

StarRocks как движок Open Data Lakehouse: архитектура, интеграция, best practices
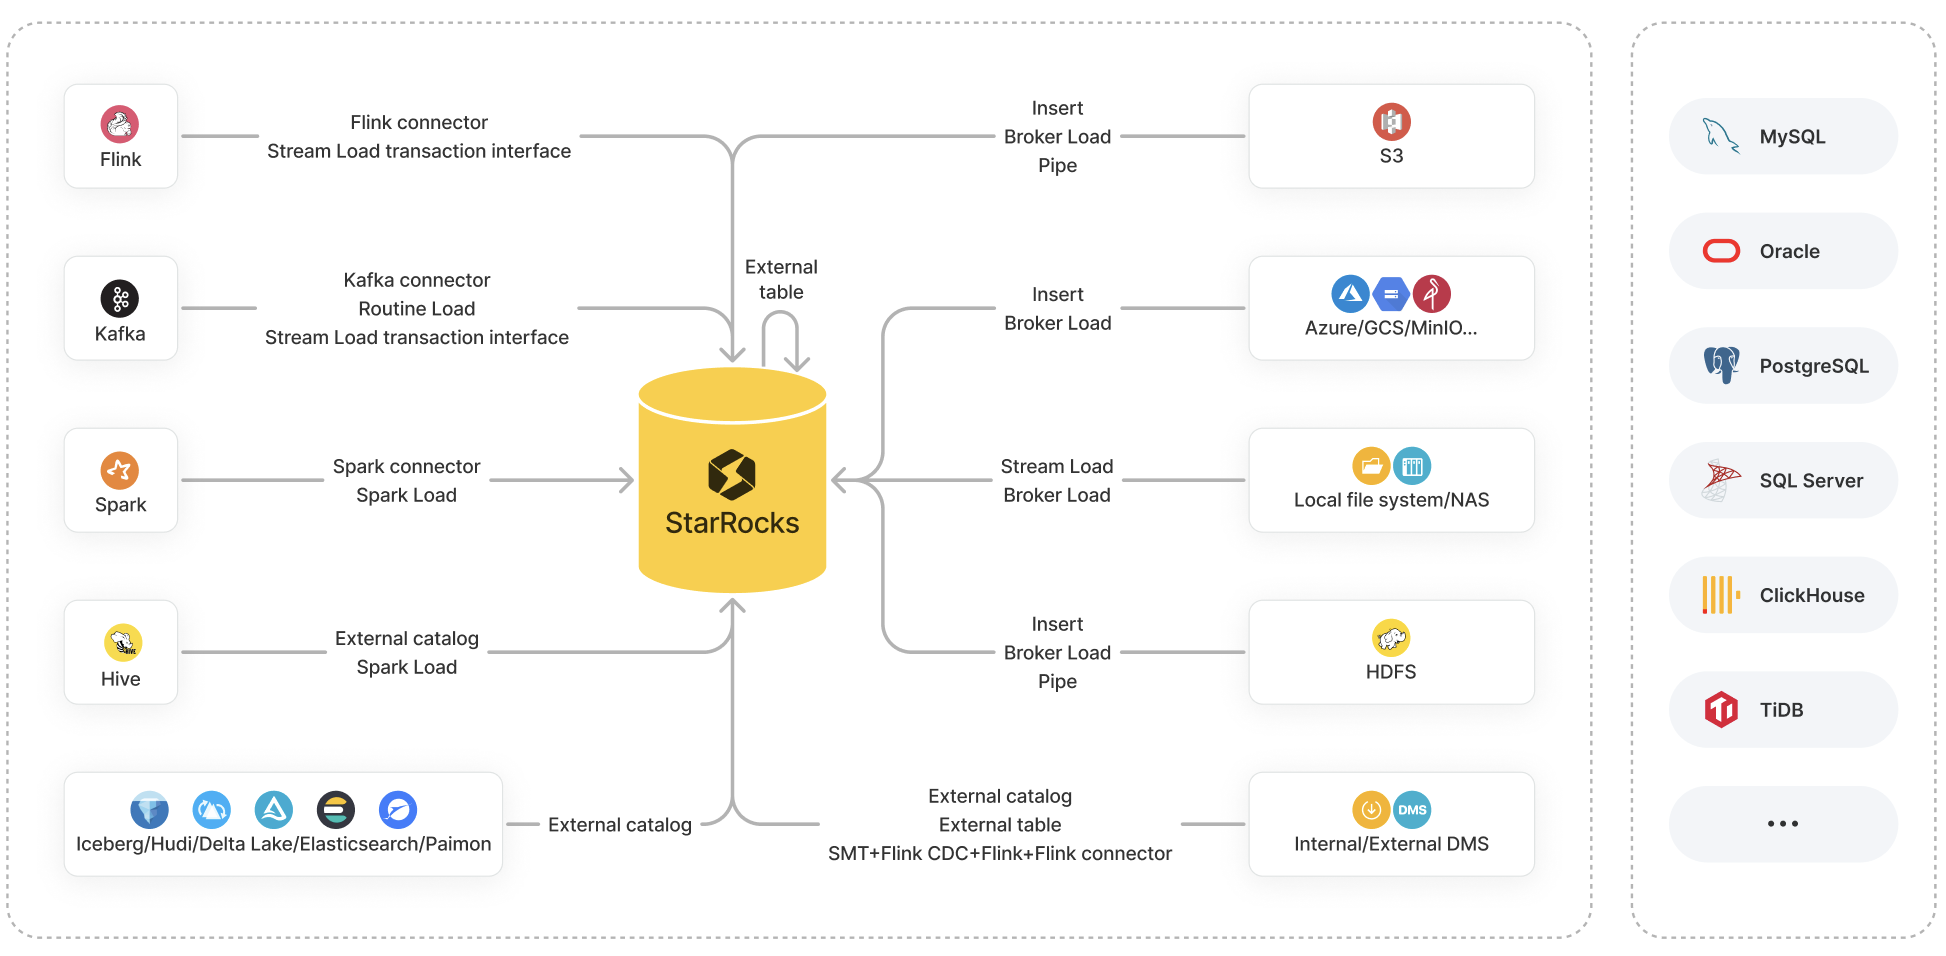
Современные аналитические платформы всё чаще строятся на принципах Open Data Lakehouse — архитектуры, которая объединяет масштабируемость и экономичность data lake с управляемостью и производительностью аналитических хранилищ. Такой подход позволяет хранить данные в открытых форматах в объектных хранилищах, а вычисления и аналитические запросы выполнять с помощью специализированных движков. В этой архитектуре StarRocks выступает как высокопроизводительный аналитический слой, обеспечивающий быстрый SQL-доступ к данным и эффективную обработку сложных аналитических нагрузок.
В этом разделе рассматривается роль StarRocks в архитектуре Open Data Lakehouse: взаимодействие с объектными хранилищами и форматами данных, интеграция с платформами обработки данных, управление метаданными и схемами, а также принципы масштабирования, безопасности и операционной устойчивости. Такой обзор помогает понять, как строить современные аналитические платформы, которые объединяют открытые технологии, высокую производительность запросов и гибкость интеграции с различными источниками и инструментами обработки данных.
- Введение: Open Data Lakehouse и роль StarRocks
- Терминология и базовые концепции Open Data Lakehouse
- Стратегия внедрения StarRocks: цели, KPI и бизнес-ценность
- Архитектура Open Data Lakehouse: слои, принципы взаимодействия
- Архитектура StarRocks: вычислительный движок, хранение и каталоги
- Хранилище данных в Data Lake: объектное хранилище и форматы столбцовые
- Метаданные, каталоги и управление схемами
- Интеграция источников данных: коннекторы, CDC и ingestion-пайплайны
- Интеграция с обработчиками данных: Spark, Flink, Hive и прочие платформы
- SQL-интерфейс StarRocks: архитектура, совместимость и возможности
- Планирование запросов: статистика, селекторы и выбор плана
- Выполнение запросов: распределенное исполнение, параллелизм и оптимизации
- Индексированные структуры и ускорения выполнения
- Эволюция схем: управление изменениями, миграции и совместимость
- Архитектура разделения хранения и вычисления: паттерны и trade-offs
- Масштабирование кластеров: шардинг, репликация и управление ресурсами
- ETL/ELT и конвейеры данных: интеграция с StarRocks
- Управление качеством данных и линии происхождения в StarRocks как движке Open Data Lakehouse: архитектура, интеграция, best practices
- Безопасность и соответствие: доступ, аудит, шифрование
- Мониторинг, метрики и наблюдаемость аналитических нагрузок
- Операционная устойчивость: бэкапы, DR, тесты восстановления
- Практические подходы к внедрению: роли, процессы, agile-методологии
- Миграционные стратегии: перенос из традиционных хранилищ
- Тестирование аналитических нагрузок и валидация данных
- Архитектура данных для аналитики: Data Mesh и Data Fabric в Lakehouse
- Архитектурные паттерны интеграций: микросервисы, централизованные конвейеры
- Кейсы внедрения StarRocks: примеры отраслей и результаты
- Риски внедрения и антипаттерны в StarRocks как движке Open Data Lakehouse
- Развитие продукта и дорожная карта StarRocks: направления исследований
- Обучение команд и развитие компетенций: методы и материалы
- Практические примеры архитектурных решений в разных отраслях


