

Развитие и будущее S3: тенденции, новые сервисы и интеграции
S3 давно вышел за рамки простого хранилища объектов. Сегодня он выступает фундаментом экосистемы данных и вычислений: база для Data Lake, платформы Lakehouse, поддержка ML-операций и гибридных сценариев. Эта глава рассматривает эволюцию архитектуры S3, современные сервисы вокруг него и направления развития, которые формируют будущее цифровой трансформации организаций. Мы опираемся на принципы открытости API, управляемости данных и устойчивости инфраструктуры, сочетая теоретические основания и практические подходы к внедрению.
S3 остаётся точкой интеграции для множества доменов: от файлового хранилища до аналитических конвейеров, от управления данными до регуляторных требований. Эволюция паттернов работы с данными в облаке приводит к более тесной интеграции с аналитикой, машинным обучением и управлением данными, где S3 выступает не просто местом хранения, а платформой данных. В условиях растущей потребности в гибкости, безопасности и экономической эффективности, архитектура S3 должна поддерживать множество режимов доступа, типологий загрузки данных, режимов версионирования и механизмов сохранения изменений на уровне объектов и метаданных. Именно такие возможности позволяют организациям строить устойчивые Data Lake, переходить к Data Lakehouse и осуществлять управляемый переход к данным как активу бизнеса.
Ниже приводятся основные тенденции, новые сервисы и подходы к интеграции, которые определяют развитие S3 в ближайшие годы. В тексте выделяются архитектурные принципы, алгоритмы обработки метаданных, протоколы взаимодействия и типовые сценарии внедрения, подкреплённые примерами реальных практик и рекомендуемыми шаблонами реализации.
- Архитектура S3 как база для Data Lakehouse и гибридных сценариев, включая паттерны репликации, версии и жизненного цикла.
- Новые сервисы вокруг S3: аналитика данных, обработка, управление метаданными, интеграции с машинным обучением.
- Инфраструктура и операционные практики: IaC, мониторинг, безопасность, оптимизация затрат и управление доступом.
- Тенденции будущего: edge-вычисления, S3 Object Lambda, data mesh, расширение совместимости и новые форматы данных.
- Практические сценарии внедрения и архитектурные решения для крупных организаций.
Эволюционная архитектура S3: от объекта к платформе данных
Истоки архитектуры и принципы
S3 проектировался как распределённое хранилище объектов с высокими уровнями доступности, масштабируемости и долговечности. Основные принципы включают централизованный контроль над данными через buckets, эффективную индексацию и поиск объектов через метаданные, а также гибкость в выборе режимов хранения и доступа. Архитектура поддерживает множество режимов безопасности: IAM-полисы, политики бакета и политику ACL, а также шифрование в покое (SSE) и в пути передачи данных. Такой набор позволяет формировать сегменты доступа по ролям, по емкости и по требованиям к соответствию регуляторным нормам.
Важной особенностью является концепция управляемого доступа через Access Points и политики квантизации доступа к конкретным областям данных внутри одного бакета, что упрощает крупномасштабное внедрение и обслуживание. Архитектура также поддерживает версии объектов, что критично для аудита и восстановлений после ошибок, и функции блокировки объектов (Object Lock) для обеспечения неизменности в рамках соответствующих регуляторных режимов (WORM). В целом, архитектура S3 строится вокруг обеспечения доступности, долговечности и консистентности данных с минимальными затратами на управление, при этом сохраняя гибкость для разнообразных рабочих нагрузок.
Современная архитектура и паттерны
Современная экосистема S3 опирается на несколько ключевых паттернов:
-
Модифицированная обработка объектов и хранение в разных классах хранения. AWS S3 предоставляет классы Standard, Intelligent-Tiering, Infrequent Access, а также архивные классы (Glacier, Glacier Deep Archive) и One Zone-IA. Такой набор позволяет автоматизировать перемещение объектов между классами и оптимизировать общие затраты на хранение без потери доступности.
-
Репликация и разделение данных. Cross-Region Replication (CRR) и Same-Region Replication (SRR) позволяют поддерживать зеркала бакетов в разных регионах или аккаунтах. Это критично для резервирования данных, локального расчёта на близких регионах и соответствия требованиям по локализации.
-
Безопасность и доступ. Политики бакетов, IAM-роли и политики на уровне объекта обеспечивают детальный контроль доступа. Дополнительные механизмы включают S3 Access Points для расчёта узких точек доступа и упрощения безопасного совместного использования бакетов между командами и отделами.
-
Событийная архитектура и вычисления. События S3 (ObjectCreated, ObjectRemoved и т. п.) могут триггерить функции вычислительных сервисов (например, AWS Lambda), конвейеры Step Functions или интеграцию через EventBridge. Такой подход позволяет внедрять автоматизированные конвейеры обработки данных без явного перемещения файлов.
-
Метаданные и поиск. S3 Select позволяет извлекать подмножество данных прямо из объектов, снижая передачу данных и ускоряя аналитику. Метаданные, теги и каталоги (метаданные в Glue Data Catalog или аналогичные решения) обеспечивают эффективную управляемость и поиск.
-
Управление жизненным циклом и версионность. Версионность объектов позволяет сохранять историю изменений и восстанавливать предыдущие версии. Правильное использование Lifecycle Policies обеспечивает автоматическую очистку, перенос в архивы и удаление старых версий в рамках требований к хранению.
-
Безопасность и соответствие. Обеспечение шифрования, аудит доступа и контроль изменений через политики и регистрации. В частности, S3 Object Lock обеспечивает неизменность для целей соответствия, поддерживать режимыCompliance и Governance.
-
Производительность и доступность. Протоколы REST и SDK поддерживают широкий спектр языков и платформ. Multipart Upload позволяет эффективно загружать крупные файлы, параллелизация запросов и оптимизация пропускной способности важны для больших конвейеров данных и ML-нагрузок.
Безопасность, доступ и комплаенс
Безопасность данных в S3 охватывает три плоскости: сетевой доступ, идентификацию и аутентификацию, а также защиту данных в покое и в пути. В сетевой плоскости применяются VPC Endpoints и PrivateLink для приватного доступа к S3 без выхода в интернет. В идентификационной плоскости используются IAM, роли и политики—они позволяют ограничить доступ на основе принципов минимальных прав и обязуют к многофакторной аутентификации для критических операций.
Защита данных включает:
- шифрование в покое и в пути: SSE-S3, SSE-KMS, SSE-C;
- использование ключей KMS и управление ими;
- поддержка версий объектов и Object Lock для записи не подлежащей изменению в рамках регуляторных требований;
- аудит действий через сервисы мониторинга и регистрации.
Комплаенс-практики требуют четкого управления жизненным циклом, метаданными и каталогами данных. В этом контексте важно поддерживать точную карту данных и владение доступами, чтобы обеспечить прозрачность и возможность аудита в рамках нормативных требований.
Жизненный цикл, версии и управление
Версионность объектов обеспечивает хранение всех изменений. Жизненный цикл и политики перехода между классами хранения позволяют оптимизировать стоимость, архивировать редко используемые данные и поддерживать регуляторные сроки хранения. Политики жизненного цикла могут автоматически перемещать объекты между STANDARD и Intelligent-Tiering или архивными классами, а также удалять устаревшие версии в определённые сроки. Кроме того, управление версионностью интегрируется с механизмами аварийного восстановления и аудита.
Object Lock поддерживает режимы Governance и Compliance, обеспечивая неизменность объектов на заданный период. Это особенно важно для отраслей с требованиями к хранению данных в неизменяемом виде (финансы, здравоохранение, государственный сектор). В связке с версиями и жизненным циклом это формирует устойчивый режим гарантированной сохранности артефактов.
Протоколы, производительность и доступность
S3 опирается на RESTful API и SDK-подключения, что обеспечивает широкую совместимость с языковыми экосистемами и инструментами обработки. Ключевые механизмы производительности включают Multipart Upload, параллельные загрузки и скачивания, настройку лимитов параллелизма и управление зависимостями между загрузками. Для глобального доступа и низкой задержки могут применяться режимы Transfer Acceleration и региональные точки доступа (Access Points) для оптимизации операций по конкретным наборам данных.
Доступность и устойчивость достигаются за счёт геораспределённости и многократности копий объектов. В реальной практике эти характеристики позволяют строить стабильные конвейеры обработки данных, поддерживать работоспособность критических сервисов и снижать риск потери данных при сбоях.
Новые сервисы и интеграции вокруг S3
Аналитика и обработка данных: от data lake к data lakehouse
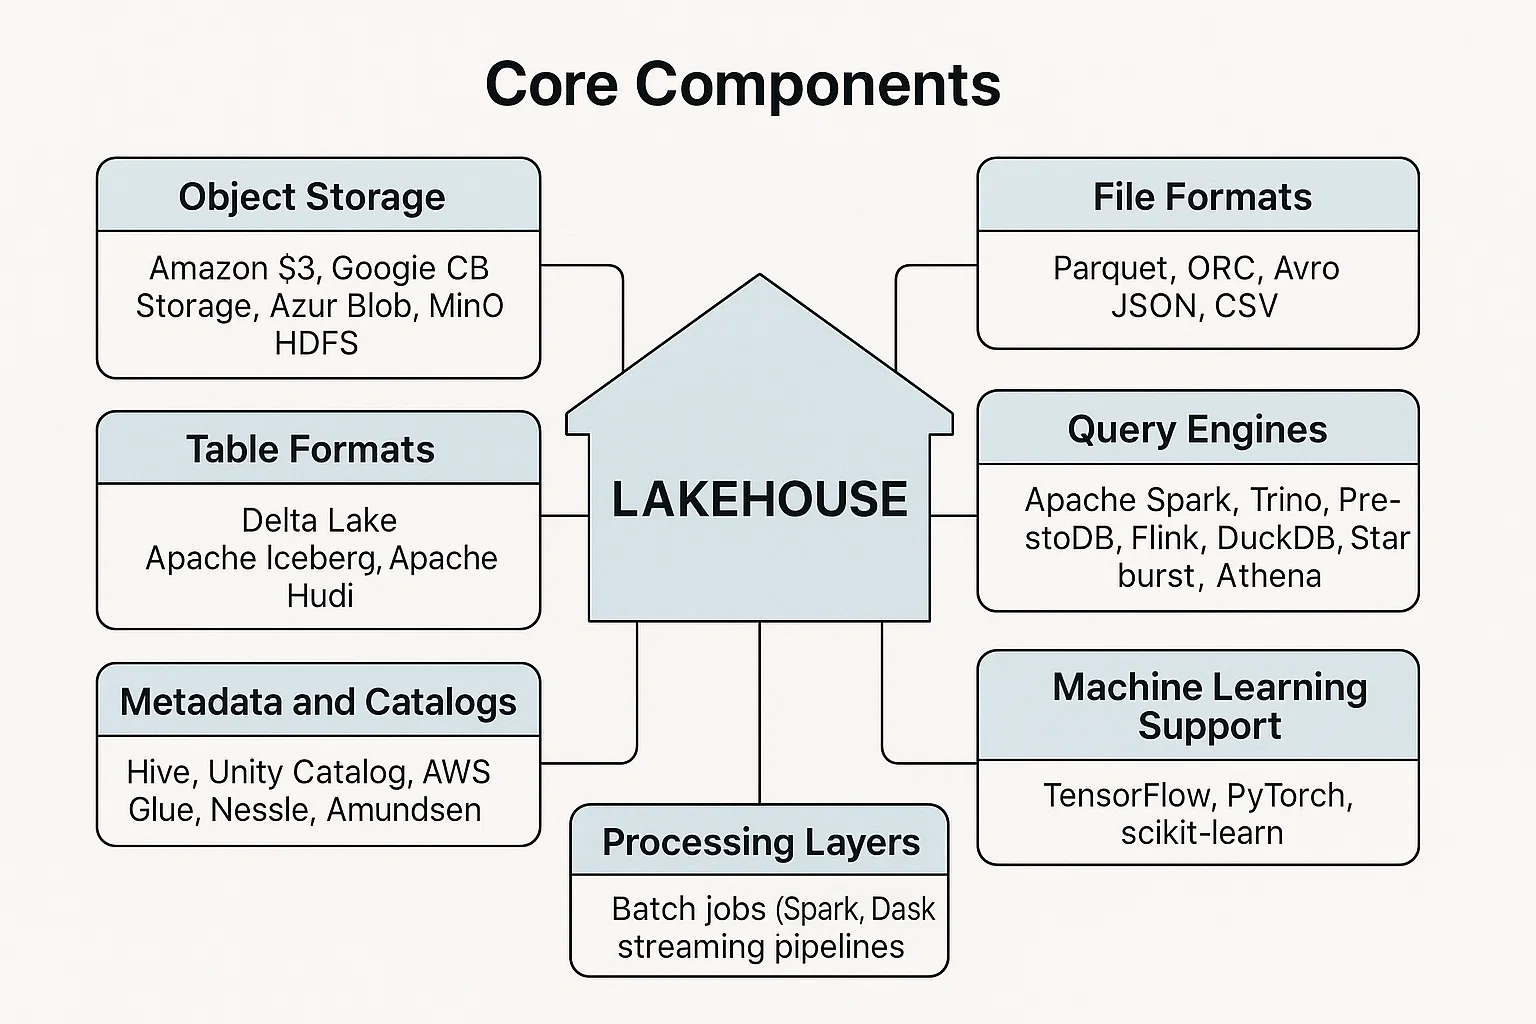
S3 остаётся фундаментом для аналитики больших данных. Инструменты бизнес-аналитики и обработки данных активно используют S3 в качестве источника и хранилища результатов анализа. Основные связки:
-
Аналитические сервисы: S3 служит основным источником данных для сервисов вроде AWS Athena, Redshift Spectrum, а также для интеграций через Glue Catalog и Data Catalog. Это упрощает выполнение SQL-запросов непосредственно над данными в S3 без необходимости загрузки в промежуточные хранилища.
-
Data Lakehouse и форматы столбцов: Parquet, ORC и AVRO становятся стандартами для эффективного хранения и чтения больших наборов данных. Паттерны управления схемами и миграциями данных требуют согласованности между каталогами метаданных и физическим расположением файлов в S3.
-
Интеграции с открытыми технологиями: Apache Iceberg и Delta Lake создают надстройки на основе S3 для управления версиями схем, атомарностью операций и поддержки мутаций данных в рамках lakehouse-подхода. Эти проекты широко применяются в гибридных архитектурах и поддерживают эволюцию данных без полного переноса.
-
Русские и локальные решения: Яндекс Облако Object Storage предоставляет S3-совместимый API и интеграции с экосистемой Яндекса, что облегчает построение локализованных архитектур. В контексте гибридности и миграций эти решения позволяют сохранить совместимость и управляемость.
Метаданные, каталоги и управляемость
Управление данными становится критичным фактором для крупных организаций. Каталоги данных (Data Catalog) и службы управления метаданными позволяют централизовать описание, классификацию и доступ к данным. Glue Data Catalog, как часть экосистемы AWS, обеспечивает единое представление о схемах и источниках. Это поддерживает единые политики доступа, упрощает поиск и ускоряет загрузку данных в аналитические конвейеры.
Iceberg и Delta Lake выступают как слои управления версиями и схему над S3, позволяя поддерживать форматы таблиц с изменяемыми данными, обеспечивая атомарность операций и временной доступ к предыдущим версиям. В сочетании с Data Catalog это позволяет строить Data Mesh-подходы и централизованное управление данными в рамках распределенной организации.
Хранение и обращение к моделям ML
S3 служит основным хранилищем для обучающих выборок, артефактов моделей и датасетов для MLOps. Интеграция с сервисами ML, такими как SageMaker, предоставляет питательную среду для обучения, развертывания и мониторинга моделей. Модели, версии и артефакты хранятся в S3, что облегчает повторное использование и совместную работу команд над ленточками данных, конфигурациями и параметрами обучения. В контексте облачных конвейеров ML S3 обеспечивает единое хранилище, к которому обращаются как вычислительные узлы, так и сервисы проверки моделей.
Безопасность, комплаенс и контроль доступа
При работе с аналитическими данными и ML-ардарами вопросы доступа, аудита и соответствия становятся критическими. Интеграция IAM, политик на уровне бакетов, объектных политик и шифрования обеспечивает защиту от несанкционированного доступа. В режиме Object Lambda возможно динамически формировать представления объектов для конкретных приложений, не копируя данные, что уменьшает объём передачи и повышает безопасность. Также стоит учитывать требования к хранению данных для регуляторов и аудит: на этом уровне настраиваются политики версий, времени хранения и блокировки.
Технологические интеграции и стандарты
Развитие S3 сопровождается расширением возможностей интеграции через открытые стандарты и совместимости. Помимо нативных AWS-сервисов, появляется всё больше S3-совместимых реализаций и шлюзов (gateway-решения) на базе MinIO, Ceph RGW, что позволяет поддерживать гибридные архитектуры и кросс-платформенные конвейеры. В реальных условиях организациям важно выбирать инструменты в зависимости от требований к совместимости, стоимости владения и локализации инфраструктуры.
Инфраструктура и операционные практики
Инфраструктура как код и эксплуатация S3-объектов
Управление бакетами и политиками через инфраструктурный код обеспечивает воспроизводимость и контроль версий конфигураций. Инструменты IaC, такие как Terraform, AWS Cloud Development Kit (CDK) или Pulumi, позволяют описывать бакеты, политики, правила жизненного цикла и механизмы доступа как часть декларативной инфраструктуры. В гибридных сценариях применяются решения, которые поддерживают S3-совместимый API и позволяют централизовать управление ресурсами в разных облачных средах и локальных дата-центрах.
Мониторинг, безопасность и управление доступом
Надёжная операционная практика требует комплексного мониторинга: CloudWatch Metrics и Logs, S3 Event Notifications, аудита через Config и интеграцию с внешними системами мониторинга (Prometheus, Grafana). Безопасность реализуется через детальный контроль доступа, многофакторную аутентификацию, аудиты и управление ключами. Организационной ценностью является единая политика по данному профилю, включая классификацию данных и автоматизацию реагирования на инциденты.
Автоматизация операций и масштабирование
Автоматизация играет важную роль в поддержке крупных конвейеров обработки данных. S3 Batch Operations позволяют масштабировать массовые операции над миллионами объектов: копирование, удаление, изменение метаданных. Lifecycles и автоматическое переносы между классами хранения снижают объем расходов и упрощают управление данными в течение их жизненного цикла. В условиях бурного роста объёмов данных необходима архитектура, которая обеспечивает параллелизм, устойчивость и предсказуемую задержку.
Управление затратами и производительностью
Оптимизация затрат требует своевременной миграции между классами хранения, использования Intelligent-Tiering там, где параметры доступа не фиксированы, и грамотного планирования архивирования. В расчетах особое внимание уделяется задержкам доступа, требованиям к скорости выборок и регуляторным аспектам. Эффективная оптимизация затрат сопровождается мониторингом использования, прогнозированием загрузок и анализом карты хранения в разрезе отделов и проектов.
Гибрид и кросс-облачные практики
Для крупных организаций характерны гибридные сценарии: часть данных хранится в облаке, часть — на локальной инфраструктуре или на облачных платформах партнёров. S3-совместимый API, S3 on Outposts и другие решения позволяют реализовать единый слой хранения, доступ к которому регламентирован политиками и безопасностью. В подобных условиях возникает задача согласования каталога данных, совместного управления версиями и единых стандартов доступа для разных сред.
Будущее: тенденции и новые подходы
Edge-вычисления, S3 на краю и данные в любом месте
Тенденции указывают на усиление вычислений на границе сети и близко к источнику данных. S3 поддерживает интеграцию с краевыми вычислениями через объекты, расширяя возможности анализа и подготовки данных без передачи больших объёмов через сеть. Концепции Edge Computing в сочетании с S3-архитектурой позволяют перерабатывать данные локально и передавать уже обработанную выборку в центральное хранилище. В этом контексте важную роль играют стратегии кэширования, локальные политики доступа и соответствие требованиям к задержке.
Data mesh и единая платформа данных
Data mesh предполагает децентрализованное владение данными, где домены становятся ответственными за данные своей предметной области. S3 выступает как единый технический слой, обеспечивающий стандартизованные механизмы доступа, каталоги и политику управления. В рамках mesh возникает потребность в согласованных интерфейсах к данным, унифицированной каталогизации и прозрачной политике безопасности. Применение Foss- и open-source подходов (Iceberg/Delta Lake) поддерживает версионирование и управление схемами даже в многоорганизационных контекстах.
Безопасность, приватность и устойчивость
Безопасность и приватность остаются приоритетами, особенно в условиях регионализации данных и гармонизации нормативных требований. Будущие решения включают расширение возможностей шифрования, более глубокую интеграцию с KMS, углублённый мониторинг доступа к данным и улучшенные механизмы аудита. Устойчивость инфраструктуры достигается через геораспределённость, резервное копирование и продуманное управление инцидентами. В рамках этого направления S3 будет продолжать развиваться как платформа, поддерживающая строгие регуляторные требования, а также облегчать управление данными на протяжении их жизненного цикла.
Новые форматы данных, метаданные и индексирование
Переход к эффективным форматам столбцовых данных (Parquet, ORC) продолжится, поддерживаясь продвинутыми индексами и схемами метаданных. Роль тегирования и контекстной информации в объектах возрастает: данные будут обогащаться контекстом через теги, собственные политики каталога и расширяемые схемы метаданных. Такой подход упрощает поиск, доступ и автоматизацию в контексте больших конвейеров данных и сложных рабочих нагрузок.
Примеры реальных реализаций и отраслевые сценарии
В организациях с многоуровневыми архитектурами S3 становится сердцем инфраструктуры данных. Реализации включают создание централизованных Data Lake для аналитики и ML, интеграцию с инструментами управления данными и безопасностью, а также внедрение гибридных сценариев с локальными кластерами и облачными сервисами. Примеры применимы к финансовому сектору, телекомму и розничной торговле, где критически важны доступность, соблюдение регуляторных требований и скорость реакции на изменения рынка.
Key takeaways
- S3 эволюционировал из простого хранилища объектов в платформу данных, поддерживающую Data Lake, Data Lakehouse и гибридные сценарии.
- Архитектура S3 сочетает хранение объектов, контроль доступа, версии, жизненный цикл, безопасность и интеграцию с вычислениями через события и API.
- Новые сервисы вокруг S3 расширяют аналитическую функциональность, управление данными и поддержку ML-операций.
- Управление инфраструктурой и затратами требует IaC-подходов, мониторинга, политики безопасности и автоматизации операций.
- Будущее S3 связано с edge-выччислениями, data mesh, расширенной безопасностью и продвинутыми форматами данных и метаданными.
- Интеграции с открытыми формами и локальными решениями позволяют строить устойчивые гибридные архитектуры с единым слоем хранения.
- Гибкость в выборе классов хранения и автоматизация переходов поддерживает cost optimization без потери доступности и функциональности.
FAQ
Какие ключевые сервисы вокруг S3 стоит учитывать при проектировании архитектуры данных?
- Важными сервисами являются аналитика и обработка данных через Athena, Redshift Spectrum, Glue Catalog; управление данными через Iceberg/Delta Lake в сочетании с S3; и ML-инфраструктура через интеграцию с SageMaker и аналогичными решениями. Также полезны Object Lambda для на лету трансформаций и промежуточные конвейеры через EventBridge и Step Functions. Выбор сервисов зависит от целей: скорость аналитики, управляемость каталогов или гибкость для ML-процессов.
Как выбрать режим хранения и стратегию жизненного цикла для данных в S3?
- Выбор класса хранения зависит от частоты доступа к данным, требований к задержке и затрат. Intelligent-Tiering подходит для неопределённых нагрузок, Standard — для часто используемых, Infrequent Access — для редких обращений, а Glacier/Deep Archive — для архивов на долгие периоды. Жизненный цикл позволяет автоматизировать переходы между классами и удаление старых версий, что снижает издержки и упрощает управление данными в компании.
Что из себя представляет S3 Object Lambda и в каких сценариях он полезен?
- S3 Object Lambda позволяет возвращать данные из объектов в виде, который вы выбираете, выполняя функции на лету при запросе. Это полезно для скрытия сложных структур данных, формирования настраиваемых представлений без копирования данных, а также для обеспечения соответствия требованиям к формату вывода и маскированию чувствительных полей.
Какие меры безопасности являются необходимыми в крупных организациях для S3?
- Необходимы: строгие IAM-политики и роли, политики бакетов, шифрование в пути и в покое (SSE-S3, SSE-KMS), контроль версий и Object Lock для неизменности в рамках регуляций, аудит через мониторинг и настройки соответствия. Важно также использовать PrivateLink/VPC Endpoints для приватного доступа и минимизировать публичные патчи.
Как S3 поддерживает устойчивость и восстановление после сбоев?
- Устойчивость достигается через географическую репликацию (CRR/SRR), многокопийность объектов и режимы резервного копирования. В случае сбоя можно переключиться на зеркальные копии в другом регионе, использовать версии объектов для восстановления и автоматизировать восстановительные процедуры через конвейеры и политики.
Какие практики применяют для интеграции S3 с аналитикой и Data Lakehouse?
- Практики включают использование Parquet/ORC форматов, каталога Glue и ледовых инструментов Iceberg/Delta Lake, чтобы обеспечить версионность и транзакционность данных в рамках lakehouse. Также применяют аналитические сервисы (Athena, Redshift Spectrum) для прямого SQL-доступа к данным в S3, уменьшая необходимость переноса файлов.
Какие подходы эффективности хранения и вычислений применяются в гибридных архитектурах?
- В гибридных архитектурах применяют S3 on Outposts и S3-совместимый API, чтобы обеспечить единый слой хранения между локальными средами и облаком. Архитектурные решения включают регулярную миграцию данных, кэширование на краю сети и единый каталог, что упрощает контроль доступа и ускоряет анализ в рамках всей организации.
Что важно учесть при переходе к Data Mesh на основе S3?
- В Data Mesh главное — владение данными доменами и единый набор сервисов для доступа и управления. S3 выступает как технологический слой, который хранит данные и обеспечивает политику доступа. Важно согласовать каталоги, схемы и версионность, а также реализовать общие политики безопасности и мониторинга, обеспечивающие прозрачность и ответственность по всем доменам.
Какие примеры технологических реализаций можно привести для больших предприятий?
- Реализация может включать: создание единого Data Lake на S3 с использованием Iceberg или Delta Lake для управления версиями, интеграцию с Glue Catalog и Athena для аналитики, а также внедрение MLOps-платформ на основе SageMaker и S3. Гибридные решения могут использовать S3 on Outposts для локальной обработки чувствительных данных и поддержания низкой задержки доступа.
Каковы лучшие практики при проектировании архитектуры S3 для enterprise?
- Следуйте принципам модульности: разделяйте данные по доменам и бизнес-контекстам; применяйте политики доступа и каталоги, соответствующие ролям; используйте версионность и Object Lock для критически важных артефактов; автоматизируйте жизненный цикл и репликацию; внедряйте мониторинг, аудит и управление затратами; обеспечивайте совместимость с выбором форматов и инструментов аналитики. Кроме того, планируйте тестовые сценарии аварийного восстановления и регулярно проверяйте их на практике.
Примечание к внедрению:
- При проектировании архитектуры S3 для конкретной организации следует учитывать отраслевые требования, регуляторные ограничения и локальные условия. В качестве опорных примеров можно рассмотреть применение S3 как основы Data Lake и интеграцию с открытыми инструментами (Iceberg/Delta Lake) или использование S3-совместимых решений в локальном контуре (например, Яндекс Облако Object Storage). Важно помнить: единая стратегия доступа, каталога данных и управления жизненным циклом обеспечивает устойчивость и предсказуемость в условиях растущего объёма данных и разнообразия рабочих нагрузок.


