

Архитектура Data Lake: как правильно спроектировать Data Lake
Data Lake - это хранилище данных, предназначенное для хранения больших объемов информации, представленной в различных форматов. Безусловно, одной из главных особенностей данного решения является то, что Вы можете хранить в нем все свои данные в формате «как они есть».
Так, Вас может интересовать вопрос хранения следующих данных:
- Операционные данные (объем продаж, бюджет, запасы);
- Автоматически генерируемые данные (IoT- устройства, логи);
- Данные, генерируемые людьми (сообщения в социальных сетях, электронные письма, веб-контент) как внутри организации, так и поступающие со стороны.
Распределение слоев
Мы воспринимаем Data Lake как единое хранилище данных. Однако у нас есть возможность разделить его на отдельные слои. Исходя из нашего опыта, можно выделить 3-5 основных слоев, которые стоит учесть при проектировании озера данных:
Слои Data Lake:
- Сырые данные
- Стандартизированные данные
- Очищенные данные
- Прикладные данные
- Песочница данных
Слои Стандартизированных данных и Песочницы данных проектируются по желанию, так как не являются обязательными элементам архитектуры Data Lake. Давайте изучим каждый слой как можно подробнее:
- Слой сырых данных или слой загрузки данных (Ingestion layer)/Landing Area - в буквальном смысле "сток" нашего озера данных. Основная задача данного слоя состоит в том, чтобы как можно быстрее и эффективнее получить все данные. Для этого они должны оставаться в своем родном формате - на этом этапе какие-либо преобразования просто недопустимы. При всем при этом данный слой все же нуждается в определенной организации папок. Из нашего опыта мы советуем клиентам начать с общего разделения: предметная область/источник данных/объект/год/месяц/день поступления/сырые данные. Важно отметить, что конечным пользователям не следует предоставлять доступ к этому слою. В данном случае данные просто не готовы к использованию, они требуют глубоких знаний и большого опыта в плане уместного и релевантного потребления. Данный слой во многом похож на всем известный слой сырых данных в DWH.
- Слой стандартизированных данных в большинстве случаев является опционным, то есть необязательным, однако, если мы предполагаем, что наша архитектура Data Lake будет развиваться быстро, тогда его стоит предусмотреть. Основная задача этого слоя заключается в повышении производительности при передаче данных из самого первого слоя в слой очищенных данных. Сюда входят как ежедневные преобразования, так и загрузка данных по требованию. Если в слое загрузки данных данные хранятся в своем родном формате, то в слое стандартизированных данных мы выбираем тот формат, который лучше всего подходит для очистки. Структура такая же, как и в предыдущем слое, но при необходимости она может быть разбита на более мелкие части.
- Слой очищенных данных также называется Курируемым (Curated Layer)/Согласованным слоем (Conformed Layer). Здесь данные преобразуются в наборы данных, пригодные для дальнейшего использования, которые могут храниться в файлах или таблицах. Назначение данных, а также их структура на этом этапе уже известны. Данные подвергаются очистке и проходят ряд преобразований. Кроме того, именно здесь зачастую происходит денормализация и консолидация различных объектов. В связи со всем вышесказанным, это самая сложная часть Data Lake. Что касается организации данных, то здесь структура довольно проста и понятна: Назначение/Тип/Файлы. Обычно конечным пользователям предоставляется доступ только к этому слою.
- Уровень прикладных данных, также называемый Доверенным уровнем (Trusted Layer)/Слоем безопасности (Secure Layer)/Производственным уровнем (Production Layer), формируется из слоя очищенных данных, дополненных какой-либо бизнес-логикой. Это могут быть суррогатные ключи, требование безопасности на уровне строк или что-то еще, специфичное для каждого приложения, использующего данный уровень. Структура данных такая же, как и в слое очищенных данных.
- Песочница данных – еще один слой, который можно считать необязательным. С ним, как правило, имеют дело продвинутые аналитики и специалисты по данным. Здесь они могут проводить эксперименты по поиску закономерностей или корреляций между данными. Если Вы захотите обогатить свои данные каким-либо источником из Интернета, Песочница – самое подходящее место для реализации Ваших задумок.
Пока данные «проплывают» по Вашему озеру данных, давайте представим его в виде следующей логической цепочки обработки данных.

Архитектура Data Lake: важные компоненты
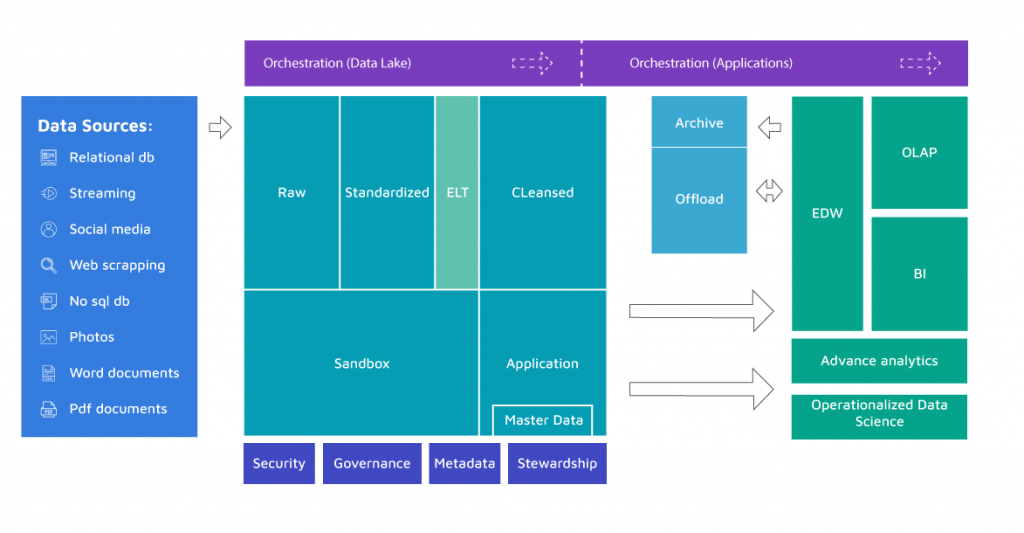
Теперь, когда мы рассмотрели самые важные части Data Lake, а именно его основные слои, предлагаю перейти к другим логическим компонентам, которые также формируют наше решение. Давайте внимательнее изучим диаграмму, приведенную ниже.
- Безопасность – даже если Вы не планируете предоставлять доступ к Вашему озеру данных широкому кругу лиц, все равно очень важно продумать аспект безопасности данных, особенно на начальном этапе разработки архитектуры Data Lake. Помните, что озеро данных совершенно не похоже на реляционные базы данных с целой артиллерией механизмов безопасности данных. Будьте осторожны и никогда не недооценивайте этот аспект!
- Governance - в определенный момент для измерения производительности и корректировки работы Data Lake пригодится мониторинг и ведение журналов (или data lineage);
- Метаданные - данные о данных или все схемы, интервалы перезагрузки, дополнительные описания назначения данных с описанием того, как они должны должны быть использованы;
- Stewardship – в зависимости от масштаба, которого Вы бы хотели добиться, Вам может понадобиться либо отдельная команда (роль), либо делегирование этой обязанности владельцам (пользователям) данных;
- Мастер-данные – важная часть обслуживания данных, готовых к использованию. Вам обязательно нужно найти способ хранить MD в самом озере данных или ссылаться на них во время выполнения процессов ELT;
- Архив – в случае, если у Вас есть дополнительное реляционное решение DWH. При этом Вы можете столкнуться с некоторыми проблемами, связанными с производительностью и хранением данных. Озера данных часто используются для хранения архивных данных, которые изначально поступают из хранилищ данных.
- Offload – и опять же, если у Вас уже есть другие реляционные DWH-решения, Вы можете использовать эту область и разгрузить таким образом некоторые процессы ETL, направив высвободившееся время и ресурсы на Data Lake.
-
Оркестрация + ELT процессы – для организации слаженного движения данных от "сырого" слоя через "очищенный" к "песочнице" Вам понадобится специальный инструмент. Это может быть какое-либо решение по оркестрации данных либо дополнительные ресурсы для выполнения данной задачи.
Другие важные аспекты
Многие считают, что Data Lake - это Святой Грааль самоорганизующегося хранилища данных. Я столько раз слышал такую фразу: "Давайте просто вливать данные, и дело сделано". На самом деле при таком подходе мы рискуем получить нечто, похожее на болото данных. Без четкого разделения на слои, соблюдения важных компонентов, о которых шла речь в данной статье, Data Lake со временем станет настолько беспорядочным, что получить искомые данные будет практически невозможно.
Для успешной реализации Data Lake крайне важен хорошо спланированный подход к проектированию областей, указанных выше. Я настоятельно рекомендую подумать о желаемой структуре озера данных заранее и как следует продумать все мельчайшие детали. С другой стороны, излишняя строгость может привести к появлению Data Desert. Помните, что озеро данных должно расширять возможности людей, а не угнетать их излишними регулятивными мерами.
На организацию Data Lake влияют следующие факторы:
- Разделение по времени;
- Паттерны загрузки данных (в режиме реального времени, потоковая, инкрементная, полная, однократная);
- Предметные области/источники данных;
- Меры безопасности;
- Downstream /цель/пользователи;
- Владельцы/stewardship;
- Политика хранения (временное, постоянное, фиксированное по времени);
- Влияние на бизнес (критически важное, высокая важность, средняя важность, низкая важность);
- Конфиденциальность (публичная информация, только для внутреннего пользования, конфиденциальная информация о поставщиках/партнерах, финансовые данные).

Заключение
В заключении предлагаю рассмотреть основные цели, которые должны быть достигнуты при внедрении любого Data Lake:
- 3 v (Velocity, Variety, Volume) или Скорость, Разнообразие и Объем. Мы можем быстро оперировать самыми разными данными. Важно, что скорость здесь означает не только время обработки, но и время создания ценности для бизнеса;
- Сокращение усилий по сбору данных (слой сырых данных) - отсрочка работы по планированию схемы и созданию моделей до тех пор, пока не будет известна ценность данных;
- Содействие продвинутым сценариям аналитики данным, новым сценариям использования новых типов данных - запуск MVP с данными, готовыми к использованию. Это значительно экономит время и деньги;
- Хранение больших объемов данных с минимальными затратами. Не нужно думать, будут ли данные когда-либо использованы, их можно хранить «на всякий случай». Эффективно управляемые и контролируемые данные можно собирать до того момента, когда мы поймем, что они могут быть нам полезны.


