

chDB - реактивный двигатель для велосипеда
Введение
Прежде чем познакомиться с chDB поближе, давайте поговорим о ClickHouse. В последние годы в сообществе OLAP-баз данных особой популярностью пользуются "векторные движки". Основная причина состоит в том, что добавление большого количества SIMD-инструкций в разы ускоряет операции агрегации, сортировки и объединения больших объемов данных. ClickHouse оптимизировала многие направления, в частности "векторизацию", о чем свидетельствуют оптимизации для lz4 и memcpy.
Далеко не все готовы назвать ClickHouse самой производительной СУБД для онлайн-обработки аналитических запросов (OLAP), но никто не будет спорить с тем, что она является одним из лидеров в своей области. Помимо производительности, ClickHouse может похвастаться своими исключительными функциями, которые делают ее «швейцарским армейским ножом» в мире баз данных:
- Прямые запросы к данным, хранящимся в S3, GCS и других объектных хранилищах;
- Использование ReplacingMergeTree для упрощения работы с обновляющимися данными;
- Выполнение межбазовых запросов к данным, а также объединений таблиц без использования сторонних инструментов;
- Автоматическое выполнение Predicate Pushdown.
Разработка действительно мощного инструмента требует много сил и времени. На то, чтобы сделать ClickHouse одной из самых мощных и быстрых СУБД у Алексея Миловидова и его команда ушло 14 лет (!). Поскольку ClickHouse может похвастаться одним из самых быстрых SQL-движков, почему бы не рассмотреть возможность его извлечения и переноса в модуль Python? Это можно сравнить с установкой реактивного двигателя на велосипед!
«Взламываем» ClickHouse
Существует достаточно простой и понятный способ встраивания движка ClickHouse в модуль Python, а именно включение утилиты clickhouse-local в пакет Python с последующей передачей SQL через popen.
Однако у данного способа есть один весомый недостаток:
Выполнение каждого запроса негативно отразиться на производительности, особенно если размер бинарного файла clickhouse-local будет составлять около 500 МБ.
Кроме того, этому способу явно не хватает элегантности!
Именно поэтому я решил поступить по-другому, и благодаря хорошо структурированной кодовой базе ClickHouse мне удалось создать прототип, при этом я взломал около 900 тысяч строк кода ClickHouse.
ClickHouse включает серию реализаций под названием BufferBase, в том числе ReadBuffer и WriteBuffer, соответствующие istream и ostream в C++. Для эффективного чтения файлов и вывода результатов буфер ClickHouse поддерживает произвольный доступ к базовой памяти. ClickHouse использует производные классы BufferBase для чтения/записи сжатых файлов, а также удаленных файлов (S3, HTTP).
Для получения данных я использовал не stdout, а встроенный WriteBufferFromVector, а для того, чтобы избежать копирования памяти из объектов C++ в объекты Python, я воспользовался функцией просмотра памяти Python.

Теперь, благодаря Pybind11, свяжем построение и уничтожение классов C++ с жизненным циклом объектов Python. Это можно сделать следующим способом:
class __attribute__((visibility("default"))) query_result {
 public:
          query_result(local_result * result) : result(result);
       ~query_result();
}
py::class_<query_result>(m, "query_result")
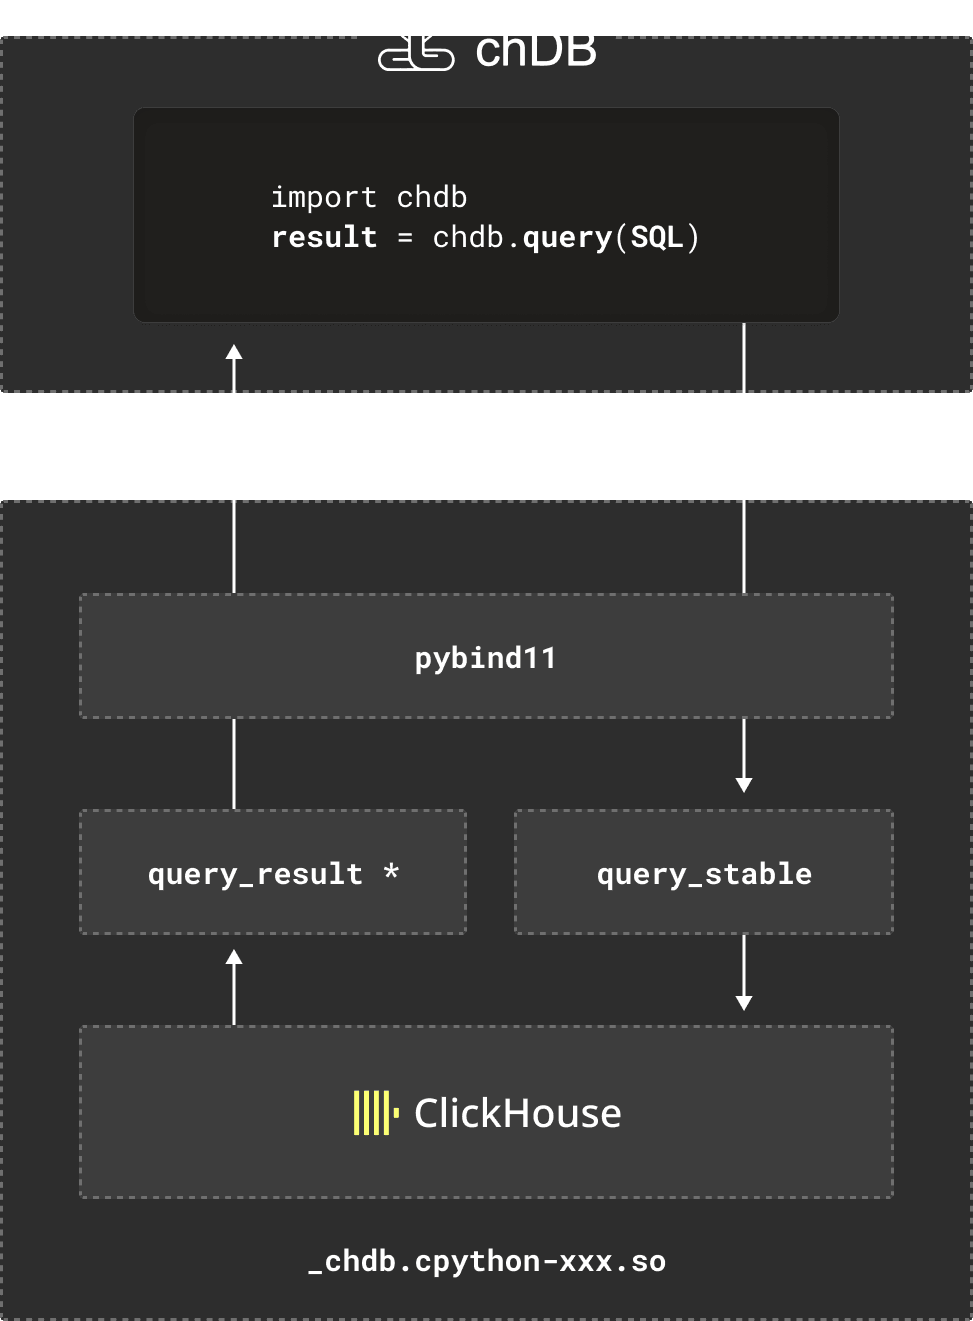
Таким образом, я достаточно быстро запустил chDB. В общих чертах архитектура chDB может быть представлена следующим образом:
Команда
Изначально я разрабатывал chDB с единственной целью - создать движок ClickHouse, который мог бы работать в Jupyter Notebook. Это позволило бы мне легко получить доступ к большим объемам информации без необходимости полагаться на медленные кластеры Hive при обучении CV-моделей с помощью Python. Удивительно, но автономная версия chDB в большинстве случаев превосходила результаты кластера Hive, состоящего из сотен серверов…

После релиза chDB со мной связался Лоренцо из QXIP. Он предположил, что устранение зависимости от AVX2 может сделать chDB более удобным для запуска на сервисах Lambda. Я незамедлительно реализовал эту возможность, после чего Лоренцо создал демо-версию chDB на fly.ioio. Честно говоря, для меня это стало сюрпризом!
Затем Лоренцо и его команда разработали связки для chDB на Golang, NodeJS и Rust. Чтобы объединить все эти проекты, я создал chdb.io на GitHub.
И да! Мы также создали экспериментальную связку chDB FFI для Bun в Linux.
Jemalloc
После тщательного анализа производительности chDB было выявлено, что в Q23 между chDB и clickhouse-local - значительный разрыв в производительности. Вероятно, эта разница связана с тем, что при реализации Q23 chDB упростила процесс, удалив jemalloc. Как же мы это исправили?
Движок ClickHouse включает в себя сотни подмодулей, в том числе такие тяжеловесные библиотеки, как Boost и LLVM. Для того, чтобы обеспечить хорошую совместимость и реализовать механизм JIT-компиляции, ClickHouse соединяется с собственными LLVM-версиями libc и libc++. Таким образом, ClickHouse гарантирует высокую безопасность соединения. Однако для chDB это довольно сложный процесс, поскольку:
- После загрузки chdb.so многие функции выделения и управления памятью, которые должны были быть связаны с jemalloc в бинарном файле ClickHouse, неизбежно будут подключены к встроенной libc через @plt;
- Для решения этой проблемы можно модифицировать исходный код ClickHouse таким образом, чтобы все соответствующие функции вызывались с помощью префикса je_, например je_malloc, je_free. У такого подхода есть ряд недостатков, один из которых можно достаточно легко нивелировать. Модификация кода вызова malloc в сторонних библиотеках – задача достаточно сложная. Вместо этого можно использовать трюк с помощью clang++: -Wl,-wrap,malloc. Например, на этапе соединения перенаправлять все обращения к malloc на __wrap_malloc.

Кажется, что проблема решена, но не тут-то было. chDB по-прежнему давал сбой при некоторых вызовах je_free. Со временем выяснилось, что это связано с libc:
При написании кода на Си malloc/calloc обычно используется в паре с free. Мы постараемся сделать все возможное, чтобы не возвращать память, выделенную с помощью malloc. Это обусловлено тем, что функция может забыть вызвать free, что приведет к неминуемой утечке памяти.
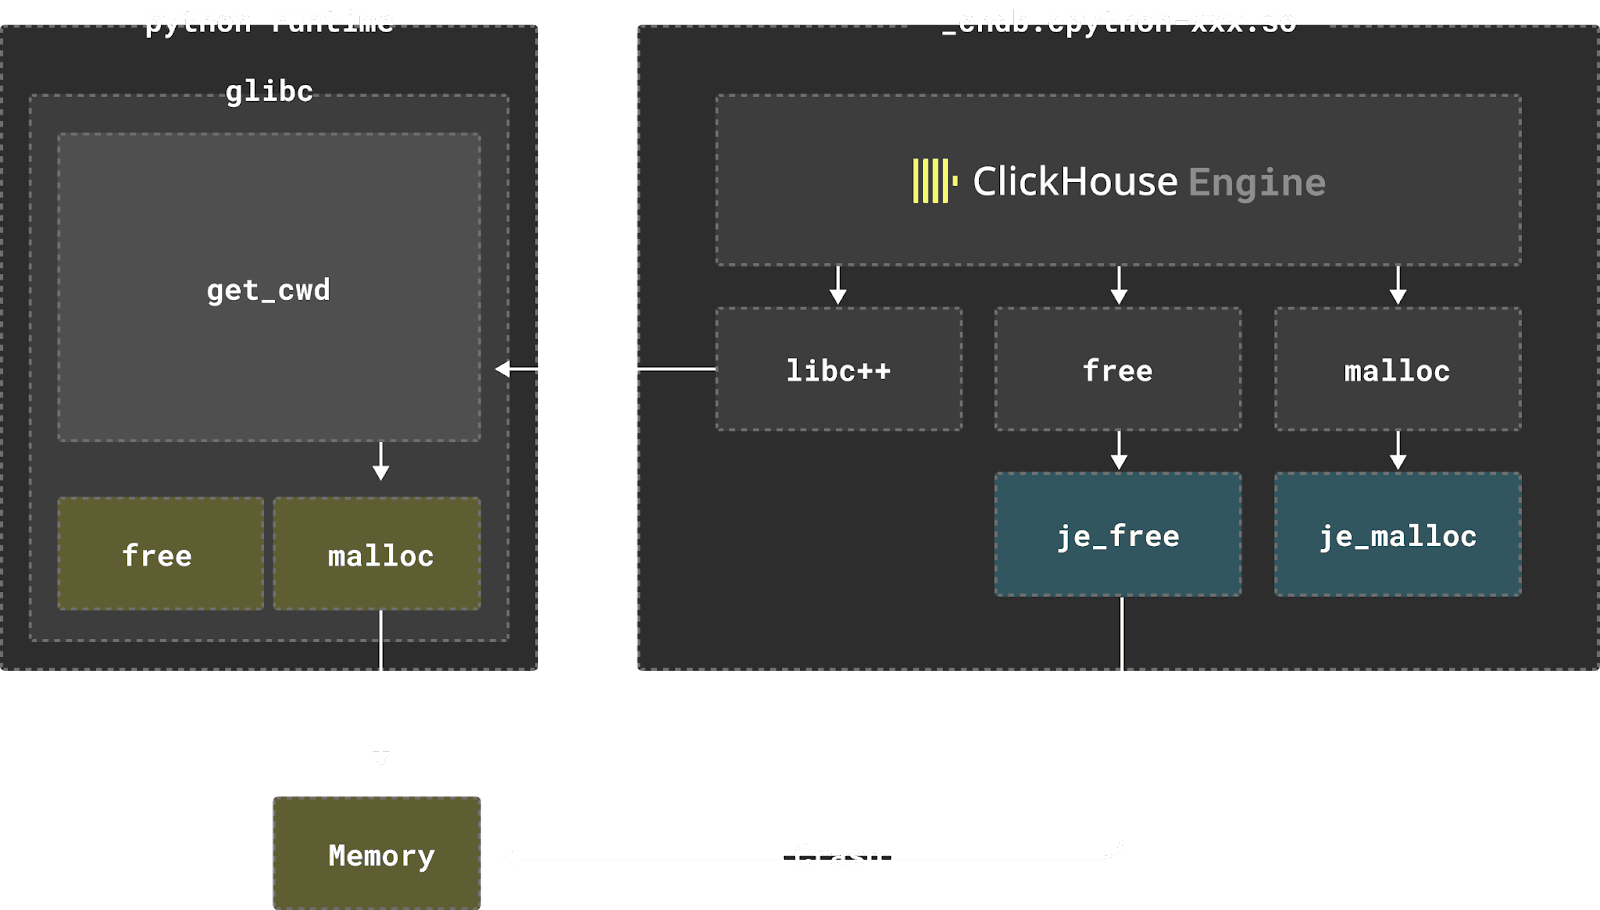
Однако libc есть некоторые функции, такие как getcwd() и get_current_dir_name(), которые вызывают malloc для выделения блока памяти.
Эти функции широко используются в библиотеках вроде STL и Boost для реализации функций, связанных с путями. Поэтому мы сталкиваемся с ситуацией, когда getcwd возвращает память, выделенную glibc'овской версией malloc и пытаемся высвободить ее с помощью je_free. Увы... но это не работает!
В идеале jemalloc должен предоставлять интерфейс для запроса, выделена ли память. Перед каждым вызовом je_free мы должны проверять, сделано это или нет.
void __wrap_free(void * ptr)
 {
int  arena_ind;
if (unlikely(ptr == NULL))
{
       return;bun
}

// in some glibc functions, the returned buffer is allocated by glibc malloc
// so we need to free it by glibc free.
// eg. getcwd, see: https://man7.org/linux/man-pages/man3/getcwd.3.html
// so we need to check if the buffer is allocated by jemalloc
// if not, we need to free it by glibc free

arena_ind = je_mallctl("arenas.lookup", NULL, NULL, &ptr, sizeof(ptr));
if (unlikely(arena_ind != 0)) {
          __real_free(ptr);
          return;
}
je_free(ptr);
}
Но, к сожалению, mallctl из jemalloc может отказать в assert при использовании arenas.lookup для запроса памяти, которая не была выделена jemalloc …
Поэтому я отправил патч для jemalloc: #2424 make arenas_lookup_ctl triable.
Результаты проделанной работы
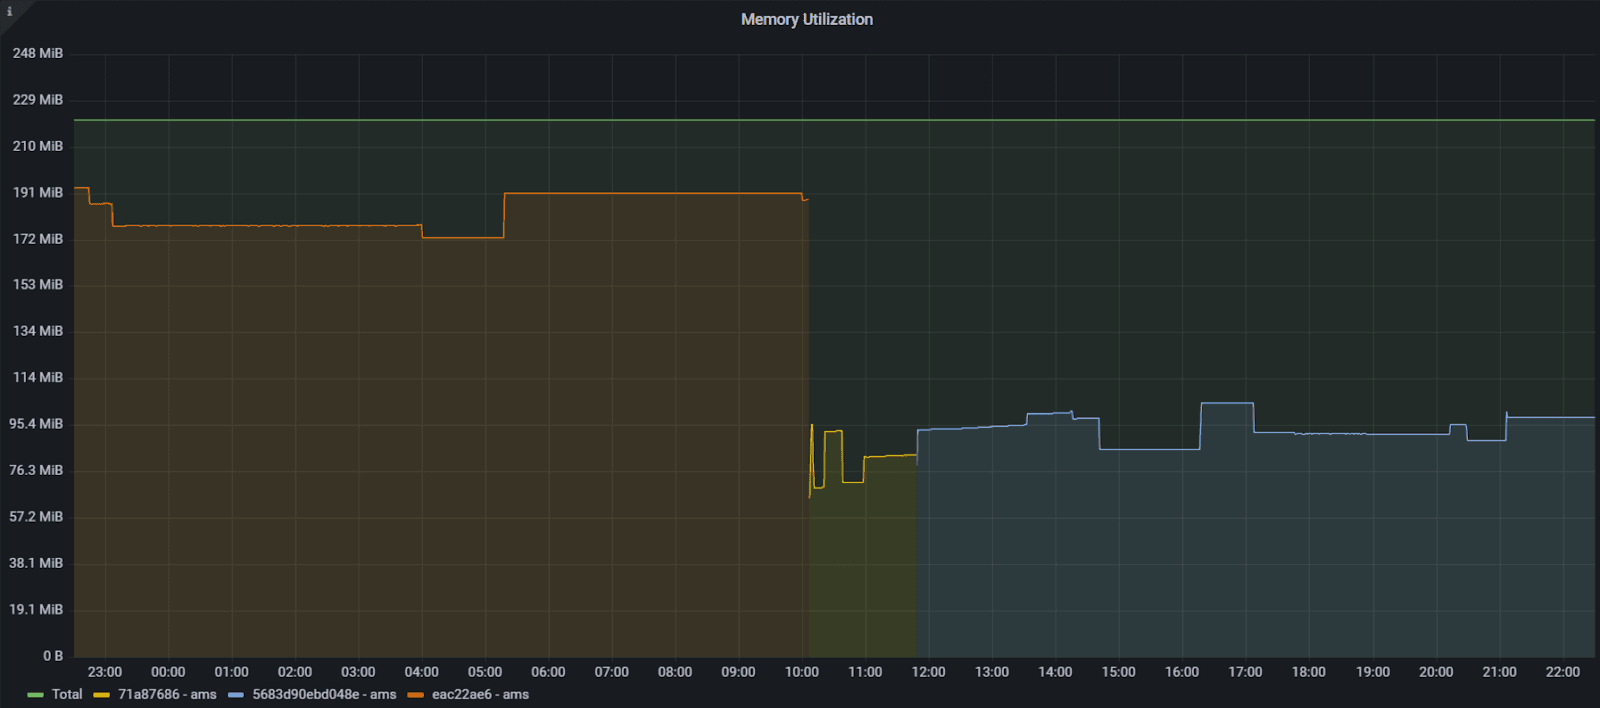
Благодаря нескольким неделям работы над ClickHouse и jemalloc использование памяти chDB было сокращено на 50%.
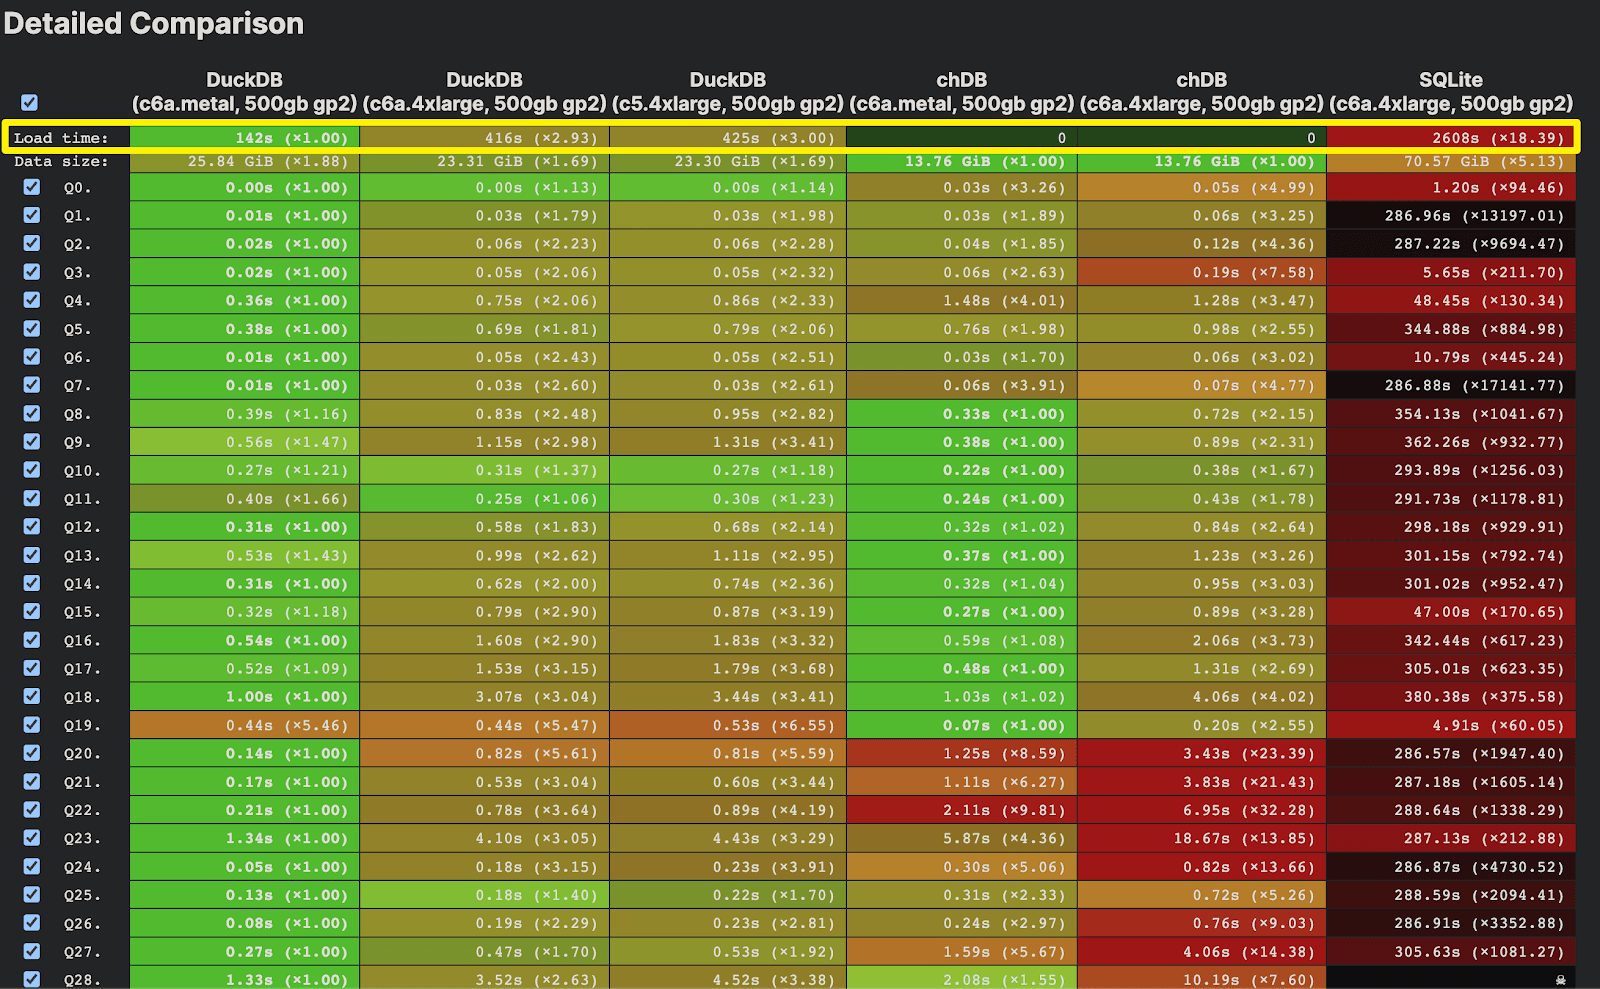
Согласно данным ClickBench, в настоящее время chDB является самой быстрой бессерверной базой данных (без учета ClickHouse Web)

В настоящее время chDB является самой быстрой реализацией SQL на Parquet. Высокая производительность DuckDB достигается по окончании процесса "Load", который длиться около 142~425 секунд.
Текущая работа
Релизу chDB v0.14 предшествовали следующие события:
v0.12 - Запрос к нескольким Pandas DataFrame. Вы даже можете объединить Parquet с DataFrame!
df1 = pd.DataFrame({'a': [1, 2, 3], 'b': ["one", "two", "three"]})
df2 = pd.DataFrame({'c': [1, 2, 3], 'd': ["ONE", "TWO", "THREE"]})
# Save df2 to Parquet file df2.to_parquet('
df2.parquet')

print("\n# Join DataFrame and Parquet:")
print(cdf.query(sql="select * from __tbl1__ t1 join __tbl2__ t2 on t1.a = t2.c"
, tbl1=df1, tbl2=cdf.Table(parquet_path='df2.parquet')))
v0.13 - Получение статистики запросов, например, rows_read, bytes_read, time elapsed.
# Query read_rows, read_bytes, elapsed time
data= "file('hits_0.parquet', Parquet)"
sql = f"""SELECT RegionID, SUM(AdvEngineID), COUNT(*) AS c, AVG(Resoluti
onWidth), COUNT(DISTINCT UserID)
FROM {data} GROUP BY RegionID ORDER BY c DESC"""
res = chdb.query(sql)
print(f"\nSQL read {res.rows_read()} rows, {res.bytes_read()} bytes, elapsed
{res.elapsed()} seconds")
v0.14 - Python UDF (пользовательские функции)
from chdb.udf import chdb_udf
from chdb import query

@chdb_udf()
def sum_udf(lhs, rhs):
   return int(lhs) + int(rhs)
print(query("select sum_udf(12,22)"))
Планы на будущее
chDB была обновлена до ClickHouse 23.6 в версии 0.11, производительность выполнения SQL на Parquet увеличилась в разы. Но подождите, это еще не все! Всего несколько дней назад мы удостоверились в том, что ClickHouse 23.8 еще больше оптимизировал производительность Parquet с помощью "Parquet filter pushdown". Итак, chDB с ClickHouse 23.8 совсем скоро будет доступен абсолютно всем желающим!
Кроме того, мы очень рады тесному сотрудничеству с командой ClickHouse по следующим направлениям:
- Максимально возможное уменьшение общего размера установочного пакета chDB (в настоящее время он сжат до 100 МБ, в этом году мы надеемся сократить его до 80 МБ);
- Добавление табличных функций и UDAF (User-Defined Aggregate Functions) в chDB;
- chDB уже поддерживает использование Pandas Dataframe в качестве входных и выходных данных, и мы будем продолжать оптимизировать производительность в этой области.
Приглашаем всех желающих попробовать chDB в действии. Будем очень рады Вашей звездочке на GitHub.
На сегодняшний момент chdb.io насчитывает 10 проектов, каждый из которых является преданным фанатом ClickHouse. Мы - группа хакеров, "генерирующих исключительные возможности с любовью"! Наша цель состоит в том, чтобы создать самую мощную и высокопроизводительную встроенную базу данных в мире!


