

CI/CD и инциденты в аналитике
В маленьких компаниях (командах) все просто, если что-то сломалось - взяли и починили. Авось никто и не заметит. А вот в больших командах и организациях все по-другому. Как правило, аналитическое решение (хранилище данных) это не business critical и может не работать целый день, пользователи потерпят. Но если ломается часто, то уже нужно что-то с этим делать, и самая лучшая стратегия пофиксить все начать использовать процессы для работы с инцидентами, прям как на картинке. Обычно используют уже готовое решение от back-end/devops, такие как PagerDuty и другие, сразу появляется новая обязанность - on-call, нужно писать сообщение бизнес пользователям о поломках и обещать, что однажды все будет лучше.
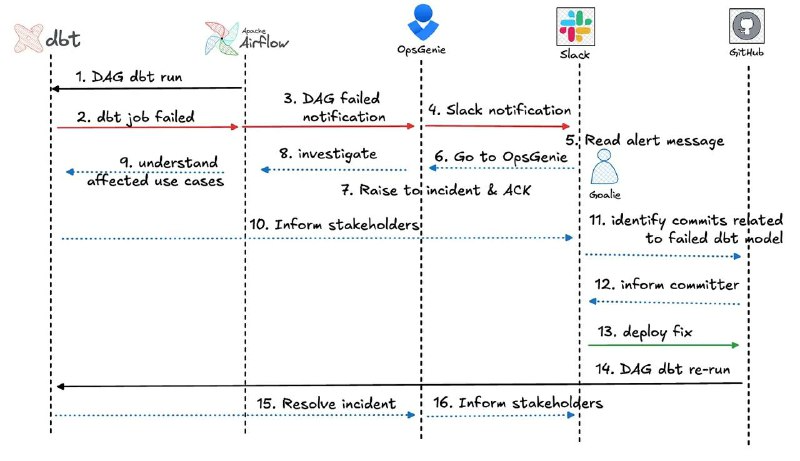
Можно все автоматизировать, и примерно будет так работать:
- Alert о падение data pipelines или отклонении показателя (качество данных)
- Заводится новый инцидент, создается Slack канал с номер инцидента и туда добавляются инженеры
- Обсуждается проблема и решение
- Ответственный пишет в другой slack канал пользователям (бизнес) о проблеме и estimation когда ее починят
- Команда все чинит, деплоит фикс, перезапускает data pipelines и вроде к обеду уже можно открывать BI дашборды.

Это уже зрелая организация. У всех компаний есть с этим проблемы, кто-то раньше, кто-то позже к этому приходит, а потом еще SLA внедрят для надежности (спокойствия бизнес пользователей). Главное отличие от backend/devops - вы все это делаете в рабочие часы, а не ночью (хотя помню в Lamoda мне в 4 утра могли звонить, что отчет поверх backend Postgres для склада в SAP BO не показывает свежие данные). Одна из причин, почему DevOps, SRE позиции не очень полезны для здоровья long term, и обычно никто не компенсирует ночные часы.


