

ClickHouse и Iceberg Lakehouse: производительная, доступная и прозрачная аналитика данных
Мир аналитики данных стремительно меняется. На смену традиционным подходам к построению хранилищ приходят гибкие архитектуры нового поколения — lakehouse. В центре этих изменений — форматы открытых таблиц, такие как Apache Iceberg, и современные аналитические СУБД, такие как ClickHouse.
Наша компания — эксперт в построении высокопроизводительных и экономичных решений на базе ClickHouse. В 2025 году мы предлагаем заказчикам новую архитектурную парадигму: интеграцию ClickHouse с Iceberg Lakehouse — как оптимальный путь к масштабируемой, прозрачной и облачно-нейтральной аналитике.
Почему Iceberg и почему ClickHouse
Apache Iceberg — это открытый формат таблиц, разработанный для отказа от ограничений традиционных файловых подходов в data lake. Он поддерживает:
- схематическую эволюцию;
- ACID-операции;
- тайм-тревел;
- управление удалениями и обновлениями;
- работу с метаданными на миллиарды строк.
ClickHouse — это аналитическая СУБД с колоночным хранением и мгновенной скоростью запросов, идеально подходящая для real-time аналитики, отчётности, мониторинга и даже построения BI-витрин.
Объединяя Iceberg и ClickHouse, вы получаете:
- низкую стоимость хранения в объектах S3;
- высокую скорость доступа через ClickHouse;
- отказ от vendor lock-in;
- независимость от коммерческих lakehouse-платформ.

Архитектуры и сценарии использования
Мы выделяем три ключевых архитектурных сценария интеграции ClickHouse и Iceberg.
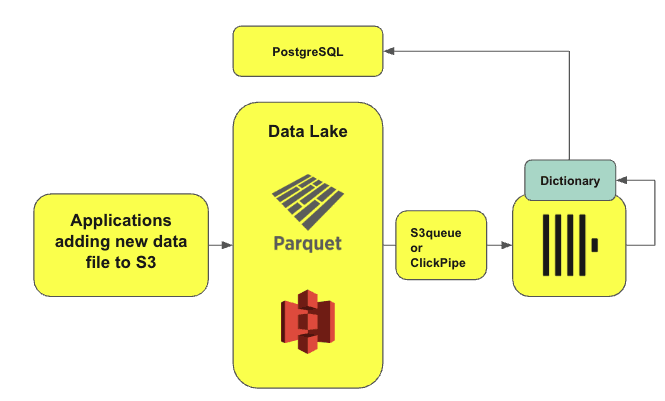
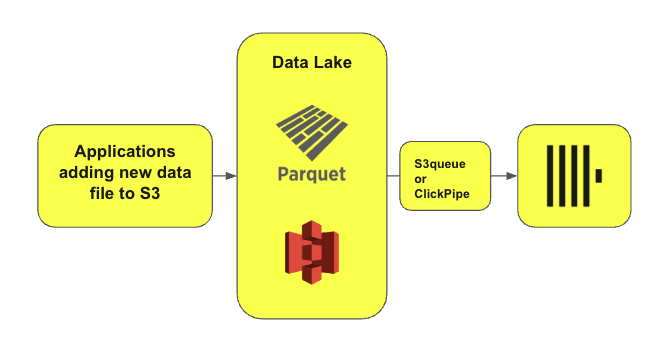
1. Загрузка данных из Iceberg в ClickHouse
Подходит для систем, которым требуется высокая скорость аналитики и быстрая агрегация данных.
Типовой стек:
- Источник: Iceberg на S3 или HDFS
- Средства: ClickPipes + s3Queue
- Приёмник: MergeTree-таблицы ClickHouse
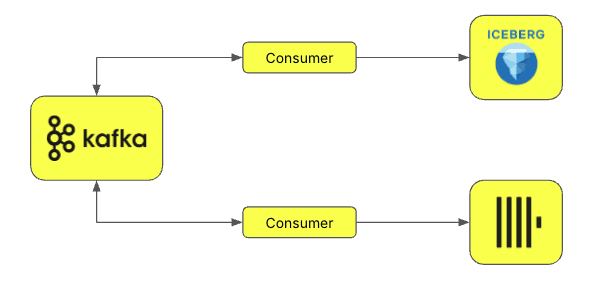
Пример: e-commerce компания использует Kafka для потоковой передачи заказов. Данные пишутся параллельно в Iceberg (архив) и ClickHouse (оперативный анализ).
Преимущества:
- Изоляция горячих и холодных данных
- Быстрая аналитика без дублирования хранилищ
- Механизм exactly-once семантики загрузки
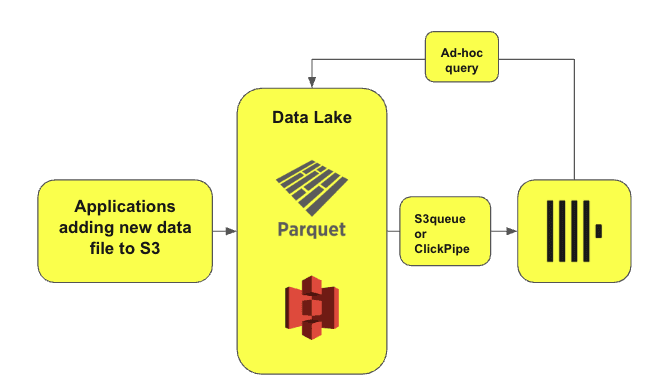
2. Ad-hoc и федеративные запросы к Iceberg
Подходит для нерегулярного доступа к большим архивам — например, в аудитах, проверках или исследовательских задачах.
Типовой стек:
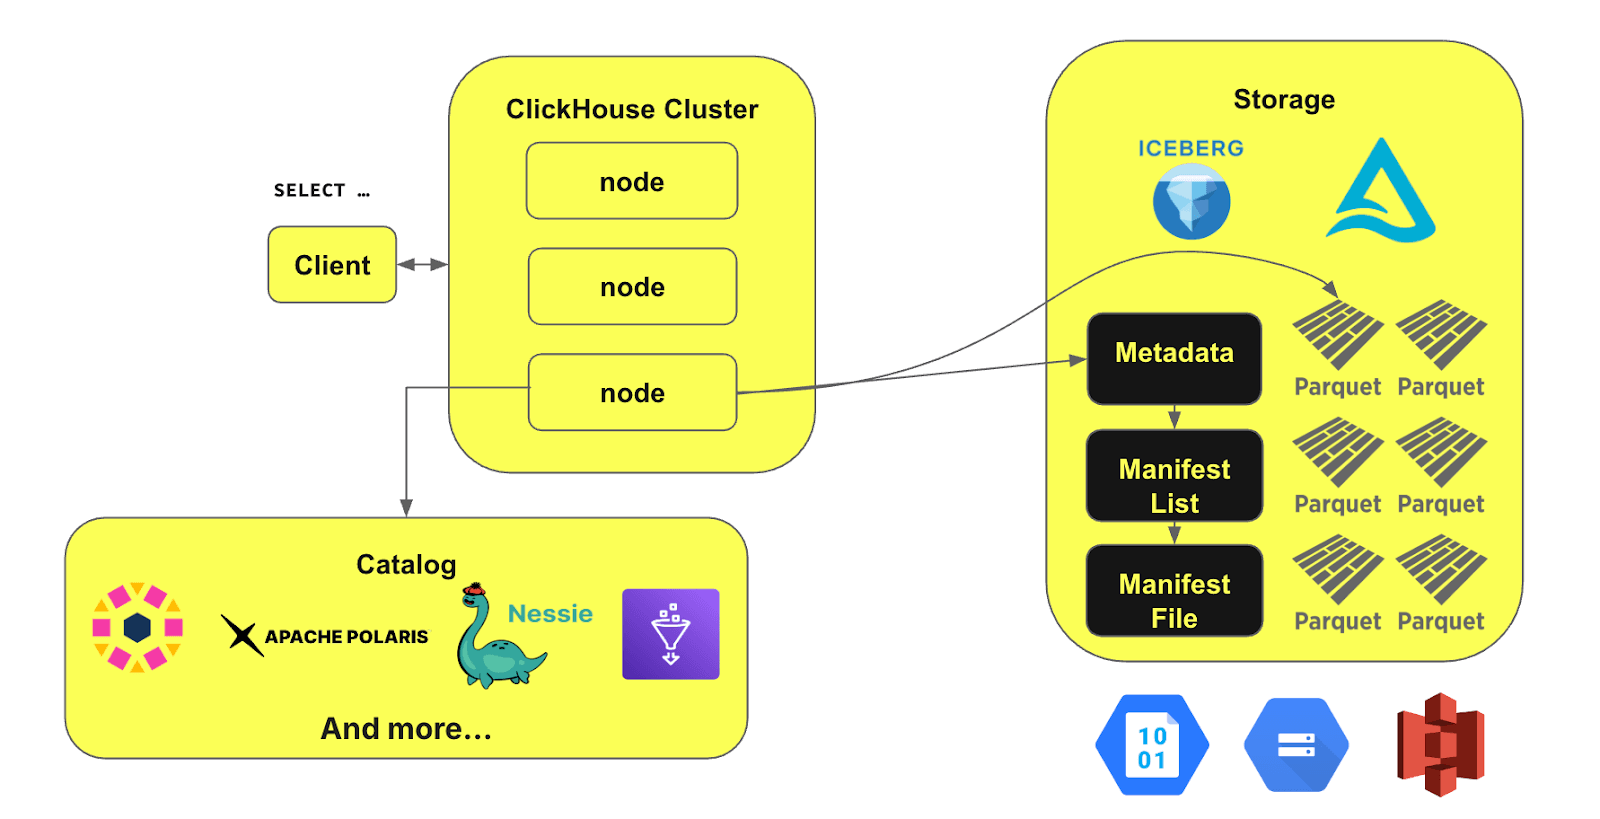
- Источник: Iceberg-таблицы (S3 + Polaris Catalog)
- Средства: icebergCluster, s3Cluster
- BI или ClickHouse клиент для запросов
Пример: банк проводит проверку операций по конкретному клиенту за последние 18 месяцев. Основные данные в ClickHouse, архив — в Iceberg.
Преимущества:
- Нет необходимости дублировать данные в ClickHouse
- Упрощённый доступ к истории через SQL
- Поддержка REST-каталогов и Polaris
3. Частые запросы к Iceberg через ClickHouse
Используется, когда хранилище данных полностью построено на Iceberg, но необходим быстрый инструмент для SQL-анализа и BI.
Типовой стек:
- Источник: Iceberg на S3 или в Snowflake Polaris
- Средства: Iceberg table engine, каталогизация
- BI-интерфейс: Superset, ClickHouse Cloud, Grafana
Пример: финансовый агрегатор хранит десятки TB данных в Iceberg. ClickHouse подключается к Polaris и обеспечивает SQL-доступ в обход API.
Практический пример: подключение к Polaris
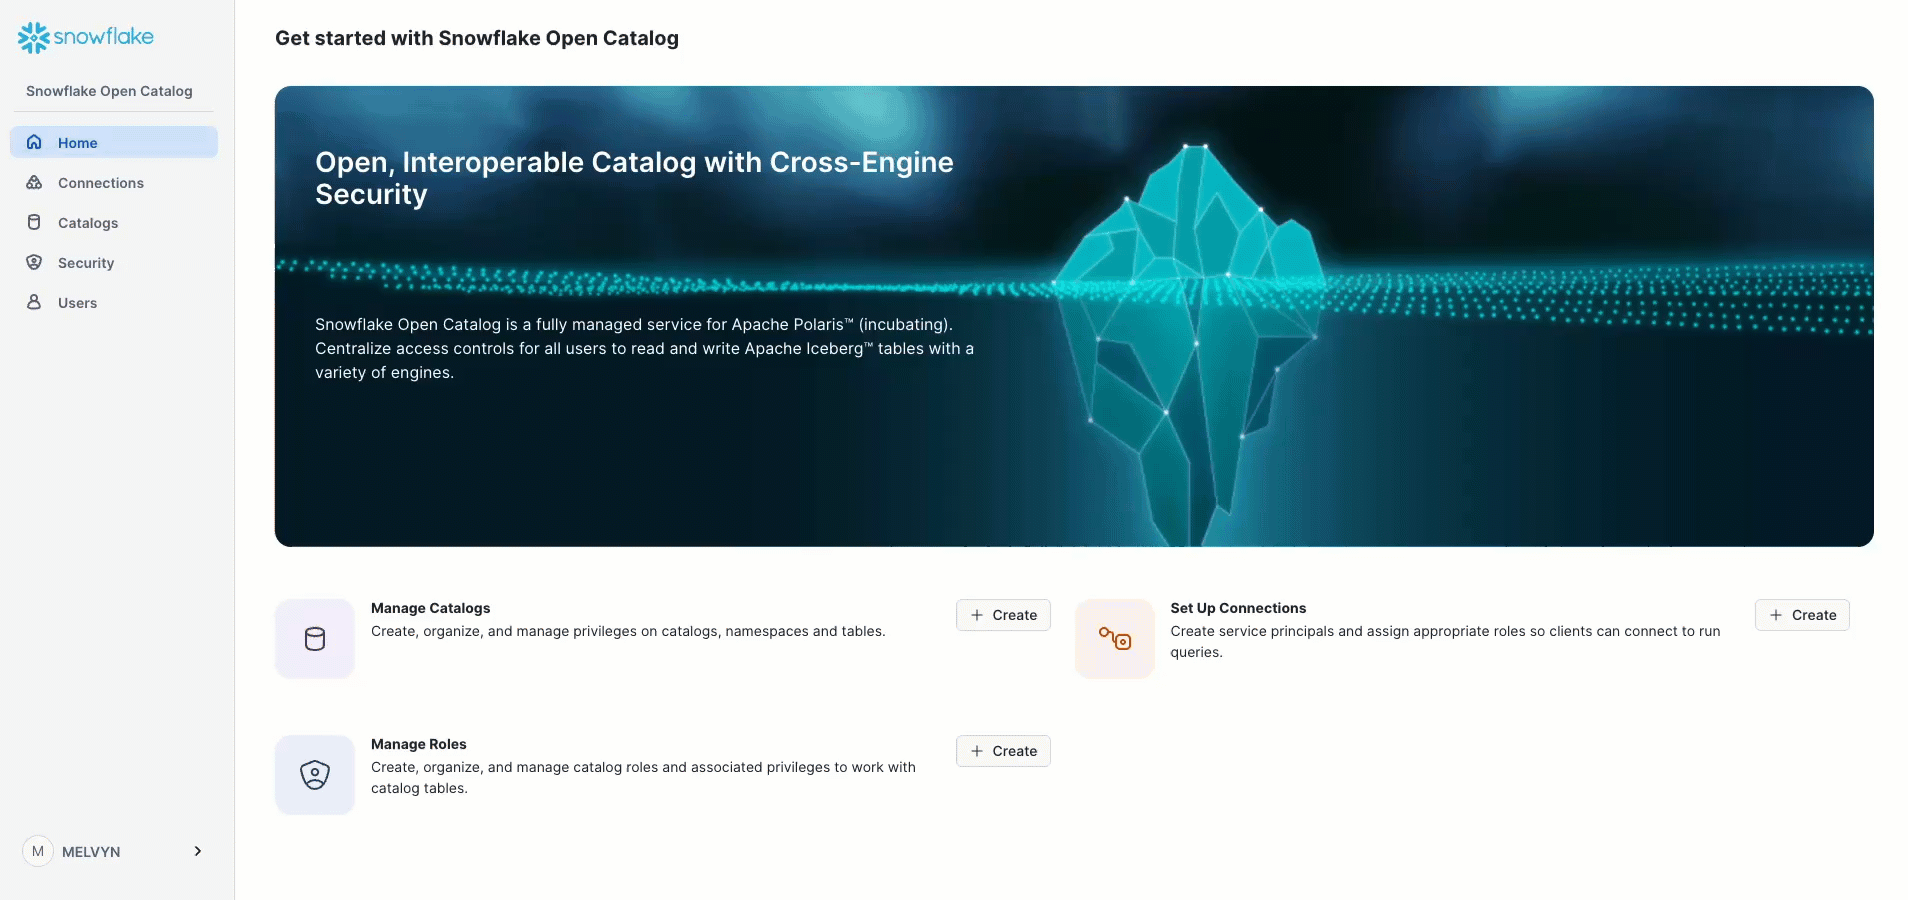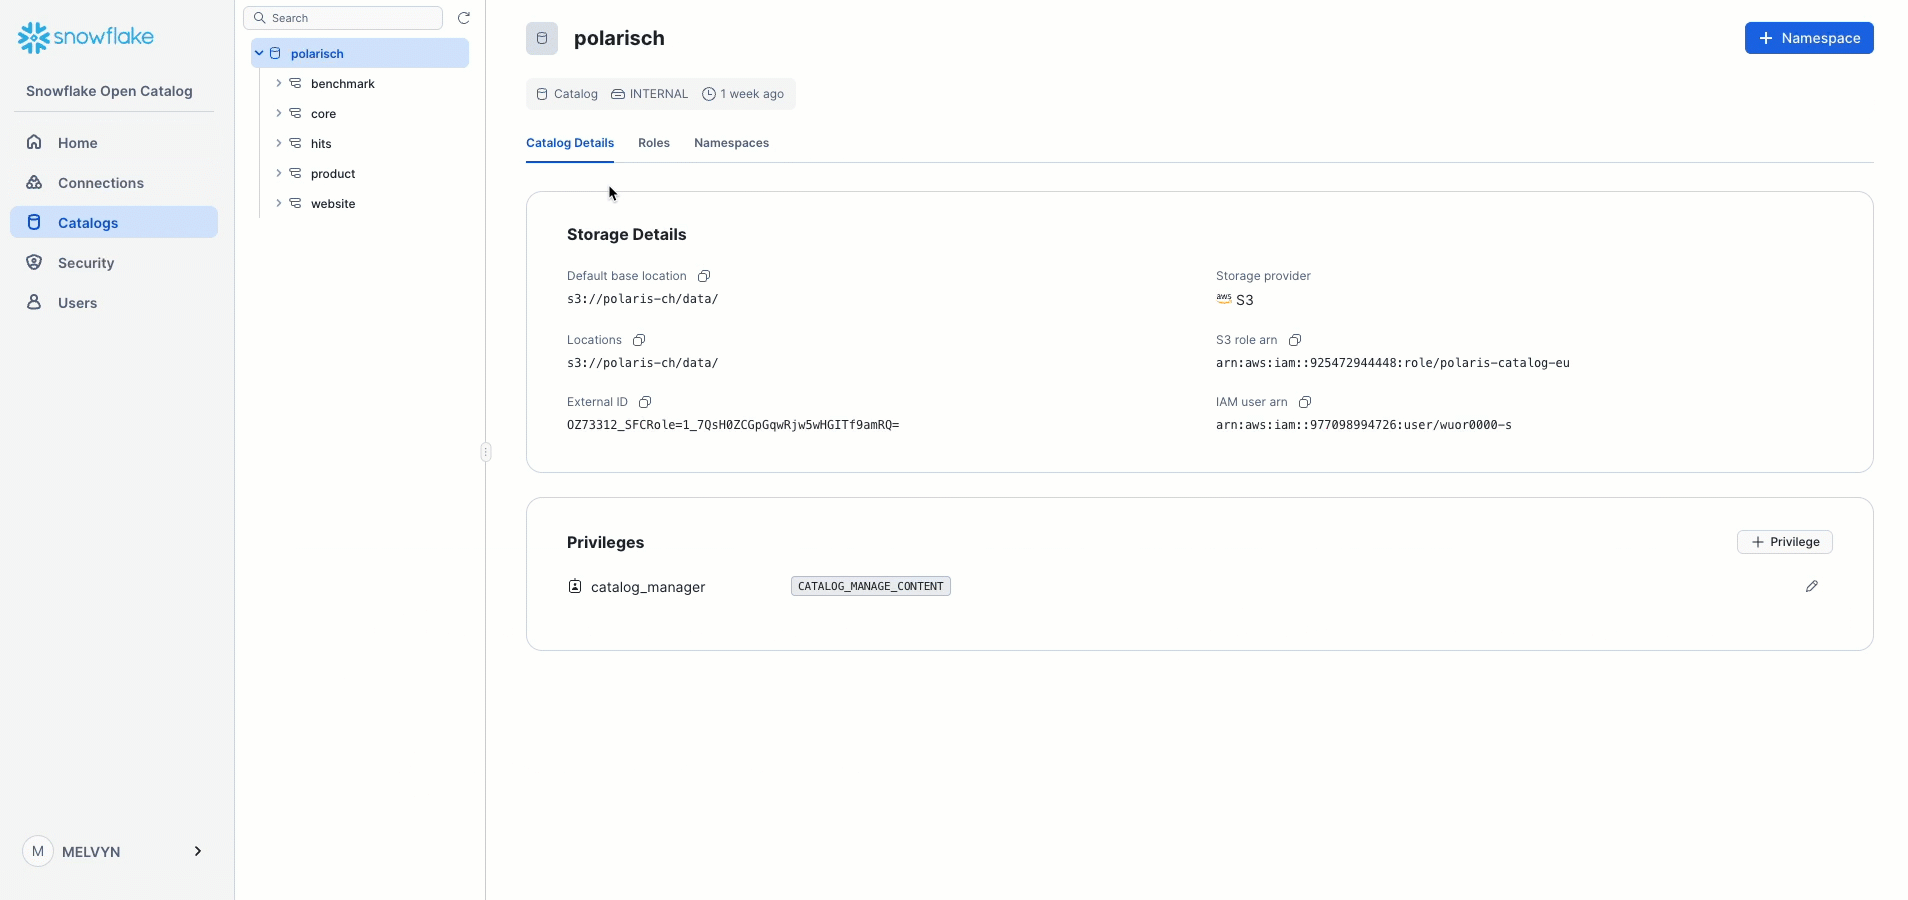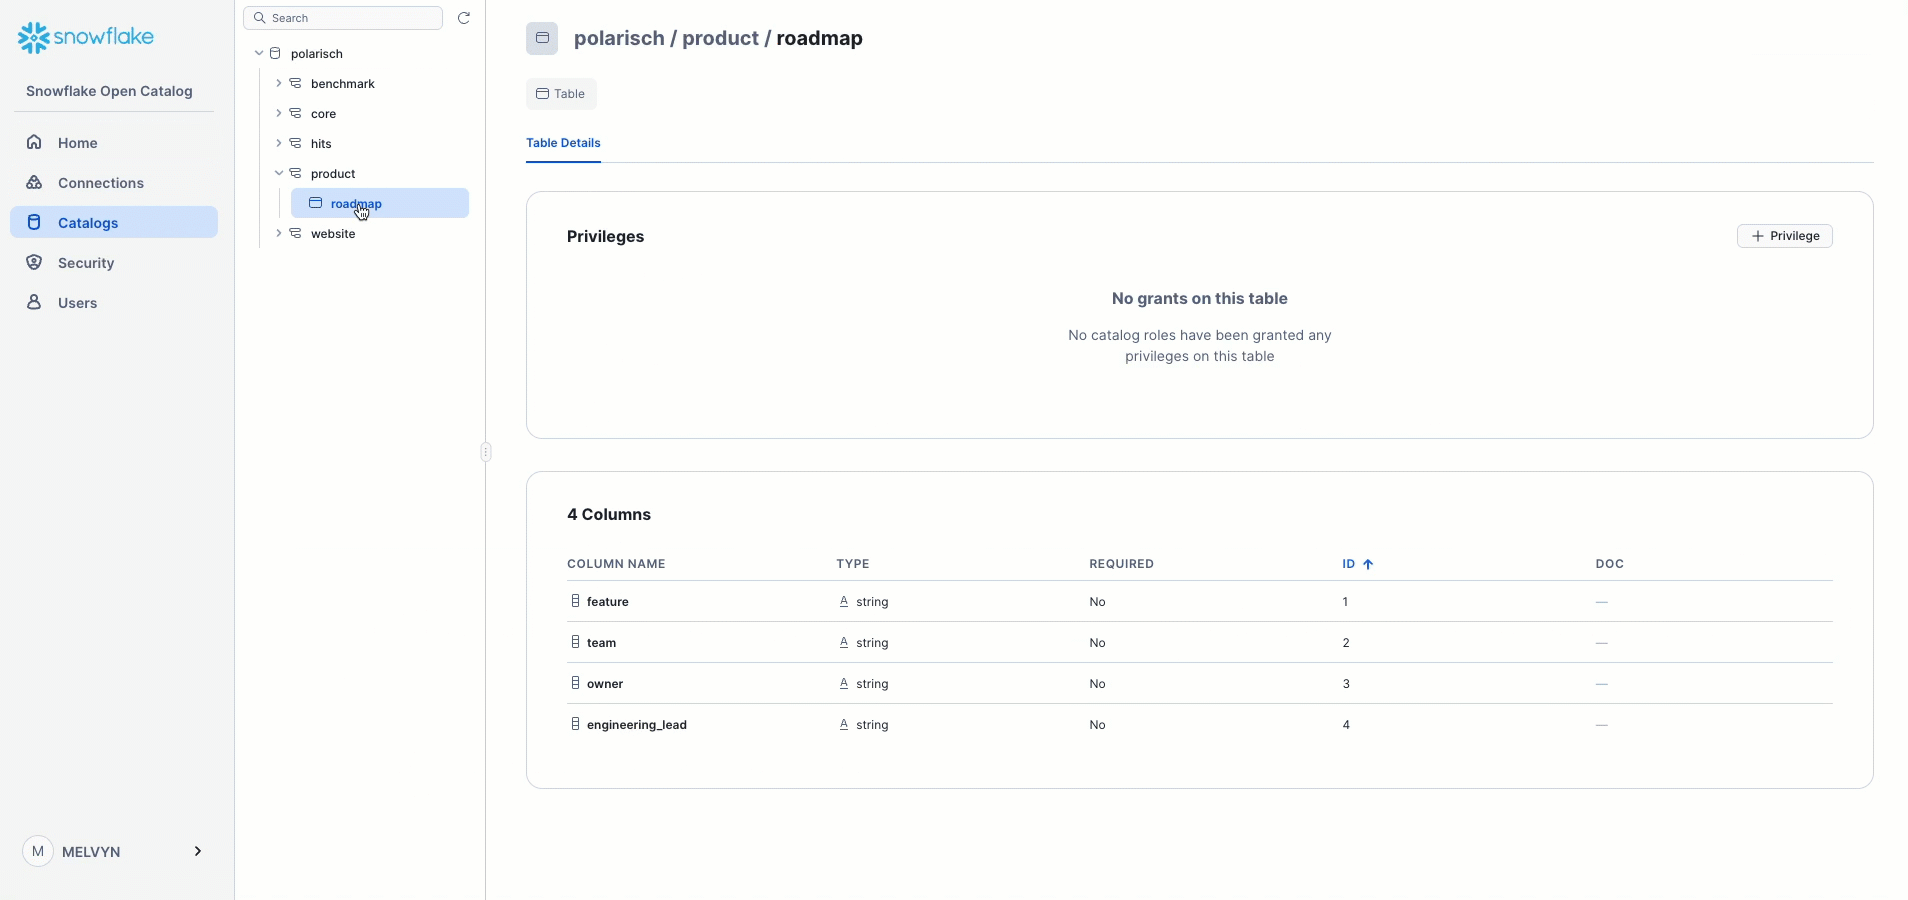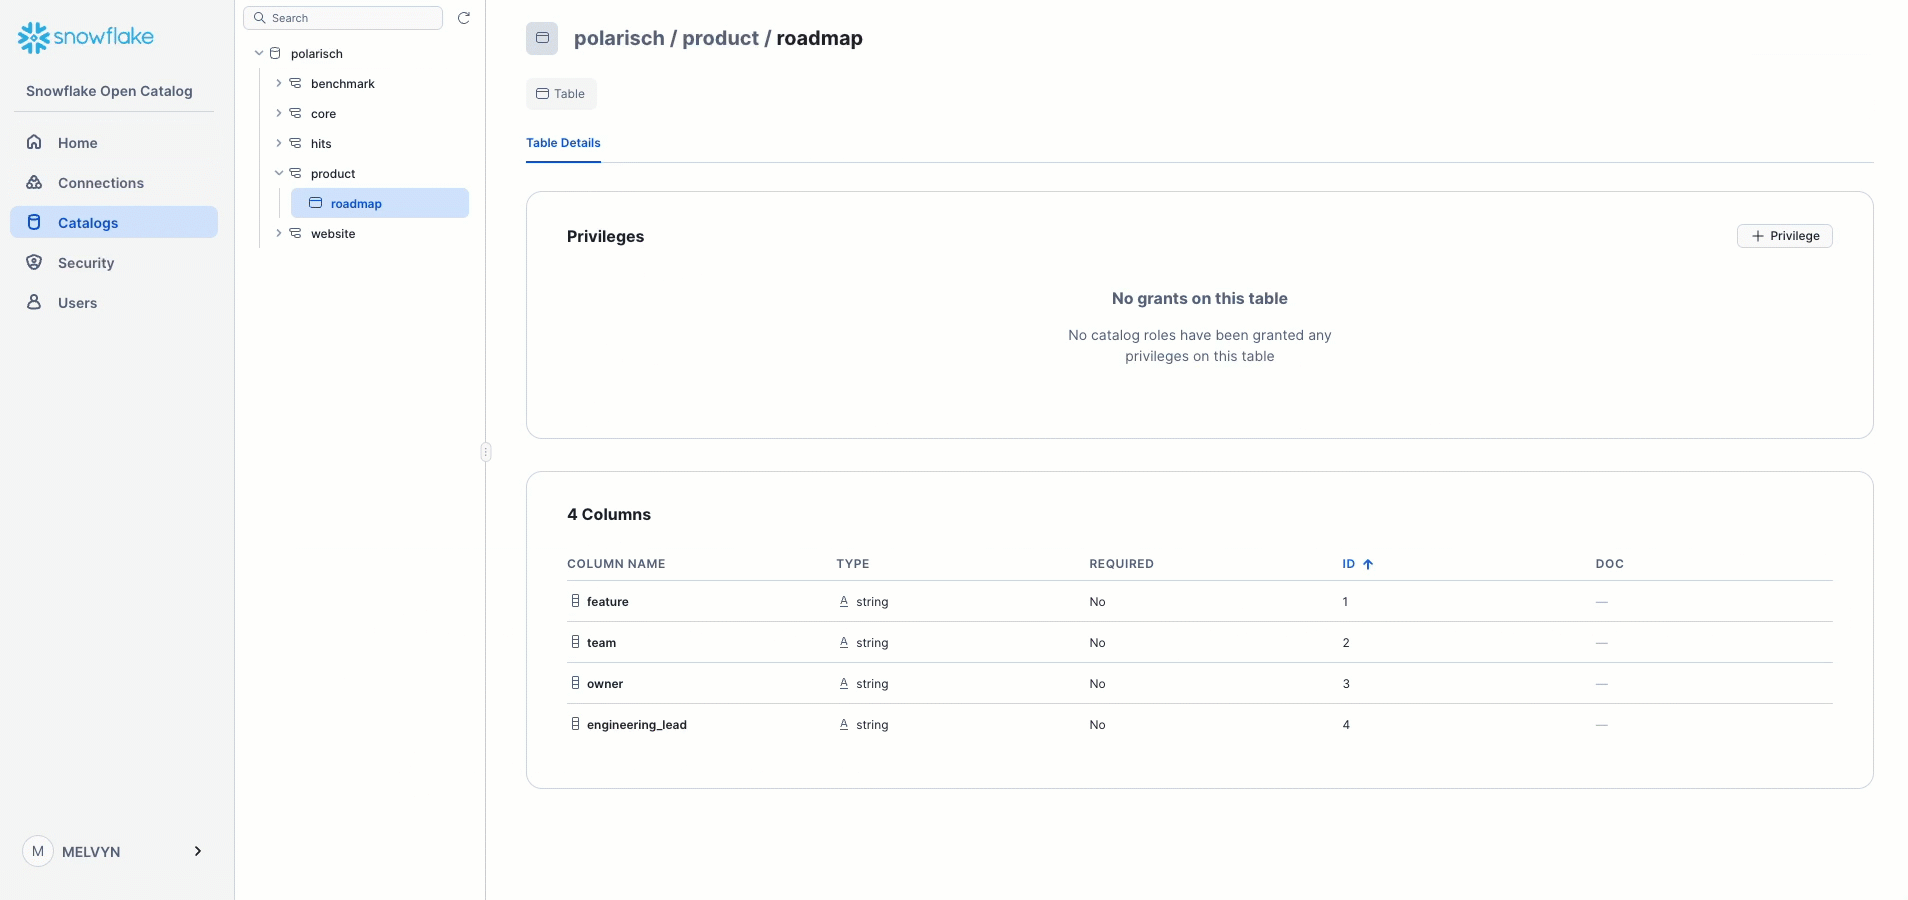
Поддержка REST-каталогов появилась в ClickHouse с версии 24.12. Подключение занимает пару минут:
CREATE DATABASE catalog
ENGINE = Iceberg('https://polaris.api/catalog/v1')
SETTINGS catalog_type = 'rest',
         catalog_credential = '<your_token>',
         warehouse= 'polarisch';
Далее можно выполнять:
SHOW TABLES FROM catalog;
SHOW CREATE TABLE catalog.`product.roadmap`;
SELECT * FROM catalog.`product.roadmap` WHERE feature ILIKE '%Lakehouse%';
Результаты можно обрабатывать, визуализировать или транслировать в ClickHouse-таблицы через materialized views.
Что такое Polaris и зачем важно его подключение к ClickHouse
Polaris — это открытый каталог (catalog), разработанный Snowflake для управления метаданными в форматах Apache Iceberg. Он основан на спецификации Iceberg REST Catalog, поддерживает хранение и публикацию Iceberg-таблиц и позволяет обращаться к ним из различных аналитических движков: Trino, Spark, Dremio, Flink и теперь — ClickHouse.
Polaris выполняет две ключевые роли:
- Регистр метаданных: где находятся таблицы, какая у них структура, версии схем, партиционирование, ACL и т. д.
- Центральная точка доступа: Polaris позволяет использовать одну точку подключения (endpoint), чтобы управлять всеми Iceberg-таблицами — без необходимости знать точные пути к S3.
Это аналог Unity Catalog в Databricks или AWS Glue Data Catalog в экосистеме AWS, но ориентированный именно на Iceberg и с открытым API.
Зачем нужно подключение ClickHouse к Polaris
Ранее ClickHouse уже умел работать с Iceberg, но для этого требовалось вручную указывать путь к каждой таблице и ключи доступа. Это подходило для тестов и узких задач, но не масштабировалось на корпоративные lakehouse-архитектуры.
Подключение к Polaris решает это ограничение. Оно позволяет:
- Автоматически обнаруживать таблицы Iceberg, доступные в каталоге;
- Работать с именованными пространствами (namespaces): как с базами и схемами;
- Централизованно управлять доступами, авторизацией и аудитом;
- Обеспечить совместимость с другими инструментами (Trino, Spark, dbt).
Теперь ClickHouse становится полноценным участником экосистемы Polaris.
Выгоды для клиентов
|
Выгода |
Подробности |
|---|---|
|
Автоматическое обнаружение таблиц |
Нет необходимости вручную настраивать каждый путь к S3. Таблицы регистрируются в Polaris и становятся доступны в ClickHouse через SHOW TABLES. |
|
Централизованное управление доступом |
Polaris поддерживает уровни доступа к таблицам и полям, можно использовать IAM-профили, OAuth и др. |
|
Совместимость с другими аналитическими инструментами |
Один каталог — единая точка подключения для Spark, Trino, dbt, ClickHouse. Нет дублирования метаданных. |
|
Ускорение аналитики |
Возможность настроить federation и выбирать нужные таблицы прямо из ClickHouse, не трогая облачное хранилище напрямую. |
|
Масштабируемость и модульность |
Вы можете наращивать количество таблиц и отделов, не меняя архитектуру. Polaris управляет всем. |
|
Облачная нейтральность |
Polaris и ClickHouse можно использовать в AWS, GCP, Azure и on-premise. |
Пример практического применения
Сценарий: финансовая организация с multi-cloud инфраструктурой
- Исторические данные операций хранятся в Iceberg-таблицах на S3.
- Каталог Polaris управляет метаданными и доступами.
- Аналитики используют ClickHouse для регулярных и adhoc-запросов — через подключение к Polaris.
- BI-системы (например, Superset) работают через ClickHouse как промежуточный слой.
- Отдельные департаменты используют Trino и Spark, но работают с тем же каталогом.
Итог — единая архитектура, разные движки, одна точка управления.
Текущие ограничения и roadmap ClickHouse
Проблемы:
- Нет поддержки удалений и изменений (DELETE/UPDATE) в Iceberg
- Нет полноценной write-поддержки из ClickHouse в Iceberg
- Каталоги пока в стадии активной разработки
- Нет поддержки CDC из Iceberg как источника
План на 2025 год:
- Поддержка Glue и Unity Catalog
- Механизмы write-операций в Iceberg (MergeTree → Iceberg)
- CDC-репликация из Iceberg в ClickHouse через ClickPipes
- Гранулярное распределение Parquet-запросов в кластере
- Оптимизация поддержки формата Parquet
- Материализованные представления поверх Iceberg
- Интеграция со Spark, Trino и DBT как часть экосистемы
Риски внедрения
При всей перспективности Iceberg + ClickHouse, важно учитывать:
|
Риск |
Описание |
Как мы решаем |
|---|---|---|
|
Недостаточная зрелость поддержки Iceberg в ClickHouse |
В ряде случаев возможны ограничения по функционалу |
Используем комбинации double-write (Kafka → ClickHouse + Iceberg) и fallback на ingestion |
|
Требования к DevOps/инфраструктуре |
Iceberg требует корректной настройки каталогов, IAM, S3 |
Предоставляем IaC-модули и best practices |
|
Iceberg не имеет C++-библиотеки |
Ограничивает глубокую поддержку в ClickHouse (удаления, CDC) |
Обходим через Rust-биндинги и подключение CDC через сторонние механизмы |
Почему это выгодно клиентам
Экономия
- S3 или облачные сторы на порядок дешевле ClickHouse-native хранения
- Можно хранить petabyte-архивы в cold-режиме и платить только за доступ
Производительность
- Быстрые запросы к горячим данным — ClickHouse-native
- Возможность комбинировать cold/hot запросы — гибкая архитектура
Прозрачность
- Открытые форматы таблиц — Iceberg, Parquet, ORC
- Отсутствие вендорных замков: Polaris, Glue, Unity, Trino
Интеграция
- Поддержка Kafka, Spark, Airflow, Trino, dbt
- ClickPipes обеспечивает потоковую синхронизацию между источниками
Как мы помогаем
Наша команда предлагает услуги по полному циклу внедрения:
|
Услуга |
Описание |
|---|---|
|
Консалтинг |
Поможем выбрать архитектуру lakehouse и инструменты |
|
Разработка |
Настроим ClickHouse, Iceberg, каталоги, ingestion |
|
DevOps & IaC |
Создание среды через Terraform, CI/CD пайплайны |
|
Производство |
Мониторинг, инциденты, SLA |
|
Обучение |
Проведём обучение по эксплуатации lakehouse и ClickHouse |
Интеграция ClickHouse с Iceberg — это не просто тренд. Это зрелая, масштабируемая и экономичная альтернатива традиционным DWH и lakehouse-решениям на базе Spark и Databricks.
В 2025 году, с учётом активной разработки поддержки Iceberg, каталогов и write-операций, ClickHouse становится серьёзным игроком в парадигме открытых lakehouse-архитектур.
Мы предлагаем клиентам безопасный путь миграции, гибкие варианты построения архитектуры, поддержку на всех этапах и, самое главное, — результат, измеряемый в производительности, снижении TCO и отказе от проприетарных решений.
Если вы хотите обсудить, как внедрить Iceberg + ClickHouse в вашей компании — свяжитесь с нашей командой. Мы проведём аудит текущей архитектуры, подберём подходящие сценарии и внедрим решение с гарантией результата.


