

Производительность и конфигурации: тюнинг StarRocks и Kubernetes
StarRocks как аналитическая платформа с распределенным исполнением запросов требует особого подхода к настройке в контейнеризированной среде. В Kubernetes удается достичь зрелой производительности и устойчивости при условии грамотной синхронизации параметров хранения, планирования ресурсов, сетевых взаимодействий и механизмов эксплуатации. Глава фокусируется на архитектурных принципах, протоколах взаимодействия и практических методах настройки, которые позволяют не только достичь требуемой скорости обработки больших объемов данных, но и обеспечить предсказуемость поведения системы в реальных условиях эксплуатации.
Краткое введение
В Kubernetes StarRocks разделяет обработку запросов и хранение данных между FE-узлами и BE-узлами, что приводит к характерной схеме горизонтального масштабирования. Эффективная эксплуатация требует ясного разделения ответственности между компонентами, правильной конфигурации памяти и CPU, продуманной политики хранения и надежного мониторинга. В этой главе рассмотрены архитектурные решения и практические шаги по настройке уровня кластера, параметров ядра и политик автоматизации, которые позволяют добиться высокой пропускной способности, малой задержки и устойчивости к сбоям.
- Краткое содержание главы
- Архитектура и конфигурации StarRocks в Kubernetes: принципы распределения ролей FE/BE, Networking, хранение данных и управление конфигурациями.
- Управление ресурсами и планировщик Kubernetes: ресурсы, квоты, размещение, масштабирование и устойчивость к сбоям.
- Оптимизация производительности чтения и записи: планирование запросов, индексы, материализованные представления и режимы загрузки данных.
- Механизмы автоматизации и эксплуатационные практики: мониторинг, резервное копирование, обновления, резервирование и аварийные сценарии.
- Интеграции и практические сценарии эксплуатации: безопасность, интеграции с конвейерами данных и сценарии внедрения.
Архитектура и конфигурации StarRocks в Kubernetes
Архитектурные принципы
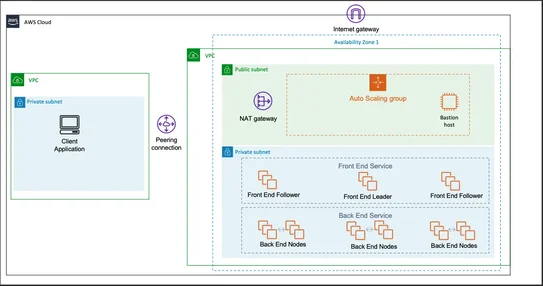
StarRocks реализует разделение ролей между Frontend (FE) и Backend (BE). FE отвечает за компиляцию запросов, оптимизацию плана и управление метаданными, тогда как BE исполняет вычисления и обращается к хранилищу данных. В Kubernetes эта архитектура проявляется в виде отдельных наборов StatefulSet или Deployment для FE и BE, сопутствующих сервисов и ConfigMap-ов, управляющих конфигурациями.
Ключевые принципы включают:
- 분리된 состояния FE и BE: FE чаще работает как статический сервис конфигурации и планирования, BE — как динамический вычислительный слой.
- Бесперебойность через репликацию: несколько FE-узлов обеспечивают HA каталога, BE-узлы — параллельную обработку и устойчивость к сбоям дисков.
- Механизмы согласованности: центральный каталог (метаданные) синхронизируется между FE, BE и внешними хранилищами, обеспечивая единый источник правды для планирования и прочего.
- Внешние клиенты и протоколы: клиенты подключаются через совместимые с MySQL протоколы (JDBC/ODBC), а внутренняя связь FE↔BE строится на brpc‑потоках с оптимизированными путями передачи данных и выполнения.
Почему это важно в Kubernetes: распределение ролей, читаемая конфигурация и четкая граница между слоями позволяют гибко подбирать ресурсы под конкретные нагрузки, упрощают обновления и пространственно отделяют данные от вычислений, что критично для устойчивого масштабирования.
Размещение компонентов в Kubernetes
Для эффективной эксплуатации необходим выбор между StatefulSet и Deployment в зависимости от требований к сохранению данных и скорости обновления. StatefulSet предпочтительнее для BE-узлов, FE‑узлы могут жить в Deployment, но часто располагаются также в StatefulSet для сохранения идентичности узлов и стабильности имен.
Основные принципы размещения:
- Данные BE размещаются на устойчивых томах (PersistentVolume), предпочтительно с локальным доступом к IOPS и пропускной способности.
- FE может быть реплицирован через StatefulSet, чтобы сохранить согласование состояний метаданных и предотвратить конфликты планирования.
- Сервисы типа ClusterIP образуют абстракцию доступа внутри кластера; headless-сервисы позволяют напрямую обращаться к конкретным узлам BE/FE для сценариев мониторинга и관리.
- Выбор сетевых политик и ограничений QoS (уровень CPU/memory) критически важен для предотвращения перегрузки узлов и балансировки трафика между FE и BE.
Ниже приведен упрощенный пример конфигурации Kubernetes (value‑пример, не является полностью работоспособным набором), иллюстрирующий принципы размещения FE и BE и параметры ресурсов. Реальная конфигурация зависит от версии StarRocks и инфраструктуры.
apiVersion: apps/v1
kind: StatefulSet
metadata:
  name: starrocks-be
spec:
  serviceName: "starrocks-be"
  replicas: 3
  selector:
    matchLabels:
      app: starrocks-be
  template:
    metadata:
      labels:
        app: starrocks-be
    spec:
      containers:
      - name: starrocks-be
        image: starrocks/starrocks:latest
        ports:
        - containerPort: 9000
        - containerPort: 9010
        resources:
          requests:
            memory: "8Gi"
            cpu: "2"
          limits:
            memory: "12Gi"
            cpu: "4"
        volumeMounts:
        - name: data
          mountPath: /var/starrocks/be
      volumes:
      - name: data
        persistentVolumeClaim:
          claimName: starrocks-be-pvc
apiVersion: apps/v1
kind: StatefulSet
metadata:
  name: starrocks-fe
spec:
  serviceName: "starrocks-fe"
  replicas: 2
  selector:
    matchLabels:
      app: starrocks-fe
  template:
    metadata:
      labels:
        app: starrocks-fe
    spec:
      containers:
      - name: starrocks-fe
        image: starrocks/starrocks:latest
        ports:
        - containerPort: 9030
        resources:
          requests:
            memory: "4Gi"
            cpu: "1"
          limits:
            memory: "6Gi"
            cpu: "2"
        volumeMounts:
        - name: data
          mountPath: /var/starrocks/fe
      volumes:
      - name: data
        persistentVolumeClaim:
          claimName: starrocks-fe-pvc
apiVersion: v1
kind: Service
metadata:
  name: starrocks-fe
spec:
  selector:
    app: starrocks-fe
  ports:
  - port: 9030
    targetPort: 9030
apiVersion: v1
kind: Service
metadata:
  name: starrocks-be
spec:
  selector:
    app: starrocks-be
  ports:
  - port: 9000
    targetPort: 9000
Примечание: приведенная конфигурация демонстрирует общую структуру размещения FE и BE в Kubernetes и не покрывает всех аспектов, включая сетевые политики, настройки безопасности и мониторинга. В реальной среде применяются Helm-чарт StarRocks или Operator, которые автоматизируют разворачивание, конфигурацию и обновления.
Конфигурационные параметры и управление ими
Управление конфигурацией в Kubernetes стандартно реализуется через ConfigMaps и переменные окружения, которые переопределяют поведение компонентов StarRocks. Ключевые направления настройки включают:
- память и CPU: определение memory.request и memory.limit на уровне FE/BE, чтобы обеспечить необходимый буфер под выполнение запросов и загрузку данных.
- параметры планирования: настройка числа параллельных потоков, очередей и степени параллелизма для BE‑узлов, чтобы балансировать нагрузку между запросами и выгрузкой данных.
- режим выполнения: включение pipeline engine, оптимизация планов, настройка режимов выбора алгоритмов соединения и агрегаций.
- хранение и I/O: параметры для настройки стратегии сжатия, форматов хранения, размерности блоков (row/column), политики сжатия и отката.
- сетевые параметры: timeouts, keep-alive, retry‑периоды и лимиты соединений, которые влияют на устойчивость к задержкам в сети и перегруженным каналам.
Конфигурации централизованно управляются через ConfigMaps и Helm values. В контексте Kubernetes важно поддерживать согласованность между версиями StarRocks, Helm-значениями и инфраструктурными параметрами (NodePort/LoadBalancer, сетевые политики, квоты).
Чтобы проиллюстрировать подход, ниже приведен фрагмент описания параметров в виде сопроводительного блока, который можно поместить в ConfigMap или Helm values. В этом примере отражены ключевые направления: контроль памяти, параллелизм и режим выполнения. Конкретные названия параметров зависят от версии и поставщика образа StarRocks.
config:
  enable_vector_engine: true
  be_memory_limit: "12Gi"
  fe_memory_limit: "6Gi"
  max_parallelism: 64
  query_timeout_ms: 30000
  enable_materialized_views: true
  storage_format: "parquet"
Важно помнить, что принципы размещения и конфигурации должны соответствовать требованиям конкретной рабочей нагрузки: аналитические запросы часто выигрывают от увеличенного параллелизма, агрессивного кэширования и предикта-прайнинга, тогда как ETL‑потоки требуют устойчивого ввода/вывода и контроля памяти.
Управление ресурсами и планировщик Kubernetes
Управление ресурсами и квоты
Эффективная работа StarRocks зависит от грамотного распределения ресурсов между FE и BE, а также адекватной конфигурации ограничений и запросов. В условиях многопользовательской среды и переменных нагрузок критически важны:
- определение минимальных и желаемых ресурсов (requests/limits) для FE и BE;
- учет пиковых нагрузок на параллельные запросы и загрузку данных;
- обеспечение достаточного запасa памяти для оперативной памяти BE и кэширования.
Kubernetes позволяет реализовать изоляцию и предсказуемость через лимиты и QoS. Важно избегать ситуаций, когда один компонент стабильно исчерпывает ресурсы в ущерб другим узлам кластера. Для корпоративных сценариев целесообразно внедрять политику резервирования на уровне кластера (Node taints, Pod Disruption Budgets) и планировать обновления так, чтобы не нарушать обслуживание.
Расположение и масштабирование
Стратегии масштабирования StarRocks в Kubernetes включают:
- горизонтальное масштабирование BE‑узлов для увеличения вычислительной мощности и пропускной способности чтения/записи.
- использование нескольких FE‑узлов для повышения устойчивости к отказам и повышения общей доступности схемы метаданных.
- динамическое масштабирование через адаптивные политики HPA и/или кастомные контроллеры. В реальных сценариях для кластера StarRocks чаще применяется горизонтальное масштабирование BE и FE, а вертикальное — для отдельных узлов с учетом ограничений памяти и CPU.
Кроме того, важна организация хранения: кластеры StarRocks требуют устойчивого доступа к данным и скорости I/O. Выбор класса хранилища (SSD, NVMe), правильная настройка RBAC и мониторинга операций ввода-вывода позволяют снизить задержки и увеличить TTL кэширования.
Мониторинг и эксплуатационные практики
Непрерывный мониторинг — основа эффективной эксплуатации. В контексте StarRocks в Kubernetes полезны:
- интеграция Prometheus и Grafana для сбора и визуализации метрик FE/BE, задержек запросов, загрузки процессора и памяти.
- сбор метрик аудита на уровне соединений, длительности операций и ошибок планирования.
- использование дашбордов для отслеживания конвейеров загрузки, состояния реплик BE и задержек в чтении данных.
Эксплуатационные практики включают:
- настройку резервного копирования и восстановления данных, включая снимки и экспорт метаданных.
- планирование профилактических обслуживаний (обновления, пропускной режим) в рамках окон обслуживания.
- обеспечение устойчивости к сбоям через репликацию и отказоустойчивые конфигурации, включая балансировку нагрузки между FE и BE.
Оптимизация производительности чтения и записи
Планирование и выполнение запросов
Производительность запросов в StarRocks определяется эффективностью планирования, архитектурой исполнения и использованием памяти. Ключевые направления оптимизации:
- статистика и селективность: актуальные статистические данные позволяют планировщику лучше выбирать алгоритмы соединения и методы сортировки; обновление статистики после больших загрузок критично для сохранения эффективности.
- выбор алгоритмов соединения: адаптивные стратегии (broadcast, shuffle) зависят от размера таблиц и распределения данных; правильный выбор снижает сетевые перенагрузки и улучшает задержку.
- использование материализованных представлений: MV-объекты ускоряют повторяющиеся аналитические запросы и снижают вычислительную нагрузку на BE.
Инженерия записи и загрузки
Для загрузки данных и поддержки консистентности важны:
- режимы загрузки (пакетная загрузка vs. потоковая) и синхронная запись в BE.
- управление параллелизмом загрузки и ограничениями для предотвращения перегрузки каталога и узлов BE.
- компрессия и формат хранения: выбор форматов хранения (Parquet/ORC) и политики компрессии влияют на размер хранения и скорость считывания.
Оптимизация памяти и кэширования
Эффективное использование памяти включает:
- размер кеша кэширования данных BE и кэширования плана запроса.
- настройку memory pool и лимитов, чтобы обеспечить достаточную буферизацию, но не выжигать ресурсы узлов.
- мониторинг утечек памяти и коррекция параметров, чтобы избежать частых сборок мусора и задержек.
В рамках Kubernetes это особенно важно: чрезмерное потребление памяти на BE может привести к ремасштабированию и перезапуску подов, что повлечет простои. Включение ограничений и контролируемого масштабирования позволяет обеспечить устойчивость и предсказуемость задержек.
Примеры сценариев настройки
- Нагрузка чтения с высокой скоростью: увеличить количество BE‑узлов, увеличить параллелизм и размер кэша, использовать MV для агрегаций и предвычислений.
- Загрузка больших пакетов данных: предусмотреть буферы для загрузки, временное увеличение памяти BE, настройку I/O-политик и соответствующую настройку форматов хранения.
Механизмы автоматизации и эксплуатационные практики
Автоматизация разворачивания и обновлений
Автоматизация в Kubernetes достигается через Helm-чарты, Operator‑решения или GitOps-подходы. В рамках StarRocks ключевые аспекты:
- управление версиями образов и конфигураций: детерминированные обновления между FE и BE, минимизация простоя.
- имитации обновления: сначала обновляются одну группа FE, затем BE, с мониторингом изменений и проверкой согласованности.
- конфигурационная управления через ConfigMaps и Secrets: хранение учетных данных, ключей и подключений безопасно и централизованно.
Мониторинг и управление оперативной нагрузкой
Мониторинг выступает неотъемлемым элементом эксплуатации. Рекомендованы:
- сбор метрик латентности, пропускной способности, загрузки CPU/памяти, задержек межузловых вызовов и трафика по сети.
- автоматические алерты на пороговые значения (например, рост задержки выполнения над порог), которые позволяют оперативно реагировать на ухудшение производительности.
- журналирование операций и трассировка запросов для диагностики проблем и оптимизации планов выполнения.
Резервное копирование и восстановление
Планирование резервного копирования данных и метаданных критично для бизнес-непрерывности. В Kubernetes подход обычно связан с:
- периодическими снапшотами данных BE и экспортом метаданных FE.
- инструменты для переноса резервных копий в внешние хранилища (облачные или локальные объектные хранилища).
- тестированием восстановления в тестовой среде для проверки целостности и быстродействия восстановления.
Безопасность и сетевые аспекты
Безопасность в кластере должна быть обеспечена на нескольких уровнях:
- аутентификация клиентов (MySQL‑совместимый протокол, поддержка ролей и пользователей, TLS для клиентского канала).
- ограничение доступа через сетевые политики Kubernetes и RBAC.
- шифрование данных на диске и в транзите для чувствительных данных.
Интеграции и практические сценарии эксплуатации
Интеграции с конвейерами данных
StarRocks интегрируется с конвейерами данных через:
- коннекторы для источников данных (Kafka,并 номенклатура источников) и загрузочных трубопроводов.
- поддержка потоковой загрузки и пакетной загрузки данных; разумный выбор между ними зависит от характера нагрузки и задержек.
- использование MV и промежуточного агрегирования для ускорения аналитических задач по данным, приходящим в режиме реального времени.
Сценарии внедрения
- Аналитическая платформа BI: высокий параллелизм, поддержка больших наборов данных, быстрые ответы на бизнес-вопросы. Подход включает масштабирование BE, усиление кэширования и использование MV.
- Интеграция с существующими хранилищами: StarRocks может выступать в роли слоя агрегирования поверх данных в других системах, поэтому важны мосты доступа и согласование типов данных.
Особенности совместимости и устойчивости
- Совмещение с существующей инфраструктурой мониторинга и алертинга.
- Поддержка обновлений без остановки сервиса и минимизации потерь в рабочем процессе.
Key takeaways
- Архитектура FE/BE в Kubernetes требует явного разделения ролей, устойчивых конфигураций и продуманного размещения томов.
- Эффективность достигается через грамотное управление ресурсами, планирование параллелизма и использование MV/пакетной загрузки.
- Мониторинг, автоматизация обновлений, резервное копирование и безопасность — обязательные элементы эксплуатации.
- Выбор режимов хранения и форматов данных влияет на производительность чтения и записи, а также на общую стоимость владения.
- Интеграции с конвейерами данных и инструментами BI позволяют StarRocks стать центральной аналитической платформой в корпоративном стеке.
- В инфраструктуре Kubernetes важно учитывать устойчивость к сбоям через HA‑конфигурации FE/BE, репликацию и стратегию обновлений.
- Постоянная работа над оптимизацией планирования запросов и кэширования обеспечивает предсказуемость задержек и стабильную производительность.
FAQ
Какие основные архитектурные решения помогают улучшить производительность StarRocks в Kubernetes?
- Основные решения включают разделение ролей FE и BE, горизонтальное масштабирование BE для увеличения вычислительной мощности и пропускной способности, использование MV для ускорения повторяющихся аналитических запросов и аккуратное управление кэшированием данных и планами выполнения. В Kubernetes это реализуется через StatefulSet для BE, повторяющиеся FE, продуманное размещение на NVMe/SSD и интеграцию с мониторингом для быстрого реагирования на перегрузки.
Как выбрать между StatefulSet и Deployment для FE и BE?
- BE обычно размещают как StatefulSet, чтобы обеспечить устойчивость и уникальные идентификаторы узлов данных. FE может быть размещен как StatefulSet или Deployment в зависимости от того, насколько критично сохранять идентичность и согласованность именно FE-узлов. StatefulSet упрощает обновления и управление именами узлов, что полезно для корреляции журналов и метаданных.
Какие показатели критичны для мониторинга StarRocks в Kubernetes?
- Важны латентность выполнения запросов (P95, P99), задержки планирования, загрузка CPU/памяти на FE и BE, пропускная способность сети между FE и BE, задержки ввода-вывода, состояние репликаций BE и наличие ошибок при чтении/записи. Мониторинг должен также включать доступность метаданных и время отклика при инициализации новых узлов.
Какие параметры управления ресурсами чаще всего влияют на стабильность кластера?
- Memory limits и requests, CPU quotas, параметры параллелизма и очередей, настройки кэширования, политики обновлений и стратегий автомасштабирования. Неправильная конфигурация может привести к перегреву узлов, частым перераспределениям контейнеров и задержкам в плане выполнения запросов.
Какобеспечить безаварийные обновления кластера StarRocks в Kubernetes?
- Рекомендовано использовать последовательные обновления FE и BE, тестировать обновления в стенде, контролировать совместимость версий и поддерживать обратную совместимость клиентских протоколов. Важно иметь резервные копии и план отката, чтобы в случае нестабильности быстро вернуться к рабочей конфигурации.
Какие практики рекомендуется использовать для хранения данных StarRocks в Kubernetes?
- Использование качественных SSD/NVMe-томов, прописывание устойчивых путей к данным в PVC, настройка политики доступа к хранению и оптимизация IOPS. Резервирование данных через репликацию BE и регулярные снимки обеспечивает возможность восстановления в случае потери узлов или дисков.
Как обеспечить безопасность соединений в кластере StarRocks?
- Включение TLS для клиентских соединений, настройка RBAC для пользователей и ролей, применение сетевых политик Kubernetes для ограничения доступа к FE/BE, а также безопасное хранение учетных данных в Secrets.
Как выбирать форматы хранения и методы загрузки данных?
- Форматы Parquet/ORC обеспечивают эффективное сжатие и быстрый доступ к колонкам, особенно в аналитических сценариях. Загрузка данных может быть пакетной или потоковой; выбор зависит от задержек в поступлении данных и требований к консистентности. MV и предвычисления помогают снизить нагрузку на BE и ускорить повторяющиеся запросы.
Какие роли играет консистентность метаданных в кластере StarRocks?
- Консистентность метаданных критична для корректного выполнения запросов и планирования. FE хранит и координирует планирование, BE — данные, поэтому надежная синхронизация и управление версиями метаданных обеспечивает правильность результатов и совместимость между узлами.
Можно ли применить автоматизированное масштабирование в продакшене?
- Да, но оно должно основываться на четко определенных метриках (CPU, задержки, очереди выполнения) и проверке влияния на существующие запросы. В крупных кластерах рекомендуется постепенное масштабирование с автоматизированными тестами, чтобы не допустить резкого снижения качества сервиса.


