

Prometheus в observability-архитектуре: микросервисы, Kubernetes и data-платформы
Prometheus является центральным элементом observability-архитектуры, интегрируясь с Grafana, Alertmanager, Loki и OpenTelemetry. Он позволяет объединить инфраструктурные, приложенческие и бизнес-метрики в единую систему наблюдаемости.
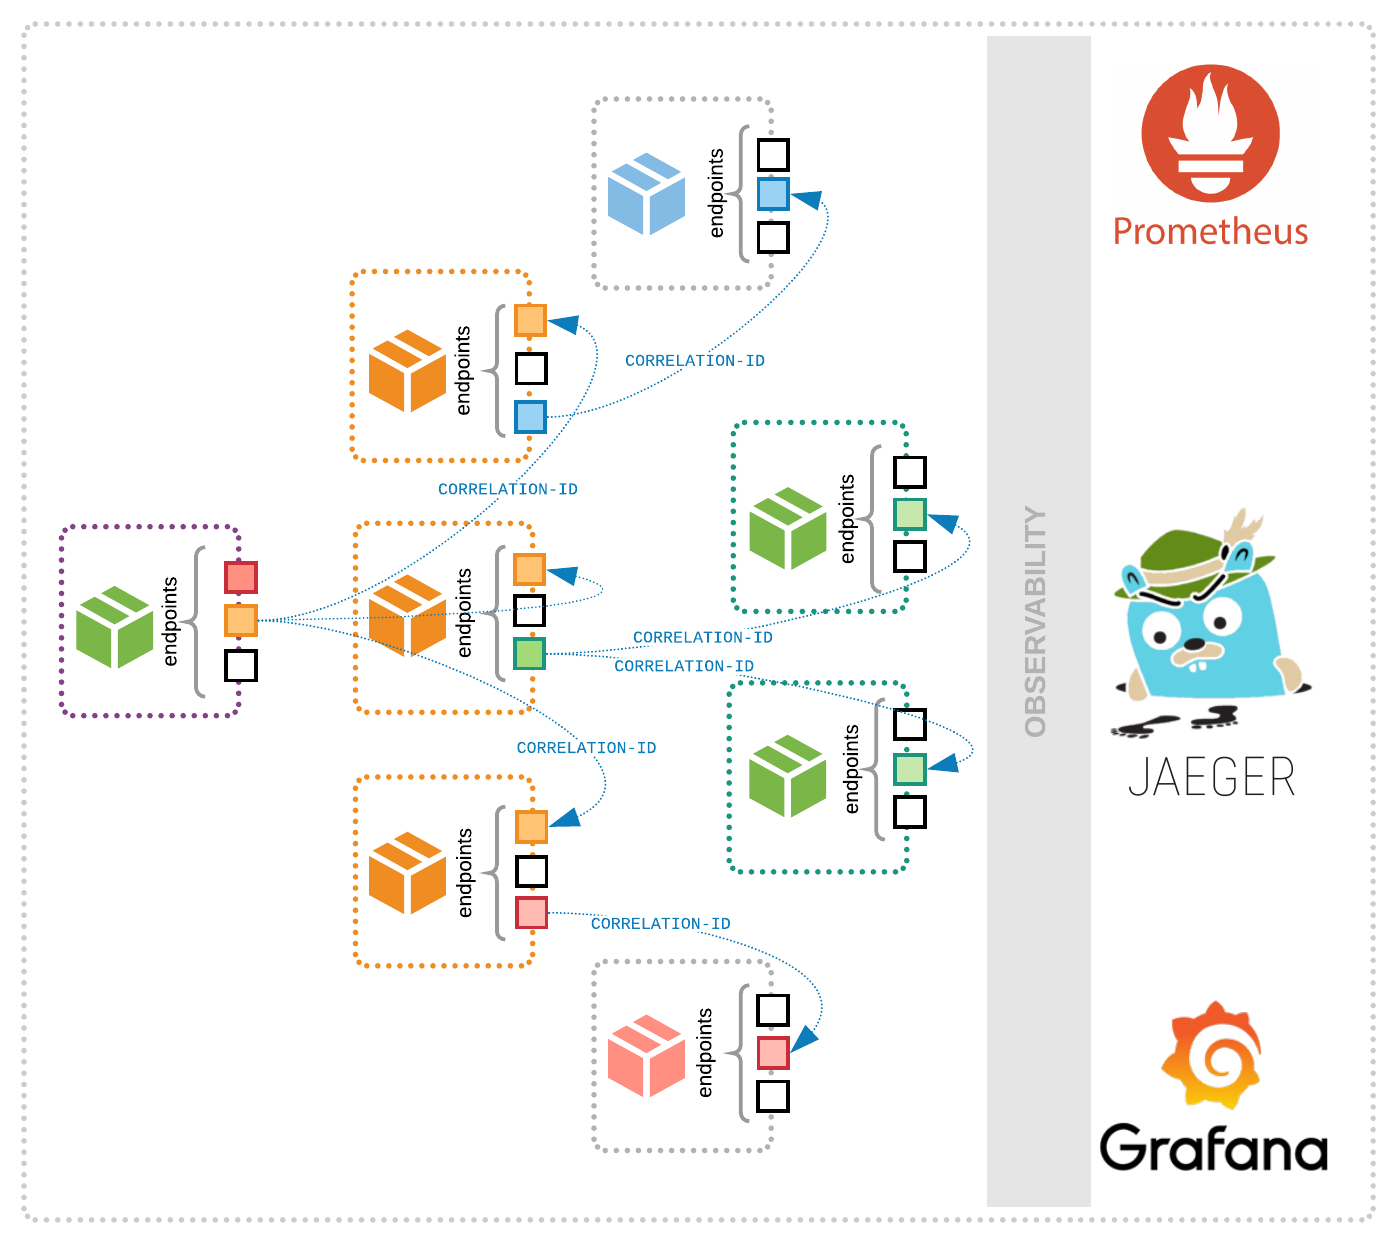
В этом разделе рассматриваются архитектурные паттерны мониторинга микросервисов и Kubernetes, построение SLO/SLA, работа с экспортёрами и интеграция с data-платформами (Kafka, Spark, Airflow).
Дополнительно раскрываются вопросы масштабирования, безопасности и операционной модели. Такой подход позволяет перейти к полноценной observability-системе.
- Стратегия observability: цели, KPI и связь с бизнесом
- Архитектура observability: слои, принципы модульности и интеграций
- Метрики, логи и трассировки: единая модель наблюдаемости
- Форматы и протоколы: Prometheus exposition format, OpenMetrics, OpenTelemetry и OTLP
- Архитектура Prometheus: компоненты, модель данных и принципы работы
- HA и федеративная архитектура Prometheus: мульти-кластерный мониторинг
- Метрики и экспортёры: сбор, discovery, агрегация и лимиты
- Kubernetes мониторинг: ноды, Pods, контроллеры и кластерные метрики
- Экспортёры и агентные решения для Kubernetes: node_exporter, kube-state-metrics, metrics-server
- Мониторинг data-платформ: пайплайны ETL, Kafka, Spark, Flink, Trino и Airflow
- OpenTelemetry: instrumentation, сигнатуры, контекст и трассировки
- OpenTelemetry Collector: пайплайны, конфигурации и маршрутизация данных
- Интеграция Prometheus и OpenTelemetry: сбор метрик и связь с трассировками
- Grafana: визуализация, дашборды, шаблоны и UX-дизайн
- Alertmanager: маршрутизация оповещений, правила и управление инцидентами
- Интеграции Alertmanager: каналы уведомлений и эскалации (Slack, PagerDuty, Teams)
- Архитектурные паттерны мониторинга микросервисов: централизованный vs федеративный мониторинг
- Kubernetes-ориентированные паттерны мониторинга: мультикластерность, namespace-изоляция и multi-tenant
- Мониторинг производительности и устойчивости сервисов: SLA/SLI, латентность и tail latency
- Практические дашборды: шаблоны для микросервисов, Kubernetes и data-платформ
- Безопасность и доступ к данным мониторинга: RBAC, секреты и управление доступом
- GitOps и мониторинг как код: конфигурации, тестирование и развёртывание правил
- Тестирование мониторинга: promtool, тестовые сценарии и synthetic monitoring
- Эксплуатация и операционная модель: runbooks, on-call и инцидент-менеджмент
- Риски, ограничения и типичные ошибки внедрения мониторинга
- Масштабирование и зрелость observability: дорожная карта эволюции


