

Apache Iceberg: транзакционный Data Lake для аналитических систем
Apache Iceberg — это открытый табличный формат нового поколения для построения транзакционных Data Lake и Lakehouse-архитектур. Он был создан как ответ на ограничения классических озер данных, где хранение файлов в object storage не обеспечивало надежной транзакционности, эволюции схем и управляемости изменений. Iceberg добавляет поверх файлового слоя полноценную табличную модель с ACID-гарантиями, snapshot-изоляцией и атомарными коммитами, что позволяет использовать Data Lake как промышленную аналитическую платформу.
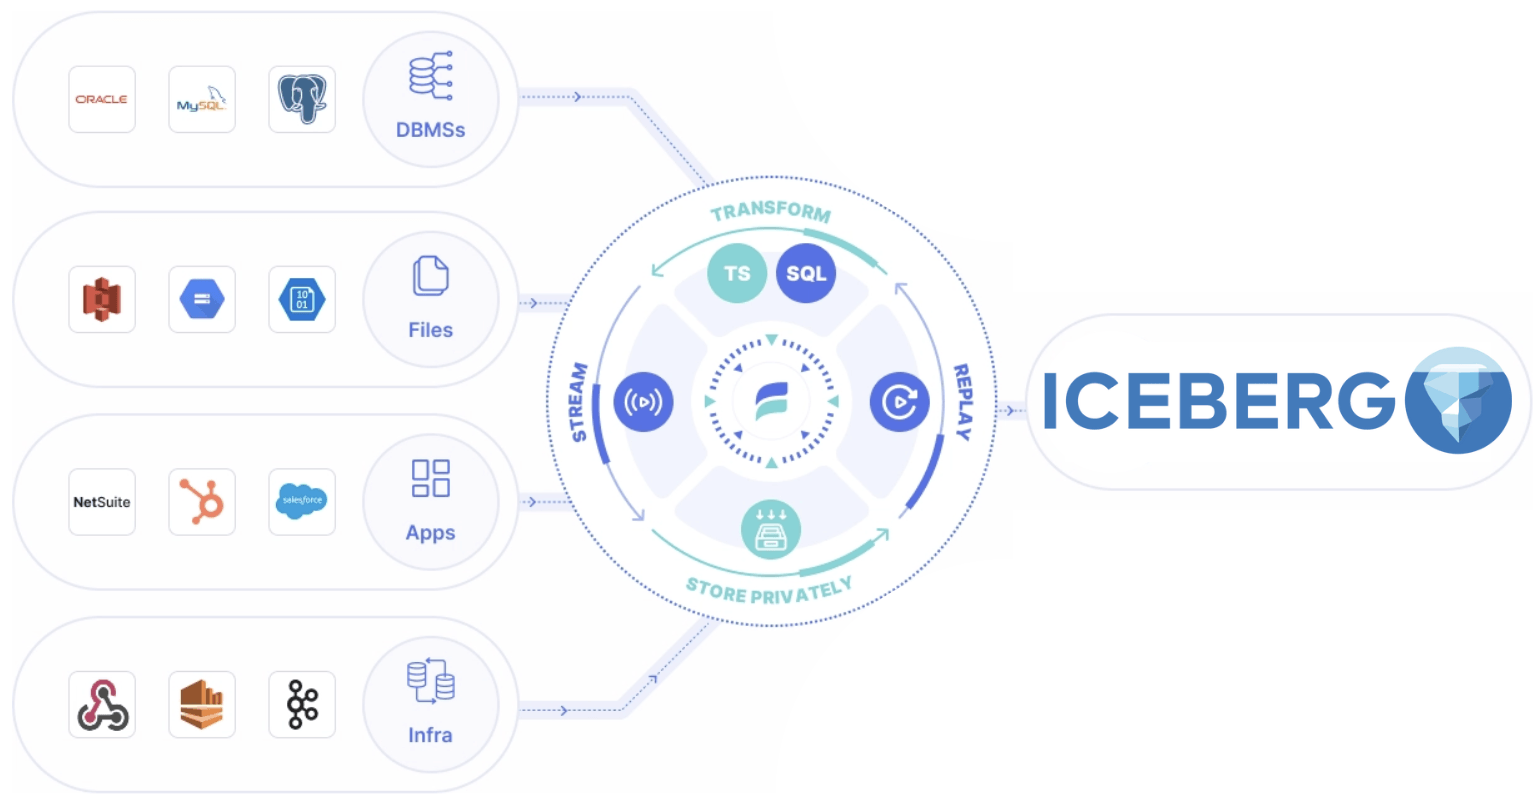
В основе Iceberg лежит строгая система метаданных и версионирования: таблицы состоят из файлов данных (Parquet, ORC, Avro), снапшотов и manifest-структур, которые обеспечивают контроль изменений, time travel, конкурентность операций и высокую производительность запросов. Благодаря интеграции с аналитическими движками (Spark, Flink, Trino, Hive), поддержке каталогов (Hive Metastore, Nessie, Glue, REST) и развитым механизмам управления жизненным циклом данных, Iceberg становится фундаментом для масштабируемых аналитических систем, AI-сценариев и корпоративного Data Governance.
- Введение в транзакционные Data Lake и роль Apache Iceberg
- Термины и базовые концепции Iceberg
- Архитектура Iceberg: таблица, файлы, метаданные и снапшеты
- Apache Iceberg: форматы хранения и сопутствующие файлы: Parquet, ORC, Avro и tombstones
- Метаданные Iceberg: manifests, manifest lists и таблица метаданных
- Каталоги Iceberg: Hive Metastore, Hadoop Catalog, Glue, Nessie и REST Catalog
- Эволюция схемы и совместимость типов данных в Apache Iceberg
- Партирования и распределение данных: partition specs, динамическая сегрегация и prune
- Транзакционная модель Iceberg: ACID, snapshot isolation и atomic commits
- Конкурентность и управление транзакциями: optimistic concurrency и блокировки
- Изменения данных: Change Data Feed, upserts, deletes и updates
- Управление файлами и производительность: размер файлов, компакция и orphan files
- Метаданные, статистика и планы выполнения запросов
- Apache Iceberg: транзакционный Data Lake для аналитических систем. Интеграции с аналитическими движками: Spark, Flink, Trino/Presto, Hive
- Каталоги данных и управление данными: Nessie, Glue, REST каталог
- Архитектура решений: слои данных, каталога и трансформаций
- Инфраструктура и развертывание: облако vs on‑prem, объектное хранилище, DR
- Миграционные стратегии на Iceberg: планирование, пилотирование и минимизация рисков
- Проектирование моделей под Iceberg: схемы, нормализация и денормализация
- Безопасность и соответствие: доступ, аудит и регуляторные требования
- Управление качеством данных: тестирование, валидаторы и мониторинг данных
- Apache Iceberg: транзакционный Data Lake для аналитических систем — Мониторинг, диагностика и эксплуатация Iceberg
- Жизненный цикл таблиц: retention, vacuum и GC
- Практические кейсы внедрения: индустриальные примеры
- Риски проекта и стратегии их снижения
- Развитие экосистемы Iceberg и будущие возможности
- Apache Iceberg: транзакционный Data Lake для аналитических систем. Стратегия внедрения: дорожная карта, регламенты и управление изменениями
- Обучение команд и сертификация: роли, программы и компетенции
Современный Data Lake должен поддерживать ACID-транзакции, time travel и эволюцию схем. Посмотрите, как архитектура на базе Apache Iceberg превращает Data Lake в надежный фундамент для аналитики и AI.


