

Функции даты, агрегации и оконные функции в DataLens
В DataLens функции даты, агрегации и оконные функции часто используются вместе: нужно округлить дату до месяца, найти последний период, посчитать сумму по условию, вывести показатель в индикатор или построить расчет поверх группировки.
В этом разделе собраны практические вопросы по формулам DataLens: как работают DATETRUNC, TODAY и MONTH, почему возникает ошибка Inconsistent aggregation among operands, как использовать SUM_IF, TOTAL и оконные функции, а также как правильно согласовать агрегированные и неагрегированные выражения.
Что внутри:
- функции даты и времени в DataLens;
- DATETRUNC и округление даты до месяца, квартала или другого периода;
- TODAY и зависимость результата от источника данных и типа соединения;
- функции агрегации и расчет показателей в индикаторах;
- SUM_IF для суммы по условию;
- TOTAL и расчеты по всему набору данных;
- оконные функции и типовые ограничения;
- ошибка Inconsistent aggregation among operands и способы ее исправить.
Функции даты и времени
Можно ли month, quarter заменить на месяц, квартал?
Да
Подскажите по поводу округления
DATETRUNC(#2018-07-12 11:07:13#, "month", 4) = #2018-05-01 00:00:00#
почему месяц стал 05?
В документации написано, что в дата-время используется две решетки ## - это начало соответствующего 4х-месячного периода.
Создаю :
Месяц = Month(Дата)
Последний месяц = Month( max(max( Дата) total))
В индикаторе отображает число
Хочу просуммировать данные по последнему месяцу :
sum_if( показатель_числовой, месяц = Последний месяц)
Выводит ошибку, когда я хочу отобразить данные :
"message": "Inconsistent aggregation among operands",
Пробую sum_if( показатель_числовой, месяц = max(Последний месяц) ) не помогает
sum_if( показатель_числовой, месяц = 1 ) ставлю число и отображает
Что нужно сделать с полем последний месяц, чтобы получить сумму по последнему месяцу?
Нужно агрегировать числовой показатель
Не понимаю функцию today(). Написано возвращение текущую дату. А что значит в зависимости от источника данных и типа соединения? А текущую дату чего? Для примера вывел в чат индикатор просто today() показывает 1. Что это означает?
Текущая дата - это какой сегодня день/месяц/год, если тип не просто "Дата", а "Дата и время", то сколько сейчас времени и какой день/месяц/год.
Если вы ее в индикатор добавили, то надо смотреть, какая агрегация. Раз значение "1", то скорее всего кол-во уникальных, ибо уникальная текущая дата только одна.
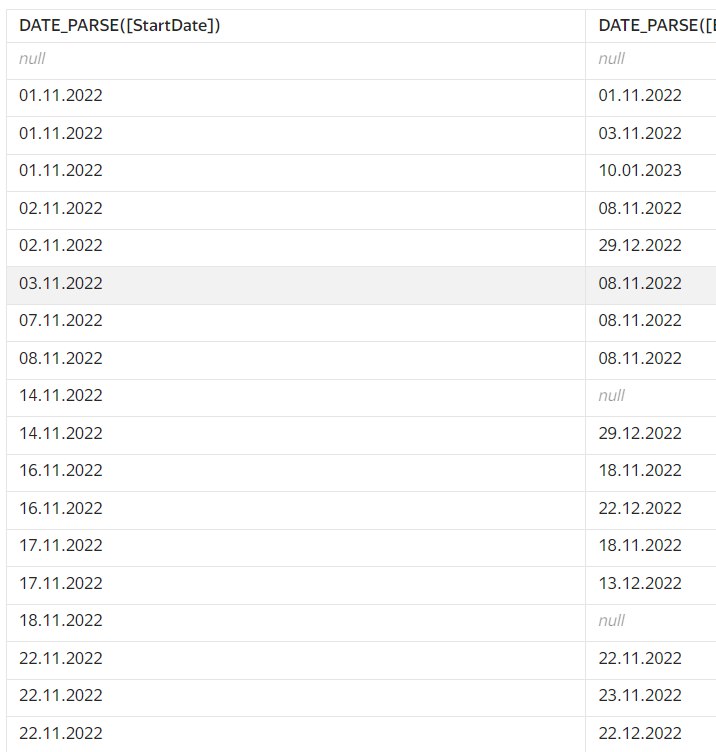
Подскажите, как можно решить задачу. Нужно вычислить количество дней в работе между датой старта и финиша при том, что некоторые заявки не завершены(NULL)
Дано:
Массив дат начала работы над заявками и их окончания. Ряд заявок не завершен и дата окончания пустая.
Простое вычитание не срабатывает потому что некоторые значения в столбце enddate=NULL.
Подскажите, возможно ли как-то произвести расчет количества дней между датами и чем-то на уровне формулы пробить Null?
Можно было бы использовать ZN для избавления от него, но он работает только с целыми числами, а не с датами
Так добавьте какой-нибудь IF или CASE на условие, что вторая дата null. То бишь если дата2 is null - записываем в столбец то-то, если не null, вычитаем даты
Подскажите пожалуйста почему может не работать формула AGO([Визиты], [Дата визита], 'month', 1) с данными из метрики
Если используется родная интеграция, то там куча ограничений. А еще measure должны быть агрегированными. У Вас это Визиты.
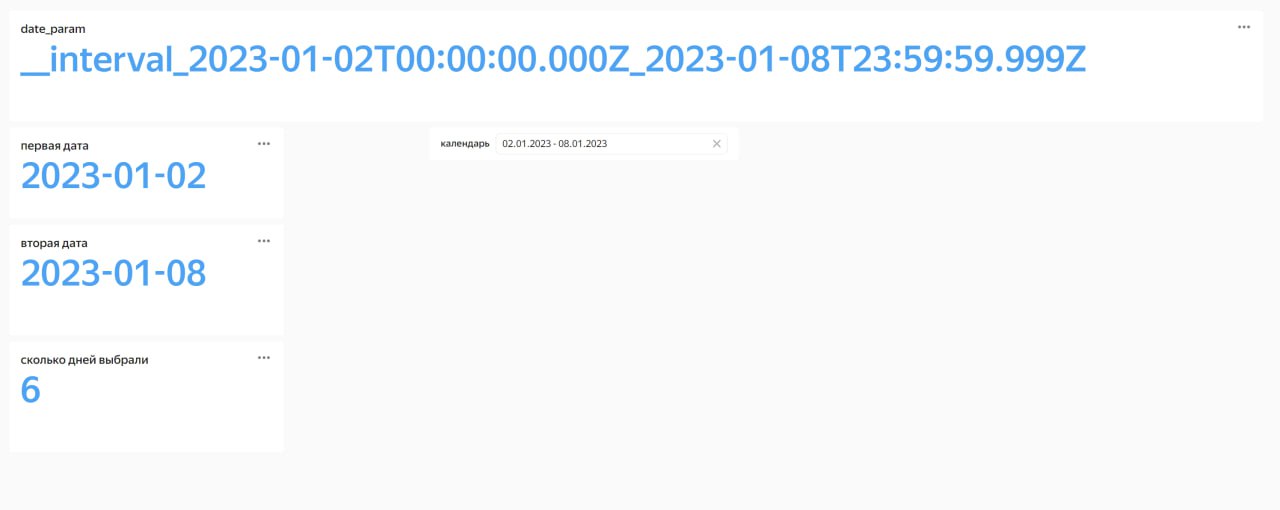
Как посчитать количество календарных дней в периоде, выбранном в параметре вкладки? Например, Продажи по Категориям товара, когда количество дней в календарном периоде больше, чем количество дней продаж. CountD по Дате не подходит. Спасибо!
вот так можно получить первая дата DATE_PARSE(SUBSTR(ALL_CONCAT([date_interval]),12,10))
вторая дата DATE_PARSE(SUBSTR(ALL_CONCAT([date_interval]),37,10)) ну и разница дат даст вам кол-во дней в выбранном промежутке а кол-во дней продаж это COUNTD(дни)
Можете подсказать, как задать выбор дат, чтобы время начиналось не с 0:00, а с 8:00 до следующих суток 8:00?
Мне необходимо будет выбирать данный период в дашборде
Часовым поясом поиграть. В БД данные из гугл таблицы тоже умеют, вроде. Даже, если и не сместят по часовому поясу функции +- время к полю "Дата и время" точно есть.
Вроде задача простая, но никак не могу воспроизвести: есть таблица с датами и напротив ID, эти ID дублируются с другими датами, необходимо напротив каждой ID указать максимальную дату, относящуюся к этой ID. Помогите, пожалуйста, с синтаксисом.
оконный макс
Подскажите, пожалуйста, как сделать группировку даты вместе с айдишниками внутри даталэнса
Хочу получить на выходе период даты с агрегированными айдишниками и чтобы дата не повтоялась.
При использовании группировки внутри чата вылезает ошибка
И второй вопрос почему недоступны QL-chart, хотя в подключении разрешены подзапросы.
Чтобы id показать за период нужен только один столбец, а период - в селектор.
Если все-таки дату надо показать справочно, то справа её, в первый столбец id
Img77_1
как можно сделать, чтобы визуализации (обычная таблица, индекс) смотрели только на часть таблицы по условию дата = максимальной дате таблицы?
Для этого воспользуйтесь оконной функцией MAX([поле] TOTAL). Далее сравнивайте каждую из строк с этим значением и выставляйте, например, NULL в случае неравенства. После этого для чарта воспользуйтесь фильтром на неравенство NULL.
Друзья , помогите.
1. Есть исходная дата , 01.01.2023 [Дата]
Есть параметр = 36 [srok_kredita]
Как превратить [Дата] + 36 (месяцев) = [Дата]
Короче как к дате прибавить количество месяцев, что бы получилась дата на 24 месяца больше исходной? если просто прибавлять, то прибавляются дни, а нужно месяца
https://cloud.yandex.ru/docs/datalens/function-ref/date-functions#dateadd
подскажите пожалуйста как узнать сколько времени прошло между 2 датами?
Вычесть
как можно сгенерировать ряд дат с часами?
То есть, условно у меня есть дата начала: 10 число месяца X, дата конца: 20 число месяца X
Как нибудь можно получить поле, которое будет содержать все часы от даты начала до даты конца? то есть хотел бы получить буквально 24 (кол-во часов) * 10 (кол-во дней) новых столбцов таблицы, а сами столбцы - это, соответственно, часы
Поле с датой можно сгруппировать по часам (не часть даты, а именно сгруппировать) и вставить его в столбцы сводной таблицы.
как можно в дате обрезать год?
чтобы вместо 25.04.2022 10:00 - отображалось: 25.04 10:00
это будет уже не дата, так что через преобразование в строку
Есть в таблице mysql поле дата время, делаю его Датой через cast(FIELD as DATE).
Дальше в примере по когортам нужно одну дату вычесть из другой. Делаю cast(FIELD as DATE) - cast(FIELD2 as DATE) - результаты не те, что должны быть.
Нагуглил, что так не получится вычислить тк поле datetime, было бы date - получилось. И нужно использовать DATEDIFF, который выдает корректный результат.
Но в DL нет DATEDIFF в формулах - что делать?
Сделать датасет как SQL запрос и вывести дополнительное поле
Подскажите, пожалуйста формулу. Нужно посчитать сделки, в которых заполнено поле типа "дата" и значение этой даты больше или равно 01.01.2023 (типа того COUNT_IF([UF_UF_DATA_VYYAVLENNOY_POTREBNO] > 01.01.2023)) и такую же формулу на интервал дат, если не сложно
Суть формулы правильная, просто нужно поставить поле для расчёта и написанную дату в подобающий вид привести.
А за интервал дат, если он конкретный, то between можете использовать или два условия отдельных. А если период в селекторе выбираете - просто считаете количество сделок.
Подскажите пожалуйста, как мне проанализировать CSV файл, состоящий из двух полей EventTimeStamp (тип дата-время) и Message (тип строка). При этом поле Message содержит JSON текст, в котором заключена наиболее важная для анализа информация. Как можно выделить из этого поля нужные поля JSON-объекта и, например, сформировать на их основе вычисляемое поле в той же строке?
строковыми функциями разбирать строку - это как раз и будут вычисляемые поля. Лучше сделать это предварительно. Можно подготовить файл через pandas
можно подсветить текущую дату в сводной таблице?
Вы можете поместить в секцию «Цвета» условие [дата]=DATE(NOW())
Как изменить формулу, чтобы всегда в показателях выводились значения прошлой недели. Формула сделана под текущую неделю. COUNTD_IF([UF_ID],DATETRUNC([UF_UF_DATA_SOGLASOVANIYA_KP],"week")=DATETRUNC(today(),"week"))
today() - 7 попробуйте в самом конце или
DATETRUNC(today(),"week")-7
Есть исходная табличка вида:
дата | департамент | какой-то текстовый комментарий (коммент)
Моя задача сделать итоговую таблицу вида:
Департамент | кол-во комментов в выбранном периоде | кол-во комментов в прошлом периоде | дельта комментов
Вывожу в поля таблицы следующее:
- Департамент;
- COUNTD ([коммент])
- AGO (COUNTD ([коммент]), [Дата с группировкой], scale, 1 BEFORE FILTER BY [Дата c группировкой])
- С дельтой все понятно
Проблемы, которые не могу решить:
- Если выбранный диапазон дат не полон для группировки (например, выбрали 3 недели, а группировка по месяцу), то в "прошлом периоде" расчет произойдет по данным всего месяца, а не по 3 неделям. Нужно по 3 неделям.
- Если в прошлом периоде были комменты у департамента, а в нынешнем их нет, то и в результирующую таблицу департамент вообще не попадет. Т.е. не могу вывести 0 |50 |-50
- При использовании параметра BEFORE FILTER BY в функции AGO у столбца перестают считаться итоги.
И еще сразу вопрос: можно ли создать на уровне датасета поле "дата для сравнения", равное "дате"; вывести в дашборд 2 этих селектора даты; создать необходимую мне таблицу, чтоб "кол-во в прошлом" вычислялся по формуле, ссылающейся на селектор из "дата для сравнения", а "кол-во в выбранном" на селектор базовой даты???
Я пытался так сделать, но при выборе разных периодов в селекторах таблица теряет данные. Как я понял, потому что они исключают друг друга. Другими словами, можно ли связывать селекторы с чартом связью "или", а не "и"?
Проще сделать через параметр-выбор дат и SQL запрос
функцию MAX - можно положить в измерение, хочу чтобы в шапке сводной таблицы выводилась максимальная дата из селектора?
Источник PostgreSQL, пока Дата Ленс дает с MAX создать только показатель(
MAX — агрегирующая функция, поэтому получить измерение не получится.
есть формула : TODAY()-DAYOFWEEK(TODAY())-6 которая отдает дату.
Я используя функцию STR привожу ее к текстовому формату, при этом формат dd.mm.YYYY меняется на другой. Может кто ни будь знает как можно задать формат даты при переводе в строку Строго говоря у даты и нет этого формата. Дата - это просто число, а не вот это вот с точками.
Преобразования в строку по формату на данный момент в ДЛ нет
Подскажите, пожалуйста, почему может получаться такая ошибка.
Есть дата1 = 08.01.2023
Есть дата2 = 01.02.2023
Дата2 - Дата1 = 93.
Почему получается 93, а 23?
Как это исправить?
потому что ваша СУБД делает операцию не с датами, а с числами
20230201-20230108 201-108 = 93
Через timestamp должно работать
полетели настройки дашборда, который около года успешно работал .
Ошибка - разные данные в столбцах.
Чарт простой: по оси Х указан год, полученный с помощью функции YEAR из Даты (Дата в csv в формате 2023-01-01, 2023-02-01 итд за несколько лет, то есть месяц и год точные, а день месяца всегда 01). По оси Y - количество, которое суммируется по настроенным селекторам. Селекторы: товарная группа, бренд, отбор дат с настройкой списком (по-сути выборка месяцев разных годов) .
При отборе из списка определённых месяцев в разных годах (не обязательно последовательных и идентичных) график отображает динамику.
Точнее отображал всегда раньше, до текущего месяца.
Перебор вариантов, проверка селекторов и настроек не выявили проблему.
Натолкните, пожалуйста, на мысль, что ещё сделать. Ощущение, что функция YEAR не корректна или перестала дружить с датами.... Опыта нет, всё методом тыка, уже не знаю, куда ещё посмотреть. Или как переделать так, чтобы график показывал динамику по "выдернутым" месяцам. Селектором эти месяцы отбираются. А на графике точки в координатах (год;значени
попробуйте сменить тип данных с "Дата" на "Дата и время". Вместо даты взяла "дату и время". А год в формате " числа" (иначе в формате даты он превращается в неверный год)
Нужно создать поле, в котором отображалась бы разница между текущей датой и датой создания?
Today()-дата создания. Итог вы получите в днях, можно округлить до целого
При делении в Чарте-таблице результат тот же (не верный).
Опишу задачу полностью:
Есть таблица, в нее поступают данные по заявкам. Заявок поступает несколько штук в день, и они приходят из разных рекламных источников.
Есть вторая таблица, в которой собирается информация о ежедневных расходах на рекламу в разрезе источников.
Мне необходимо посчитать, стоимость привлечения заявки. Для этого я в подключении DataLens объединил эти две таблицы по полю Дата. С помощью функции COUNT_IF я получаю сумму заявок по разным источникам. Расходы считаются суммой соответствующих полей.
Если выводить полученные числа в таблицах или индикаторах, то все считается корректно, но если делить расходы на число заявок, ответ получается неверный.
В итоге я не смог решить этот вопрос с помощью функций DataLens, и сделал подсчет заявок в таблице с расходами в Google с помощью функции СЧЁТЕСЛИМН. И теперь, когда данные о сумме расходов и количестве заявок по источникам трафика находятся в одной Google таблице, все считается корректно.
Проверьте объединение в Datalens. Верный ли тип объединения вы используете
Хочу посчитать сумма за месяц/пройденых дней за месяц * количество дней в месяце
Не могу придумать как, в датах у меня только факты, и нет дат за будующее что бы посчитать дни в месяце)
У меня идея одна, календарь в БД построить. Подскажите как в даталенс решается такая задача?
добавляете к дате месяц. округляете до месяца, вычитаете один день и берете номер дня = число дней в месяце
имеется таблица данных с полем Период в формате ДАта/Время.
Нужно добавить вычисляемое поле, в котором указана самая последняя Дата.
Какой функцией \это сделать?
MAX([field] FIXED)
а как разность дат сформировать ? есть функция которая разницу дат в днях выдаст ?
дата1 - дата2, где дата - это просто число
Мне нужно найти для каждого значения CONTACT_ID минимальное значение среди всех DATE_CREATE(1), при которых STAGE(1) = "[UC_2K4CIO] запланировать выкупы".
Я уже делала пыталась добавить фильтр [STAGE(1)] = "[UC_2K4CIO] запланировать выкупы" и следующим шагом попробовала создать поле с формулой MIN([DATE_CREATE (1)] FIXED [CONTACT_ID])., но потом столбцы и фильтры будут удалены, поэтому эта формула же слетит и слетает корректное значение в столбце "дата создания самой первой сделки"
Дата создания самой первой сделки min([DATE_CREATE] FIXED [CONTACT_ID]).
Фильтры: CONTACT_ID > 0
CATEGORY_ID = 0.
Я пыталась добавить новое поле
"IF [STAGE (1)]="[UC_2K4CIO] запланировать выкупы" THEN [DATE_CREATE (1)] ELSE 0 END"
Но выдаёт ошибку Type conflict: [CONST_INTEGER, GENERICDATETIME]
min([DATE_CREATE] FIXED [CONTACT_ID] before filter by [STAGE (1)])

как можно обозначить параметр русскими буквами? Например,
Дата: month, quarter заменить на месяц, квартал?
параметры для функций обозначаются латиницей
Как реализовать счетчик количества дней в текущем месяце, для разделения месячного плана
day(dateadd(DATETRUNC([Дата создания (дата)], "month"), "month", 1)-1)
подскажите, какую функцию использовать, чтобы из поля такого типа '9 февраля 2020 г.' сделать дату формата дата (чтобы в селекторе реализовать календарь с диапазоном).
Лучше это сделать в источнике если там есть функция преобразования к дате по формату.
У меня вопрос по функции LAST. Есть ли способ заставить функцию брать последнюю строку по окнам?
Не пойму почему не работает:
SUM(last([Прогноз] WITHIN [Филиал], [Начало месяца] ORDER BY [Дата]))
В postgres аналогичный результат получаю с помощью:
last_value(m."Прогноз") over(partition by "Начало месяца", "Филиал"
order by "Дата" range between UNBOUNDED PRECEDING AND UNBOUNDED FOLLOWING) as "last_Prognoz"
Поясню, внешний SUM() в Datalens нужен для агрегации (к примеру, если выбрано несколько месяцев, то прогнозы должны суммироваться)
в ДЛ оконные функции работают с показателями, то есть уже с агрегациями
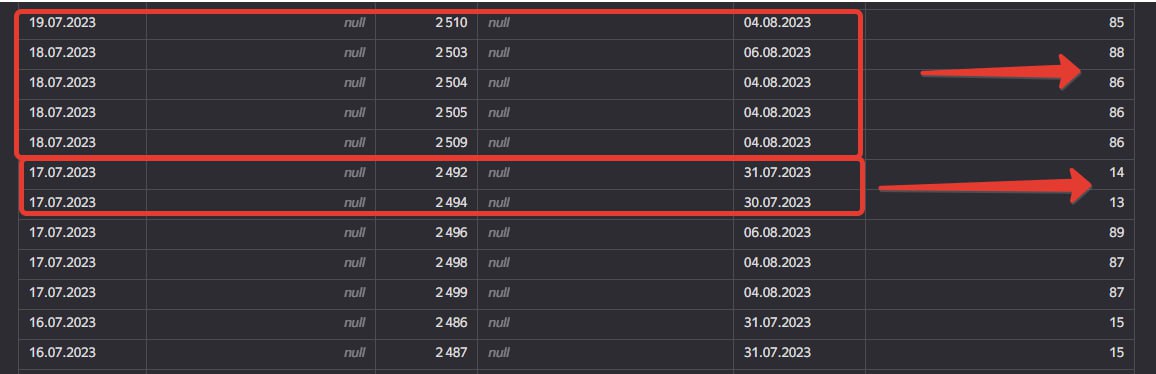
Вопрос по вычислению разницы в днях между двумя датами
В случае если вычитание дат проиходит в рамках одного месяца то дни считаются корректно.
В случае если вычитание происходит между датами принадлежащим разным месяцам, то количество дней превышает фактическое
Потому что ваша СУБД делает операцию не между датами, а между числами 20230815 и 20230715
Подскажите пожалуйста дилетанту. Как-то можно сделать фильтр поля с датой по условию "дата в поле меньше чем текущая дата"?
текущая дата today()
В таблице есть поля user_id, active_day (дата активности). Я хочу посчитать всех юзеров, которые были активны хотябы раз в месяце. Использую округление даты datetrunc([active_day], "month"). А для user_id делаю подсчёт уникальных. Правильно же?
да, всё верно
Как можно задать строго ограниченный диапазон на который не будут влиять никакие фильтры чарта ? Типо COUNTD([Дата]FIXED), но если я уберу часть показателей фильтром, чтобы данные не изменились
необходимо добавить BEFORE FILTER BY
У меня дата в файле в таком формате: 09.01.2023 09:28:36 - это 9 января 2023. Но при загрузке в датасет и смене типа поля со строки на дату он распозняет как 1 сентября 2023 года. Как это исправить?
Сделайте с помощью lag()
Подскажите, пожалуйста, правильную формулу для вычисления кол-ва времени в часах между двумя датами
Из одной даты вычитаете другую и умножаете на количество часов в сутках.
Привет всем. Помогите разобраться с сортировкой в RANK_UNIQUE( value [ , direction ] ) нигде не нашел пример как заставить ранжировать от меньшего к большему ранжировать планирую даты. По умолчанию - от большего к меньшему Выделенная жирным область никак мне не поддается.
```
RANK_UNIQUE( [start_time] [, direction ]
WITHIN [equipment+streams]
)
```
Использовалась несовместимая с датами функция (sum).
Код сработал:
RANK_UNIQUE(avg([start_time]), "asc"
WITHIN [equipment+streams]
)
Подскажите пожалуйста как правильно сделать каунт по условию дата больше x-даты. Пример COUNT_IF([Дата встречи]>'02.10.2023')
Формат даты должен быть написан как гггг-мм-дд
Через какие формулы можно вывести в соседние колонки показатели за разные периоды. Например есть колонки товар, ср. оценка текущий месяц, ср. оценка предыдущий месяц. И если это возможно, что бы селектор с датами на них не влиял. Это возможно?
возможно, ago() вам в помощь) Чтобы селектор с датами не влиял в ago дописываете конструкцию before by filtered
Доброе утро! Пожалуйста подскажите как можно реализовать изменение цвета ячейки таблицы, если дата в ячейке больше или равна текущей дате
сделать формулу типа
if [Дата]>=TODAY() then 1 else 0 end
в IF в условие нельзя дату использовать? IF [Период]="01.10.2022" в таком виде
можно, но дата должна быть в формате yyyy-mm-dd и гигиена требует даты в строковом виде преобразовывать явно функцией DATE TODATE и тп
Скажите, пожалуйста, в чем может быть проблема - из Битрикс пользовательское поле выгружается в формате "строка"(ДЛ распознает как строку, вывод на экран гггг-мм-дд). Перевожу поле в формат даты, строю с ним линейную диаграмму - в ней отображается нормально датой, можно группировку по периодам, в общем все как положено.
Это же поле кладу в фильтрацию - если оно остаётся в формате строки, предлагает выбрать вариант фильтрации как для строкового значения, а это очень много строк, если кладу туда в формате дата через date, то выдаёт ошибку.
Как это починить??
{"rtvduahjgms4g_result": {
"code": "ERR.DS_API.FORMULA.TRANSLATION.DATA_TYPE",
"status": 400,
"sourceType": "bi_datasets",
"message": "Invalid argument types for function DATE; dialect: BITRIX; types: (STRING); the function is only defined for other databases.",
"details": {}}}
Да, единственное решение, которое сработало - отказаться от бесплатного коннектора в пользу платного + облачная БД))
Коннектор не даёт возможности работать с пользовательскими полями полноценно, в том числе менять формат - выдаёт ошибку.
Скорее всего такой вопрос уже был но найти не удалось. Как можно в круговой диаграмме объединить в "Другие" все категории что не входят в Топ 10?
Датасет вида:
- Дата заказа
- ID заказа
- Регион
- Категория
- Сумма заказа
Если делать через RANK по ['Сумма заказа'], то когда пишешь
IF RANK(SUM(['Сумма заказа'])) > 10 THEN 'Другие' ELSE ['Категория'] END, то возвращает ошибку Inconsistent aggregation among operands. Понятно в чём проблема, но непонятно как её можно исправить
сформировав поле на стороне БД в котором для первых 10 будет свое имя, а для остальных Другие
Подскажите, пжл, есть таблица с датой, повторяющимися несколько раз id и кол-вом для этих id, необходимо вывести ежемесячно сумму первых значений каждого id.
In reply to this message
дата | id | кол-во
01.01| 1 | 7
02.01| 1 | 8
03.01| 2 | 9
04.01| 2 | 7
Вывод:
дата | кол-во
01.01| 16
Я пробовала First(Кол-во WITHIN id), но он не пропускает, потому что кол-во должно быть агрегировано, но мне надо без агрегации значение
Если прописать достаточно полей в within - можно спокойно ставить агрегацию, она ничего не испортит. Подробнее
Не очень долго работаю в Datalens, помогите, пожалуйста.
Есть расписание уроков с датами и id учеников с 2017 года. Как только ученик посетит 20 уроков в учебном году, с этого месяца (не обязательно сентябрь, может быть и март) он попадается в группу УЧАСТНИКИ до конца учебного года. На выходе необходимо построить график количества УЧАСТНИКОВ по месяцам .
Максимум, что у меня получилось сделать таблицу с учебным годом, месяцем, id ученика, сумму уроков с накоплением по месяцам через rsum и 1/0 является ли УЧАСТНИКОМ. Но из этого мне уже и не посчитать количество УЧАСТНИКОВ, да и вообще естественно работает правильно, только при наличии всех столбцов.
Подскажите, пожалуйста, можно ли реализовать это и как?
Смотрите в сторону уровней детализации LOD.
Там же будет и про заведение в чарт отсутствующего в нем поля через INCLUDE
Подскажите, пожалуйста, есть ли возможность реализовать такой сценарий:
Имеются 4 поля: дата подписания, дата продажи, подписан да/нет, продан да/нет
Выводим по менеджерам количество продаж и подписаний (count_if) и селекторы "дата подписания" и "дата продажи". Если выбираем один день там и там или связываем их через связи (что то же самое), то показывает количество строк, в которых дата подписания=дата продажи, но они могут быть в разный день, естественно.
Желаемый результат: единый селектор по дате, по которому будет показываться количество подписаний в этот день по менеджерам и количество продаж в этот день по менеджерам
совместите даты в одном поле
один селект -одно поле
при правильной организации у вас на каждую операцию должна быть своя запись, а не одна запись и несколько полей дат
у меня есть дата (date) дата начала рабочего дня (datetime) и дата конца рабочего дня (datetime), нужно вычислить сколько в среднем сотрудник работает в день, в неделю, в месяц (показать как индикатор)
подскажите, пожалуйста, как это сделать на уровне поля вычисляемого
Дата - Дата
у меня в таблице в столбце дата, дата и время в формате unix, изначально в просмотре датасета сменил тип с чисел на дата-время, было все ок, но сейчас когда строю чарты у меня вместо нормальной даты на оси Х значение unix,Подскажите плиз как все таки сделать дату
создайте поле в котором явно преобразуйте datetime(…)
Скорее всего такой вопрос уже был но найти не удалось. Как можно в круговой диаграмме объединить в "Другие" все категории что не входят в Топ 10?
Датасет вида:
- Дата заказа
- ID заказа
- Регион
- Категория
- Сумма заказа
Если делать через RANK по ['Сумма заказа'], то когда пишешь
IF RANK(SUM(['Сумма заказа'])) > 10 THEN 'Другие' ELSE ['Категория'] END, то возвращает ошибку Inconsistent aggregation among operands. Понятно в чём проблема, но непонятно как её можно исправить
Укажите явно с помощью include группировку в IF
У меня есть данные с гранулярностью по месяцам. По умолчанию показываю последние 90 дней, по факту - показывается 3 месяца.
Есть чарт типа Индикатор, хочу туда для наглядности добавить некой динамики. Т.е. при отрицательном сравнении с аналогичным периодом прошлого года (т.е. август-октябрь 2022) emoji стрелка вниз, при положительном - вверх (падение-рост). Как эту часть сделать представляю - concat и т.д.
Для сравнения хочу использовать функцию AGO(SUM([sales]), DATETRUNC([date], 'year'), 'year', 1), но сравнивать хочу не со статичным значением на октябрь прошлого года, а чтобы показывало данные за аналогичный период прошлого года.
Пока не понимаю почему у меня ошибка агрегации при попытке сравнить SUM(sales) с этой функцией.
Тогда используйте ago по датам, он будет учитывать правильно диапазон Т.е. без DATETRUNC
Подскажите пожалуйста, как написать вычисляемое поле:
Логика поля заключается в том, что если Дата полной оплаты товара позднее 3 рабочих дней после даты продажи, то в таком случае должна проставиться дата : дата продажи + 3 рабочих дня. Если все в срок, то null. проблема именно с тем, как обозначить рабочие дни, не могу найти решение ….
if weekday([Дата]) < 6 then
if [Дата полной оплаты товара]>=[Дата продажи]+3 then [Дата продажи] + 3 else null end
else null
end
как можно создать [Дата], не знаю, как притянуть именно просто дату обычную, если в таблицах ее нет
In reply to this message
--- ПН и ВТ
IF (DAYOFWEEK([Дата продажи]) < 3) AND (DATEADD([Дата продажи], 'day', 3) < [Дата полной оплаты])
THEN DATEADD([Дата продажи], 'day', 3)
--- СР - СБ
ELSEIF (DAYOFWEEK([Дата продажи]) BETWEEN 3 and 6) AND (DATEADD([Дата продажи], 'day', 5) < [Дата полной оплаты])
THEN DATEADD([Дата продажи], 'day', 5)
--- ВСК
ELSEIF (DAYOFWEEK([Дата продажи]) = 7) AND (DATEADD([Дата продажи], 'day', 4) < [Дата полной оплаты])
THEN DATEADD([Дата продажи], 'day', 4)
ELSE NULL
END
тут с расчетом в рабочих дней
Мне нужно график сделать с нарастающим итогом. Мне нужно вычисляемое поле добавить? Если да, то что там написать? Или тип диаграммы какой-то особый применить. Пример: Иванов - 01.01.2023, Петров - 01.01.2023, Сидоров - 02.02.2023. Как сделать график, чтоб 01.01.2023 - было значение 2 человека, а 02.02.2023 - 3 человека, а не один. Заранее спасибо
RSUM(COUNT([ДатаРождения)]), "ASC")
вопрос по вычислению полей
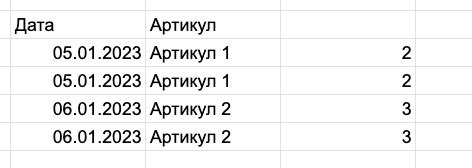
необходимо посчитать сумму заказов по определенным артикулу и дате, но строки с артикулами и датами могут повторяться несколько раз, но значение заказов у них одинаковая, есть ли возможность проверять на уникальность даты + артикул а после суммировать для составления чарта? чтобы к примеру в этом кейсе показывало значение суммы заказов не 10 а 5
в поле хотелось бы формулу записать, но не знаю возможно ли
ANY([Выручка общая] FIXED [Дата],[Артикул]) = select ANY() from GROUP BY дата, артикул соответственно это становится подзапросом
по результату которого вы берете SUM уже с внешней группировкой
можно ли средствами ДЛ сделать поле с разницей дат?
для каждой строки есть поля с датами, нужно поле с разницей между ними в днях.
почитала, погуглила , ответа не нашла(
изначально файл из Гуглтаблиц подключен
Дата – Дата
У меня есть стаж сотрудника в днях
today() - дата устройства
Как вывести это в формате "X лет, Y мес, Z дней"?
Только делением и вычислением остатка
Подскажите, пожалуйста. Нужно создать поле в датасете. Есть столбец дата начала работы и столбец дата завершения работы. Нужно посчитать срок работы (в днях). Но в большинстве ячеек даты завершения работы нет даты, то есть работа продолжается. Получатся, нужно чтобы в подсчетах автоматом подставлялась текущая дата. Как это сделать в датасете data lens? Спасибо.
if ([date] is Null, now(), [date])
каждого месяца?
Никак не придумаю как это реализовать. Все ломается об момент, что первая неделя не обязательно начинается с понедельника, а последняя не обязательно кончается воскресеньем.
Дата и день недели есть
У меня нет доступа к самим данным, да и привязать все надо к уже существующему чарту таблице
Буду очень признателен, если кто-то поделится идеей как это реализовать
если последняя дата недели меньше либо равна 7 - первая неделя/если первый день недели больше, чем число дней в месяце - 7, то последняя
почему если фильтровать значение даты из самого подключения, то sumX-ago работает исправно, а если фильтровать по year(значение даты из подключения), то показывает ноль?
2023 - число 01.01.2023 - дата
здравствуйте, если год вводить в виде числа, есть ли какая-нибудь функция по типу ago для даты? чтобы из текущего значения текущего года вычесть значение предыдущего
LAG
А можно ли как-то в DL высчитать время в чч:мм:сс? Не могу никак сообразить
чч:мм:сс - это строка
Подскажите пожалуйста по преобразованию формата даты
Из источника данных дата подтягивается в формате строки, преобразую в дробное число, далее хочу перевести в формат даты, но выходит единая дата от формата unix
В случае с файлом/гуглом лучше сразу подавать в ДЛ в формате гггг-мм-дд

А как правильно задать промежуток между датами?
Разница между датами возвращает количество дней. Количество месяцев можно получить, поделив это число на 30, количество дней — получив остаток от деления на 30.
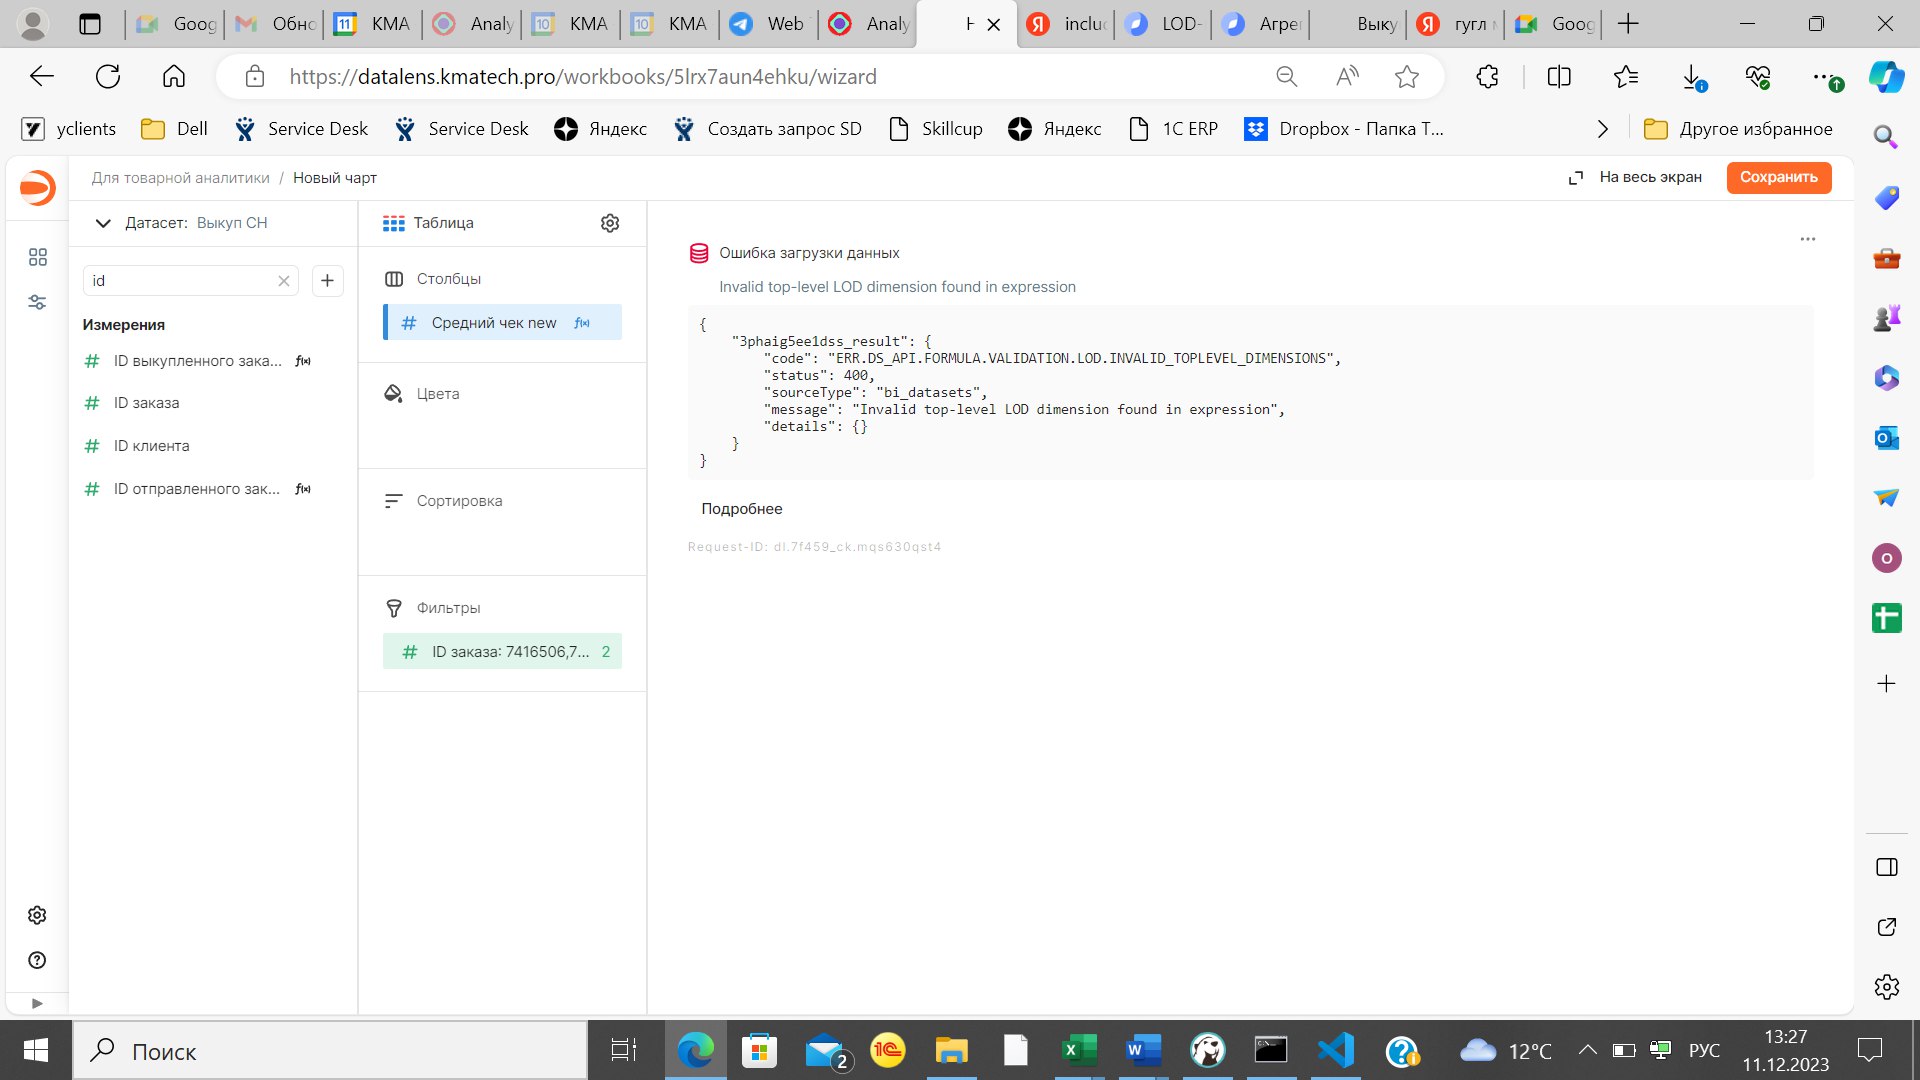
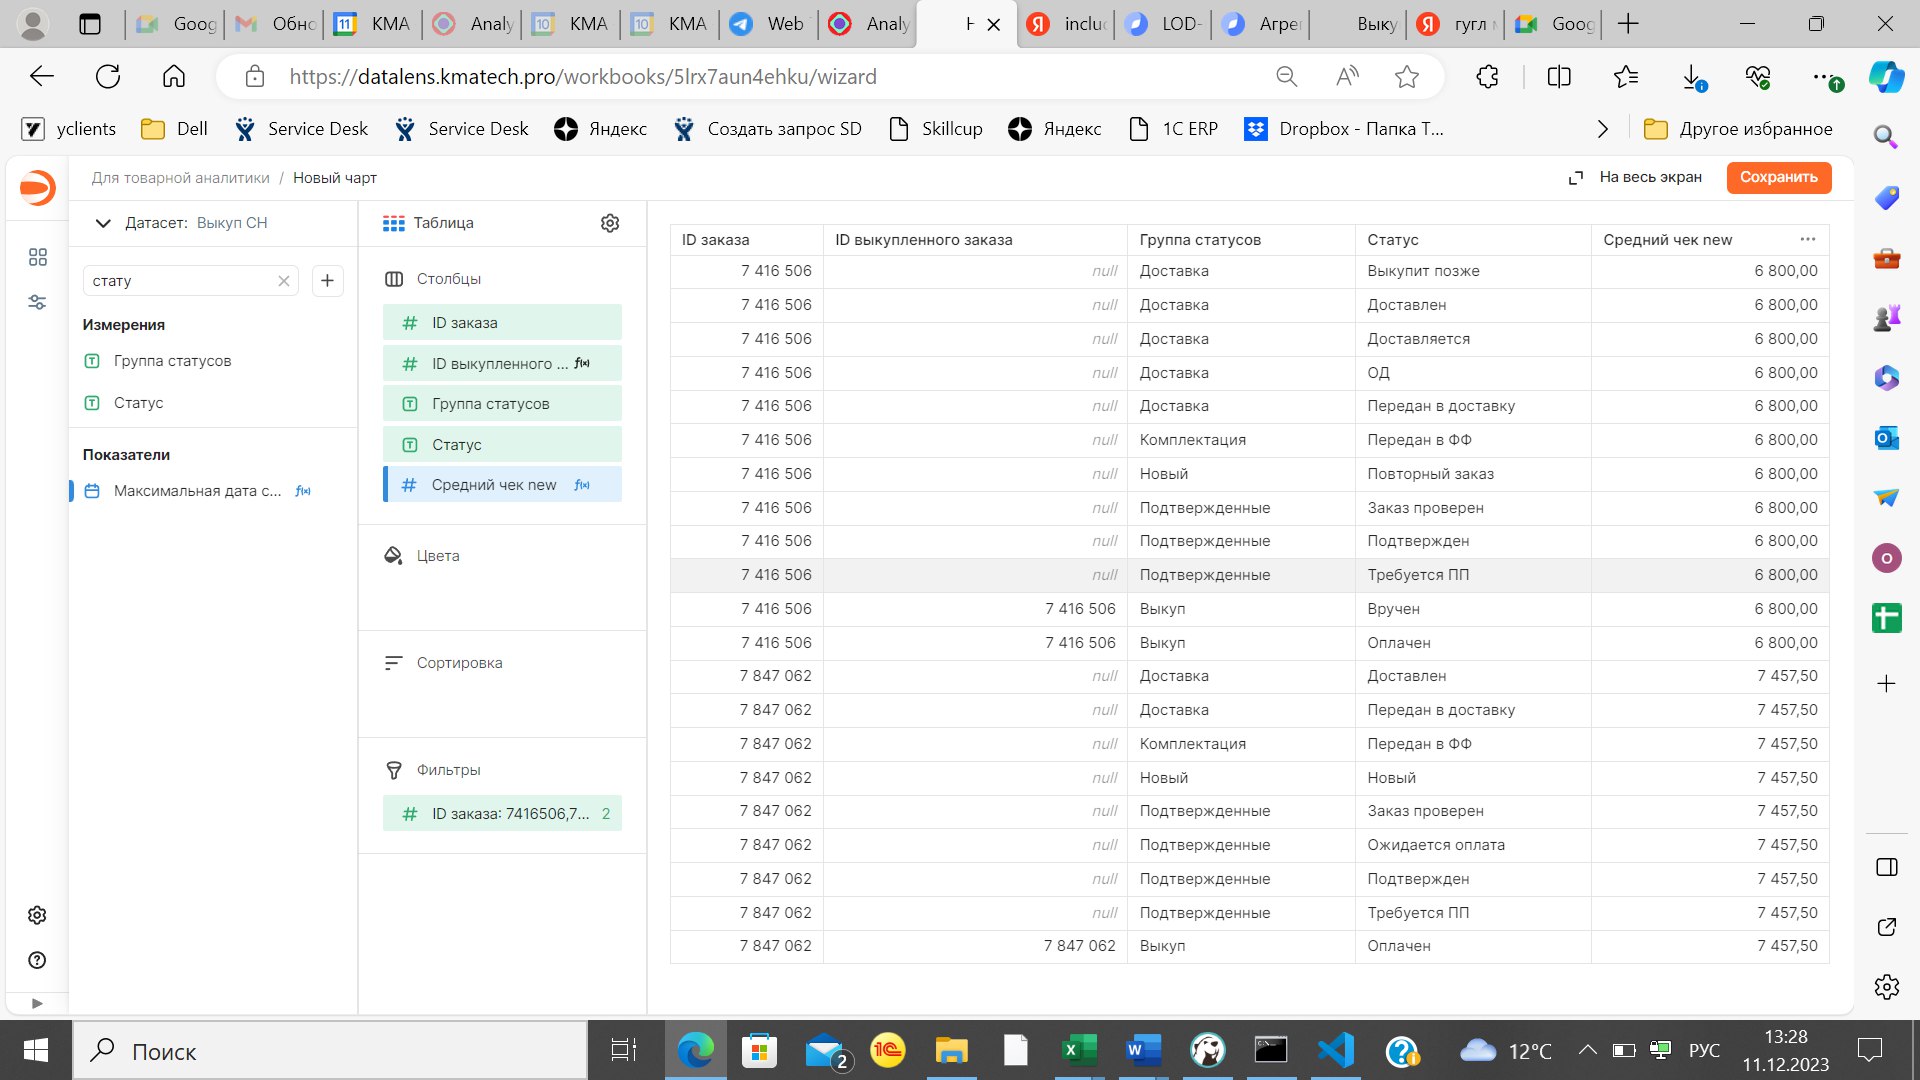
посчитал AVG([Сумма заказа] INCLUDE [ID выкупленного заказа]) через такую формулу, это ок, если в таблице есть заказы, но не ок, если я хочу их убрать (для индикатора например) есть еще даты изменения статуса, я могу взять же сумму заказа, только если дата =максимальной дате а потом сагрегировать? как прописать максимальную дату внутри заказа?
Ошибка на первом скрине говорит о том, что include не может быть на верхнем уровне формулы. Оберните формулу в ещё одну агрегацию, в вашем случае в avg и заработает
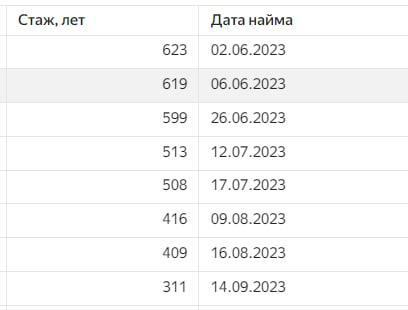
Подскажите пожалуйста, нужно вычислять стаж по дате найма в годах, при отнимании сегодняшней даты от даты найма получаю такие значения, а это в чем и можно ли привести к годам? Формула ((TODAY()) - ([Дата найма]))
это у вас MySQL, наверное, тогда сначала переводите даты в int и только потом вычитайте иначе оно вам из 20231225 вычитает 20230602
Функции агрегации
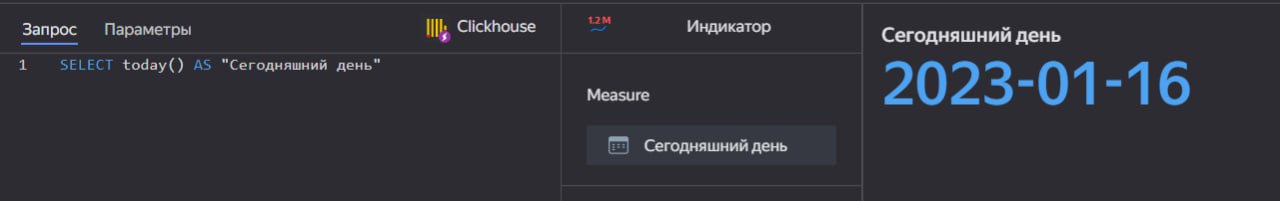
А эту самую агрегацию как посмотреть? В общем, например задача, в индикатор вывести текущую дату. Как это можно сделать?
Простейший вариант через QL-чарт, Ну или в датасете поле сделайте себе с today() без агрегации, простейшая агрегация any
У меня в таблице есть повторяющиеся проекты с бюджетами. Как посчитать сумму по всем проектам? если считать через агрегацию сумму - то он посчиатет по всем дублям, если через среднее - то посчитает сумму всего и поделит на общее число записей. А как сналача сгруппировать пропекты одинаковые, а потом по ним посчитать общую сумму. В общем, какой есть аналог groupby в datalens?
В документации есть описание оконных функций
Подключил Я.Метрика к Datalens. Вроде все отлично.
Но, не могу агрегировать данные по неделе/месяцу/году.
Возможно, надо преобразовать date-переменную в датасете?
при подключении по Апи там есть готовые поля с такими агрегациями
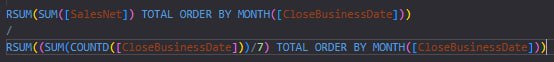
ошибка деления аггрегированого значения на не агрегированное, не могу понять, где у меня не аггрегированное значение, может поможете ?
Подозреваю, что дело в разных уровня агрегации. В числителе rsum+sum, а в знаменателе rsum+sum+countd
Почему формула AGO не работает?
Несоответствие агрегаций, судя по всему.
PostgreSQL норм с этой функцией работает.
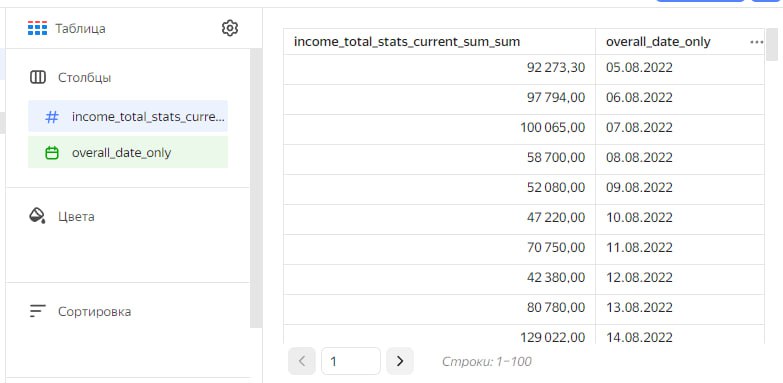
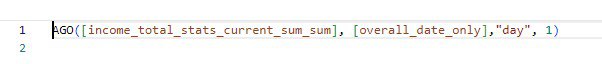
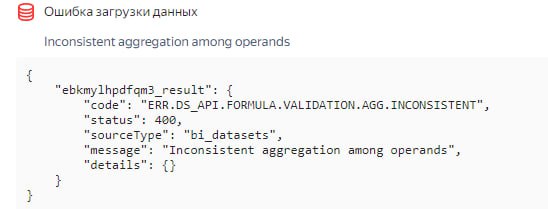
Подскажите, как можно решить проблему ошибки inconsistent aggregation в SUM_IF?
Судя по всему, ругается на дату в условии, а ее нету в качестве отдельного столбца в графике (там используется агрегация по всему периоду).
Пока думаю в сторону добавления параметра datetime_from и _to
если чего-то нет, то для агрегаций есть INCLUDE
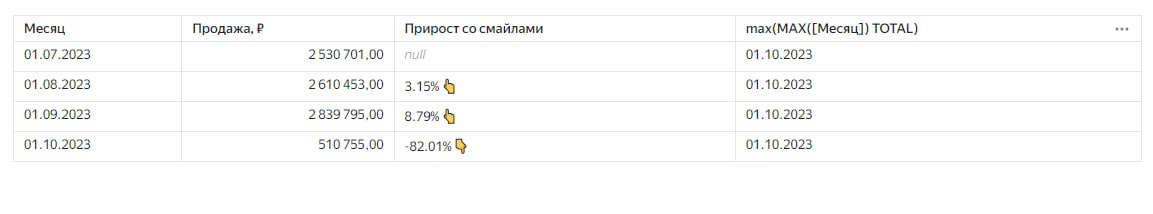
MAX([date] TOTAL)
Передает привет в виде ошибки:
Window function MAX has no aggregated expressions among its arguments
Я явно что-то делаю не так
внутри еще одна агрегация нужна. пример в правом столбце
описываю текстом, у меня есть процедуры которые имеют поле НМЦ(initialsum)и цену контракта(price) надо, при агрегации по полю заказчика(например) получается, что у заказчика несколько процедур, мне нужно посчитать экономию по тем процедурам у которых был заключен контракт
sum_if(суммируемое,условие) в зависимости от своих нюансов либо sum_if(val/val) либо sum_if(val)/sum_if(val)
не забывая про обработку null и безопасное деление на случай 0 в знаменателе
подскажите, почему в формуле SUM( SUM([Sales]) FIXED) нужно писать SUM два раза?
потому что SUM([Sales]) FIXED - это подзапрос и на верхнем уровне, вам нужно указать агрегацию для его результата
можете написать AVG(SUM...
Объясните пожалуйста принцип работы агрегации в DataLens. Я привык, что нужно указывать поле для агрегации например через GROUP BY, и поэтому мне непонятно как работает агрегация в интерфейсе, ведь мы не указываем поле группировки. Например, тут поставил суммирование по полю Sales. Агрегация будет считаться как сумма по уникальным датам? В справке раздел агрегации видел, не понял(
Это нужно смотреть не в датасете, где все показывается построчно, а в чартах, например в табличных будет очень наглядно. Для агрегаций по измерениям, которые в чарте присутствовать не должны, есть оконные и lod функции.
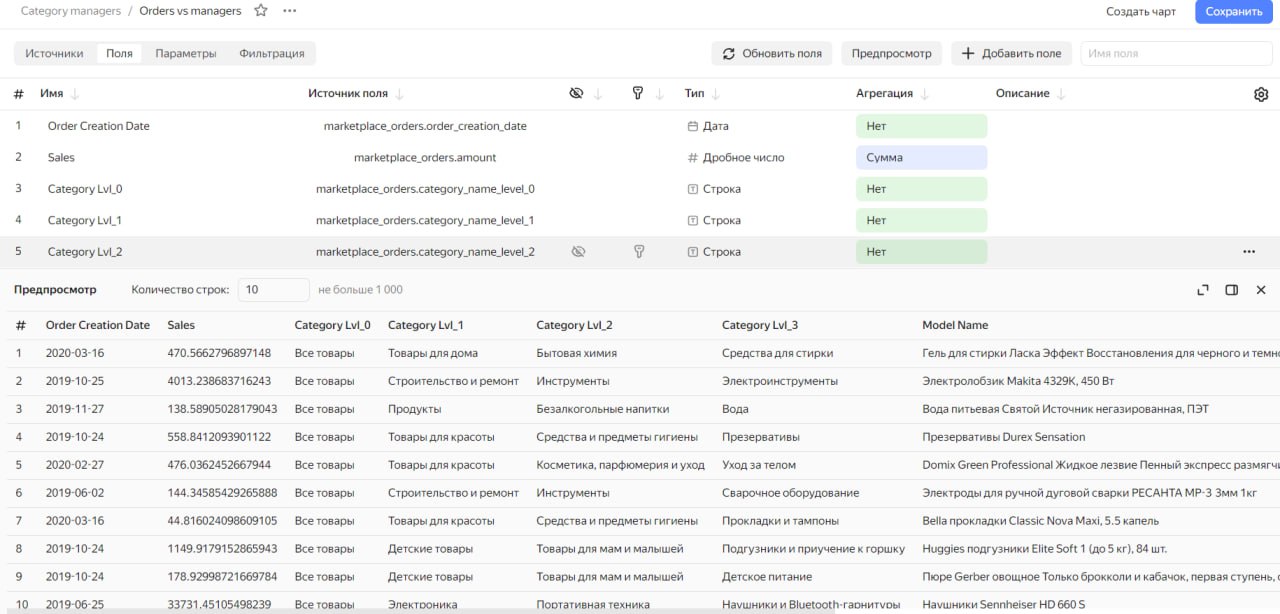
Подскажите, пожалуйста, как правильно посчитать дубли на уровне датасета и отразить результаты в новом поле избегая агрегации (сохраняя исходное количество строк).
Есть 2 поля:
1) ИД-шники клиента, повторение которых нужно посчитать и отразить в новом поле
2) Любое другое поле, не влияющее на задачу.
Пробовал это сделать и через count, countd, count_if, как оконные так и агрегированные, в результатах количество строк сокращается, чего хочется избежать.
Знаю, что это можно и проще сделать на уровне чарта, но поле нужно подготовить на уровне датасета для дальнейшего переиспользования.
Не пишу сюда свои попытки (формулы) т.к. толку в этом почти нет, после того как понял, что логически не могу дойти до этого, начал просто подбором пробовать варианты.
Оставляете исходное поле неагрегированным , делаете вычисляемое с count от первого. Все.
В предпросмотре датасета у вас всегда там будет 1, так как в предпросмотре group by *
А в чарте у вас будет на каждый id его количество
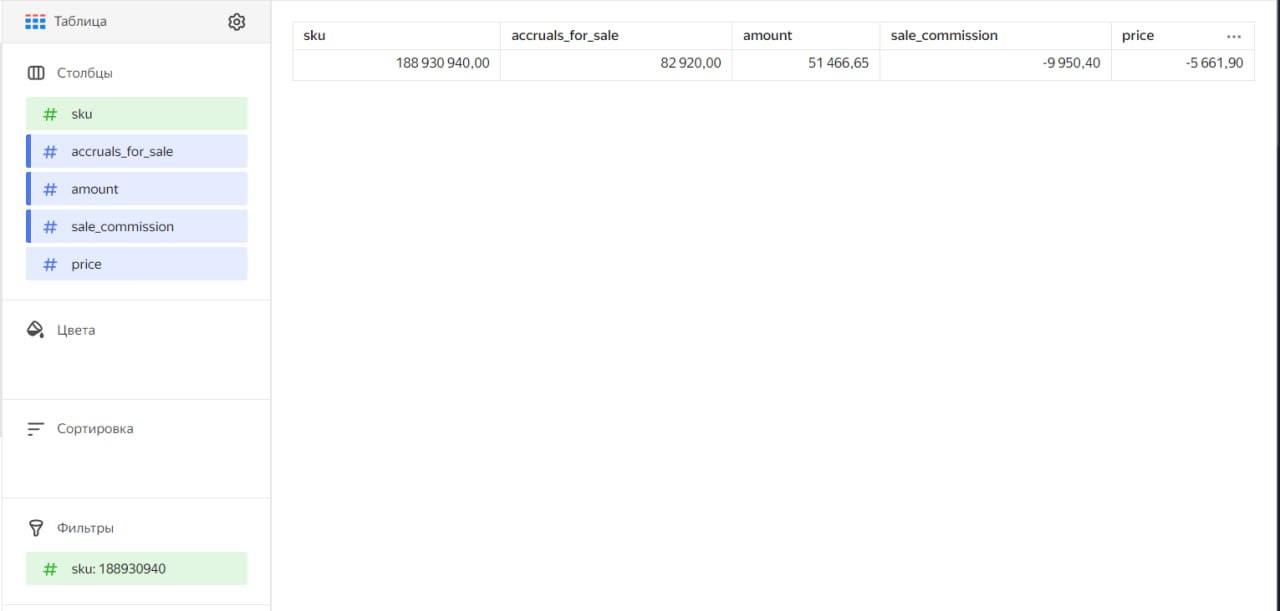
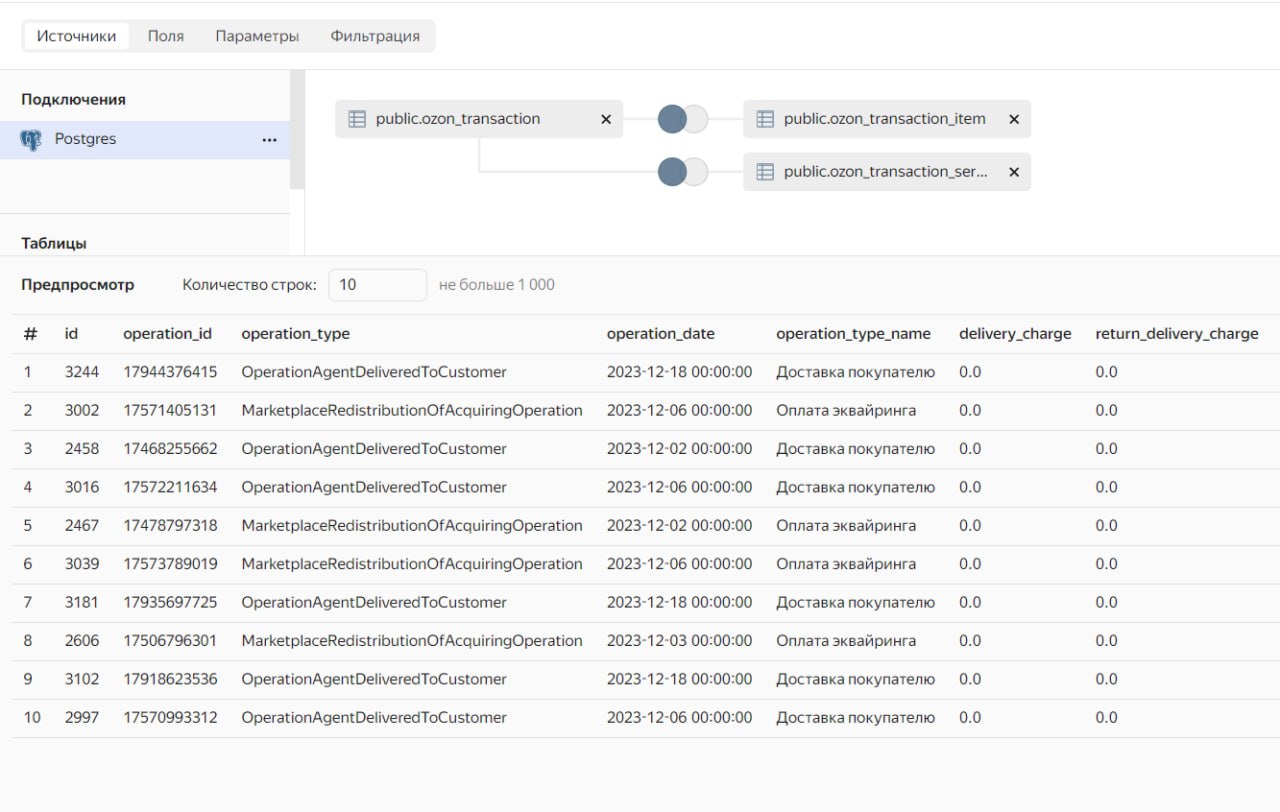
У меня есть датасет с информацией о транзакциях на маркетплейсе, не получается их агрегировать по sku - сумма в столбцах не равна 0.
Прикладываю скрины, как это выглядит.
Предполагаю, что проблема кроется именно в агрегации поля price. Потому что в датасете я использую left join, из-за этого каждая строка operation раскладывается в несколько строк по service id. Пока что не понимаю, как мне это сделать.
Витрину собрать сразу в СУБД
Оконные функции
Как можно применить функцию по аналогии с group by для индикатора?
Оконные функции AVG,OVER PARTITION, BY, необходимо выбрать параметр, по которому необходимо сгруппировать
Подскажите пожалуйста оконную ф-цию, если хочу показывать прирост от недели к недели по показателю то есть у второй недели будет подпись n% (на n% больше прошлой недели)
LAG() должен подойти в этом случае
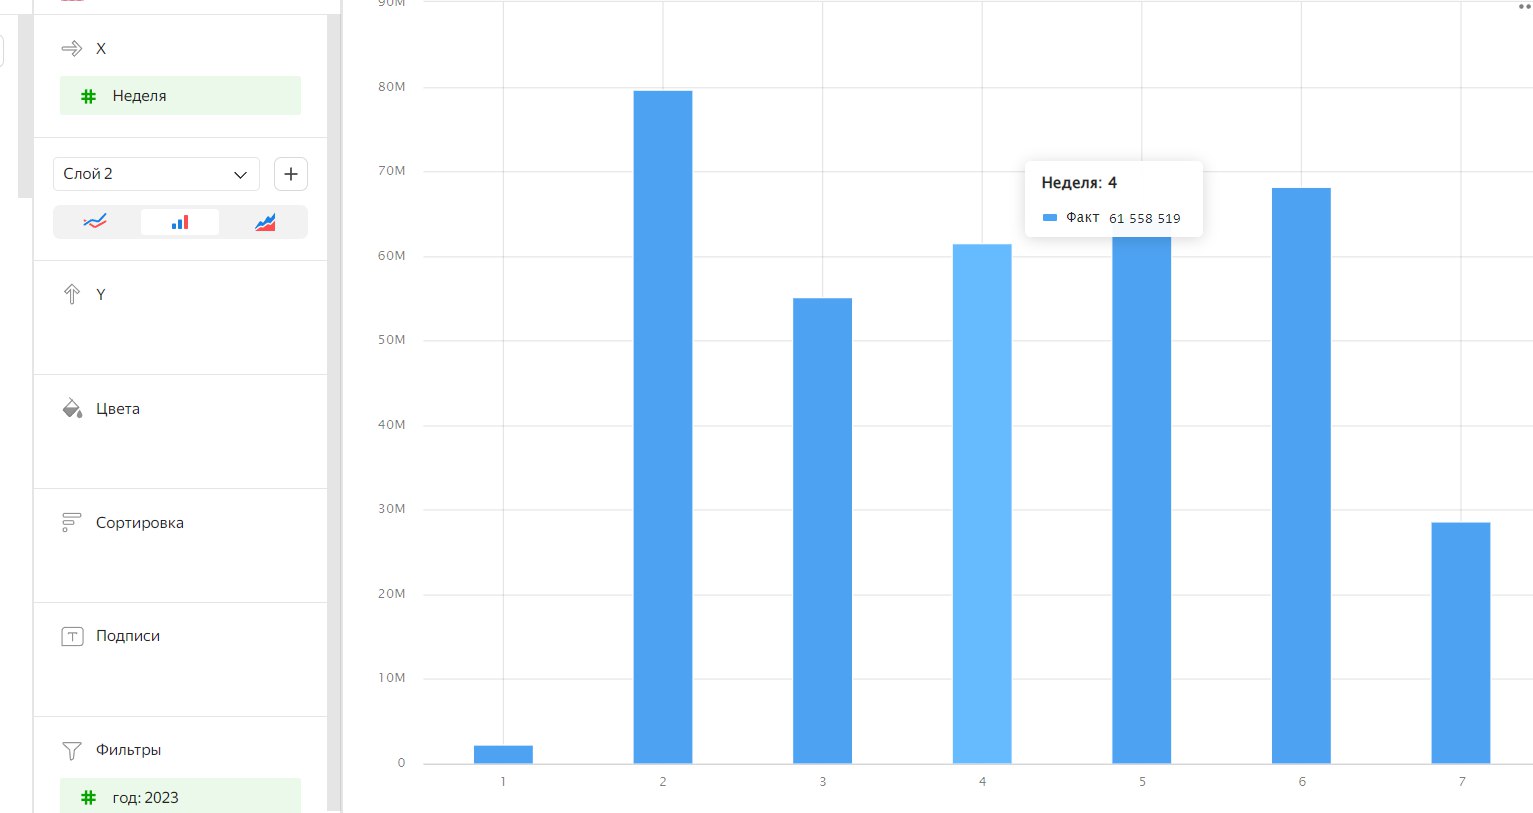
Это точно должно быть просто, но не пойму как: есть таблица с заказами. В таблице есть поле Магазин. Как посчитать процент заказов, которые приходятся на каждый магазин?
Оконные функции
почему нарастающий итог в таблице вывод в обратном порядке
Это оконная функция, ей лучше явно прописывать на какое поле опираться при сортировке и смотреть его надо по возрастанию и убыванию.

есть ли туториал по синтаксису оконок? В справке есть примеры, но без кода, которым они получены
демодашборд вы можете развернуть себе и тогда будете видеть, как все устроено и документацию никто не отменял
Друзья, напомните, как посчитать нарастающий итог?
Оконная функция с order by по датам
как можно в одной таблице вывести в одном столбце сколько продано товара за неделю, а в следующем за квартал (квартал выбирается автоматически в зависимости от того, в какой из них попадает выбранная через календарь неделя)?
через оконные функции
В датасете можно ли вычислить накопительную сумму?
Можно, с помощью оконных функций
У нас много регистраций относится к одному договору. Когда хотим посчитать сумму объема продаж, то она дублируется. Есть ли способ, как посчитать сумму по уникальным id договоров при этом не рушить связь с регистрациями? Спасибо!
Оконной функцией
Можно ли выставлять ранги с помощью оконной функции по дате?
Можно. Дату ставите в rank.
А можно как-то составить формулы, чтобы увидеть ТОП-3 по показателям?
Либо ранк, либо оконные функции с сортировками. В зависимости от вашей конкретики
Пытаюсь верно составить средний чек, но думаю, что вычитание по дню неверное. Т.к. аренда может идти более одного месяца, как мне верно высчитать разницу дат?
Вам будет проще это делать во View на стороне БД. А на стороне DataLens для таких случаев подойдут оконные функции.
подскажите пожалуйста. есть индикатор и нужно сделать расчёт суммы за предыдущий период.
Функция AGO возвращает ошибку (очевидно - там дата, а не диапазон).
Как сделать так, чтобы в индикаторе была сумма за предыдущий период?
Посмотрите на оконные функции
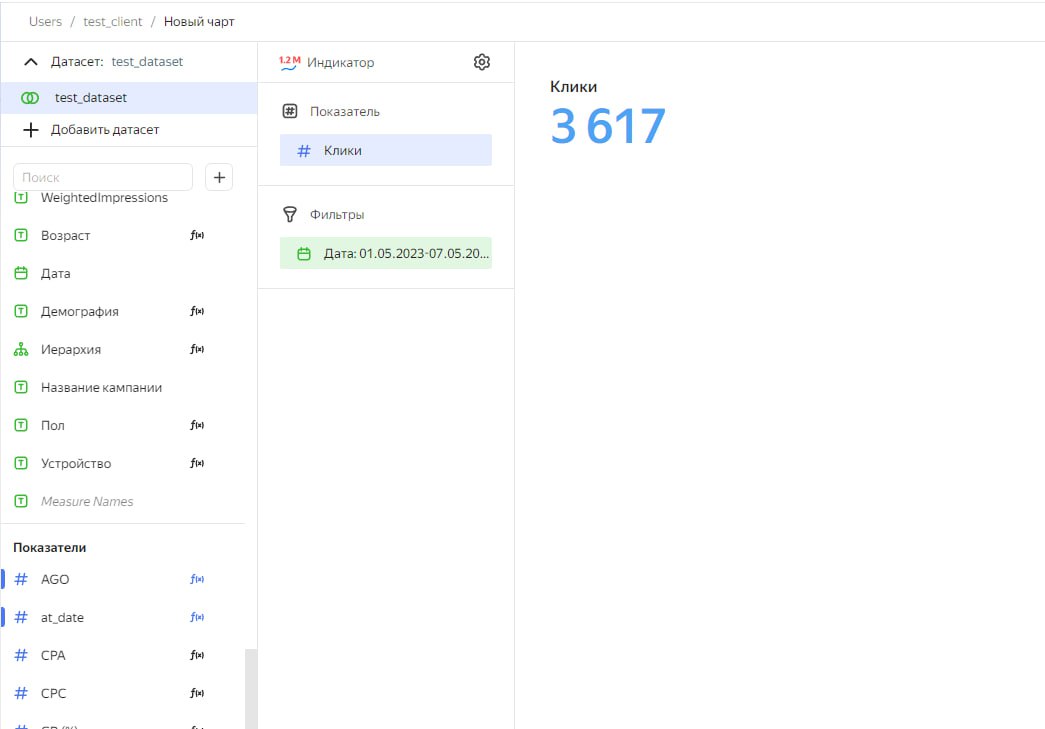
У меня есть 3 значения:
за 14 сентября - 28
за 15 сентября - 30 и 29
когда я в индикаторе ставлю среднее по всем датам - логично получаю 29
но я хотела также провести прямую от среднего на линейной диаграме
сделала оконкой - нифига не то. на графике рисует значение 28,75, то есть он считает среднее по дням, а потом среднее от них.
что в формуле исправить, чтоб среднее считалось без группировок?
AVG(AVG([Баллы]) TOTAL)
upd: before filter by [date] пробовала - не спасает
А попробуйте avg(баллы fixed)
Напомните, пож, как такое сделать?
RCOUNT
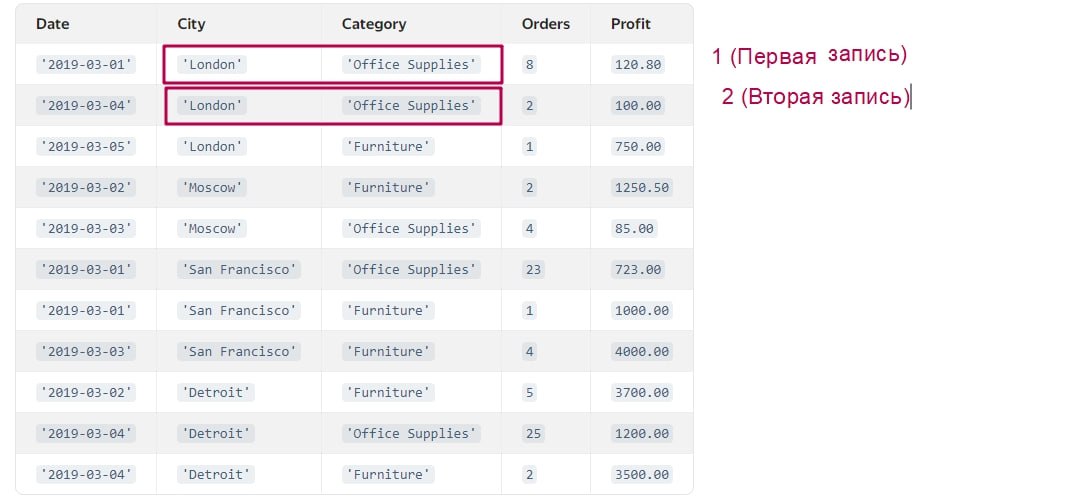
Получается оконная и агрегатная никак не отличаются по написанию, но различаются по кол-ву параметров. По идее если я передаю 2 параметра, то она должна восприниматься как оконная или я не прав? а тогда как функция поймёт для какого поля каунт делать?
COUNT применяется не для поля, а для строк. Вы проверяете сколько строк удовлетворяют условию и их считаете
Подскажите, пожалуйста, можно ли какой-то формулой взять количество строк таблицы без фильтрации (в BEFORE FILTER BY не хочется все фильтрующие поля писать, их очень много) задача - выводить долю отфильтрованных значений от размера всей таблицы
Нужно на уровне YQL создать поле оконной функцией и с помощью него считать
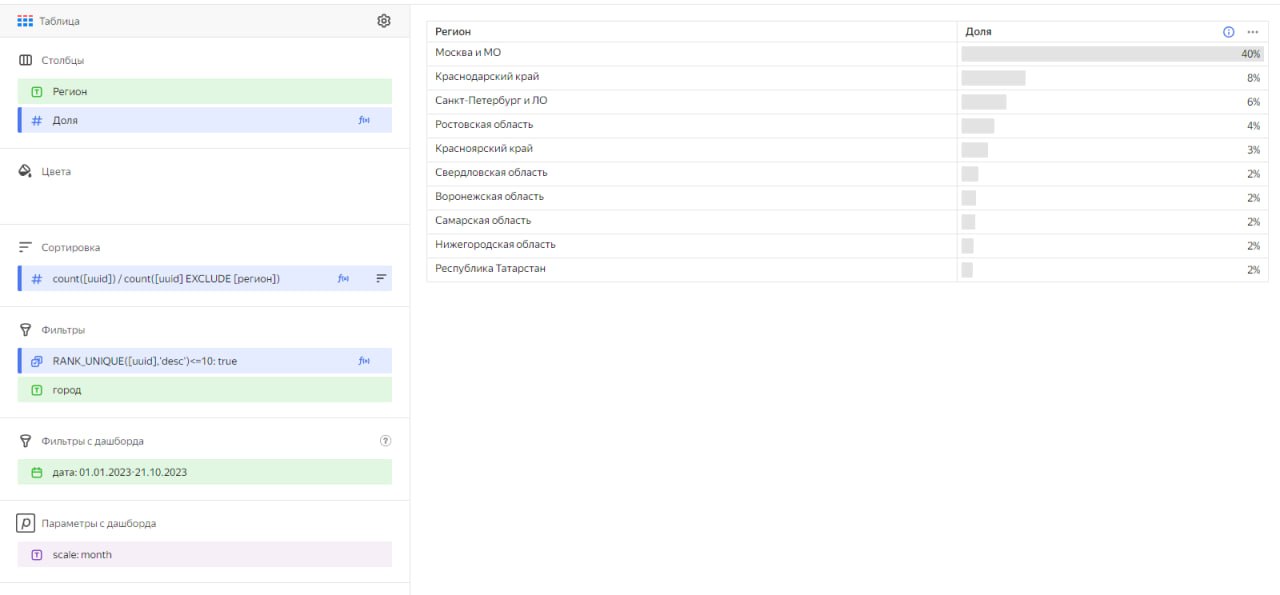
Подскажите, пожалуйста, как считать долю среди регионов, которые указываются в фильтре? Сейчас в таблице доли распределяются среди всех всех регионов (там их сотни), а нужно, чтобы только среди топовых 10ти
Используйте оконные функции, Total должен помочь при условии фильтрации до total. Да, как я понимаю тут с IF можно расчет сделать

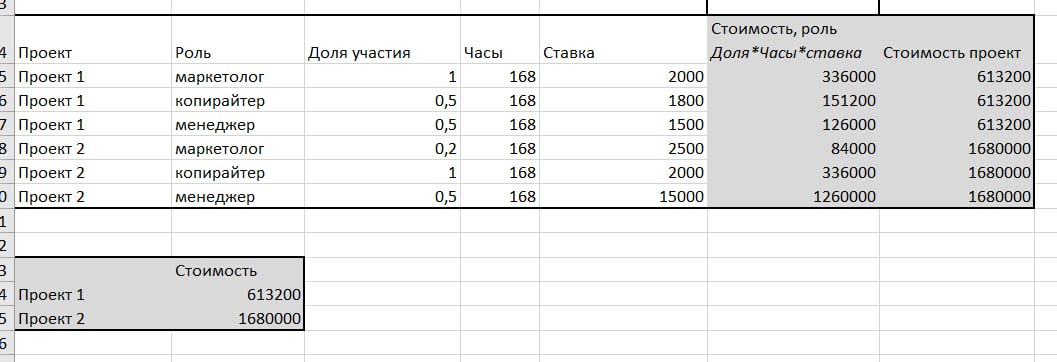
Подскажите пожалуйста по оконным функция. Есть таблица, с двумя вычисляемыми полями - стоимость по роли и стоимость проекта. Здесь через WITHIN получилось посчитать стоимость проекта.
Но в идеале, эта таблица должна отображать только название проекта и итоговую стоимость. Итоговая стоимость в таком случае считается по среднему, а мне нужно именно как в развернутой таблице - стоимость проекта равна сумме стоимости по ролям.
получилось через lod
Подскажите пожалуйста, если селектор в дашборде связан с полем (выбор даты).
Возможно ли в вычисляемом поле, обратиться к конечной дате? Если да то как, или где в документации написанно об этом?
Используйте оконку
Max([date] total), он заберет максимальное значение из селектора
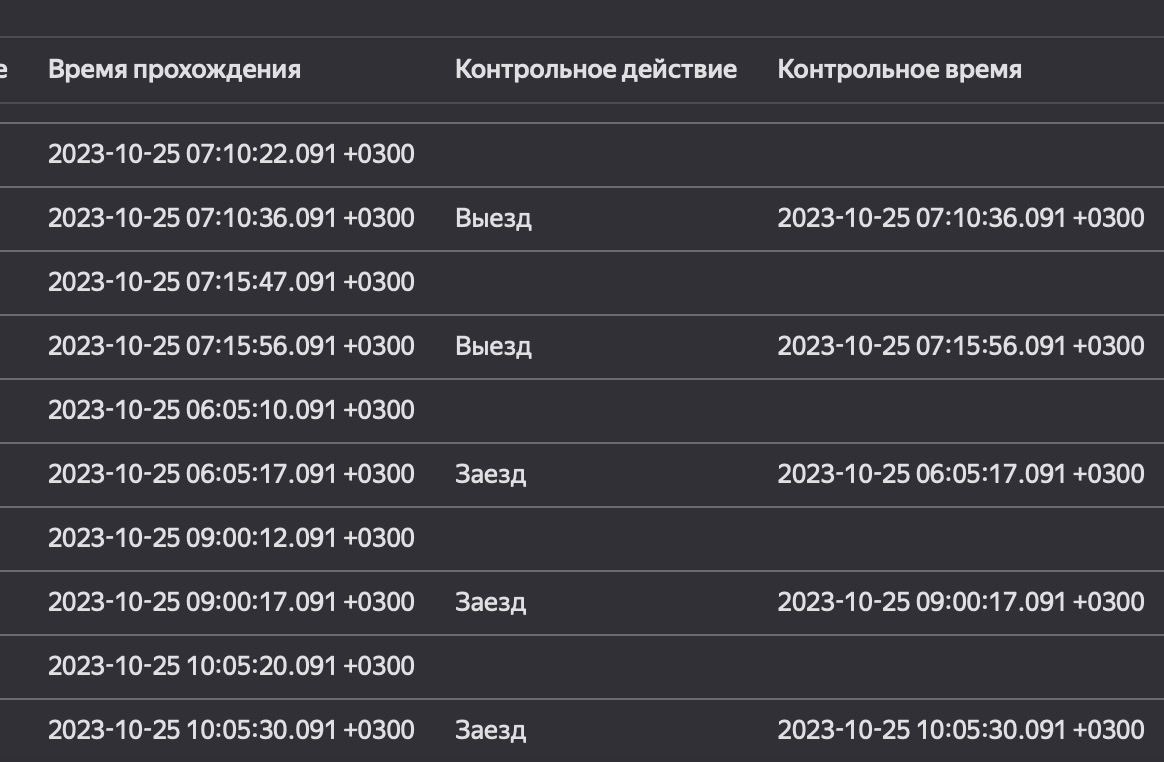
Имею столбец "Контрольное время)с временем ( или он меня имеет). Мне надо машина в гараже или выехала. Для этого я беру последнюю точку. КАК создать поле для присвоение значения "ПОСЛЕДНЕЕ ВРЕМЯ" LAST ([контрольное время]) не получилось. Киньте в меня советом или мануалом, пажалуйста. Мне целый отчет надо потроить на минимальном и максимальном времени
Можно попробовать через rank. вот тут есть на вкладке оконных функций пара примеров
https://datalens.yandex/9fms9uae7ip02/?tab=Are
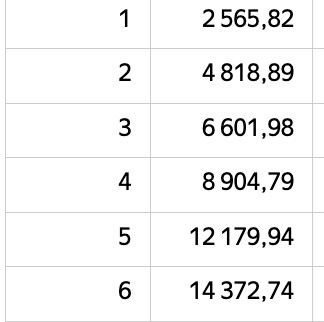
не очень получается разобраться с lod :( подскажите, как посчитать среднее количество id за неделю...
пишу как-то так: AVG(COUNTD([id]) fixed [Ned_sosd])
У меня тут задача, с которой не понимаю, как справиться. Есть таблица с продукцией, датой закупки продукции и количеством закупленной продукции. Мне нужно вывести количество закупленной продукции в первое и последнее число месяца и посчитать процент удорожания. Я вывел минимальную дату закупки в периоде, максимальную дату закупки в периоде, но как вывести количество закупленной продукции? Я пробовал через SUM_IF, менял условия, что минимальная дата закупки = первой дате закупке, а максимальная-последней дате закупки. Но при расчете формула показывает одно и то же значение. Подскажите пожалуйста, что сделано не так?
Решение реализуемо при помощи оконных функций.
подскажите, пожалуйста, какую оконную функцию нужно использовать, чтобы посчитать долю каждой ячейки в стобце относительно их суммы?
Не оконную, а lod
подскажите, пожалуйста, какую оконную функцию нужно использовать, чтобы посчитать долю каждой ячейки в стобце относительно их суммы?
[col] / sum([col] total)
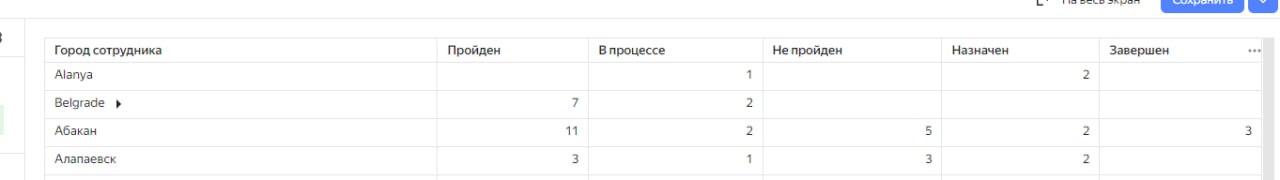
еще новичок, но как-то стандартным способом можно сделать долю по статусам от общего количества по всем статусам? Вычисляемое поле не получилось если только им, может кто подскажет плиз?
можно, вам в помощь оконные функции, опция TOTAL, например
Вопрос: Почему DATETRUNC в DataLens возвращает неожиданный месяц?
Ответ: DATETRUNC может учитывать размер периода и начало периода. Например, при округлении к 4-месячному периоду дата может перейти к началу соответствующего интервала, поэтому месяц результата отличается от исходного.
Вопрос: Что означает TODAY() в DataLens?
Ответ: TODAY() возвращает текущую дату, но результат может зависеть от источника данных, типа подключения и типа поля. Если функция показывает неожиданный результат, стоит проверить тип данных и то, где именно выполняется вычисление.
Вопрос: Почему SUM_IF выдает ошибку Inconsistent aggregation among operands?
Ответ: Такая ошибка обычно появляется, когда в одной формуле смешаны агрегированные и неагрегированные выражения. Нужно агрегировать числовой показатель и привести условие к совместимому уровню детализации.
Вопрос: Как посчитать показатель только за последний месяц?
Ответ: Нужно определить последний месяц через агрегированное выражение, затем использовать его в условии для расчета показателя. Важно, чтобы и показатель, и условие были согласованы по уровню агрегации.
Вопрос: Когда нужны оконные функции в DataLens?
Ответ: Оконные функции используют, когда расчет зависит от соседних строк, порядка сортировки или общей выборки: например, для нарастающего итога, ранжирования, сравнения с предыдущим периодом или расчета по группе.
- FAQ по DataLens: вычисляемые поля
- FAQ по DataLens: подключения к источникам и ролевые модели
- FAQ по DataLens: геоаналитика, сортировка и фильтрация
- FAQ по DataLens: чарты и дашборды 1


