

Greenplum для Data Science: Анализ Big Data с помощь SQL и Python
Эта статья является первой частью серии статей «Greenplum для Data Science и ML», в которой рассказывается о том, как использовать интегрированные функции Greenplum для решения проектов по анализу данных от экспериментов до массового развертывания.
Рост, вызовы и возможности данных
Мы живем в эпоху цифровых технологий, и все, что мы делаем с помощью наших смартфонов, планшетов, компьютеров и даже бытовой техники, генерирует огромное количество разнообразных данных. Сбор данных ради того, чтобы их было больше – дело, конечно, захватывающее, но абсолютно бессмысленное. Необходимо четко понимать, ради чего эти данные собираются, какие цели мы преследуем. Именно здесь на помощь и приходят специалисты по Data Science.

Как специалисты по Data Scienсe могут нам помочь
Среди всех областей, связанных с данными, Data Science - это область исследований, которая использует данные и количественное моделирование для создания результатов, имеющих определенное значение для пользователей. В этом контексте специалист по Data Science занимается широким спектром задач, включая, но не ограничиваясь следующими:
- Сотрудничество с разработчиками для установления контакта с пользователями для того, чтобы лучше понять их потребности и изучить, как мы можем использовать данные и алгоритмы таким образом, чтобы действительно их порадовать.
- Определение приоритетов для следующих разработок совместно с менеджерами по продуктам.
- Сотрудничество с дата-инженерами для подготовки данных к анализу.
- Изучение данных и построение моделей ML для удовлетворения потребностей пользователей - чаще всего на языках Python, R или SQL.
- Взаимодействие с инженерами-программистами для развертывания моделей в виде сервисов, которые могут быть использованы приложениями или непосредственно пользователями.
- Итеративное повторение пунктов (1)-(5) для того, чтобы максимально точно удовлетворить постоянно растущие потребности пользователей.
Фокус серии статей: технические подходы и инструменты, позволяющую извлечь максимальную ценность из Big Data
Перечисленные выше виды деятельности включают в себя аспекты, связанные с тем, как работают специалисты по Data Science), а также инструменты и технологии, необходимые для их продуктивной работы. В этой серии технических статей мы сосредоточимся на инструментальной составляющей, в первую очередь связанной с пунктом № 4 из списка, приведенного выше.
В частности, мы рассматриваем сценарии, в которых специалист по Data Science исследует данные и строит модели машинного обучения на основе огромного набора данных. В этом контексте специалист по исследованию данных может столкнуться с особыми техническими проблемами, включая следующие:
- Медленный конвейер обработки данных при работе с большими объемами данных
- Ограниченные объемы памяти и вычислений в традиционных средах выполнения Python/R
- Ограниченный аналитический функционал в платформах, позволяющих вычислять большие данные
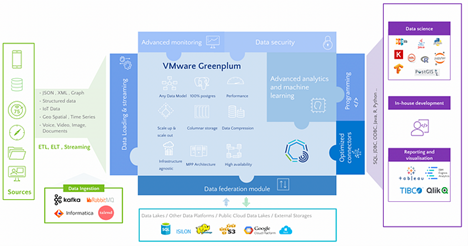
Почему именно Greenplum?
Экспорт данных из базы данных и их импорт в серверную среду с помощью широко используемых инструментов для работы с данными (например, Python, R) – далеко не самый идеальный вариант для работы с Big Data. Как было описано выше, специалистам по Data science может потребоваться помощь в решении проблем, связанных с ограничениями памяти и масштабируемости этих инструментов, а также с узкими местами, связанными с передачей больших объемов данных между различными платформами.
Именно в этом случае выбор правильного инструмента становится критически важным фактором успеха работы специалиста по Data Science. В этом статье мы рассмотрим Greenplum, движок PostgreSQL, предназначенный для массивно-параллельной обработки данных, который предоставляет ученым встроенные инструменты для исследования данных в больших объемах и обучения моделей. Эти инструменты и расширения включают в себя:
- Apache MADlib для МО
- Раширения процедурных языков для оптимизации работы с Python и R
- PostGIS для геоаналитики и GPText для поиска и обработки текстов
- Совместимость с инструментами для создания дашбордов, такими как Tableau, PowerBI …
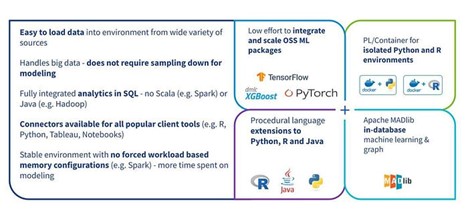
В этом посте мы расскажем, как начать работу с Greenplum, и поделимся примерами того, как специалист по Data Science может использовать все вышеупомянутые инструменты.
Часть 1: Установка и подключение
1. Установите пакет:
!pip install ipython-sql pandas numpy sqlalchemy plotly-express sql_magic pgspecial
2. Импортируйте пакет:
import pandas as pd
import numpy as np
import os
import sys
import plotly_express as px
# For DB Connection
from sqlalchemy import create_engine
import psycopg2
import pandas.io.sql as psql
import sql_magic
3. Подключитесь к Greenplum:
Существует несколько способов подключения к Greenplum. С помощью блокнота Jupyter можно испольовать «магию» SQL .
- Установка на клиенте:
!pip install ipython-sql
- Для работы на уровне блокнота:
% load_ext _ sql
% sql postgresql://<user>:<password>@<IP_address>:<port>/<database_name>
- Затем выполните следующие SQL команды:
%% sql
SELECT version ();

Вы также можете использовать коннектор psycopg2 или pyodbc (существуют и другие способы, например, через JDBC)
Часть 2: обзор набора данных
В этой серии статей мы будем использовать набор данных Daily Financial News , взятый с Kaggle под лицензией CC0: Public Domain. Для обучения NLP модели выполнению анализа тональности новостей мы будем использовать Greenplum и выполним все этапы жиненного цикла Data Science (Исследование данных — Подготовка данных — Моделирование данных — Оценка модели — Развертывание модели).
Набор данных содержит заголовки с сайта Benzinga.com и его партнеров. Его размер увеличен примерно до четырех миллионов строк, что является довольно большим набором данных. Он разделен на следующие семь столбцов:
- docid — целое число: уникальный индекс
- title — текст: заголовок строки
- content — текст: эквивалентен title
- url — текст: ссылка на новость
- publisher — текст: издаель новостей
- date — дата: дата публикации
- stock — текст: символ биржевого тикера, относящийся к новости
Для начала работы с этим набором данных мы выполним исследовательский анализ данных с помощью специальной команды SQL без использования других расширений (о которых мы расскажем в следующих частях этой серии статей).
Часть3: подготовка данных
Набор данных сохранен в таблице source_financial_news. Давайте рассмотрим ее одну строку:
%%sql
SELECT * FROM source_financial_news LIMIT 1;
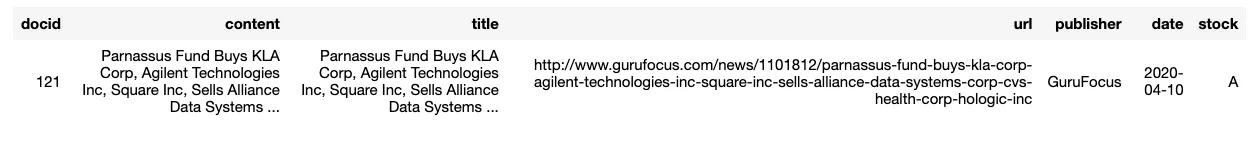
Точное количество строк, содержащихся в таблице:
%%sql
SELECT count(*) FROM source_financial_news;

Партиционирование таблиц в целях увеличения производительности обработки запрсосов
Поскольку старые новости будут использоваться нечасто, создадим таблицу ds_demo.financial_news, разбитую по дате, в которой нас интересуют новости, опубликованные после 2010 года.
Установка в качестве распределенного ключа уникального индекса docid позволяет равномерно распределить данные по разным сегментам.
Кроме того, установка хранилища, ориентированного на столбцы, и параметра appendoptimized на True повышает общую аналитическую производительность.
%%sql
DROP TABLE IF EXISTS ds_demo.financial_news;
CREATE TABLE ds_demo.financial_news
(     LIKE source_financial_news
) WITH (appendoptimized=true, orientation=column)
DISTRIBUTED BY(docid)
PARTITION BY RANGE (date)
(     START (date '2010-01-01') INCLUSIVE
    END (date '2024-01-01') EXCLUSIVE
    EVERY (INTERVAL '1 month'),
    DEFAULT PARTITION old_news
); -- Insert data from the source table into a newly created partitioned table
INSERT INTO ds_demo.financial_news SELECT * FROM source_financial_news;
Описание вновь созданной аналитической таблицы показано ниже:
%sql \d+ ds_demo.financial_news
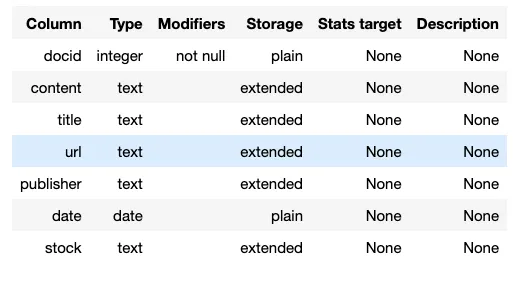
NB: В Greenplum 7 разделы не обязательно должны следовать одним и тем же настройкам, пользователи могут настраивать их в соответствии со своими потребностями.
Проверьте равномерноcть распределения нашей таблицы
Теперь, когда наша новая таблица успешно создана, давайте проверим равномерность ее распределения, вычислив стандартное отклонение количества строк, приходящееся на 1 сегмент.
%%sql
-- Standard deviation to check table distribution
SELECT STDDEV(count)
FROM (
    SELECT gp_segment_id, COUNT(*)
    FROM ds_demo.financial_news
    GROUP BY 1
) table_distribution ;
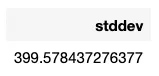
По сравнению со средним значением (163383,333) наше стандартное отклонение очень низкое (399,5784). Таким образом, наша таблица распределена равномерно!
Партиционирование для сканирования только нужных данных
При использовании партиционирования нет необходимости сканировать все разделы для того, чтобы ответить на какой-либо вопрос.
%%sql
-- Show the execution plan "EXPLAIN" and check scanned partitions
EXPLAIN SELECT COUNT(*)
        FROM ds_demo.financial_news
          WHERE date >= '2020-01-01'
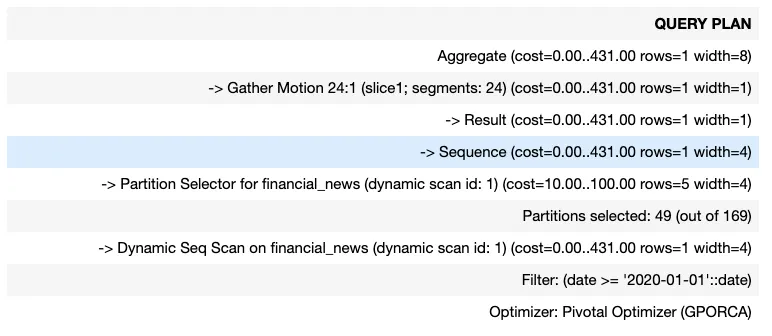
Более того, если мы добавим условие sup_date на дату, то не нужно будет сканировать разделы с датой, превосходящей sup_date
Часть 4: Исследовательский анализ данных с помощью SQL & MADlib
Далее для аналитики непосредственно в базе данных мы будем использовать SQL (sqlmagic для интерактивных результатов с базой данных Greenplum) и MADlib, библиотеку с открытым исходным кодом на основе SQL, которая предоставляет параллельные реализации математических, статистических и графовых методов для структурированных и неструктурированных данных.
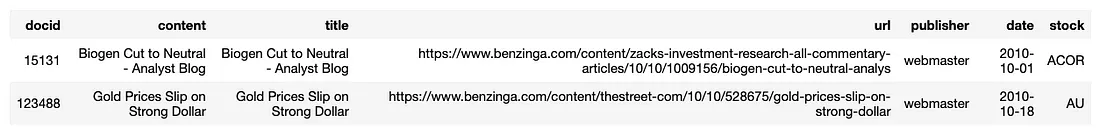
1/ Еще один обзор первых двух строк таблицы
%%sql
SELECT * FROM ds_demo.financial_news LIMIT 2 ;
2. Apache MADlib для надежной и мощной статистики с использованием SQL
Убедитесь в том, что расширение MADlib включено!
%sql SELECT madlib.version();

2.1. Статистическое описание таблицы - MADlib
Функция MADlib summary() выводит сводную статистику для любой таблицы данных. Функция вызывает различные методы из библиотеки MADlib для того, чтобы предоставить обзор данных.
%%sql
DROP TABLE IF EXISTS ds_demo.financial_news_summary;
SELECT * FROM madlib.summary(
        'ds_demo.financial_news', 'ds_demo.financial_news_summary'
);
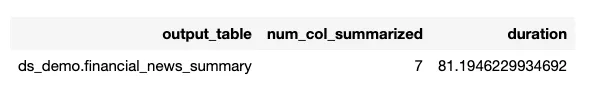
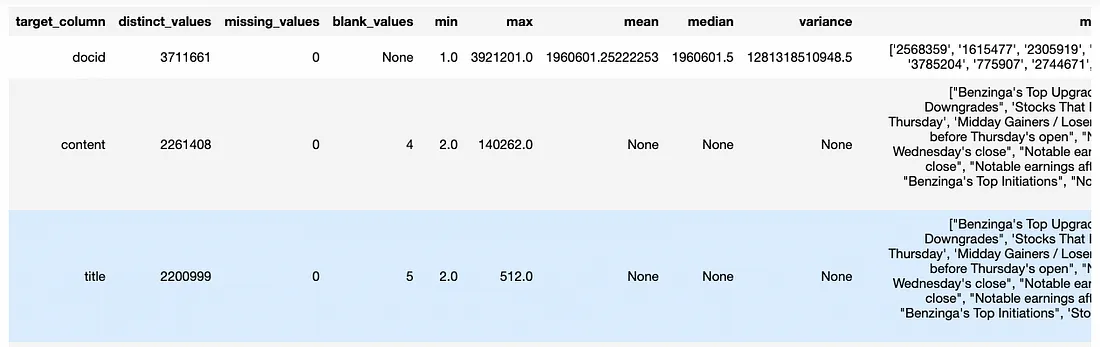
Вывод функции summary() сохраняется в таблице ds_demo.financial_news_summary.
%%sql
SELECT
    target_column, distinct_values, missing_values, blank_values,      min, max, mean, median, variance, most_frequent_values FROM ds_demo.financial_news_summary;
3. Количество новостей, приходящихся на дату
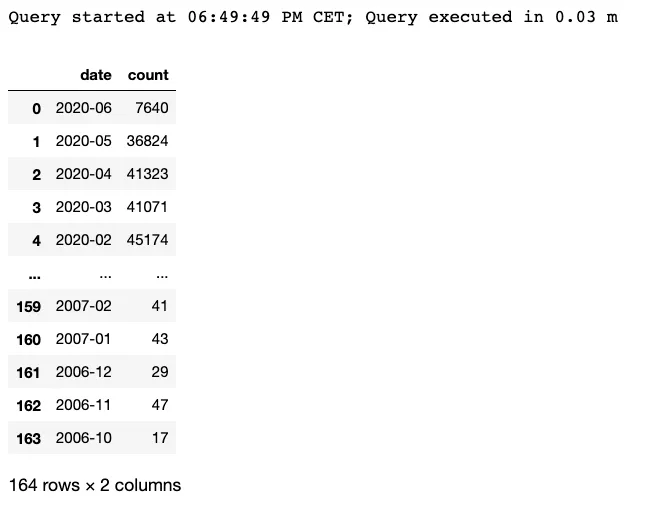
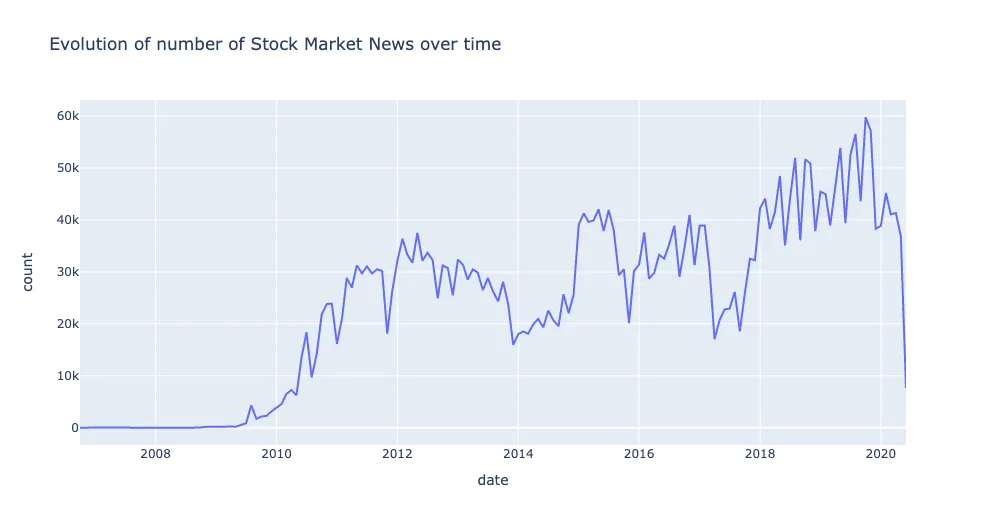
Для того, чтобы увидеть динамику изменения количества новостей за несколько месяцев:
- Преобразуйте столбец даты в формат Год-Месяц с помощью SQL-функции to_char.
- Сгруппируйте данные по отформатированной дате и вычислите частоты с помощью функции COUNT(*).
- Наконец, упорядочите итоговые результаты по дате.
%%read_sql df_news_per_date
SELECT
    to_char(date,'YYYY-MM') as date,
    COUNT(*)
FROM ds_demo.financial_news
    WHERE date IS NOT NULL
GROUP BY 1
ORDER BY 1
DESC;
Теперь давайте визуализируем агрегированные результаты с помощью Plotly:
px.line(df_news_per_date,
        x = 'date',
        y = 'count',
        title='Evolution of number of Stock Market News over time')
4. Гистограмма длины финансовых новостей
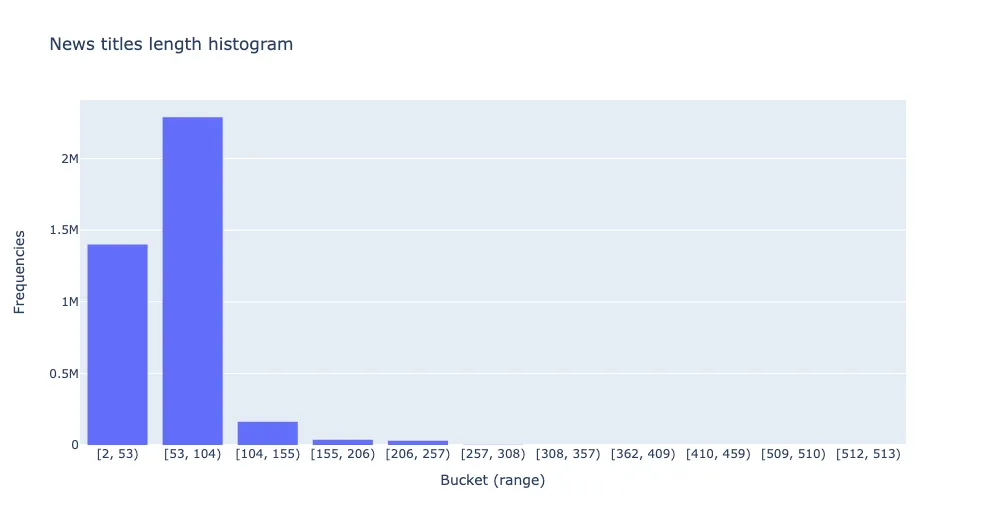
Визуализация распределения длины финансовых новостей:
%%read_sql df_histogram
WITH drb_stats AS (
    SELECT min(length(title)) AS min,
           max(length(title)) AS max
      FROM ds_demo.financial_news
),      histogram AS (
   SELECT width_bucket(length(title), min, max, 10) AS bucket,
          int4range(MIN(length(title)), MAX(length(title)), '[]') AS range,
          COUNT(*) AS freq
     FROM ds_demo.financial_news, drb_stats
     GROUP BY bucket
     ORDER BY bucket
) SELECT bucket, range, freq,
        repeat('■',
               (   freq::FLOAT
                 / MAX(freq) OVER()
                 * 30
               )::INT
        ) AS bar
FROM histogram
ORDER BY bucket ASC
;
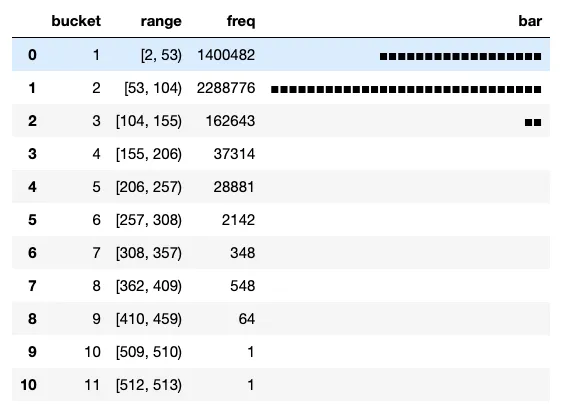
fig = px.histogram(y = df_histogram.freq,
                   x = df_histogram.range.astype(str),
                   nbins=10,
                   title = 'News titles length histogram')
fig.update_layout(yaxis_title="Frequencies", xaxis_title = 'Bucket (range)')
fig.show()
5. Количество новостей на одну акцию
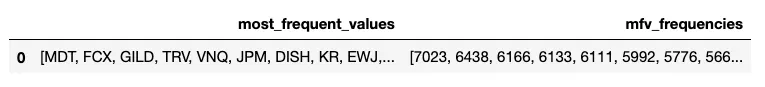
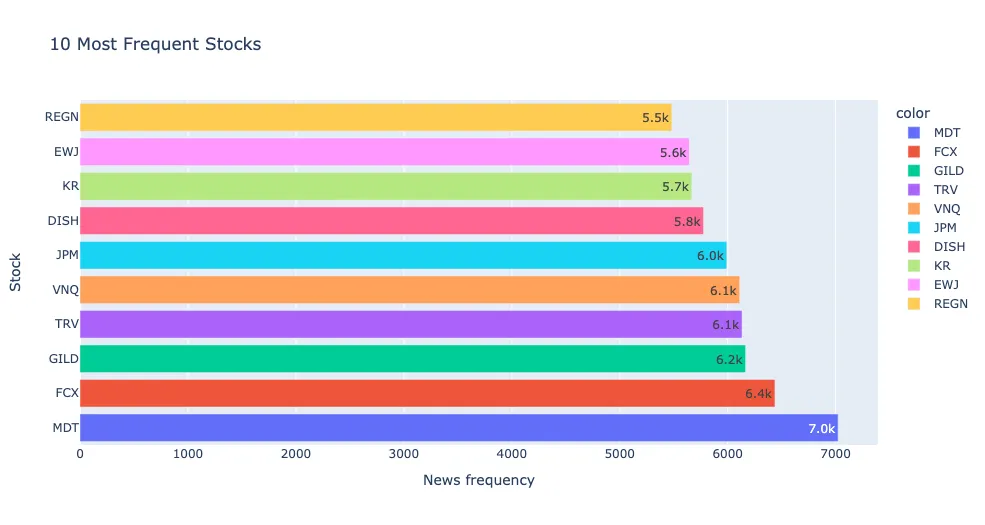
Для визуализации наиболее часто встречающихся результатов используйте сводные результаты MADlib.
%%read_sql df_stock_frequencies
SELECT most_frequent_values, mfv_frequencies
FROM ds_demo.financial_news_summary
  WHERE target_column = 'stock';
px.bar(y = df_stock_frequencies.most_frequent_values.values[0],
       x = df_stock_frequencies.mfv_frequencies.values[0],
       color = df_stock_frequencies.most_frequent_values.values[0],
       labels={'x':'News frequency', 'y': 'Stock'},text_auto='.2s',
       title="10 Most Frequent Stocks")
6. Количество новостей, приходящееся на одного издателя (источник)
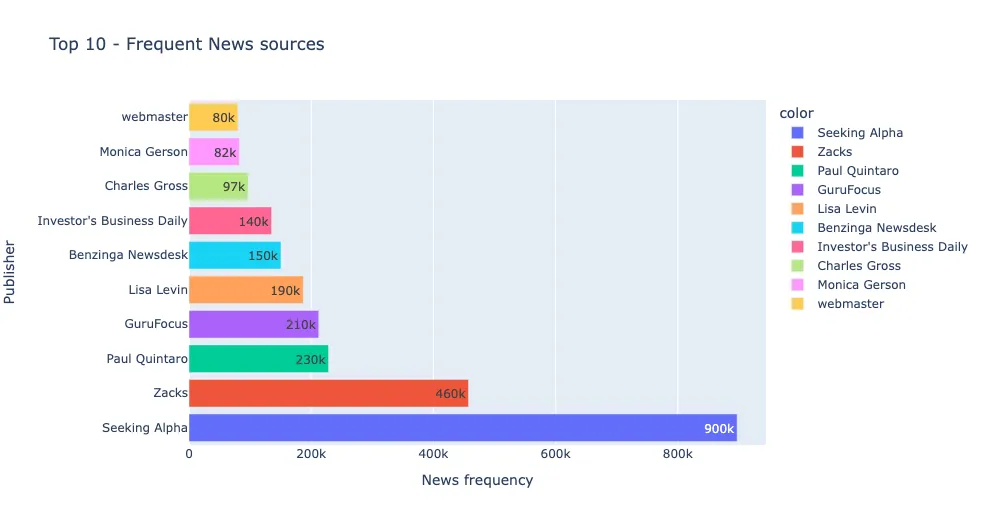
Давайте найдем издательство, которое чаще всего встречается в нашем наборе данных:
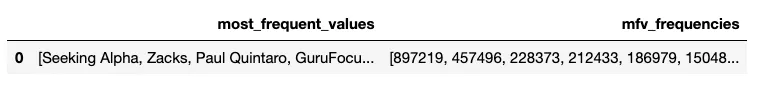
%%read_sql df_publisher_frequencies
SELECT most_frequent_values, mfv_frequencies
FROM ds_demo.financial_news_summary
  WHERE target_column = 'publisher';
px.bar(y = df_publisher_frequencies.most_frequent_values.values[0],
       x = df_publisher_frequencies.mfv_frequencies.values[0],
       color = df_publisher_frequencies.most_frequent_values.values[0],
       labels={'x':'News frequency', 'y': 'Publisher'},text_auto='.2s',
       title="Top 10 - Frequent News sources")
7. Какой сайт чаще всего встречается в наборе данных?
%%read_sql df_url_domain
SELECT
        split_part(REGEXP_REPLACE(url, '^(https?://)?(www\.)?', ''), '/', 1) AS source_url,
        count(*) as frequency
FROM (SELECT
        CASE WHEN url IS NOT NULL THEN url ELSE 'Other' END
        AS url
      FROM ds_demo.financial_news
      ) t GROUP BY 1
ORDER BY 2 ASC;
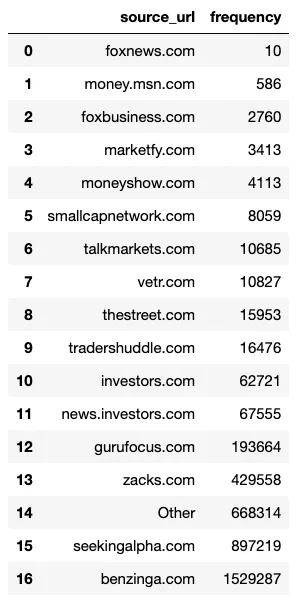
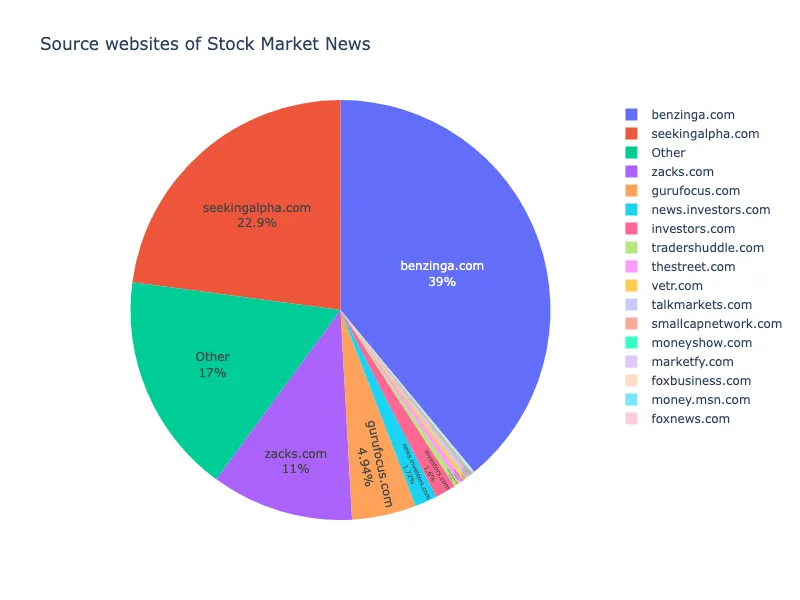
fig = px.pie(df_url_domain,
             names = 'source_url', values = 'frequency',
             width=800, height=600,
             title='Source websites of Stock Market News')

fig.update_traces(textposition='inside', textinfo='percent+label')
fig.show()
Заключение
В заключение следует отметить, что аналитики и ученые могут использовать производительность Greenplum и возможности массивно-параллельной обработки данных для обработки и изучения больших массивов данных с помощью встроенных аналитических функций, комбинируя SQL и Apache MADlib и визуализируя результаты с помощью Python.


