

Интеграция Apache Spark, AST и Apache Atlas: архитектура линейности данных, моделирование и прототип с практическими кейсами
Современные корпоративные инфраструктуры данных сталкиваются с задачей прослеживаемости происхождения и трансформаций данных на всем жизненном цикле: от их источников до конечных аналитических потребностей. Классический подход к управлению метаданными фрагментирован и часто не охватывает жизненный цикл сложных вычислительных графов, характерных для систем обработки больших данных. В условиях растущих требований к прозрачности, аудируемости и соответствию регуляторным нормам становится необходимым объединить три ключевых элемента: вычислительную платформу (Apache Spark), формализованные представления планов обработки (абстрактное синтаксическое дерево, AST) и систему управления метаданными и линейностью (Apache Atlas).
Цель данного исследования — показать архитектурную концепцию интеграции Spark, AST и Atlas, которая позволяет не только визуализировать и хранить линейность данных, но и формализовать типы данных и процессов таким образом, чтобы Atlas мог отражать входы, выходы и связи между ними. В рамках прототипа предложены:
- единый подход к моделированию логического плана Spark как AST;
- создание иерархий кастомных типов Atlas (pico_spark_data_type и pico_spark_process_type) для представления DataSet и Process;
- механизм преобразования AST в Atlas-совместимый формат и загрузки сущностей через REST API Atlas;
- демонстрационный кейс на примере набора данных cars.csv, иллюстрирующий генерацию линейности и связь между данными и процессами;
- анализ рисков, ограничений и направлений дальнейшей разработки.
Понимание архитектурной сущности взаимодействия Spark/AST/Atlas позволяет перейти от концептуального уровня к реализационному: проектирование расширяемого контура метаданных, который поддерживает эволюцию планов обработки, рефлексию данных на уровне схем, а также аудит и мониторинг линейности в реальном времени. В этом контексте прототип служит наброском методологии, демонстрирующим принципы интеграции и архитектурные решения, которые подлежат дальнейшей доработке, тестированию в производственной среде и социальной адаптации к специфике отрасли.
Теоретическая база: концепции data lineage, метаданных и абстрактного синтаксического дерева
Data lineage (линейность данных) — это отображение происхождения и трансформаций данных в рамках информационной системы. В классическом понимании линейность охватывает источники данных, промежуточные преобразования и конечные результаты, позволяя ответить на вопросы: какие данные повлияли на конкретный набор вывода, какие переходы произошли между уровнями абстракции, и какие зависимости существуют между процессами и данными. В современных платформах линейность становится неотъемлемым компонентом управляемости данных, поскольку она обеспечивает прозрачность, воспроизводимость вычислений и соответствие регуляторным требованиям.
Метаданные — это данные о данных. Они описывают контекст, структуру, источники, качество, владение и жизненный цикл объектов данных. В рамках нашей архитектурной концепции метаданные выступают в роли единой границы взаимодействия между Spark как вычислительной средой и Atlas как системой управления знаниями о данных. В Atlas собственно сущности описываются посредством типов, атрибутов и отношений. В частности, для задач линейности нам необходимы концепты DataSet (наборы данных) и Process (процессы), поддерживаемые базовым наследованием в Atlas. Концепции абстрактного синтаксического дерева (AST) применяются для формализации структур логических планов Spark и подготовки их к сохранению в виде семантически значимых сущностей Atlas.
AST — это графовая структура, представляющая синтаксическую иерархию плана обработки данных. В контексте Spark AST становится мостом между динамично развиваемыми планами (логическими представлениями) и статическими метаданными Atlas. Преимущества AST очевидны: автономность трансформаций, возможность агрегации и ранжирования узлов, а также гибкость внедрения новых узлов и типов, соответствующих evolutive архитектуре данных. В комбинации Spark+AST+Atlas формируется устойчивый каркас для трассируемого и управляемого движения данных через сложные вычислительные графы.
С точки зрения методологии проектирования, мы опираемся на три слоя:
- слой вычислений: Apache Spark, его логические и физические планы;
- слой моделирования: AST как абстракция логического плана;
- слой метаданных: Apache Atlas как репозиторий типов, сущностей и линейности.
Эта триада обеспечивает не только техническое решение, но и методику эволюционного развития архитектуры, позволяя постепенно расширять наборы типов, внедрять новые правила преобразования и наращивать функциональность мониторинга линейности в контекстах реального применения.
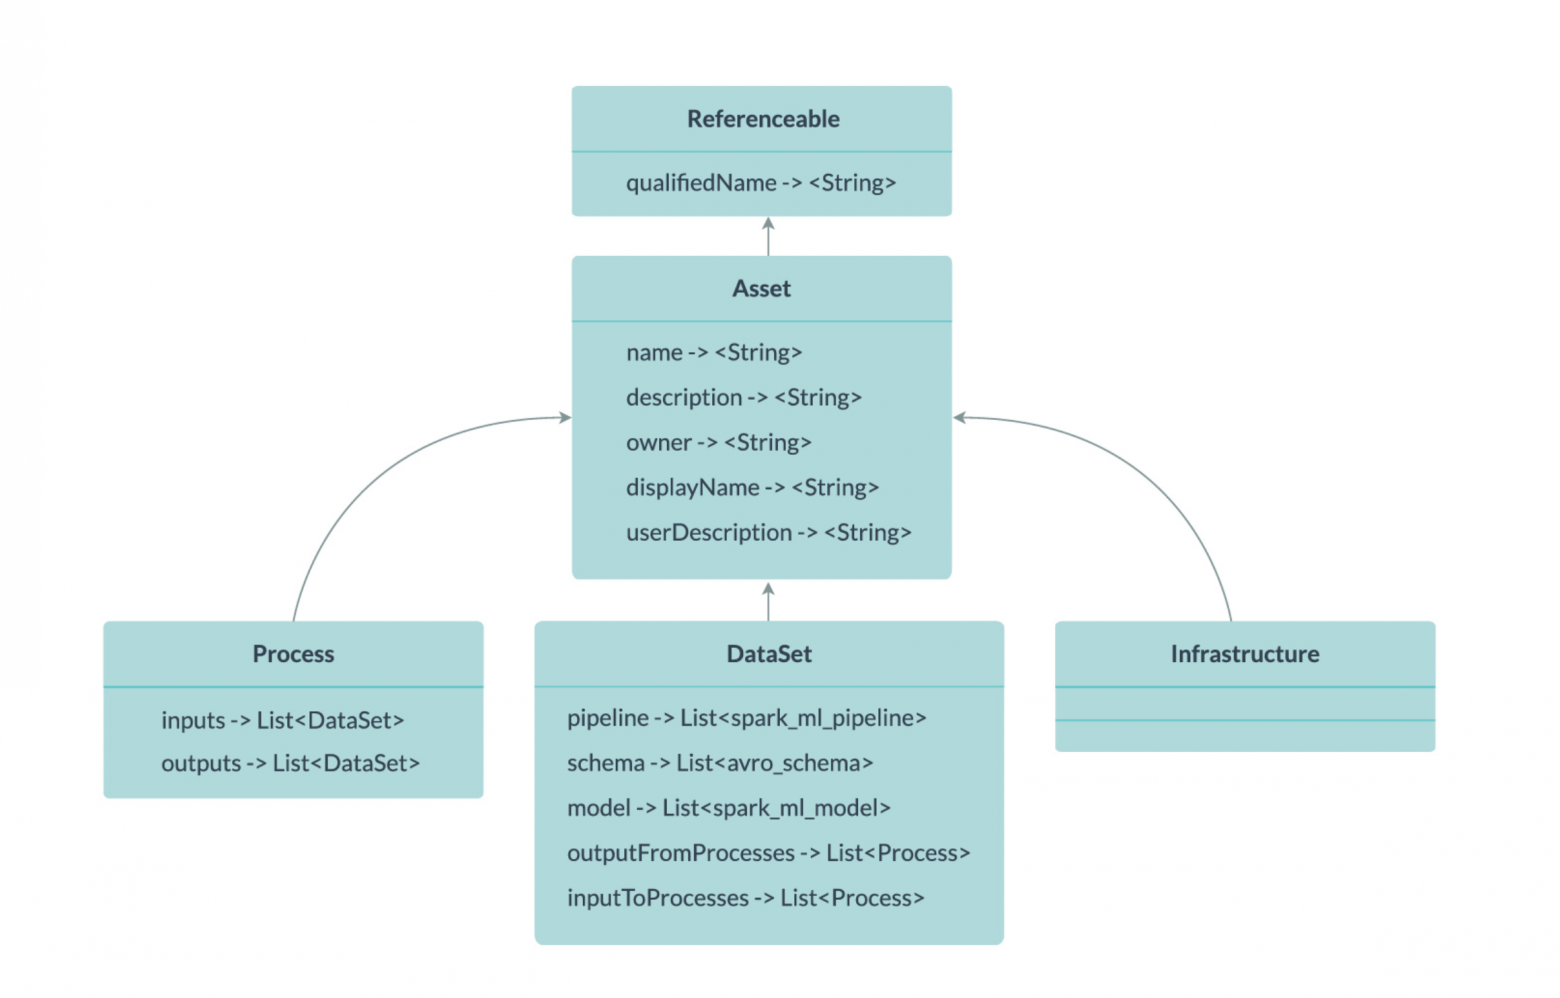
Архитектурное видение: интеграция Spark, AST и Apache Atlas
Архитектурное видение предполагает тройной контур взаимодействия, где каждый компонент сохраняет свою роль, но функционирует в едином сценарии:
- Apache Spark выступает как движок обработки данных, формирующий логические планы трансформаций;
- AST выступает как нейтральное представление плана, пригодное для анализа, трансформации и сопоставления с метаданными Atlas;
- Apache Atlas выполняет роль хранилища линейности данных, типов и связей между данными и процессами, обеспечивая управление доступом, версионирование и аудит.
Основной поток работает следующим образом:
- Spark генерирует логический план обработки, включающий узлы Project, Filter, Union, LocalRelation и LogicalRelation;
- этот план преобразуется в дерево AST, которое структурирует план по узлам, уровням и зависимостям;
- AST служит входом для формирования Atlas-совместимых сущностей: DataSet и Process, связанных через поля inputs и outputs;
- через REST API Atlas выполняется загрузка определений типов и самих сущностей, формирующих линейность между входами, процессами и выходами;
- система позволяет визуализировать и аудировать линейность, а также расширять модель метаданных для поддержки новых узлов и сценариев.
В образной трактовке архитектура напоминает конвергенцию трех входов в единый конструкт технологического контура, где каждый компонент сохраняет автономность, но микроархитектура выстроена через единое API-слово и единые метаданные. В реальном внедрении этот контур требует дисциплины в управлении версиями типов, границами зон ответственности между командами и соглашениями по именованию квалифицированных имен (qualifiedName) в Atlas. В рамках прототипа внимание сосредоточено на демонстрации возможности переноса значимой семантики логического плана Spark в Atlas и на выявлении узких мест, которые требуют доработки в части производительности и устойчивости к изменениям версий компонентов.
Декомпозиция технических компонентов и их взаимодействия
Разложим архитектуру на пять ключевых компонентов и интерфейсов:
- модуль Spark-планирования: отвечает за получение и представление логического плана, который далее подлежит интерпретации в AST;
- конвертер AST: преобразует план Spark в абстрактную грамматику дерева, сохраняя структурные связи и типы узлов;
- модель Atlas: набор кастомных типов и сущностей, ориентированных на представление DataSet и Process, с поддержкой линейности;
- слой трансформации and загрузки: формирует Atlas-совместимый JSON и отправляет его через REST API Atlas;
- управляющий слой и оркестрация: координирует последовательности вызовов, обеспечивает корректную загрузку типов перед созданием сущностей, поддерживает базовые сущности Input/Output и базовую линейность.
Эти компоненты должны работать в синергии, причем важным моментом является архитектурная дисциплина: типы Atlas должны создаваться до сущностей, чтобы ссылки и связи могли корректно формироваться, а имена и атрибуты должны быть согласованы между слоями. Кроме того, необходимо аккуратно проектировать JSON-форматы, чтобы Atlas воспринял их без ошибок 404 или аналогичных проблем, связанных с порядком загрузки типов.
Моделирование логического плана Spark: от плана к AST
Преобразование логического плана Spark в AST — это основа для дальнейшей интеграции с Atlas. Логический план Spark представляет собой дерево операций, где каждый узел несет ответственность за операцию над данными: выборку столбцов (Project), фильтрацию (Filter), объединение источников (Union) и связывание с конкретной схемой (LocalRelation, LogicalRelation). Основная идея заключается в том, чтобы выделить тип узла, извлечь релевантные характеристики и сохранить их в виде узлов AST с сохранением иерархической структуры.
Процесс функционирует следующим образом:
- сбор исходного плана через API Spark-клиента, включая список столбцов и условия;
- инкапсуляция этого плана в набор соответствующих узлов AST с указанием типа (Project, Filter, Union и т. д.), а также параметров, таких как список колонок, условие фильтрации и флаг наличия всех записей;
- создание экземпляра AST с указанием уровня и ветвления (level_num и levelExpr), что обеспечивает идентификацию местоположения каждого узла в пределах общего дерева.
Преимущество такого подхода в том, что AST становится независимым от конкретной реализации Spark и может быть адаптирован под различные планы обработки, присутствующие в данных средах. Это обеспечивает устойчивость к изменениям в версиях Spark и позволяет переиспользовать логику преобразования при внедрении аналогичных механизмов для других движков обработки данных.
Структура AST: узлы Project, Filter, Union, LocalRelation и LogicalRelation
AST в рамках прототипа моделирует следующие узлы, каждый из которых несет смысловую нагрузку при реконструкции плана обработки:
- ProjectNode: представляет операцию проекции, содержит список колонок, которые формируют итоговый набор столбцов;
- FilterNode: содержит условие фильтрации, выражение, которое применяется к данным на данном уровне;
- UnionNode: указывают, следует ли объединять все записи и по какому признаку, что отражает операцию объединения источников;
- LogicalRelationNode: отражает линейку столбцов в отношениях, участвующих в логическом плане;
- LocalRelationNode: аналогично LocalRelation в Spark, представляет локальное отношение с набором столбцов, поступающих из источника данных;
- Optional: NodeType, который может включать и другие узлы по мере расширения схемы (например, Join, Aggregate и т. п.).
Каждый узел имеет структуру, позволяющую хранить:
- имя типа узла (Project, Filter, Union, LocalRelation, LogicalRelation);
- параметры узла (например, список колонок, условие, флаг объединения);
- ссылку на дочерние узлы, что обеспечивает полную реконструкцию дерева;
- уровень в дереве и выражение уровня для идентификации в Atlas.
Такая структура обеспечивает единообразие в представлении логики обработки и служит удобной базой для последующих шагов трансформации в Atlas. Важно отметить, что узлы Atlas напрямую зависят от типов DataSet и Process, но через кастомные сущности pico_spark_data_type и pico_spark_process_type мы передаем смысл операций и их связь с данными.
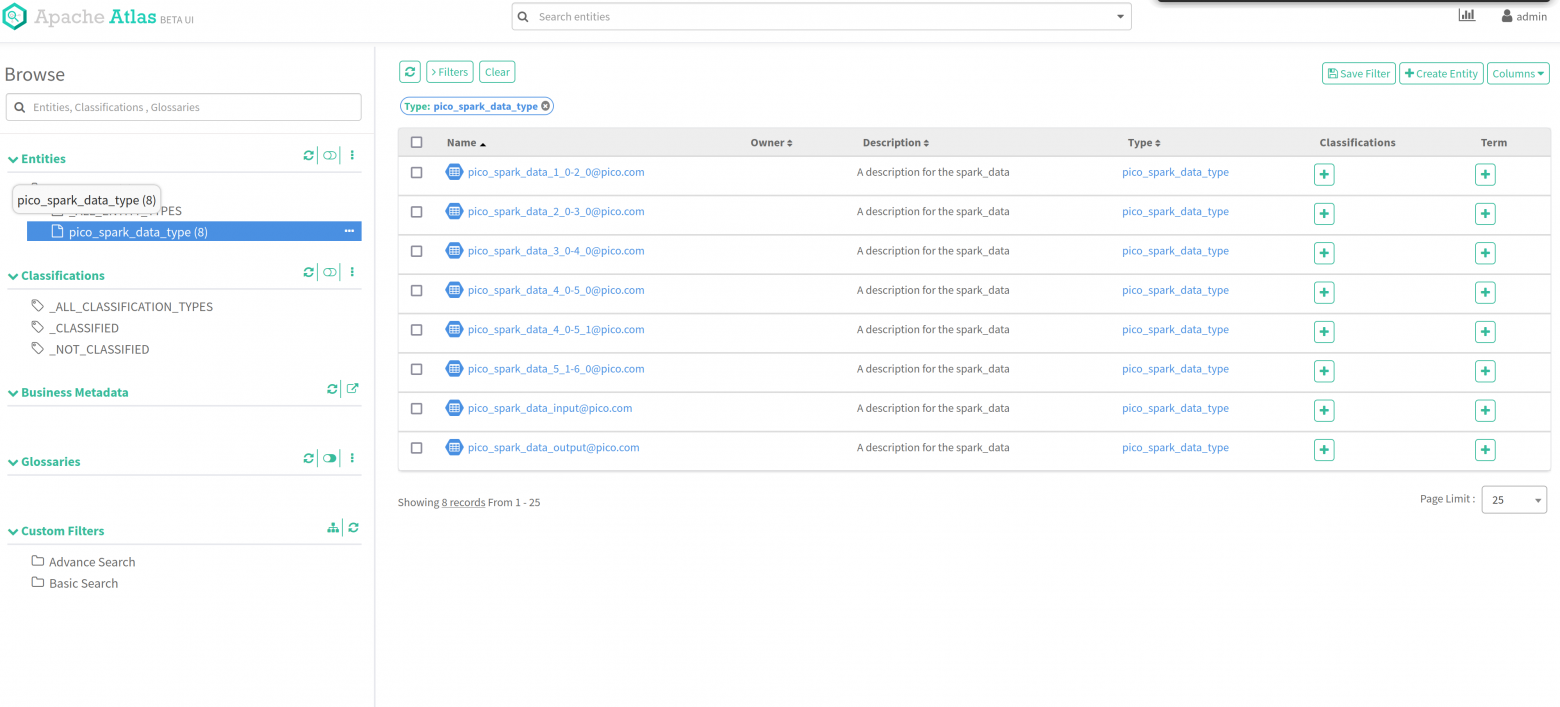
Преобразование AST в Atlas-совместимый формат
Преобразование AST в Atlas-совместимый формат — это процесс, который превращает структурированное древо в JSON-описания сущностей и их связей, пригодные для загрузки в Atlas. В рамках прототипа предполагается наличие двух базовых сущностей:
- pico_spark_data_type: кастомный тип, наследующийся от DataSet, используемый для описания входных и выходных наборов данных процесса;
- pico_spark_process_type: кастомный тип, наследующийся от Process, используемый для описания процесса обработки и связи между его входами и выходами.
Трансформация AST в Atlas-формат выполняется через следующий набор действий:
- для каждого узла AST формируется сущность типа pico_spark_process_type, которая включает уникальные атрибуты типа и связи с данными;
- для каждого дочернего узла формируются сущности pico_spark_data_type, которые представляют входные данные и выходы, связанные с конкретной операцией;
- создаются связи между процессами и данными через поля inputs и outputs, реализующие принцип линейности;
- формируются базовые сущности DataSet для входов и выходов, чтобы обеспечить существование необходимых точек привязки к процессам;
- устанавливаются уникальные квалифицированные имена (qualifiedName) на основе домена и уровней AST, что обеспечивает уникальность и воспроизводимость в Atlas.
Ключевой аспект — последовательность загрузки: сначала должны быть зарегистрированы типы (pico_spark_data_type, pico_spark_process_type), затем загружаются сами сущности. Это обеспечивает корректные ссылки и предотвращает ошибки при обращении к несуществующим типам в Atlas. Применение такого подхода требует дисциплины в управлении версионированием типов и синхронизацией между пайплайнами данных и тестовым окружением Atlas.
Для иллюстративного примера можно привести упрощенную схему JSON-запроса типа, создающего новый тип в Atlas:
{
  "entityDefs": [
    {
      "name": "pico_spark_data_type",
      "description": "A type inheriting from assets for Pico DataSet",
      "superTypes": ["DataSet"],
      "attributeDefs": [],
      "relationshipDefs": []
    }
  ],
  "enumDefs": [],
  "structDefs": [],
  "classificationDefs": [],
  "relationshipDefs": [],
  "businessMetadataDefs": []
}

А для типа pico_spark_process_type:
{
  "entityDefs": [
    {
      "name": "pico_spark_process_type",
      "description": "A type inheriting from assets for Pico Spark abstraction",
      "superTypes": ["Process"],
      "attributeDefs": [
        { "name": "inputs", "typeName": "array", "isOptional": true },
        { "name": "outputs", "typeName": "array", "isOptional": true }
      ],
      "relationshipDefs": []
    }
  ],
  "enumDefs": [],
  "structDefs": [],
  "classificationDefs": [],
  "relationshipDefs": [],
  "businessMetadataDefs": []
}
Такие определения обеспечивают необходимый каркас для загрузки в Atlas и позволяют хранить информацию об операциях в виде взаимосвязанных сущностей. В реальном прототипе помимо самих сущностей мы предусматриваем возможность расширения набора узлов AST и сопутствующих им типов, что обеспечивает гибкость и адаптивность к эволюционному развитию планов Spark.
Определение типов в Apache Atlas: pico_spark_data_type и pico_spark_process_type
Идея введения двух базовых типов в Atlas состоит в создании одного типа данных, который эволюционным образом расширяет DataSet, и одного типа процессов, который наследуется от Process. Это позволяет выстроить иерархическую модель линейности, где каждое преобразование в Spark становится процессом, а данные, с которыми он оперирует, — набором данных. В контексте Atlas эти сущности образуют две фундаментальные категории:
- pico_spark_data_type — элемент линейности, который описывает входные и выходные данные процесса и может быть переиспользован для разных уровней AST;
- pico_spark_process_type — сущность процесса, описывающая операцию над данными, включая ссылки на inputs и outputs и параметры, релевантные конкретной операции (например, фильтрация, проекция, объединение и т. д.).
Определение атрибутов для pico_spark_process_type (inputs, outputs) позволяет напрямую моделировать линейность в Atlas. В процессе разработки стоит учитывать, что атрибуты могут быть пустыми на ранних этапах, однако по мере стабилизации контура обработки и расширения модели рекомендуется заранее объявлять ожидаемые структуры входов и выходов. Это позволит заранее валидировать схемы и исключить несогласованности между планом Spark и его отражением в Atlas.
Необходимо помнить, что Atlas работает с наследованием и ссылками на другие сущности, поэтому для простого функционала без сложных отношений можно сохранять inputs/outputs как массивы ссылок на другие pico_spark_data_type. В дальнейшем можно рассмотреть введение дополнительных сущностей для представления конкретных уровней в AST (например, pico_spark_node_type) или дополнительных связей (relationshipDefs) между узлами AST и их семантикой в Atlas.
Модели данных Atlas: inputs, outputs и связь с DataSet
В Atlas модель линейности формируется посредством объектов DataSet и Process, где каждый Process имеет поля inputs и outputs — массивы DataSet. Эта структура объясняет, почему в Atlas приходится обрамлять пользовательские сущности DataSet в рамках Process. В начальном варианте прототипа DataSet сущности существуют в системе и могут служить опорой для отображения схем данных, с которыми процесс начинает работу и которые он возвращает. Однако на этапе прототипирования мы можем оставить поля схем пустыми, чтобы не усложнять демонстрацию и сохранить гибкость для будущих расширений.
Основной сценарий размещения данных в Atlas состоит в следующих принципах:
- DataSet представляет конкретный набор данных с ассоциированной схемой, квалифицированным именем и ссылками на метрики качества, происхождения и конфигурации хранилища;
- Process описывает шаг обработки, включая ссылки на входы и выходы через поля inputs и outputs;
- Связи между Process и DataSet отражают линейность: какие наборы данных входят в процесс и какие выходы образуют последующие шаги вычислительного конвейера.
Для совместимости с Atlas в рамках прототипа следует соблюдать принципы единообразного именования, использования доменной квалификации (domain) и уникальности qualifiedName, что обеспечивает корректное ориентирование в большом объеме объектов и предотвращает конфликты версий.
Таблично это можно представить как сопоставление:
- Pico Spark DataSet <-> DataSet Atlas;
- Pico Spark Process <-> Process Atlas, с inputs/outputs как связи на DataSet;
- AST-узлы <-> логические конфигурации процессов, отражаемые через набор процессов и взаимосвязанных DataSet.
Эта модель обеспечивает прозрачность и расширяемость, поскольку Atlas поддерживает разнообразие типов и может быть расширен для включения дополнительных атрибутов, а также новых узлов AST по мере развития проекта.
Реализация прототипа: тестовый набор и примеры кода
Разработка прототипа опирается на демонстрационный набор данных cars.csv, который иллюстрирует базовую цепочку обработки Spark: считывание таблицы, формирование набора данных, объединение данных и фильтрацию по признак производителя. Этот набор призван показать, как логический план Spark конвертируется в AST и затем отображается в Atlas. В процессе реализации используются стандартные подходы к чтению CSV, созданию датафреймов и применению трансформаций. В качестве исходной иллюстрации можно привести следующую последовательность действий: чтение файла cars.csv:
  model,manufacturer
  Model S,Tesla
  Model 3,Tesla
  Mustang,Ford
  Civic,Honda
формирование набора данных из списка и последующее объединение:
unioncars = carsCSV.union(carsSeq)
применение фильтрации и добавление временной метадной колонки:
resDF = unioncars.where(manufacturer != "Audi").select("model","manufacturer").withColumn("processedDDTM", current_timestamp())
получение логического плана и его отображение:
println(resDF.queryExecution.logical)
Далее план переходит к этапу транформации в AST через концептуальный класс AST и соответствующие узлы (Project, Filter, Union, LocalRelation, LogicalRelation). Логика преобразования предусматривает обход дерева планирования, конвертацию каждого узла в соответствующий узел AST и рекурсивное построение деревьев. В дальнейшем AST можно использовать как источник для формирования Atlas-сущностей.
Для взаимодействия Atlas с прототипом использованы JSON-описания типов и сущностей, а также REST API запросы. Пример типовых запросов может выглядеть следующим образом:
- создание типа pico_spark_data_type (DataSet-подкласс);
- создание типа pico_spark_process_type (Process-подкласс) с атрибутами inputs и outputs;
- загрузка сущностей DataSet и Process через эндпоинт /entity;
- использование полей inputs/outputs для формирования линейности.
Рассматривая практическую реализацию, следует подчеркнуть, что данные запросы требуют последовательности создания типов и затем сущностей. В реальном проекте, помимо продуманной схемы, необходимо обеспечить обработку ошибок сервера Atlas, управление правами доступа, а также мониторинг статусов загрузки и журналирование операций.
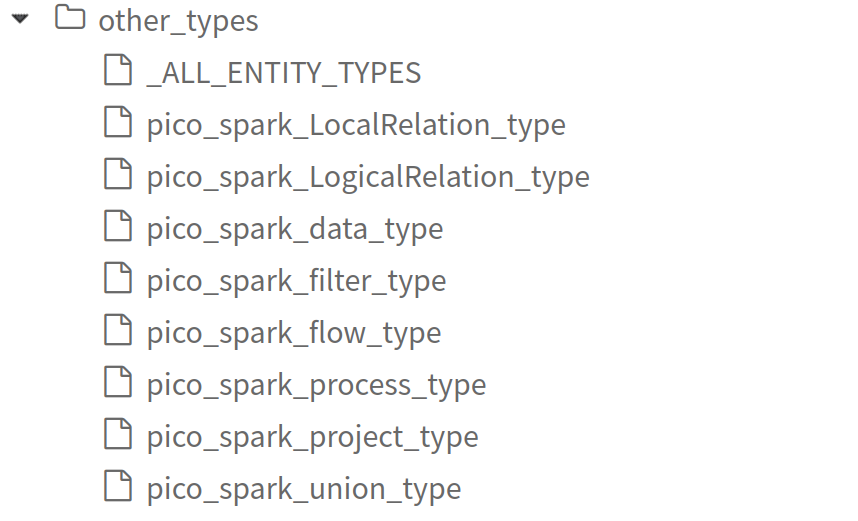
Генерация сущностей и линейности: процессы и данные в Atlas
Генерация сущностей в Atlas представляет собой последовательность шагов:
- определение домена (domain) — это качественный контекст, в рамках которого формируются квалифицированные имена и ссылки на сущности;
- последовательное создание сущностей DataSet и Process, где каждый Process имеет привязанные inputs и outputs, что образует цепочку линейности;
- использование AST для формирования JSON-описаний, соответствующих структурам Atlas;
- вызов REST API Atlas для загрузки созданных сущностей и сохранения линейности между ними.
Особое внимание уделяется тому, чтобы входные и выходные DataSet были корректно зарегистрированы до попытки привязать их к Process. Это обеспечивает устойчивость инфраструктуры к ошибкам загрузки и позволяет Atlas корректно построить граф линейности.
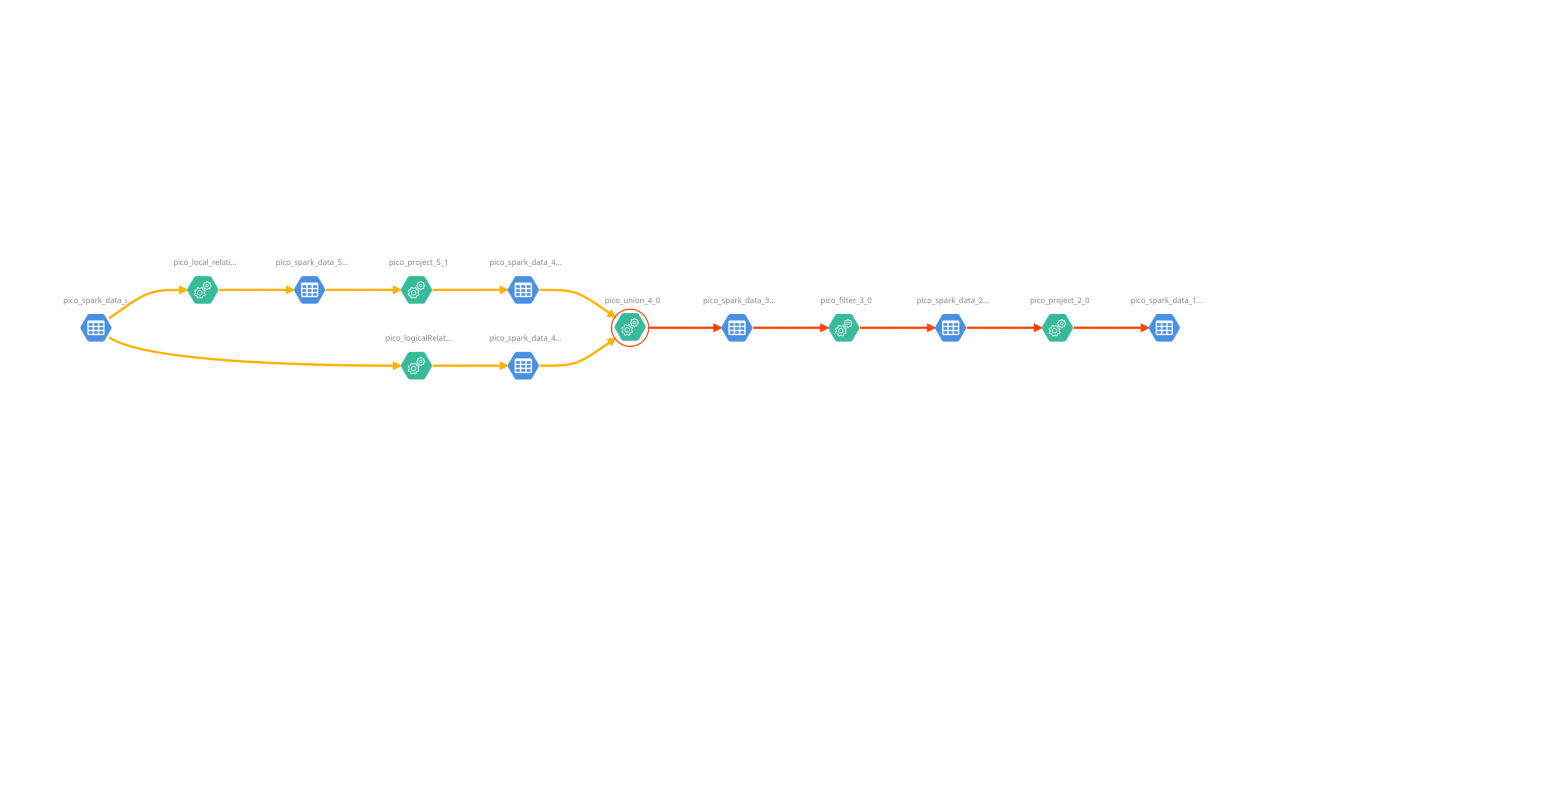
В рамках прототипа демонстрируется, что после загрузки типов и сущностей, Atlas способен отражать линейность, например в виде:
Project [model#17, manufacturer#18, 2024-09-12 16:57:34.046609 AS processedDDTM#36] +- Project [model#17, manufacturer#18] +- Filter NOT (manufacturer#18 = Audi) +- Union false, false :- Relation [model#17,manufacturer#18] csv +- Project [_1#23 AS model#28, _2#24 AS manufacturer#29] +- LocalRelation [_1#23, _2#24]
Такое представление демонстрирует, что линейность между источниками и итогами обработки корректно отражена в Atlas благодаря связям между DataSet и Process и тому, что узлы AST соответствуют операторам в Spark.
REST API и последовательности операций по загрузке типов и сущностей
Работа с Atlas базируется на REST API, которое позволяет управлять типами, сущностями и связями. В рамках протокола загрузки типов требуется последовательность:
- создание typedefs (типов) через endpoint /types/typedefs;
- ожидание успешной регистрации новых типов и отметка о готовности к загрузке сущностей;
- загрузка сущностей через endpoint /entity, обеспечивая соответствие структуры и атрибутов требуемым типам.
Пример последовательности операций в концептуальной форме:
- отправка JSON-описания для типа pico_spark_data_type;
- отправка JSON-описания для типа pico_spark_process_type с атрибутами inputs и outputs;
- загрузка сущностей DataSet и Process через endpoint entity, формируя квалифицированные имена на основе домена и уровней AST;
- после загрузки сущностей в Atlas выполняется построение линейности через связи inputs/outputs между Process и DataSet.
Чтобы обеспечить повторяемость, в реальном проекте рекомендуется автоматизировать этот процесс через скрипты или небольшие сервисы, которые:
- читают конфигурационные файлы EntityTypes.json (список определений типов);
- выполняют POST-запросы на atlasServerUrl/types/typedefs и обрабатывают ответы;
- формируют и отправляют сущности по мере готовности соответствующих типов;
- регистрируют лог ошибок и статусы выполнения.
Важно помнить, что Atlas использует строгую схему версионирования и зависимости между типами, поэтому корректная последовательность загрузки играет критическую роль в успехе интеграции.
Практический кейс: демонстрационная задача с файловым набором cars.csv
Пилотная демонстрация опирается на тестовый набор cars.csv, который иллюстрирует базовую цепочку преобразований и последующее отражение линейности в Atlas. В рамках кейса:
- файл cars.csv содержит столбцы model и manufacturer;
- Spark код строит DataFrame из CSV, объединяет его с дополнительной последовательностью записей, затем фильтрует по производителю и добавляет временную метку обработки;
- логический план операции выводится в виде дерева, которое затем преобразуется в AST;
- AST служит входом для генерации Atlas-совместимой структуры и загрузки в Atlas;
- через REST API Atlas загружаются типы pico_spark_data_type и pico_spark_process_type и сущности DataSet и Process, формируя линейность для проекта.
Этот кейс демонстрирует не только концептуальную состоятельность подхода, но и практическую реализуемую схему: от входных данных до линейности процесса, учитывая текущие ограничения и необходимость дальнейшей эволюции архитектуры. В рамках кейса также подчеркиваются аспекты мониторинга, аудита и поддержания консистентности между планируемыми операциями и их отражением в метаданной системе Atlas.
Ограничения и критические моменты прототипа: риски, костыли и технические ограничения
Несмотря на демонстративную ценность прототипа, важно обратить внимание на ряд ограничений и рисков, которые влияют на переход от пилота к промышленной реализации:
- текущая архитектура упирается в необходимость эволюции набора типов в Atlas и в возможность расширения функциональности AST;
- линейность на ранних стадиях строится через простейший набор сущностей DataSet и Process, что ограничивает полноту отображения сложной архитектуры с большим количеством взаимосвязей;
- вопросы производительности: обработка больших планов Spark и большого числа сущностей Atlas может требовать оптимизаций по памяти, параллелизму и кэшированию;
- управление версиями: изменение планов Spark и изменений в Atlas требуют согласованных версий типов и атрибутов, чтобы не нарушать существующую линейность;
- безопасность и доступ: работа через REST API Atlas требует настройки аутентификации и контроля доступа, особенно в корпоративной среде;
- необходимость дальнейшей разработки: создание специализированных библиотек и более чистая архитектура, модульность ввода-вывода, расширяемые конвертеры для узлов AST и поддержка новых операций.
Указанные ограничения подчеркивают необходимость дальнейших исследований и разработки в нескольких направлениях: расширение набора узлов AST (Join, Aggregate и др.), внедрение более зрелой модели схем DataSet, улучшение согласованности между планами Spark и моделями Atlas, а также создание инструментов для тестирования и автоматизации загрузки.
Кейсы применения в реальных сценариях и индустриальных контекстах
Реализация интеграции Spark, AST и Atlas имеет широкий диапазон применения в корпоративной среде:
- управление линейностью для дата-фабрик, где множество источников данных и трансформаций требуют явной трассируемости;
- регуляторные требования к аудиту данных (например, финансовый сектор, телеком и здравоохранение), где нужно доказать происхождение и путь данных;
- миграционные проекты, где необходимо сопоставлять данные между различными стеками технологий и сохранять их путь в Atlas;
- обеспечение прозрачности для аналитиков и инженеров данных, позволяя им визуализировать поток данных и зависимости между процессами.
В индустриальных контекстах интеграция Atlas с Spark через AST обеспечивает не только контроль над линейностью, но и поддержку при автоматическом документировании процессов, генерировании отчетов и аудите изменений. В качестве будущих направлений отмечаются расширение спектра поддерживаемых узлов AST, развитие практик версионирования моделей данных и планов обработки, а также внедрение дополнительных устойчивых механизмов репозитория метаданных и мониторинга.
Интеграция стеков и синергия: NiFi, Spark и Atlas в архитектурном контуре
Эффективная архитектура линейности данных складывается не только из связки Spark, AST и Atlas, но и из умелой синергии с сопутствующими компонентами инфраструктуры. В индустриальной практике возможно сочетать:
- Apache NiFi как инструмент для потоковой интеграции, сборки данных, маршрутизации и схлопывания источников в единый конвейер;
- Spark для высокопроизводительной обработки больших данных;
- Atlas для управления метаданными, управления линейностью и аудита.
NiFi может служить входной точкой для потоков данных, инициируя Spark-обработку, а Atlas обеспечивает хранение и отображение линейности и метаданных. Эта интеграция позволяет выстраивать полноценные конвейеры, где входные данные регистрируются в Atlas, а последующие трансформации в Spark отражаются как процессы, что в итоге обеспечивает прозрачность и управляемость критических потоков данных.
Аналитика рисков, метрик эффективности и мониторинга линейности
Успешная реализация требует внедрения системного набора метрик и мониторинга. В числе ключевых метрик:
- полнота линейности: доля компонентов конвейера, для которых действуют явные входы и выходы;
- точность отражения планов Spark в Atlas: соответствие между узлами AST и сущностями Atlas;
- время задержки от изменения в Spark до отражения в Atlas;
- корректность схемы DataSet: доля DataSet с заполненными схемами;
- устойчивость к версиям: способность адаптироваться к обновлениям компонентов без потери линейности.
Периодическая валидация метаданных, аудит изменений и мониторинг системы через метрики позволят оперативно выявлять расхождения и обеспечивать надлежащее функционирование контура.
Конкурентный анализ и дифференциация существующих решений
Существующие подходы к управлению линейностью часто используют внешние инструменты для аудита и управления метаданными, но редко связывают Spark, AST и Atlas в единый контура. Отличие предлагаемой архитектуры:
- формальное использование AST как переходной стадии между планом Spark и метаданными Atlas;
- внедрение кастомных типов Atlas (pico_spark_data_type, pico_spark_process_type) специально под задачи линейности;
- упор на непрерывную адаптацию и расширение моделей типов и узлов AST для поддержки более сложных сценариев;
- возможность интеграции с NiFi для построения целостных конвейеров данных.
Эти элементы обеспечивают уникальное сочетание вычислительных и метаданных аспектов в рамках единой архитектуры линейности данных.
Дорожная карта и требования к будущим библиотекам и архитектуре
Дальнейшее развитие требует следующих направлений:
- расширение набора узлов AST: добавление узлов Join, Aggregate, Sort и др. с корректной поддержкой значений и атрибутов;
- углубление модели DataSet: поддержка схем, форматов хранения, версий и качественных характеристик данных;
- развитие расширяемости типов Atlas: добавление новых атрибутов и независимых сущностей для более глубокой семантики;
- оптимизация производительности: параллельные загрузки, кэширование и параллельная обработка планов;
- повышение устойчивости к регуляторным требованиям: аудит, мониторинг, версия контроля и организация политик доступа;
- интеграция с другими инструментами: расширенная интеграция с NiFi, Airflow, DL/ML-пайплайнами.
Эти направления формируют дорожную карту для перехода от прототипа к промышленному решению, подходящему для реализации в рамках реальных проектов.
Выводы и направления дальнейших исследований
Интеграция Apache Spark, AST и Apache Atlas в архитектуру линейности данных представляет собой концепцию, которая сочетает вычислительную динамику Spark с формализованной семантикой и управлением метаданными Atlas. Прототип демонстрирует жизнеспособность подхода: логический план Spark может быть преобразован в AST, а затем отражен в Atlas через кастомные типы pico_spark_data_type и pico_spark_process_type, образуя линейность между входами и выходами. Такой контур позволяет организовать прозрачное отслеживание происхождения данных, обеспечение аудита и документирования сложных вычислительных пайплайнов.
Дальнейшие исследования следует направлять на расширение функциональности AST и типов Atlas, углубление поддержки процессов и данных, автоматизацию процессов загрузки, а также комплексное тестирование в условиях реального производства. Важной составляющей станет развитие методик мониторинга и управления качеством данных в контексте линейности, обеспечение совместимости с регуляторическими требованиями и создание устойчивого стандарта обмена метаданными между системами.
Поступательное развитие архитектуры, гибкость адаптации к отраслевым требованиям и системная интеграция со стеком данных приведут к созданию полноценных архитектурных контура, которые не только позволяют отслеживать путь данных, но и поддерживать эффективную эволюцию вычислительных конвейеров в условиях цифровой трансформации предприятий.
Вопрос-Ответ:
1. Вопрос: Какова основная роль AST в интеграции Spark и Atlas?
Ответ: AST служит переходной абстракцией между логическим планом Spark и сущностями Atlas, позволяет стандартизировать структуру плана, поддерживать расширяемость и удобство преобразований в Atlas.
2. Вопрос: Какие типыAtlas используются в прототипе?
Ответ: Основные типы — pico_spark_data_type (наследуется от DataSet) и pico_spark_process_type (наследуется от Process), обеспечивающие представление данных и процессов, а также их взаимосвязи через inputs и outputs.
3. Вопрос: Как обеспечивается последовательность загрузки типов и сущностей в Atlas?
Ответ: Сначала создаются типы (typedefs) pico_spark_data_type и pico_spark_process_type, затем загружаются сущности DataSet и Process с заполненными inputs/outputs, чтобы ссылки могли корректно формироваться.
4. Вопрос: Какой кейс иллюстрирует подход?
Ответ: Демонстрационный кейс с набором cars.csv демонстрирует преобразование логического плана Spark в AST и последующую загрузку линейности в Atlas, демонстрируя от входов к выходам через процессы.
5. Вопрос: Какие риски сопровождают прототип?
Ответ: Ограниченность типа линейности, необходимость расширения набора узлов AST, производительность и масштабируемость, вопросы управления версиями типов Atlas и безопасность доступа через REST API.
6. Вопрос: Какие шаги необходимы для перехода к промышленной реализации?
Ответ: Расширение набора узлов, разработка библиотек для автоматизации загрузки типов и сущностей, улучшение обработки ошибок, создание тестовых сценариев, настройка мониторинга и интеграция с внешними конвейерами (NiFi, Airflow).
7. Вопрос: Какой будет следующий шаг в развитии архитектуры?
Ответ: Расширение модели узлов AST и типов Atlas, добавление механизмов верификации линейности, внедрение практик мониторинга и аудита, а также создание модульной инфраструктуры для повторного использования в различных доменах и отраслях.
8. Вопрос: Какой вклад данное исследование в область управления данными?
Ответ: Предложенный подход предоставляет архитектурную дорожную карту для интеграции вычислительных конвейеров Spark с управлением метаданными Atlas через AST, что позволяет формализовать линейность, улучшить прозрачность и повысить управляемость в рамках цифровой трансформации.
9. Вопрос: Какие условия необходимы для успешной эксплуатации в реальной среде?
Ответ: Наличие дисциплины по управлению версиями типов Atlas, автоматизация процессов загрузки, устойчивые механизмы аутентификации и мониторинга, а также тестовые окружения с воспроизводимыми наборами данных и планами обработки.


