

Интеграция источников данных в каталог
Интеграция источников данных в каталог представляет собой один из ключевых этапов внедрения системы каталогизации данных в компании. Задача состоит не просто в сборе метаданных, но и в создании устойчивого, безопасного и полезного слоя знаний, который соединяет физические источники данных, их схемы, процессы обработки и бизнес-потребности сотрудников. В этом разделе мы рассмотрим теоретические основы интеграции источников данных в каталог, обсудим термины и методологии, дадим примеры практического внедрения на базе доступных инструментов, рассмотрим технические детали, риски и ограничения, а затем подведем итоги и предложим вопросы-ответы, которые помогут закрепить материал.
Что такое источники данных и почему они должны попадать в каталог
Источники данных — это любые хранилища и системы, из которых можно извлекать данные для анализа и отчетности: реляционные базы данных, хранилища данных (data warehouses), озера данных (data lakes), файловые хранилища, API-слои, стриминговые платформы и т. д. Каталог данных агрегирует метаданные об этих источниках: техническую информацию (схемы, типы данных, версии), бизнес-онтологии (пользовательские определения данных, глоссарий), процессную информацию (потоки данных, lineage), а также политики доступа и качества данных.
Ключевые термины и концепции
- Источник данных: конкретная система или пространство, из которого извлекаются данные.
- Метаданные: данные о данных — структура, формат, владелец, дата создания, версия схемы, теги и т. д.
- Каталог данных: централизованный реестр метаданных, который обеспечивает поиск, контекст и управление данными в рамках организации.
- Интеграция метаданных: процесс извлечения и загрузки метаданных из источников в каталог.
- Ingestion (ингестион): перенос метаданных из источника в каталог. Может быть пакетным (batch) или потоковым (streaming).
- Коннектор: модуль, который знает, как подключиться к конкретному источнику и извлечь из него метаданные.
- lineage (происхождение данных): цепочка преобразований и перемещений данных от источника к конечному потребителю.
- Глоссарий: бизнес-терминология и определения, используемые в организации, связанные с данными.
- Метаданные технического уровня: схемы, типы данных, правила конвертации, индексы, зависимости.
- Метаданные бизнес-уровня: бизнес-термины, ответственность, владение, политика доступа для качественной интерпретации данных.
- Управление доступом и безопасность: роли, политики, аутентификация и авторизация пользователей каталога, соответствие требованиям регуляторов.
- Контекст и качество данных: дополнительные сведения, помогающие понять пригодность данных для задач (правильность, полнота, актуальность, соответствие нормам).
Методологии интеграции источников
- Подход push vs pull: в подходе push источники отправляют метаданные в каталог по расписанию или при изменении; в подходе pull каталог запрашивает данные через коннекторы. Часто используется гибридный режим.
- Централизованный репозиторий против федеративной модели: централизованный каталог хранит все метаданные в одной системе; федеративная модель может держать часть метаданных в локальных хранилищах источников, синхронизируя критичные данные в общий каталог.
- Безопасность и соответствие: изначальная настройка ролей и политик доступа, минимизация привилегий, аудит изменений, поддержка локализации данных в соответствии с требованиями РФ и международными регуляторами.
- Этапы внедрения: 1) анализ источников и требований, 2) выбор инструментов и архитектуры, 3) настройка коннекторов и схемы миграции метаданных, 4) настройка глоссария и политики доступа, 5) валидация данных и lineage, 6) мониторинг и эволюционная поддержка.
Технические детали интеграции Архитектура общего уровня
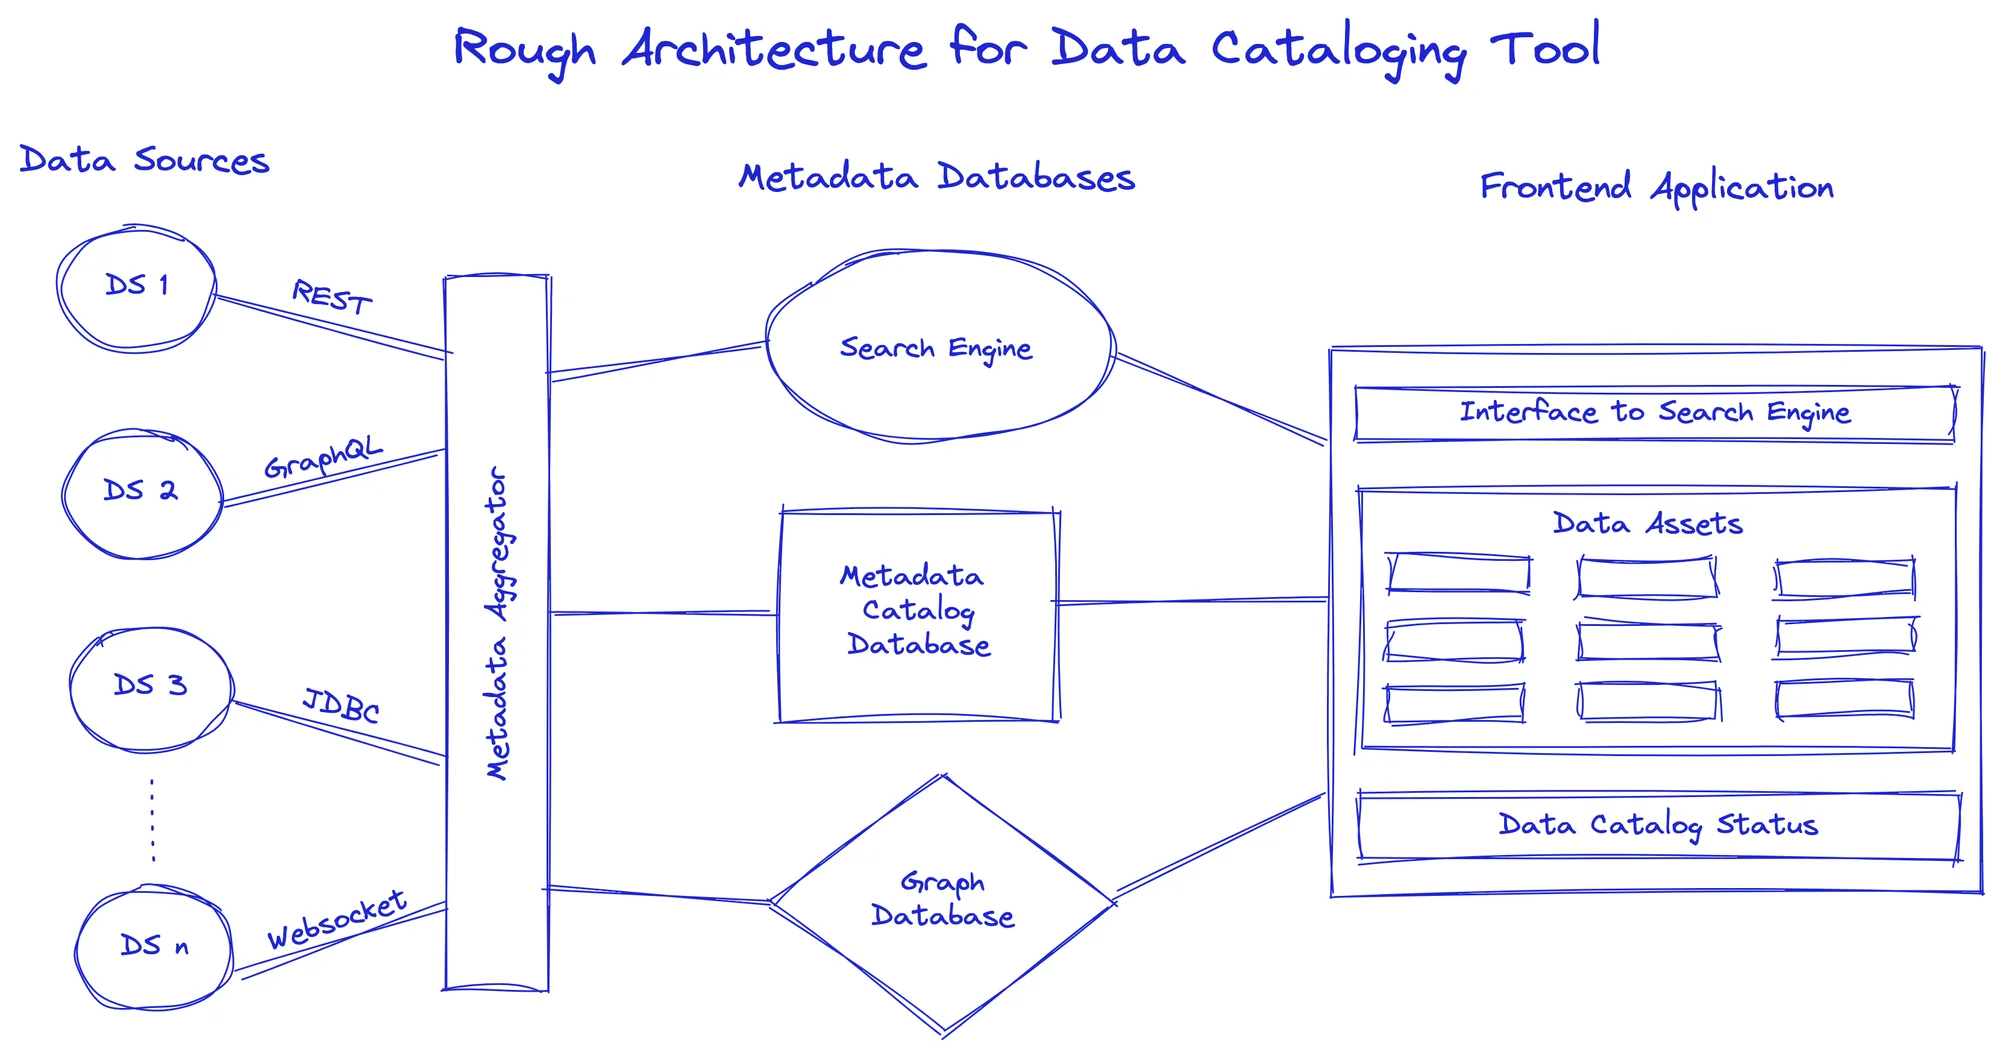
- Источники данных соединяются с каталогом через коннекторы. В зависимости от типа источника коннектор может быть разработан производителем продукта, сообществом open-source или корпоративной командой.
- Каталог хранит метаданные в слое репозитория. Часто это база данных (PostgreSQL, MySQL, CockroachDB и т. д.) плюс индекс поиска (Elasticsearch/OpenSearch) и индексируемые представления для быстрого поиска.
- Система аутентификации и авторизации обеспечивает доступ к данным каталога и, при необходимости, передачу разрешений в источники.
- Происхождение данных и lineage строятся через трекинг зависимостей между источниками и обработкой трансформаций, что помогает отвечать на вопросы “откуда взялись эти данные” и “как они изменились”.
Выбор и настройка коннекторов
- Реляционные базы данных (PostgreSQL, MySQL, Oracle, SQL Server): коннектор обычно извлекает схему таблиц, представления, процедуры и спецификации индексов. Часто поддерживает чтение метаданных из information_schema и системных таблиц.
- Хранилища данных и озера данных (Snowflake, BigQuery, Amazon Redshift, Hadoop/HDFS, S3): коннектор может использовать метаданные витрин, схемы, представления, материализованные представления и файлы схем. Для S3/HDFS важно учитывать форматы файлов (Parquet, ORC, Avro, JSON) и их схемы.
- Непрямые источники и API: коннектор обращается к API источника, извлекая схемы объектов, доступные конечные точки, схемы сообщений или событий.
- Стриминговые платформы (Kafka, Pulsar): lineage и метаданные о потоках, топиках, форматах сообщений, схемах Avro/JSON и схемах консьюсеров/потребителей.
- Файловые системы и данные в облаке: коннекторы для локальных файлов, файловых систем в облаке и архивов, учет версий и изменений.
Инструменты и примеры открытого кода
- Apache Atlas: открытая платформа для управления метаданными, фокусируется на метаданных технического уровня и lineage. Хорошо подходит для интеграции с Hadoop-экосистемой и Hive Metastore.
- Amundsen: фреймворк от Lyft, ориентирован на удобство поиска и контекст данных. Предлагает коннекторы к различным источникам метаданных и поддерживает расширяемый набор плагинов.
- OpenMetadata: современная платформа с модульной архитектурой, поддерживает множество источников и форматов и предлагает удобную модель сущностей, lineage и governance.
- DataHub: платформа, ориентированная на масштабируемость и способность работать с большими объёмами метаданных; хорошо интегрируется с экосистемами Apache и поддерживает lineage и качество данных.
- Пример конфигураций: на практике часто встречаются YAML-конфигурационные файлы для описания коннекторов, источников данных, расписаний и правил обработки метаданных. В реальных проектах можно увидеть схемы вида sources: name: db_postgres type: relationdb config: host:… port:… database:… credentials: use_secret_manager: true.
Российские решения и локализация
В отечественных проектах интеграция метаданных обычно строится на базе открытых платформ с локализацией и поддержкой российских регламентов. Часто применяются развертывания на корпоративной инфраструктуре заказчика: локализация данных, хранение журналов аудита, интеграция с системой единого входа (SSO через LDAP/AD или SAML), ограничение доступа по месту нахождения серверов и по регионам.
Поддержка локализации и соответствие требованиям регуляторов часто достигается через:
- использование локальных хранилищ и резервного копирования данных каталога внутри РФ;
- настройку политик соответствия и классификацию по уровням чувствительности;
- интеграцию с системами управления доступом в организации.
Практические подходы: развертывание OpenMetadata или Amundsen на российских серверах под управлением заказчика, адаптация коннекторов под локальные источники данных, настройка государственного контрольно-надзорного аудита и хранение журнала изменений на внутреннем носителе.
Примеры сценариев: интеграция с отечественными СУБД (PostgreSQL, MySQL, Oracle), локальными хранилищами, системами BI и отчетности, коннекторы к корпоративным API и сервисам. В рамках российского рынка часто используются решения системных интеграторов, которые на базе открытых платформ разрабатывают специфические модули под требования заказчика: консолидация разных источников, локализация интерфейса, адаптация к локальным стандартам кода и документации.
Практические примеры: пошаговые сценарии интеграции
Пример 1. Интеграция реляционной базы данных PostgreSQL в каталог
- Шаг 1: определить владельца данных, цель каталога, требования к доступу и категорию чувствительности.
- Шаг 2: выбрать коннектор для PostgreSQL (обычно стандартный коннектор поддерживается большинством платформ).
- Шаг 3: настроить аутентификацию и доступ к базе: использование защищенного канала, создание сервисного пользователя только с необходимыми правами.
- Шаг 4: собрать метаданные: схемы, таблицы, столбцы, типы данных, ограничения, зависимости.
- Шаг 5: настроить lineage: какие процессы ETL/ELT и какие сквозные схемы обработки данных в источнике связаны с таблицами.
- Шаг 6: определить политики тегирования и бизнес-блога: какие таблицы относятся к финансовым данным, какие к персональным данным.
- Шаг 7: запустить инкрементную загрузку и проверить консистентность метаданных в каталоге.
- Шаг 8: настройка мониторинга и оповещений о сбоях интеграции.
Пример 2. Интеграция облачного хранилища данных (S3) и форматов Parquet
- Шаг 1: определить источник и формат файлов, пути к данным и структура каталогов.
- Шаг 2: настроить коннектор к S3 и определить стратегию чтения схем (параметры чтения схемы, Inferring schema, использование встроенных форматов Parquet).
- Шаг 3: добавить бизнес-глоссарий и теги: чувствительность данных, принадлежность к проекту, аудит.
- Шаг 4: построить lineage от источника файлов к таблицам в каталоге (если данные позже загружаются в аналитическое хранилище).
- Шаг 5: Протестировать инкрементную загрузку метаданных при добавлении новых файлов.
Пример 3. Интеграция стримингового источника Kafka
- Шаг 1: определить топики и форматы сообщений, схемы данных (Avro/JSON).
- Шаг 2: настроить коннектор для чтения метаданных о топиках, схемах и потребителях.
- Шаг 3: связать lineage с потоками обработки и преобразованиями, которые происходят в потоковом анализе.
- Шаг 4: обеспечить мониторинг задержек и обновление схем по мере изменений.
Пример 4. Российские решения и локализация
- Развертывание OpenMetadata или Amundsen на территории заказчика под локальным управлением.
- Настройка аутентификации через локальный LDAP/AD или SSO SAML.
- Интеграция с отечественными системами аудита и мониторинга, хранение журналов в локальном хранилище.
- Применение локальных политик доступа и локализацию интерфейсов на русском языке.
- Включение классификации и глоссария на уровне организации, соответствующего требованиям регуляторов.
Технические детали реализации
- Безопасность и управление доступом: внедрить RBAC (роль-базированное управление доступом), использовать SSO и интеграцию LDAP/AD, настроить политики доступа по уровням сенситивности, журнал аудита действий пользователей и изменений метаданных.
- Учет версии схем и изменений: хранение версий схем, фиксация изменений в lineage, возможность отката к предыдущим версиям метаданных.
- Инкрементная синхронизация: поддержка изменений схем, добавления столбцов, изменений типов данных и новых объектов без повторной загрузки всего набора метаданных.
- Качество данных и контекст: хранение информации о качестве данных (правдивость, полнота, частота обновления) и контекст (описания, примеры данных, бизнес-правила).
- Метаданные по безопасности и приватности: маркировка персональных данных (PII) и чувствительных данных (как это определяется в политике организации), поддержка режимов доступа к данным.
- Технические требования к инфраструктуре: вычислительные ресурсы для каталога, требования к памяти и дисковому пространству для хранения метаданных и индексов, план обновления и резервирования, мониторинг и уведомления.
Риски и ограничения внедрения
- Сложность интеграции множества источников: разные форматы, версии схем, различная частота изменений требуют гибкой архитектуры коннекторов и обработки ошибок.
- Производительность и масштабирование: при большом количестве источников и обновлений нагрузка на каталог и индексы поиска может возрастать; необходимо предусмотреть горизонтальное масштабирование и кэширование.
- Контроль версий и миграции: возможность несогласованности между источниками и каталогом при одновременных изменениях, риск потери контекстной информации при слиянии данных.
- Безопасность и соответствие: плохая настройка ролей и политик может привести к несанкционированному доступу, нарушению конфиденциальности и регуляторных требований.
- Управление качеством: без полной картины качества данных трудно поддерживать доверие к каталогу; данные требуют регулярной валидации и обновления.
- Зависимость от поставщиков: риск зависимости от конкретного производителя или решений при обновлениях функционала, лицензионных ограничениях и сроках поддержки.
- Локализация и регулирование: требования по локализации данных, хранению журналов аудита и соблюдению законодательства могут усложнить архитектуру.
- Сложность эксплуатации и обучения персонала: необходимы обучающие программы для дата-стейкхолдеров, администраторов и пользователей; без этого каталог может быть непопулярен и неиспользуем.
Интеграция источников данных в каталог — это фундаментальная часть стратегии управления данными в компании. Правильно спроектированная и реализованная интеграция обеспечивает единое место для поиска, контекста и управления данными, усиливает доверие к данным, облегчает соблюдение нормативов и ускоряет работу аналитиков и бизнес-пользователей. Выбор инструментов (от открытых платформ до локализованных решений интегратора), аккуратная настройка коннекторов, продуманная архитектура lineage и глоссария, а также эффективное управление безопасностью и качеством данных — залог успешного внедрения. При этом важно предвидеть риски и ограничения, планировать этапы внедрения, а также постоянно обучать пользователей и поддерживать систему в актуальном состоянии.
Вопрос–Ответ (FAQ)
1. Что такое ingestion и чем он отличается от интеграции?
Ingestion — это процесс переноса и загрузки метаданных из источников в каталог. Он может быть пакетным (Batch) или потоковым (Streaming). Интеграция охватывает не только перенос, но и настройку коннекторов, сопоставление схем, управление lineage, согласование терминов и политики доступа. В целом ingestion — часть интеграции, сосредоточенная на переносе данных.
2. Какие типы источников обычно подключают к каталогу?
Обычно подключают реляционные СУБД (PostgreSQL, MySQL, Oracle, SQL Server), облачные хранилища и озера данных (S3, HDFS, Parquet/ORC), хранилища данных (Snowflake, BigQuery, Redshift), API-слои и стриминговые платформы (Kafka, Pulsar), а также файлы в файловых системах и каталоги метаданных из других подсистем.
3. Какие платформы открытого кода стоит рассмотреть и чем они полезны?
Apache Atlas: хорошо работает в экосистеме Hadoop, поддерживает lineage и сервисы управления метаданными. Amundsen и OpenMetadata предоставляют современные UX, гибкость плагинов и хорошую поддержку контекста данных. DataHub подходит для больших масштабов и сложной связности metadata. Выбор зависит от архитектуры вашего стекa и требований к UX, поддержке федеративных источников и кросс-платформенности.
4. Что важно учесть при локализации российского рынка?
Важно обеспечить локализацию интерфейсов и документации на русском языке, интеграцию с локальными системами аутентификации (LDAP/SSO, SAML), соответствие требованиям к хранению журналов аудита и регулятивным требованиям РФ, а также способность размещать данные и логи внутри российской инфраструктуры по требованиям локализации.
5. Какие риски чаще встречаются на этапе интеграции источников?
Риски включают сложность поддержки множества коннекторов и изменений схем, риск несогласованности между источниками и каталогом, проблемы с безопасностью и доступом, ухудшение производительности при большом объеме метаданных, а также трудности обучения сотрудников и нестабильность процессов обновления.
6. Как обеспечить качество данных в каталоге?
Включать глоссарий и бизнес-термины, задавать политики классификации и маркировки чувствительности, внедрять метрики качества метаданных (полнота, точность, актуальность), регулярно проводить аудиты и валидацию схем, а также поддерживать автоматическое обновление и версионирование метаданных.
7. Какова роль lineage в каталоге и зачем он нужен?
Lineage показывает путь данных от источника до конечного использования, включая все трансформации и переносы. Это важно для аудита, понимания влияния изменений, оценки рисков, анализа воздействия на бизнес-процессы и соблюдения регуляторных требований.
8. Какие шаги предпринять при внедрении интеграции источников в каталог?
Определить цели и владельцев данных, выбрать архитектуру (централизованный versus федеративный каталог), определить набор источников, выбрать коннекторы, настроить RBAC и SSO, настроить lineage и глоссарий, запустить пилот, пройти валидацию и начать широкое внедрение с планированием поддержки и обучения сотрудников.
9. Какие аргументы в пользу использования открытых платформ?
Гибкость, прозрачность, возможность адаптировать под специфику организации и локальные требования, активное сообщество, доступ к широким экосистемам коннекторов и механизмов интеграции, снижение зависимости от одного вендора и возможность эффективной локализации.
10. Что должно быть в плане внедрения с точки зрения безопасности?
Необходимо заранее определить требования к аутентификации и авторизации, внедрить RBAC и SSO, ограничить доступ по ролям, обеспечить аудит изменений, зашифровать трафик и хранение чувствительных данных, и поддерживать процессы управления инцидентами и регламенты обработки персональных данных.


