

Какие концепции ИИ, ориентированные на данные, лежат в основе моделей GPT?
Обзор технологий ИИ, ориентированного на данные, используемых в ChatGPT и GPT-4

Искусственный интеллект (ИИ) добился невероятных успехов в преобразовании нашего образа жизни, работы и взаимодействия с технологиями. В последнее время одним из направлений, в котором наблюдается значительный прогресс, является разработка больших языковых моделей (LLM), таких как GPT-3, ChatGPT и GPT-4. Эти модели способны с впечатляющей точностью выполнять такие задачи, как переводы и резюмирование текстов, а также ответы на различные вопросы.
Хотя трудно игнорировать рост объема моделей LLM, важно также признать, что их успех во многом обусловлен большим объемом и высоким качеством данных, используемых для их обучения.
В данной статье мы поговорим о последних достижениях в области LLM с точки зрения ИИ, ориентированного на данные, опираясь на результаты наших недавних обзоров с соответствующими техническими ресурсами на GitHub. В частности, мы подробнее рассмотрим модели GPT через призму ИИ, ориентированного на данные. Мы раскроем концепции ИИ, ориентированного на данные, лежащие в основе моделей GPT: создание обучающих данных, создание данных для выводов и обслуживание данных.
Большие языковые модели (LLM) и модели GPT
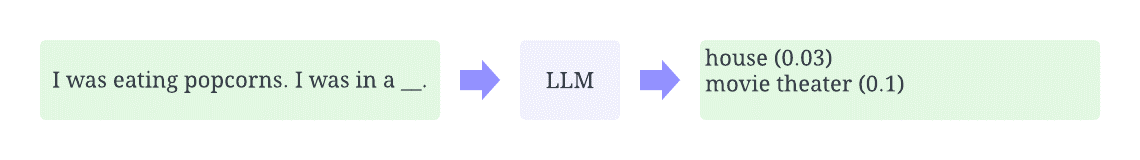
LLM - это тип модели обработки естественного языка, которая обучается находить слова в контексте. Например, самой основной функцией LLM является предсказание отсутствующих лексем с учетом контекста. Для этого LLM обучают предсказывать вероятность появления каждого кандидата в лексемы на основе массивных данных.
Модели GPT относятся к серии LLM, разработанных OpenAI ( GPT-1, GPT-2, GPT-3, InstructGPT, и ChatGPT/GPT-4). Наподобие других LLM, архитектура моделей GPT основана на Transformers, которые используют в качестве входных данных текст и позиционные вкрапления, а также слои внимания для моделирования связей между лексемами.
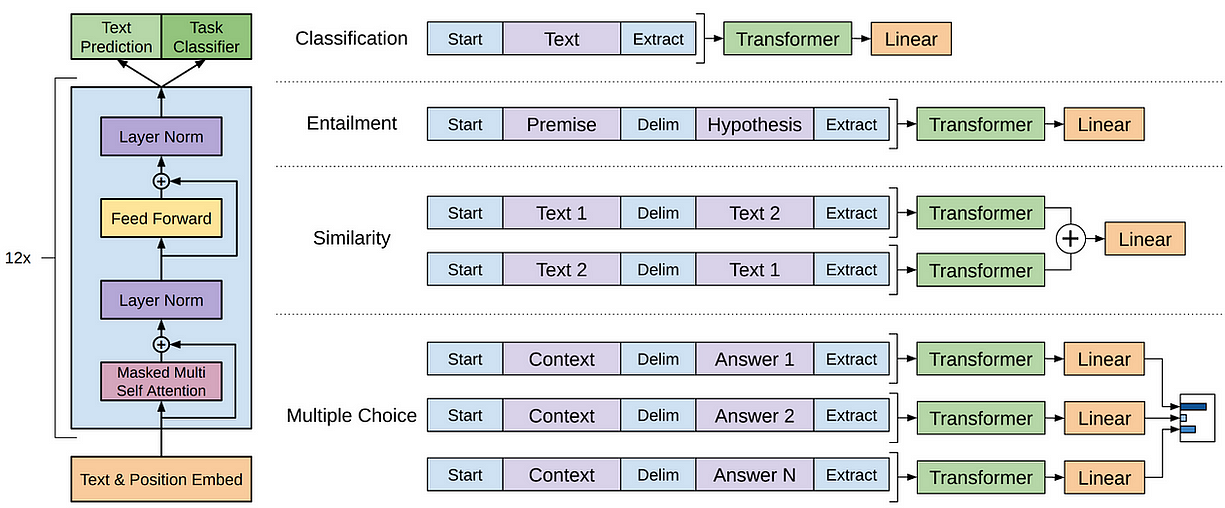
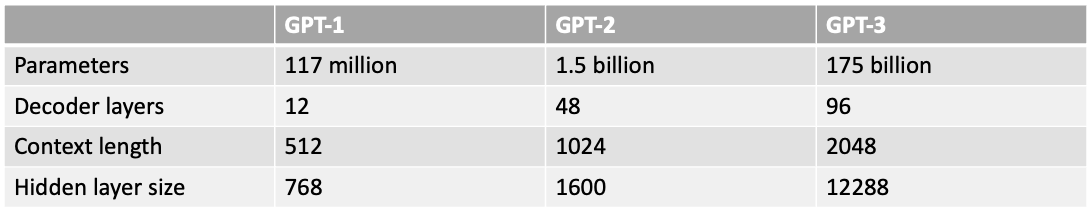
Последние модели GPT используют такую же архитектуру, как и у GPT-1, за исключением использования большего количества параметров модели с большим количеством слоев, большей длиной контекста, размером скрытого слоя и т.д.
Что такое ИИ, ориентированный на данные?
ИИ, ориентированный на данные - это новый подход к созданию систем искусственного интеллекта, пропагандируемый Эндрю Нг (Andrew Ng), пионер в области ИИ.
Прямоугольник: скругленные углы: «ИИ, ориентированный на данные - это дисциплина систематической разработки данных, используемых для создания системы ИИ»
Эндрю Нг
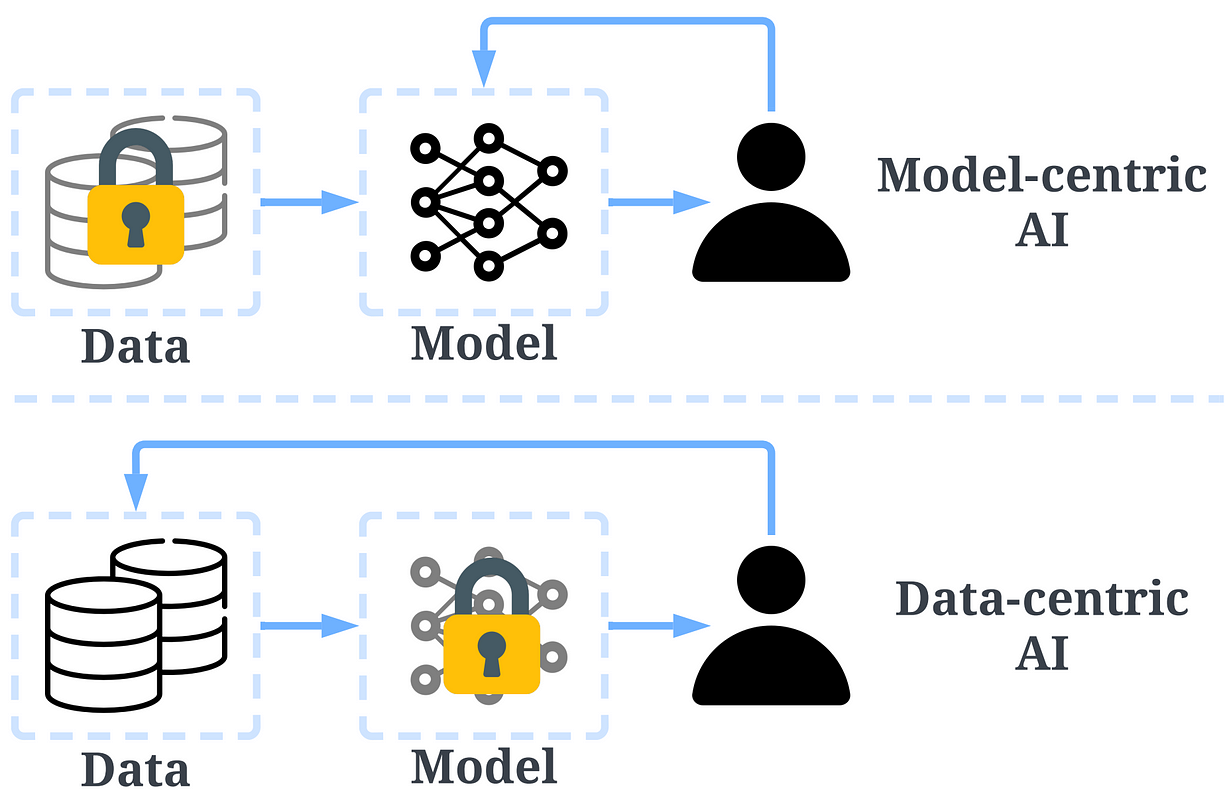
В прошлом мы в основном концентрировались на создании моделей при практически неизменных данных (модельно-ориентированный ИИ). Однако такой подход может привести к проблемам в реальном мире, поскольку он не учитывает различные проблемы, которые могут возникнуть в данных, такие как неточные метки, дубликаты и смещения. В результате "чрезмерная подгонка" набора данных не всегда приводит к улучшению поведения модели.
В отличие от этого, ИИ, ориентированный на данные, фокусируется на улучшении качества и количества данных, используемых для построения систем ИИ. Это означает, что основное внимание уделяется самим данным, а модели являются более фиксированными. Разработка систем ИИ на основе подхода, ориентированного на данные, имеет больший потенциал в реальных сценариях, поскольку данные, используемые для обучения, в конечном итоге определяют максимальные возможности модели.
Важно отметить, что термин "data-centric" принципиально отличается от термина "data-driven", поскольку в последнем случае речь идет лишь об использовании данных в качестве ориентира при разработке ИИ, который, как правило, по-прежнему ориентирован на создание моделей, а не на engineering data.
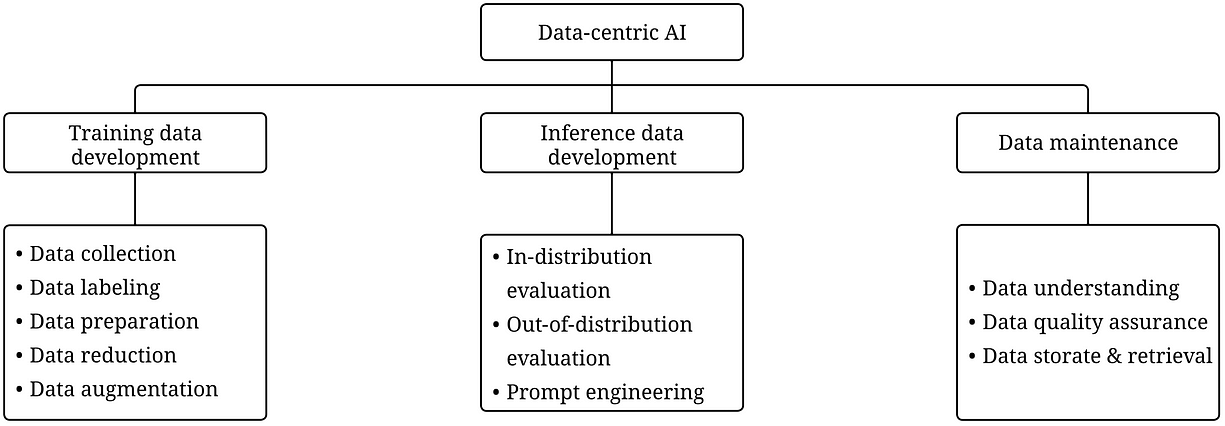
Концепция ИИ, ориентированного на данные, состоит из 3 целей:
- Разработка обучающих данных заключается в сборе и подготовке высококачественных данных для поддержки обучения моделей машинного обучения;
- Разработка данных для выводов заключается в создании новых наборов оценок, которые могут дать более детальное представление о модели или запустить определенную возможность модели с помощью специально разработанных входных данных;
- Обслуживание данных - это обеспечение качества и надежности данных в динамичной среде. Сопровождение данных является критически важным, поскольку в реальном мире данные создаются не один раз, а требуют постоянного обслуживания.
Почему ИИ, ориентированный на данные, обеспечил успех моделей GPT?
Несколькими месяцами ранее Ян ЛеКун написал в своем твиттере, что ChatGPT не представляет собой ничего нового. Действительно, все технологии (трансформатор, обучение на основе обратной человеческой связи и т.д.), использованные в ChatGPT и GPT-4, совсем не новы. Однако они позволили добиться невероятных результатов, которые не удавалось достичь предыдущим моделям. Итак, что же является движущей силой их успеха?
Создание обучающих данных. Количество и качество данных, используемых для обучения моделей GPT, значительно возросло благодаря более совершенным стратегиям сбора, маркировки и подготовки данных.
-
GPT-1: Для тренировки используется набор данных BooksCorpus . Он содержит 4629.00 MB сырого текста, включаякниги, относящиеся к различным литературным жанрам, таким как Приключения, Фантастика и Роман.
- Стратегии ИИ, ориентированного на данные: отсутствуют;
- Результат: Уточнение GPT-1 на этом наборе данных позволяет увеличить производительность на последующих задачах с тонкой настройкой.
-
GPT-2: Для тренировки используется WebText . Это внутренний набор данных OpenAI, созданный путем «соскабливания» исходящих ссылок из Reddit.
- Стратегии ИИ, ориентированного на данные: (1) Курировать/фильтровать данные, используя только те исходящие ссылки Reddit, которые получили не менее 3 баллов кармы. (2) Использовать инструменты Dragnet и Newspaper для получения чистого контекста. (3) Применять де-дупликациюи некоторые другие методы очистки.
- Результат: 40 ГБ текста после применения фильтрации.
-
GPT-3: Для тренировки в основном используется Common Crawl.
- Стратегии ИИ, ориентированного на данные: (1) Обучить классификатор для отсеивания некачественных документов на основе сходства каждого документа с WebText, являющимся прокси для высококачественных документов. (2) Использовать MinHashLSH в Spark для дедупликации документов. (3) Дополнить данные WebText, книжными корпорациями и Википедией.
- Результат: 570ГБ текста после применения фильтрации из 45 ТБ открытого текста (при такой качественной фильтрации отбирается только 1,27% данных).
-
InstructGPT: Позволяет людям оценить ответ, чтобы настроить GPT-3 таким образом, чтобы он лучше соответствовал их ожиданиям. Они разработали тесты для аннотаторов, и только те, кто прошел эти тесты, могут быть допущены к аннотированию. Они даже разработали опрос, чтобы убедиться, что аннотаторы получают удовольствие от процесса аннотирования.
- Стратегии ИИ, ориентированного на данные: (1) Использовать полученные от человека ответы на подсказки для настройки модели с помощью контролируемого обучения. (2) Собирать сравнительные данные для обучения модели, а затем использововать эту модель для настройки GPT-3 с помощью обучения с подкреплением на основе человеческой обратной связи (RLHF).
- Резльтат: InstructGPT демонстрирует большую правдивость и меньшую предвзятость, т.е. лучшее согласование.
- ChatGPT/GPT-4: OpenAI не раскрывает всех деталей. Но совершенно точно известно, что ChatGPT/GPT-4 является последователем предыдущих моделей GPT и по-прежнему для настройки модели используется RLHF. Существует общепринятое мнение, что GPT-4 использовал более объемные наборы данных, поскольку вес модель значительно увеличился.
Содание данных для выводов. Поскольку современные модели GPT достаточно мощные, мы можем достигать самых различных целей, настраивая промты (или настраивая данные для вывода). Например, мы можем резюмироватье тексты, предлагая текст для резюмирования вместе с инструкцией "Резюмируй это" или "TL;DR", чтобы направить процесс вывода.
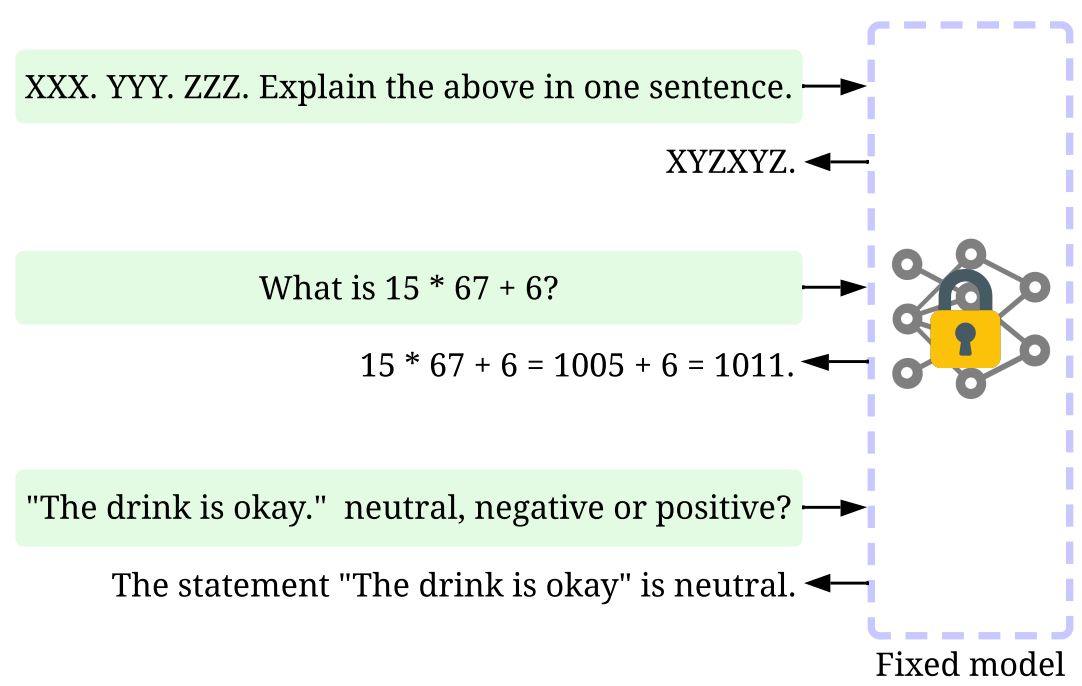
Разработка подходящих промтов – задача не из легких. Она в значительной степени опирается на эвристику. Отличный обзор резюмировал основные методы построения промтов. Иногда даже семантически схожие промты могут давать совершенно разные результаты. В данном случае для уменьшения вариативности целесообразно использовать Soft Prompt-Based Calibration.
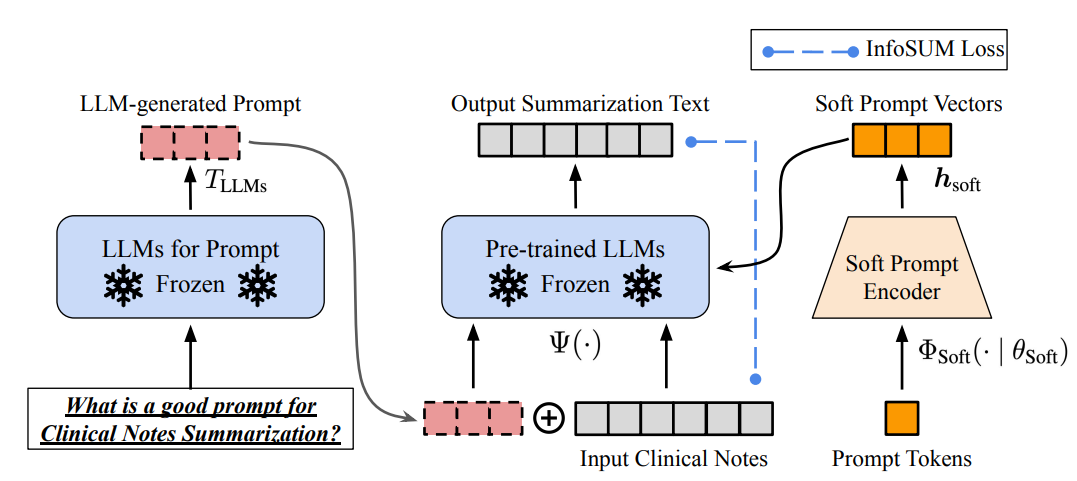
Исследования в области разработки выводных данных для LLM находятся на начальном этапе. В ближайшем будущем в LLM могут быть применены другие методы разработки данных для выводов , которые уже использовались в других задачах.
Обслуживание данных. ChatGPT/GPT-4, как коммерческий продукт, не обучается единожды, он постоянно обновляется и требует поддержки. Очевидно, что мы не можем знать, как осуществляется поддержка данных за пределами OpenAI. Поэтому давайте рассмотрим некоторые общие стратегии ИИ, ориентированные на данные, которые уже используются или с большой вероятностью будут использоваться для моделей GPT:
- Постоянный сбор данных: Когда мы используем ChatGPT/GPT-4, наши промты/обратная связь могут быть использованы OpenAI для дальнейшего развития своих моделей. Для сбора высококачественных данных могут быть разработаны и реализованы специальнвые метрики качества и стратегии по обеспечению высокого качества.
- Инструменты распознавания данных: Неплохо было бы разработать различные инструменты для визуализации и осмысления пользовательских данных, способствующие лучшему пониманию требований пользователей и определяющие направления для будущих улучшений.
- Эффективная обработка данных: Поскольку число пользователей ChatGPT/GPT-4 растет достаточно быстро, необходима эффективная система администрирования данных, позволяющая быстро их получать.
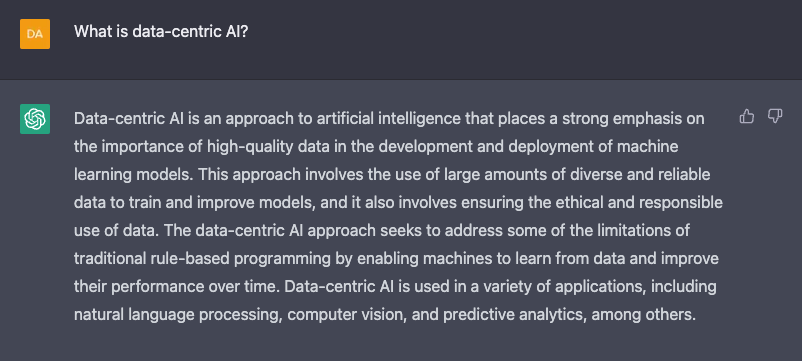
Чему сообщество по науке о данных может научиться у этихLMM?
Успех LLM привел к революции в области ИИ. В перспективе LLM могут произвести революцию в жизненном цикле данных. У нас два прогноза на этот счет:
- ИИ, ориентированный на данные, становится еще более важным. После многих лет исследований модельная конструкция уже достаточно развита, особенно после появления Transformer. Engineering data становятся важнейшим (а возможно, и единственным) способом совершенствования систем ИИ в будущем. Кроме того, когда модель станет достаточно мощной, нам не нужно будет обучать модели в ходе нашей повседневной работы. Вместо этого нам нужно будет только разрабатывать соответствующие данные для вывода (оперативная инженерия), чтобы получить знания из модели. Таким образом, исследования и разработки в области ИИ, ориентированного на данные, будут определять прогресс в будущем;
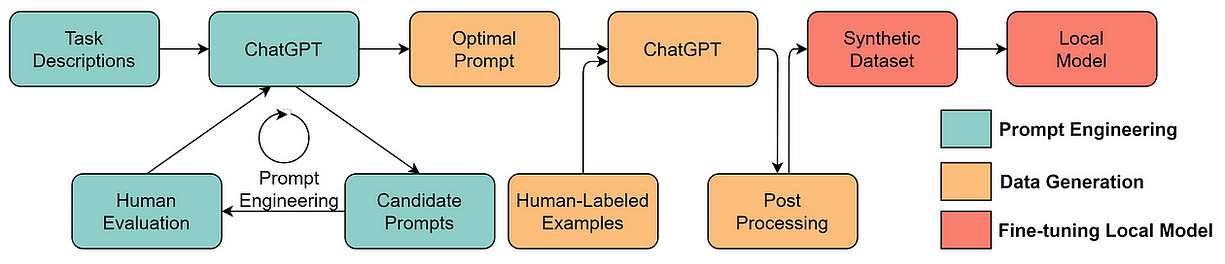
- LLM позволят создать более совершенные решения в области ИИ, ориентированные на данные. Многие утомительные работы в области науки о данных могут быть выполнены гораздо эффективнее с помощью LLM. Например, ChaGPT/GPT-4 уже может писать работоспособные коды для обработки и очистки данных. Кроме того, LLM можно использовать даже для создания данных для обучения. Например, в недавней работе было показано, что создание синтетических данных с помощью LLM может значительно повысить производительность моделей.
Надеюсь, данная статья вдохновит Вас. Более подробно о системе ИИ, ориентированной на данные, и о том, как она может быть полезна, можно узнать из следующих статей:
Мы создали репозиторий на GitHub, который будет регулярно обновляться. Не переключайтесь!


