

Платформа Data Mesh: self-serve инфраструктура и сервисы
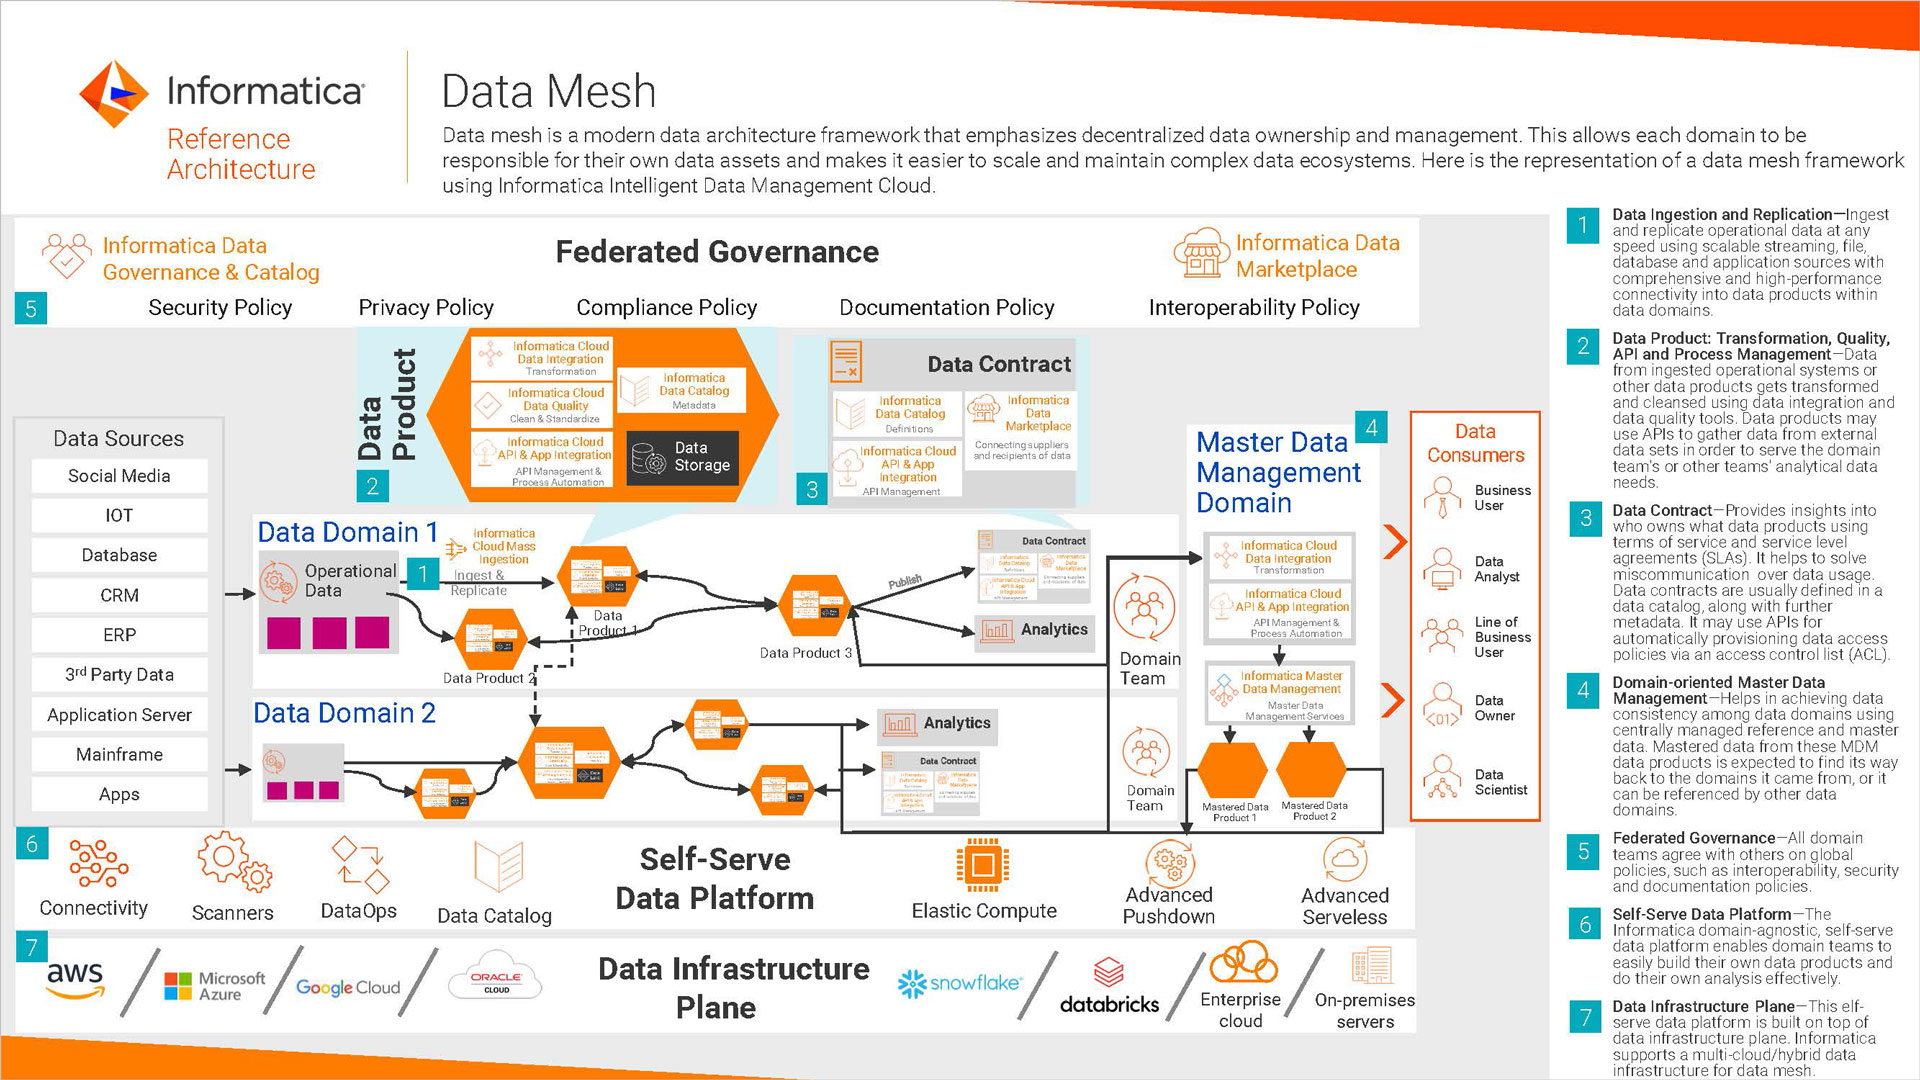
Самослужебная платформа - центральный элемент Data Mesh, который позволяет доменным командам автономно публиковать и управлять данными как продуктами. Она обеспечивает единые инфраструктурные услуги, политики и инструменты, необходимые для публикации, discovery, безопасного доступа, мониторинга и эволюции данных в рамках корпоративного DWH и Lakehouse. В рамках данной главы рассмотрены архитектурные принципы и ключевые сервисы платформы, паттерны взаимодействия между доменами, а также практики операционной эксплуатации и обеспечения соответствия требованиям безопасности и управления.
Платформа Data Mesh выступает связующим звеном между автономностью доменов и необходимостью сохранять целостность и управляемость корпоративной аналитической экосистемы. Она должна позволять доменным командам быстро находить данные, оценивать их качество и согласование с контрактами, а также предоставлять безопасный доступ к данным через хорошо определённые интерфейсы. В то же время платформа обеспечивает центральные сервисы - каталог данных, политику доступа, мониторинг, lineage и инфраструктурную внешнюю среду - так, чтобы масштаба и снижения рисков при горизонтальном росте доменов не происходило за счет хаотичного дублирования решений.
Краткое содержание главы
- Определение роли self-serve инфраструктуры в Data Mesh и её связь с архитектурой DWH и Lakehouse.
- Архитектура платформы: слои, сервисы и протоколы взаимодействия, принципы декомпозиции и интеграции.
- Контракты доменных продуктов и принципы самосервиса: данные как продукт, версия контрактов, управление доступом.
- Каталоги, API-first self-service: публикация, поиск, подписка, управление контрактами и мониторинг.
- Безопасность, управление доступом, аудит и прозрачность операционной деятельности.
- Эксплуатация платформы: CI/CD для данных, наблюдаемость, стоимость владения и эволюция архитектуры.
Архитектура self-serve платформы Data Mesh
Архитектура self-serve платформы строится вокруг нескольких взаимодополняющих слоёв: базовые сервисы инфраструктуры, доменные сервисы самосервиса и набор ориентированных на потребителя API-интерфейсов, которые позволяют доменным командам работать независимо друг от друга. Центральной концепцией является контракт между производителем данных и потребителем продукта: контракт определяет схему данных, требования к качеству, политики доступа и сроки хранения. Архитектура должна обеспечивать сильную разделяемость обязанностей, при этом поддерживая единый подход к управлению качеством данных, lineage и безопасности.
Ключевые компоненты
- Identity и Policy Engine: управление идентификацией, аутентификацией и авторизацией, политиками доступа к данным, включая RBAC, ABAC и контекстно-зависимые правила.
- Data Catalog и Metadata Repository: единый реестр активов данных, мигрирующий в единый источник истинности по метаданным, lineage и версионированию контрактов.
- Data Contracts и Data Product Registry: хранилище контрактов на уровне данных и интерфейсов, управление версиями и эволюцией контрактов.
- Data Quality и Observability: конвейеры проверки качества, правила проверки, мониторинг полноты, точности, своевременности, а также сбор и визуализация метрик и lineage.
- Data Platform и Compute Abstraction: общий набор инфраструктурных сервисов - хранение, вычисления, оркестрация задач и кэширование - с обеспечением изоляции ресурсов между доменами.
- Self-Service APIs и сервисный слой: REST/gRPC/API-first интерфейсы для публикации, поиска, подписки и доступа к данным, а также инструменты для создания и публикации Data Products.
- Интеграционная шина и события: обмен сообщениями, события об изменении данных и контрактов, поддержка event-driven сценариев и синхронных/асинхронных сценариев взаимодействий.
Протоколы взаимодействия
Взаимодействие компонентов self-serve платформы базируется на API-first подходе и унифицированном наборе протоколов. Для синхронных запросов применяются REST или gRPC API с хорошо описанными схемами и документами (OpenAPI/Protobuf). Для асинхронной коммуникации - сообщение через шину событий (Kafka, Pulsar или облачный аналог) с поддержкой коррекции и повторной попытки. В контексте Data Mesh важна консистентность данных и контрактная совместимость: схемы данных валидируются по контрактам до публикации, lineage автоматически пополняется во время загрузки и изменения данных, а политики доступа применяются на уровне сервиса и данных.
Взаимодействие с DWH и Lakehouse
Интеграция с корпоративными DWH и Lakehouse достигается посредством слоёв абстракции над источниками и вычислениями. К примеру, доменный сервис может предоставлять внешние таблицы в Iceberg или таблицы в Delta Lake, которые выражают контрактный контрактный набор полей и схемы. Системы управления доступом должны обеспечивать политики на уровне строк и столбцов, при этом сохраняются метрики lineage и аудита. Разделение управляемой зоны данных и вычислительной зоны обеспечивает безопасность и производительность: домены публикуют данные как готовые к использованию продукты, а платформа управляет вычислительной ресурсной подсистемой, scale-out обработкой и контролем затрат.
## пример конфигурации контракта данных в YAML
apiVersion: datamesh/v1
kind: DataProductContract
metadata:
  name: orders_public_v2
spec:
  version: v2
  schema:
    type: object
    properties:
      order_id:
        type: string
      customer_id:
        type: string
      total_amount:
        type: number
  privacy:
    pii: false
  retention_days: 365
  accessPolicy:
    roles: ["data_consumer","data_analyst"]
    namespaces: ["finance","sales"]
  lineage: true
Этот минимальный пример иллюстрирует ключевые элементы контракта: версия, схема, требования к приватности, срок хранения и политики доступа. В реальных условиях контракт может включать дополнительные параметры: допустимые версии схем, требования к частоте обновления, SLA на доступность, требования к мониторингу данных и метрикам качества.
Паттерны интеграции
- Контрактно-ориентированная интеграция: производство и потребление согласуют интерфейсы и требования к качеству ещё на этапе объявления продукта.
- Разделение слоя данных и вычислений: публикация данных через внешние таблицы или проекции, управляемые платфорой, с контролируемой производительностью и безопасностью.
- Локализация политик: политика доступа применяется как на уровне набора данных, так и на уровне отдельных колонок и строк, через слои политики и фильтрации.
Контракты доменных платформ и самосервисы
Контракты служат связующим контрактом между доменными командами и самой платформой. Они описывают не только схему и формат данных, но и требования к качеству данных, доступности и хранению. Контракты поддерживают эволюцию данных, позволяя версиям существовать параллельно, дефицировать устаревшие версии и планировать миграцию потребителей. В рамках архитектуры Data Mesh контракт включает следующие элементы:
- Versioning и жизненный цикл: каждый контракт имеет номер версии, дату выпуска и политику устаревания. Важное требование - поддержка миграций потребителей на новую версию через совместимый дескриптор и тестовую среду.
- Валидируемые схемы: схема, типы данных, ограничения(nullable, уникальность, внешние ключи), политика дефинирования чувствительных полей.
- Качество данных: набор требований к полноте, точности, своевременности и согласованности, включая автоматические проверки и пороги тревог.
- Аудит и lineage: запись происхождения данных, источников, изменений и воздействий на downstream-потребителей.
- Доступ и приватность: правила доступа к данным, включая роль, контекст, геолокацию и требования к приватности; поддержка строковой фильтрации и маскирования.
Контрактная модель способствует независимости команд. Производитель может обновлять контракт, не ломая потребителей, если версия совместима. Потребители, в свою очередь, подписываются на уведомления об изменении контрактов и тестируют совместимость в песочнице перед переходом на новую версию.
Пример контрактной схемы
В реальном применении контракт может быть представлен в машинно-читаемом виде и интегрирован в CI/CD процессов. Ниже приводится упрощённый фрагмент для иллюстрации концепции.
## файл: contracts/orders_public_v2.yaml
apiVersion: datamesh/v1
kind: DataProductContract
metadata:
  name: orders_public_v2
spec:
  version: v2
  schema:
    type: object
    properties:
      order_id: { "type": "string" }
      customer_id: { "type": "string" }
      total_amount: { "type": "number" }
  privacy:
    pii: false
  retention_days: 365
  accessPolicy:
    roles: ["data_consumer","data_analyst"]
  lineage: true
В этом примере отражены базовые элементы: версия, схема данных, требования к приватности, срок хранения, политики доступа и lineage. В реальности контракт может поддерживать маппинг для адаптации к разным хранилищам и версиям API потребителей.
Управление версиями и эволюция контрактов
- Версионирование: поддерживать несколько активных версий контрактов, чтобы миграция происходила без простоев.
- Депрегация: планировать замены и вывод из эксплуатации устаревших версий через уведомления и переходные периоды.
- Автоматизация тестирования: проверки на совместимость между версиями, регрессионные тесты для качественных метрик и соответствия схеме.
Каталоги и сервисы самообслуживания: API-first подход
Суть self-serve платформы состоит в предоставлении доменным командам возможности самостоятельно публиковать, находить и использовать данные как продукты, без постоянного участия центра компетенций. Каталог данных, реестр контрактов и сервисы подписки образуют ядро этой функциональности. Принцип API-first означает, что все операции доступны через хорошо документированные интерфейсы, что обеспечивает автоматизацию процессов публикации, верификации и доступа.
Функциональные возможности каталога
- Поиск и метаданные: поиск по схеме, тегам, домену, цели использования и SLA; поддержка полнотекстового индексирования и фильтров.
- Управление метаданными: версия данных, источник, lineage, качество, правила доступа и политика хранения.
- Управление контрактами: публикация нового контракта, версияция, просмотр зависимостей и зависимостей потребителей.
- Управление доступом: запросы на доступ, утверждения, аудит действий и роли.
- Наблюдаемость и измеряемость: сбор метрик использования данных, частоты обновления, задержек и ошибок.
API-интерфейсы и сценарии использования
- Поиск данных: потребитель запрашивает наборы данных по критериям и получает персонализированные результаты.
- Получение контракта: потребитель оценивает требования к схеме и качеству перед использованием.
- Запрос доступа: процесс запроса доступа к конкретному набору данных и последующее утверждение.
- Подписка на обновления: уведомления о новых версиях контрактов, изменениях в lineage и политике.
## пример HTTP-запроса на получение списка данных
GET /api/data-products?domain=sales&tag=financial
## пример запроса доступа
POST /api/data-products/orders_public_v2/access-requests
{
  "profile": "data_analyst",
  "reason": " анализ продаж за Q4"
}
Взаимодействие с безопасностью и контролем доступа
- RBAC и ABAC: комбинированное использование ролей и атрибутов контекста для гибкого ограничения доступа.
- Политики доступа на уровне строк и столбцов: маскирование чувствительных полей и фильтрация данных в зависимости от роли.
- Аудит и прозрачность: хранение журналов доступа, изменений контрактов и действий пользователей для аудита и соответствия требованиям.
Безопасность, доступ и операционная прозрачность
Безопасность должна быть встроена в архитектуру на этапе проектирования. Data Mesh требует надёжной и прозрачной модели управления доступом, детального аудита и грамотной реализации политики приватности. Основные принципы включают:
- Унифицированная идентификация: использование OIDC/OAuth2 для аутентификации, централизованный реестр пользователей и сервисов.
- Контекстная авторизация: учитывание контекста запроса, роли, принадлежности к домену и географической локализации.
- Защита данных в состоянии покоя и в транзите: шифрование на уровне хранилища и транспортная безопасность.
- Контроль доступа к данным: сложные политики доступа, включая контроль за доступом к конкретным колонкам (column-level security) и аудит исполнения.
- Аудит и комплаенс: детальные логи, интеграция с системами SOC и внутрирганизационная регуляция (например, внутренние политики retention и privacy rules).
Безопасность не должна быть слишком централизованной, чтобы не тормозить скорость публикации данных доменами. Важна гибкая политика, которая позволяет адаптироваться к требованиям бизнеса и регуляторным требованиям. Роль центра компетенций состоит в создании и поддержке общей политики, инструментов автоматизации и шаблонов конфигураций, которые домены могут применять без значительных расходов времени.
Эксплуатация, мониторинг и эволюция платформы
Операционная сторона Data Mesh требует внедрения практик DevOps/DataOps и SRE для данных. Эффективная платформа должна обеспечивать устойчивую работу, возможность быстрого внедрения изменений и предсказуемое управление стоимостью.
- CI/CD для данных: автоматизация тестирования контрактов, схем, проверок качества и миграций версий контрактов. В качестве инструментов часто применяют открытые фреймворки для тестирования данных и их качества в сочетании с процессами GitOps.
- Мониторинг и наблюдаемость: сбор метрик по доступности контрактов, задержкам публикации, качеству данных и lineage. Визуализация в дашбордах и создание алертингов на основе пороговых значений.
- Партнерство с платформой для управления затратами: мониторинг использования вычислительных ресурсов и хранения по доменным продуктам, контроль перерасхода и прогнозирование нагрузок.
- Эволюция архитектуры: регулярное обновление инфраструктурных компонентов, поддержка новых форматов данных, обновления на уровне контрактов и контрактных зависимостей, планирование миграций и деградаций совместимости.
- Примеры технологий и практик: использование IaC (инфраструктура как код) и GitOps для управления конфигурациями, применение открытых проектов для управления данными и мониторинга; внедрение независимости доменов в рамках единого платформенного контура.
Важно отметить, что выбор конкретных решений зависит от контекста организации, зрелости команд и регуляторных требований. В качестве примеров можно рассмотреть открытые решения, такие как Apache Iceberg/Delta Lake для таблиц и хранения, или DataHub как каталог метаданных и lineage, а также Great Expectations для проверки качества данных и мониторинга. В российских контекстах к подходящим примерам можно отнести локальные решения по управлению данными и безопасностью, но их применение должно опираться на согласованные политики и совместные практики в рамках корпоративной архитектуры.
Key takeaways
- Self-serve платформа Data Mesh обеспечивает автономию доменов при сохранении единой управляемости, качества и безопасности данных.
- Архитектура должна отделять инфраструктуру, платформенные сервисы и доменные приложения, поддерживая строгие контракты и версионирование.
- Контракты данных - это ядро совместимости: они описывают схему, требования к качеству, приватности и доступу, а также lineage.
- Каталог данных и API-first подход упрощают публикацию, поиск и подписку на Data Products, ускоряя внедрение и снижая риск ошибок.
- Безопасность и аудит должны быть встроенными по умолчанию, с гибкими политиками доступа и прозрачной регуляцией действий.
- Эффективная операционная практика требует CI/CD для данных, мониторинга качества и lineage, а также планирования эволюции платформы и управления затратами.
FAQ
- Что такое self-serve инфраструктура в контексте Data Mesh?
Self-serve инфраструктура - это набор платформенных сервисов и интерфейсов, которые позволяют доменным командам самостоятельно публиковать, управлять и потреблять данные как продукты. Это снижает зависимость от центральной команды и ускоряет скорость предоставления данных, но требует четко описанных контрактов, политик доступа и механизмов контроля качества, чтобы сохранить единое качество и управляемость всей аналитической экосистемы.
- Какие принципы лежат в основе контрактов Data Product?
Контракт должен зафиксировать версию, схему данных, требования к приватности и аудит, политику доступа, сроки хранения и lineage. Контракты поддерживают эволюцию данных: версии позволяют параллельно существовать устаревшим и новым форматом, а уведомления об изменении контрактов дают потребителям возможность адаптироваться без сбоев. Важно также определить критерии качества и мониторинга, чтобы соответствие контракту автоматически проверялось во время публикации и потребления.
- Как обеспечить безопасность в self-serve платформе без торможения внедрения?
Необходимо сочетать централизованное управление политиками с локальной автономией доменов. Реализация RBAC и ABAC, поддержка политики на уровне колонок и строк, аудит действий и независимые тесты соответствия - все это позволяет безопасно предоставлять доступ к данным. Важна интеграция политики в конвейеры публикации: любые изменения контракта должны проходить автоматическую валидацию и аудит, а доступ к данным - через контролируемые шлюзы и сервисы авторизации.
- Какие протоколы лучше использовать для взаимодействия сервисов Data Mesh?
Для синхронных операций подходят REST или gRPC с хорошо задокументированными схемами API (OpenAPI/Protobuf). Для асинхронной передачи событий - шина сообщений (например, Kafka или Pulsar) с повторной попыткой и отслеживанием lineage. Взаимодействие должно быть безопасным и совместимым с политиками доступа, поэтому аутентификация через OIDC и централизованные сервисы авторизации являются предпочтительной практикой.
- Как организовать публикацию данных как продукта?
Каждый Domain Data Product должен иметь набор метаданных, контракт, набор правил качества и политики доступа. Публикация происходит через каталог данных и реестр контрактов, после чего данные становятся доступны в рамках согласованных интерфейсов. Потребители могут просмотреть контракт, проверить совместимость и запросить доступ. Важно обеспечить возможность версионирования и миграции, чтобы потребители могли плавно переходить на новые версии без простоев.
- Как связать публикацию данных с DWH/Lakehouse?
Платформа должна абстрагировать источники через внешние таблицы или проекции, управляемые ядром платформы. Это позволяет доменам не копировать данные по всему контуру, а давать доступ через контролируемые слои и безопасные интерфейсы. Lineage и метаданные сохраняются на уровне платформы, что обеспечивает прозрачность происхождения данных и их траекторию через конвейеры в Lakehouse или DWH.
- Как измерять успех внедрения Data Mesh-платформы?
Успех измеряется через скорость публикации Data Products, долю потребителей, охват контрактов, качество данных, задержки обновления контракта, уровень доступа и аудит, а также показатели стоимости владения инфраструктурой. Регулярные аудиты, тестирование совместимости и мониторинг данных позволяют оценить устойчивость экосистемы и своевременно выявлять узкие места.
- Какие риски связаны с внедрением платформы и как их минимизировать?
Основные риски - задержки между доменами, несогласованные контракты, недостаточная прозрачность lineage и угрозы безопасности. Минимизация достигается через раннее внедрение контрактной модели, автоматизацию тестирования контрактов и качества, четкое разделение зон ответственности, а также обучение команд работе с каталогами, API и инструментами мониторинга.
- Какие мировые и локальные примеры технологий чаще всего применяются?
Из открытых проектов часто используют Apache Iceberg или Delta Lake в качестве форматов таблиц и хранения, Data Hub как каталог метаданных и Apache Atlas или Great Expectations для обеспечения качества. В локальных реалиях возможно применение отечественных решений в рамках корпоративной инфраструктуры или соответствующих отечественных экосистем, адаптированных под регуляторные требования, с учётом совместимости с открытыми стандартами.
- Как начать переход к Platform-as-Data в рамках Data Mesh?
Стратегия начинается с определения набора доменов и определения граней их ответственности, выбора базовых инфраструктурных сервисов и политики доступа. Затем создаются пилотные Data Products в рамках ограниченного набора доменов, внедряются контракты и каталог, устанавливаются процессы ревью и миграции версий. По мере набора опыта платформа расширяется на другие домены, параллельно развивая практики мониторинга, тестирования и управления затратами. Важным является внедрение архитектурных паттернов, которые обеспечивают масштабируемость и управляемость, не становясь препятствием для скорости публикации данных.
Эта глава сформировала концептуальные ориентиры и практические принципы построения платформы Data Mesh, ориентированной на self-serve инфраструктуру и сервисы. В следующих главах будет рассмотрено детальное проектирование монолитных и микросервисных компонентов, примеры реализации паттернов совместной работы доменных команд и методики внедрения в условиях крупных корпоративных DWH и Lakehouse.


