

Разработка, развертывание и эксплуатация конвейеров: DevOps для данных
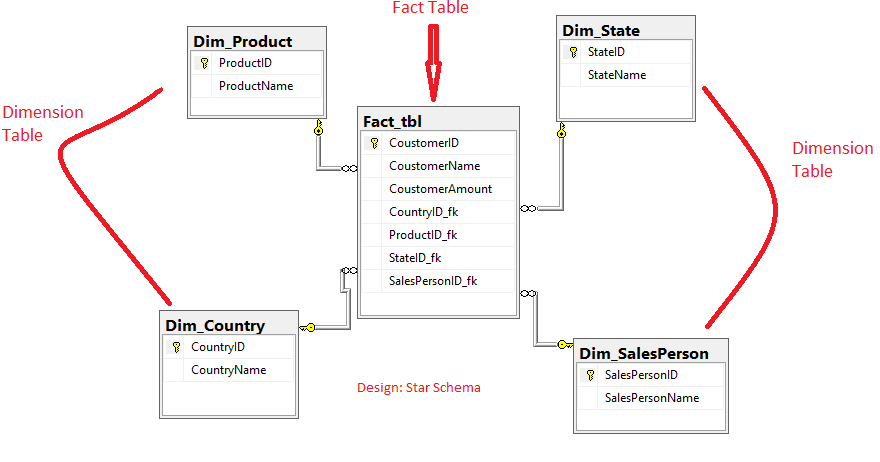
В контексте современных информационных систем данные становятся неотъемлемым продуктом бизнеса. Эффективная работа конвейеров превращает сырьевые поступления в надежные факты и размерности, обеспечивая своевременную доступность, качество и управляемость. DevOps для данных сочетает принципы непрерывной интеграции и развёртывания с требованиями к управлению схемами, качеством данных и операционной устойчивостью. В этой главе рассматриваются архитектурные паттерны, практики контроля изменений, тестирования и мониторинга, которые позволяют реализовать устойчивый конвейер для Fact & Dimension Tables на практике.
Цель главы - преобразовать теоретические принципы в конкретные подходы к проектированию, развёртыванию и эксплуатации конвейеров: от выбора архитектуры и инструментов до процедур эксплуатации и улучшения процессов на уровне всей организации.
- Краткое содержание главы
- Архитектура конвейера и DevOps-подход к данным, включая данные контракты, версионирование и устойчивость к изменению схем.
- Управление версиями схем, миграциями и совместимостью для фактов и размерностей.
- CI/CD для данных: сборка, тестирование и развёртывание конвейеров, роль моделирования и контроля качества.
- Мониторинг, эксплуатация и операционные процессы: наблюдаемость, инцидент-менеджмент и улучшение конвейеров.
- Практические паттерны внедрения и управление рисками.
Архитектура конвейера: DevOps-подход к данным
Уровень архитектуры конвейера должен обеспечивать четкое разделение обязанностей между источниками данных, трансформацией и хранилищем, при этом сохранять управляемость и воспроизводимость. В контексте Fact & Dimension Tables ключевые принципы включают модульность, контрактность между репозиториями данных и потребителями, а также возможность повторного выполнения трансформаций без дублирования данных.
- Модульность и разделение слоёв: слой инжекции данных может состоять из CDC-слоя (или буфера событий), слоя трансформаций и слоя моделирования. Ведущая роль отводится оркестратору конвейеров, который обеспечивает надёжную постановку задач, обработку ошибок и повторные запуски.
- Данные контракты и схема как первые граждане: каждое изменение в источниках и трансформациях сопровождается контрактом на схему и ожидаемые показатели качества. Для динамичных схем целесообразно применить реестр схем (schema registry) и версионирование таблиц, чтобы потребители могли адаптироваться к изменениям без сбоев в работе.
- Инкрементальные загрузки и CDC: для Fact & Dimension Tables критически важны методы извлечения изменений и загрузки без перегрузок. CDC, а также режимы SCD (Slowly Changing Dimensions) должны быть встроены как первые классы в проект конвейера, чтобы поддерживать корректную историю изменений размерностей и целостность фактов.
- Надежность и повторяемость: Idempotent transforms и детерминированная нумерация партий данных позволяют повторно запускать конвейеры без риска дублирования. Логика повторных запусков сочетается с устойчивостью к сбоям и возможностью быстрого воспроизведения истории.
- Линейность и трассируемость: полный путь данных** - от источника до целевых таблиц - должен быть прозрачен через lineage-метрики и метаданные, что упрощает аудит, ретроспективу и локализацию проблем.
- Пример архитектурной композиции: Ingestion Layer (CDC/Streaming) -> Staging -> Transformation Layer (SQL/Spark) -> Modeling Layer (FCT, dimensions) -> Presentation/Consumption Layer (BI, аналитика) с оркестрацией на Airflow или Dagster и версиями схем в реестре.
Эти принципы особенно важны для обеспечения корректности и согласованности между фактами и размерностями: любые изменения в измерениях требуют согласованных процессов миграции и тестирования, чтобы не нарушить целостность бизнес-подводной части аналитики.
- Роль выбора инструментов: ориентируйтесь на сочетание надёжного оркестратора, эффективного слоя моделирования и инфраструктуры для управления схемами. В реальных проектах часто встречаются связки, где оркестратор (например, Apache Airflow, Dagster) координирует задания, dbt управляет моделированием размерностей и факт-таблиц, а некоторая часть инфраструктуры обеспечивает схему и метаданные.
- Ключевые требования к архитектуре: поддержка версий таблиц, управление миграциями без простоя, возможность отката, мониторинг загрузок, обеспечение достаточной прозрачности по lineage и качеству данных.
Почему это важно для работы с фактами и размерностями? Фактовые таблицы несут высокую нагрузку на производительность и целостность. Любые изменения в размерностях напрямую отражаются на точности аналитических выводов и отчетности. Архитектура DevOps для данных должна обеспечить предсказуемость изменений, возможность развёртывания с минимальными задержками и эффективный контроль качества на каждом этапе конвейера.
Архитектура конвейера и паттерны внедрения
- Контракты схем: применяйте контрактную схему с явным определением ключей, типов и ограничений. При изменениях поддерживайте параллельные версии схем или миграционные планы, чтобы потребители имели время адаптироваться.
- Эффективное использование CDC: избирательно применяйте CDC к критичным источникам и таблицам, отслеживая латентность и задержку во время пиковых нагрузок.
- Линейка тестирования на каждом слое: на уровне источников - валидация данных, на уровне трансформаций - тесты детерминированности и idempotence, на уровне моделей - тесты бизнес-правил и корректности агрегаций.
- Мониторинг целостности lineage: храните и визуализируйте зависимость от источников к целевым таблицам, чтобы быстро отвечать на последствия изменений в источниках данных.
- Обеспечение устойчивости к изменению: планируйте миграции схем, стратегий SCD, переключения между версиями таблиц и режимов загрузки без прерывания аналитики.
Управление версиями и изменения: схемы, миграции, совместимость
Управление версиями в контексте Fact & Dimension Tables требует прозрачности и формальных процедур. Миграции должны быть предсказуемыми, обратимыми и безопасными. Важной частью является поддержка совместимости между старыми и новыми версиями схем и таблиц, особенно когда данные уже потребляются многочисленными аналитическими инструментами и BI-панелями.
- Версионирование и реестр схем: храните версии схем и таблиц как часть метаданных проекта. Это облегчает откат и аудиты, а также упрощает планирование backfill и ретроспективы.
- Совместимость и стратегии миграций: применяйте стратегию нулевого простоя, например создание новой версии таблицы (shadow table) и миграцию через копирование, затем переименование и смену ссылок на потребителе. Для SCD размерностей применяйте типы изменений, которые минимизируют риск потери истории.
- Миграции фактов и размерностей: фактовые таблицы особенно чувствительны к задержкам и нарушению единообразия временных меток. При изменениях в измерениях и связанных ключах обеспечьте совместимость ключей и соответствие бизнес-правил для агрегаций.
- Скрипты миграций и их контроль: храните миграционные скрипты в версии и применяйте их через контролируемые пайплайны. Все критические миграции сопровождайте тестами на предшествующих наборах данных.
- Тестирование изменений: помимо модульных тестов трансформаций, выполняйте end-to-end тесты, где проверяете согласованность фактов и измерений на целевых структурах. Включите проверки временных признаков и корректности исторических данных.
Внедрение схемного контроля требует дисциплины и пропускной способности процессов. В реальном проекте целесообразно рассмотреть стратегию параллельных версий таблиц вокруг критичных областей, чтобы минимизировать риск и обеспечить плавную миграцию без ущерба для аналитической доступности.
- Привязка к архитектурным паттернам: при переходе к новой схеме подумайте о сохранении совместимости идентификаторов и ключей, чтобы существующие домены аналитики не требовали радикальных изменений.
- Прозрачность изменений: документируйте каждое изменение схемы, его влияние на качество данных и бизнес-процессы, а также связанные тесты и параметры окружения.
Типичные сценарии изменений в Fact & Dimension Tables требуют особого внимания к глобальным метаданным и тестируемости конвейера. Основа - планирование миграций, надёжные тесты и поэтапное развертывание.
Конкретные приемы и паттерны
- Контракт-first подход: формируйте требования к данным и схемам до реализации конкретных трансформаций. Это снижает риск несогласованности между источниками и потребителями.
- Версионирование таблиц и миграции: используйте параллельные версии таблиц и безопасные миграции, чтобы не прерывать аналитический доступ.
- Работа со SCD: для размерностей применяйте проверенные типы изменений (Type 2, Type 3 и пр.) с устойчивой логикой обновления и сохранения истории.
- Тестирование на продвинутом уровне: кроме unit-тестов трансформаций добавляйте end-to-end тесты, которые проверяют согласованность фактов и размерностей на выбранном наборе данных.
- Лидерство по качеству: внедрите базовые практики контроля качества на каждом этапе конвейера и устанавливайте пороги допустимого риска.
CI/CD для данных: сборка, тестирование и развёртывание конвейеров
CI/CD для данных требует адаптации классических практик DevOps к особенностям обработки данных: детерминизм, воспроизводимость, тестируемость и безопасность. В контексте DevOps для данных основное внимание уделяется автоматизации сборки трансформаций, тестированию качества данных и надёжному развёртыванию в окружения development, staging и production.
-
Инфраструктура как код и окружения: храните инфраструктуру конвейеров, ресурсы хранения и разрешения доступа как код. Это упрощает развёртывание повторяемых окружений и управление изменениями.
-
Контроль качества на ранних стадиях: внедряйте тестирование не только на уровне отдельных трансформаций, но и на уровне моделей, Validated Data Contracts и согласованности между фактовыми и размерными таблицами.
-
Верификация миграций и безопасные релизы: применяйте паттерны blue/green или canary для схем и данных, чтобы минимизировать риск на проде. Развёртывание критично для аналитических процессов, потому что потребители могут зависеть от конкретной структуры данных.
-
Непрерывная документация и прозрачность: поддерживайте документацию по моделям, тестам и окружениям, а также автоматически обновляйте документацию по данным и lineage.
-
Безопасность и доступ: обеспечьте ограничение доступа к конфиденциальным данным и контроль изменений в схемах, чтобы соответствовать требованиям регуляторики и корпоративной политики.
-
Пример практического паттерна: использование dbt для моделирования размерностей и фактов в связке с оркестратором для управления зависимостями и окружениями. В этом случае CI/CD фокусируется на тестах dbt, проверке совместимости и автоматическом развёртывании моделей в staging, а затем в production после прохождения проверок.
-
Пример кода: небольшой фрагмент CI-пайплайна на GitHub Actions, иллюстрирующий сборку и тестирование dbt.
name: CI for data pipelines on: push: branches: [ main ] jobs: test-and-deploy: runs-on: ubuntu-latest steps: - uses: actions/checkout@v4 - **name**: Set up Python uses: actions/setup-python@v5 with: python-version: '3.11' - **name**: Install dbt run: pip install dbt-core dbt-snowflake - **name**: Run dbt tests run: dbt test -
Как организовать окружения: dev, staging и prod должны быть отделены на уровне данных и инфраструктуры. Механизм одобрения на промо-кейсы, а также возможность отката к предыдущей версии - минимизируют риск.
Почему стоит сосредоточиться на CI/CD для данных? Эффективный цикл сборки и развёртывания обеспечивает воспроизводимость, улучшает качество данных и снижает риск ошибок при внедрении изменений в схемы и трансформации. В частности, для Fact & Dimension Tables это обеспечивает согласованность между различными слоями аналитики и минимизирует временной разрыв между выпуском и доступностью обновлённых данных.
Примеры ключевых тестов и проверки
- Тесты трансформаций: проверка детерминированности, корректности вычислений и соответствия бизнес-правил.
- Границы и целостность данных: проверки уникальности ключей, отсутствия пропусков в критичных столбцах и корректности агрегаций.
- End-to-end тесты загрузок: проверяют, что данные проходят через все слои, и целевые таблицы получают ожидаемое содержимое.
Мониторинг и эксплуатация: наблюдаемость конвейеров
Обеспечение наблюдаемости - критический элемент DevOps для данных. Без адекватного мониторинга команды не смогут своевременно обнаружить и локализовать проблемы, определить влияние изменений на качество данных и бизнес-процессы.
- Метрики конвейера: задержка загрузки, время выполнения ETL/ELT, пропуск операций, доля ошибок, частота повторных запусков. Эти показатели позволяют оценивать устойчивость и производительность.
- Качество данных как продукт: помимо технических метрик обращайте внимание на качественные показатели: полнота данных, согласованность между фактами и размерностями, корректность временных отметок.
- Наблюдаемость и трассировка: внедрите lineage-метрики, чтобы видеть путь данных от источника к целевым таблицам, а также используйте логи и трассировку для быстрого обнаружения причин сбоев.
- Инструменты мониторинга: для эффективной визуализации применяйте решения на базе Prometheus и Grafana, а для трассировки - OpenTelemetry или аналогичные подходы. Сохранение и анализ логов обеспечивает долгосрочное понимание активности конвейера.
- Эксплуатационные процедуры: разработайте runbooks для инцидентов, автоматические алерты по критическим метрикам и регламентные задачи по проверке соответствия требованиям к качеству.
Почему мониторинг важен для DevOps в данных? Своевременная идентификация задержек и ошибок в конвейере минимизирует риск недоступности аналитических данных, ухудшения качества и задержки в принятых бизнес-решениях. Наблюдаемость помогает не реагировать на сбои, но и развивать конвейер: выявлять узкие места, оптимизировать ресурсы и улучшать устойчивость к изменениям.
- В чем заключается роль политики SLA и SLO в дата-бизнесе? Определение целевых уровней доступности и качества данных помогает формировать ожидания бизнеса, устанавливать ответственность и структурировать работу команд по улучшению конвейеров.
- Как организовать устойчивость к сбоям? Включайте планирование отказоустойчивости: копирование данных, резервные копии, механизмы повторного разворачивания и тестирования восстановления.
Практические паттерны внедрения и интеграции
Реализация DevOps для данных требует сочетания процессов, технологий и организационных изменений. Ниже представлены несколько практических паттернов, которые часто встречаются в реальных проектах и дают эффективную базу для дальнейшего масштабирования.
- Контрактно-ориентированная разработка: задавайте требования к данным и схемам заранее, поддерживайте совместимость и документируйте ожидания потребителей данных.
- Партнёрство между моделированием и автоматизацией: dbt и подобные инструменты позволяют управлять размерностями и фактами в рамках единого репозитория изменений, облегчая контроль версий и тестирование.
- Управление изменениями без прерывания аналитики: используйте миграции схем с параллельной версией таблиц, переключение потребителей на новую схему и ретроспективные проверки, чтобы бизнес продолжал получать доступ к данным.
- Канарейный внедрение изменений: разворачивайте изменения в небольших порциях, анализируйте влияние на качество данных и устойчивость конвейера, прежде чем перейти к полной миграции.
- Учет затрат и оптимизация: планируйте конвергенцию между требованиями качества, latency и стоимость обработки, применяйте соответствующие паттерны, такие как партиционирование и таргетированное кэширование, чтобы управлять ресурсами.
Развитие DevOps для данных - это не только техническая задача, но и организационная: требуется выстроить совместную работу между командами разработки данных, аналитики и эксплуатации, определить ответственных за мониторы качества, а также внедрить единые процедуры тестирования и развёртывания. Важно внедрять культуры прозрачности и совместной ответственности за качество и своевременность данных.
Key takeaways
- DevOps для данных объединяет архитектуру, процессы и операционные практики для обеспечения воспроизводимости и устойчивости конвейеров Fact & Dimension Tables.
- Контракты схем, версионирование и тестирование на уровне конвейера снижают риск изменений и улучшают управляемость.
- CI/CD для данных, включая тестирование моделей и миграций, позволяет достигать предсказуемых релизов и более быстрого времени реакции на бизнес-требования.
- Мониторинг и наблюдаемость должны охватывать производительность конвейера, качество данных и lineage, чтобы оперативно обнаруживать проблемы и проводить анализ влияния изменений.
- Практические паттерны внедрения помогают минимизировать риск, ускорить внедрение и обеспечить устойчивость к меняющимся условиям бизнеса.
FAQ
- Что включает понятие DevOps для данных и чем оно отличается от традиционного DevOps?
- DevOps для данных адаптирует практики DevOps к данным и аналитике: управление версиями схем, тестирование качества данных, контроль миграций и мониторинг конкретно вытаскиваемых данных и фактов. В отличие от классического DevOps, здесь особое внимание уделяется воспроизводимости конвейеров, семантике схем, lineage и управлению временем жизни данных (latency, freshness) и бизнес-правилам аналитики.
- Как выбрать стратегию миграции схемы для фактов и размерностей без прерывания аналитики?
- Применяйте стратегию параллельных версий схем и миграций: создайте shadow-таблицу, доведите данные до новой версии, выполните валидацию, затем переключите потребителей на новую версию. Важно обеспечить полноценное тестирование на staging и иметь план отката. Для размерностей используйте SCD-методы (Type 2/Type 3) с чёткими правилами обновления, чтобы сохранять историю и поддерживать корректные агрегации.
- Как обеспечить повторяемость и детерминированность конвейера?
- Обеспечьте детерминированные ключи и последовательности загрузки, используйте idempotent transforms, храните версии кода и схем, применяйте контрольные точки и журналирование. Автоматическая повторная загрузка должна приводить к идентичному результату без дублирования записей.
- Какие инструменты чаще всего применяются для DevOps в данных?
- В типовой связке встречаются оркестраторы (Airflow, Dagster), инструменты моделирования данных (dbt), и механизмы управления схемами. Для мониторинга применяют Prometheus и Grafana, а для трассировки - OpenTelemetry. В контексте облаков возможны решения на основе встроенных сервисов провайдера и открытых проектов, ориентированных на гибкую интеграцию.
- Какие типичные ошибки встречаются при внедрении DevOps для данных?
- Неправильное управление версиями схем, отсутствие тестов на изменениях, недостаточное внимание к lineage и качеству данных, отсутствие чётких процедур развёртывания и мониторинга. Часто ошибки возникают при попытке «переписать» схемы в проде без адаптивного плана миграции и без учёта потребителей.
- Как обеспечивать качество данных на всём конвейере?
- Включайте проверки на уровне источников, трансформаций и целевых таблиц, используйте тесты соответствия бизнес-правилам, валидацию целостности ключей и точности агрегаций. Включение автоматических тестов в CI/CD позволяет выявлять отклонения до развёртывания в прод.
- Какие паттерны помогут управлять изменениями в бизнес-логике без риска для аналитики?
- Контракт-first подход, отдельное тестирование контракта, можно использовать паттерн canary для изменений и шаговое развёртывание, сопровождаемое мониторингом качества данных и lineage, чтобы быстро реагировать на отклонения.
- Что важно учесть при работе с фактовыми и размерными таблицами в крупных компаниях?
- Важны управляемость изменений, консистентность между слоями конвейера, прозрачность lineage и учет регуляторных требований к данным. В крупных организациях особенно критично обеспечить согласование между командами, документирование процессов миграций и наличие механизмов аудита.
- Какие организационные изменения часто сопровождают внедрение DevOps для данных?
- Формирутся команды ответственные за данные, внедряются практики совместной разработки и эксплуатации, создаются общие стандарты моделирования, тестирования и развёртывания, прописываются политики по доступу и управлению рисками, внедряется централизованный мониторинг и управление изменениями.
- Какие дальнейшие шаги для углубления практик DevOps в данных вы бы рекомендовали?
- Разработать и утвердить контракты данных и схем на уровне организации, внедрить schema registry и версионирование таблиц, расширить набор тестов для end-to-end проверки изменений, усилить мониторинг качества и lineage, а также постепенно расширять автоматизацию развёртывания конвейеров в продакшен окружение с фиксацией контрольных точек и откатов.
Глава представлена с целью балансированного подхода к архитектуре, процессам и практическим аспектам внедрения DevOps для данных в контексте Fact & Dimension Tables. Включенные примеры и рекомендации служат ориентиром для профессиональной разработки, развёртывания и эксплуатации конвейеров, обеспечивая надёжность, воспроизводимость и управляемость аналитических процессов.


