

Интеграция и ELT против ETL: стратегия загрузки и pushdown
В условиях современных больших данных выбор между ETL и ELT диктуется требованиями к скорости загрузки, масштабируемости и качеству данных. Эффективная интеграция данных в хранище требует ясной архитектуры, понимания того, какие операции выполняются в сторонних системах, а какие - в целевом DWH. В этой главе разворачивается практический взгляд на две парадигмы загрузки, их влияние на архитектуру и производительность, а также механизмы pushdown - когда и как переносить вычисления ближе к источнику данных для оптимизации затрат и времени выполнения.
Краткое введение
-
Понимание различий между ETL и ELT - как они влияют на пути обработки данных, требования к ресурсам и срокам поставки аналитики.
-
Архитектурные решения: зоны данных, ные и обработанные слои, схемы модульности и повторного использования компонентов.
-
Технологии и паттерны pushdown: где возможно переносить трансформации в источники данных и как это влияет на управляемость и стоимость.
-
Практические сценарии внедрения: типовые архитектуры под крупные объёмы и требования к SLA, совместимость с существующими инструментами и процессами.
-
Различия архитектур и стратегий инжекции данных
-
Методы pushdown и их влияние на производительность
-
Интеграционные схемы и выбор инструментов
-
Практические руководства по реализации и мониторингу
Краткое содержание главы
- Архитектурные модели загрузки: ETL против ELT, зоны данных и принципы трансформации.
- Pushdown: что это, какие операции можно переносить и как защищать качество данных.
- Интеграционные протоколы и схемы обработки: батчевые и стриминговые подходы, форматы данных, контроль версий.
- Выбор стратегии: критерии, риски и организационные аспекты внедрения.
- Реализация на практике: пример архитектуры и сценарии загрузки в современных DWH.
- Контроль качества, мониторинг и управление изменениями.
Архитектурные модели загрузки: ETL vs ELT
Эта секция объясняет фундаментальные различия двух парадигм и их последствия для архитектуры DWH. В ETL данные проходят серию трансформаций до того, как попадут в целевое хранилище. Это требует мощной промежуточной платформы для обработки, orchestration и управления качеством данных. В ELT данные вначале загружаются в «сырой» слой, затем трансформации выполняются в самом DWH или в его аналитических слоях. Такой подход снимает давление с внешних ETL-шлюзов и позволяет масштабировать обработку за счет возможностей самого хранилища.
- В ETL ключевые решения касаются способности обрабатывать данные в промежуточном уровне: форматирование, нормализация, санитарная обработка, обогащение. Преимущества - контроль над качеством на раннем этапе, упрощение последующей аналитики в некоторых сценариях и предсказуемые сроки загрузки.
- В ELT основная работа по трансформации переносится в аналитическую систему. Это обеспечивает гибкость, ускоряет цикл разработки новых показателей и лучше подходит для больших объёмов, где вычисления можно эффективно распараллелить на целевом хранилище. Однако требует более тщательного управления качеством данных и координации между загрузкой и трансформацией.
Архитектурная практика предполагает наличие как минимум трех слоёв данных:
- Raw (сырой) слой - данные в их исходном формате без значительной трансформации.
- Processed (обработанный) слой - результаты минимальных преобразований для устранения структурных несоответствий и подготовки к бизнес-аналитике.
- Analytics (аналитический) слой - готовые к потреблению бизнес-показатели, кубы и витрины.
В этой схеме ETL чаще реализуется через мощный промежуточный слой, который осуществляет большую часть трансформаций до загрузки в целевую систему. ELT же предполагает загрузку «как есть» и последующую трансформацию внутри хранилища, что требует поддержки мощной вычислительной перспективы внутри DWH и грамотного проектирования операционных нагрузок.
Предпочтения и компромиссы
-
Нагрузка на источники данных: ETL может снизить нагрузку на источник за счет выполнения трансформаций вне зоны источника, ELT может увеличить нагрузку на источники, если преобразования включают доступ к большим объемам данных.
-
Контроль качества: ETL позволяет внедрять процедуры в промышленных этапах обработки, что упрощает аудит и повторную валидацию. ELT переносит проверки ближе к целевому хранилищу, что требует более развитых средств обеспечения качества внутри DWH.
-
Масштабируемость: ELT выгоден в средах с мощными хранилищами (например, облачными DWH), где вычисления можно масштабировать параллельно. ETL - подходящим образом работает там, где вычислительные ресурсы ограничены или где важна сборка сложной бизнес-логики вне DWH.
-
Время до аналитики: ELT часто сокращает время вывода новых метрик за счёт ускоренного развёртывания трансформаций непосредственно в целевом хранилище, особенно при использовании современных форматов данных и мощной параллельной обработки.
-
Разделение ответственности: в ETL процесс ETL-головной компонент отвечает за извлечение, трансформацию и загрузку, часто с сильной связью к инструментарию. В ELT ответственность перераспределяется: извлечение и загрузка делегируются источнику или инструменту загрузки, трансформации - сохраняются внутри DWH или аналитической среды.
Технологическая база
-
Применимые концепции: форматы файлов Parquet/ORC, схемы схлопывания, управление схемами, версионирование данных, idempotence загрузок.
-
Инструменты: для оркестрации чаще всего применяют открытые решения, такие как Apache Airflow, а для самих вычислений - движки SQL-скриптов внутри DWH или внешние вычислительные среды, поддерживающие pushdown.
-
Архитектура интеграции: в современных стеке обычно существует слой Data Lake или Data Lakehouse, который выступает как лабиринт сырого и подготовленного данных, затем данные попадают в аналитическое хранилище. ETL чаще строится вокруг конвейеров загрузки в промежуточный слой с последующей трансформацией, ELT - вокруг загрузки в целевое DWH и посттрансформаций внутри него.
-
Примеры подходов и паттернов:
- ETL-пайплайн с централизованной трансформацией в ETL-инструменте: извлечение, очистка, обогащение в отдельном сервисе, загрузка в staging, затем загрузка в данные-слой.
- ELT-пайплайн с загрузкой в staging и пост-трансформациями в DWH: трансформации выполняются средствами DWH и/или внешних вычислительных кластеров, что обеспечивает гибкость и масштабируемость.
Пример кода
-- ETL: трансформации выполняются до загрузки в целевое хранилище
-- Псевдокод, иллюстрирующий подход
LOAD DATA INFILE 's3://data/raw_sales.csv' INTO TABLE staging_raw_sales;
## UPDATE staging_raw_sales
SET amount = COALESCE(amount, 0), tax = COALESCE(tax, 0);

## INSERT INTO dwh.fct_sales
SELECT sale_id, customer_id, amount, tax, date_key
FROM staging_raw_sales;
-- ELT: загрузка в сырой слой, трансформации выполняются внутри DWH
LOAD DATA INFILE 's3://data/raw_sales.csv' INTO TABLE raw.sales_staging;

## CREATE TABLE dwh.dim_date AS
SELECT DISTINCT date_key, date, year, month
FROM raw.sales_staging;

## CREATE TABLE dwh.fct_sales AS
SELECT s.sale_id, s.customer_id, s.amount, s.tax, d.date_key
## FROM raw.sales_staging s
JOIN dwh.dim_date d ON d.date = s.sale_date;
Преимущества ELT в контексте больших объёмов
- Гибкость разработки: новые показатели могут добавляться быстрее за счёт выполнения трансформаций в целевом хранилище без переработки внешнего ETL-слоя.
- Экономия на перемещении данных: данные загружаются без значительных преобразований, что снижает задержки на обработку и уменьшает сложность конвейера.
- Масштабируемость: современные DWH поддерживают параллельные вычисления, что оптимизирует работу с большими массивами данных и сложной бизнес-логикой.
Недостатки и риски ELT
- Качество данных требует более строгого контроля на уровне самого хранилища - иначе растет риск скрытых ошибок и несоответствий.
- Необходимость мощной вычислительной инфраструктуры внутри DWH, а также продуманной архитектуры индексов/материализованных представлений.
- Сложности управления зависимостями: трансформации внутри DWH могут создавать циклы исполнения и трудности в трассируемости.
Pushdown-процессы и их влияние на производительность
Pushdown - это способность перенести вычисления ближе к данным, чтобы уменьшить объем перемещаемых данных и ускорить обработку. В контексте интеграции ELT/ETL pushdown применим к нескольким уровням конвейера:
- Predicate pushdown: фильтры и условия отбора применяются на источнике данных или ближайшем к нему уровне, чтобы вернуть только релевантные записи.
- Projection pushdown: выбор только нужных столбцов, что снижает объем передаваемых данных.
- Function pushdown: вычисления функций и агрегатов выполняются на ближайшем источнике или в самом хранилище, если оно поддерживает соответствующие операции.
- Pushdown в оптимизаторах: современные движки SQL включают оптимизаторы, которые автоматически пытаются перенести вычисления в источники данных, например, в колоночные базы данных или облачные DWH.
Зачем это нужно
- Снижение сетевых затрат: меньшая передача данных по сети.
- Скорость загрузки: меньшее количество данных, которые нужно обработать в целевой системе.
- Снижение нагрузки на центральный ETL/обработчик: упор на простые, эффективные операции, которые можно перенести.
Где применим pushdown
- В источниках, поддерживающих вычисления (например, внешние базы данных, ленточные хранилища с вычислительным оптимизатором).
- В облачных DWH и аналитических платформах, которые поддерживают перенесение фильтров и агрегаций на хранение (например, парадигмы predicate/projection pushdown в Snowflake, BigQuery, ClickHouse).
Риски и ограничения
- Не все операции можно пушить: сложные пользовательские функции, недоступные плагины и нестандартные типы данных часто требуют локальных вычислений внутри DWH.
- В некоторых сценариях pushdown может приводить к перегреву источника данных и ухудшению управляемости, особенно если источники не поддерживают необходимый уровень параллелизма.
- Версионирование и совместимость: обновления источников могут ломать существующие стратегии pushdown; необходима регламентированная поддержка совместимости между версиями.
Практические рекомендации
- Начинайте с анализа запросов: какие фильтры и проекты чаще всего применяются к данным? Эти элементы - кандидат на pushdown.
- Определите точки контроля качества: какие вычисления требуют явной валидации и не могут быть делегированы источнику.
- Включайте мониторинг pushdown-эффективности: измеряйте время выполнения, объем переданных данных, расход ресурсов.
- Учитывайте особенности платформы: некоторые DWH и движки дают больший контроль над pushdown, чем другие; оптимизация должна строиться вокруг конкретной технологической архитектуры.
Интеграционные протоколы и схемы обработки
Эффективная интеграция требует согласованности между источниками данных, конвейерами загрузки и целевым хранилищем. В рамках этой секции рассмотрены ключевые схемы обработки и протоколы взаимодействия между компонентами.
- Батчевые конвейеры: традиционные конвейеры загрузки для больших партий данных с периодической периодизацией (ежедневно, почасово). Применяются в случаях, когда задержка допустима и объем данных предсказуем.
- Стриминг и микропакеты: обработка потоковых данных в реальном времени или близко к ним. Позволяет снизить латентность, но требует более сложного управления консистентностью и качеством.
- Форматы данных: Parquet и ORC обеспечивают эффективную компрессию и столпную организацию данных, что улучшает производительность и pushdown. Avro - полезен для схемной эволюции и передачи схем.
- Контроль версий и схем: инструменты миграции схем, хранение версий таблиц, управление изменениями ETL/ELT-процессов. Включают схемы кросс-версионности и схемные эволюционные подходы.
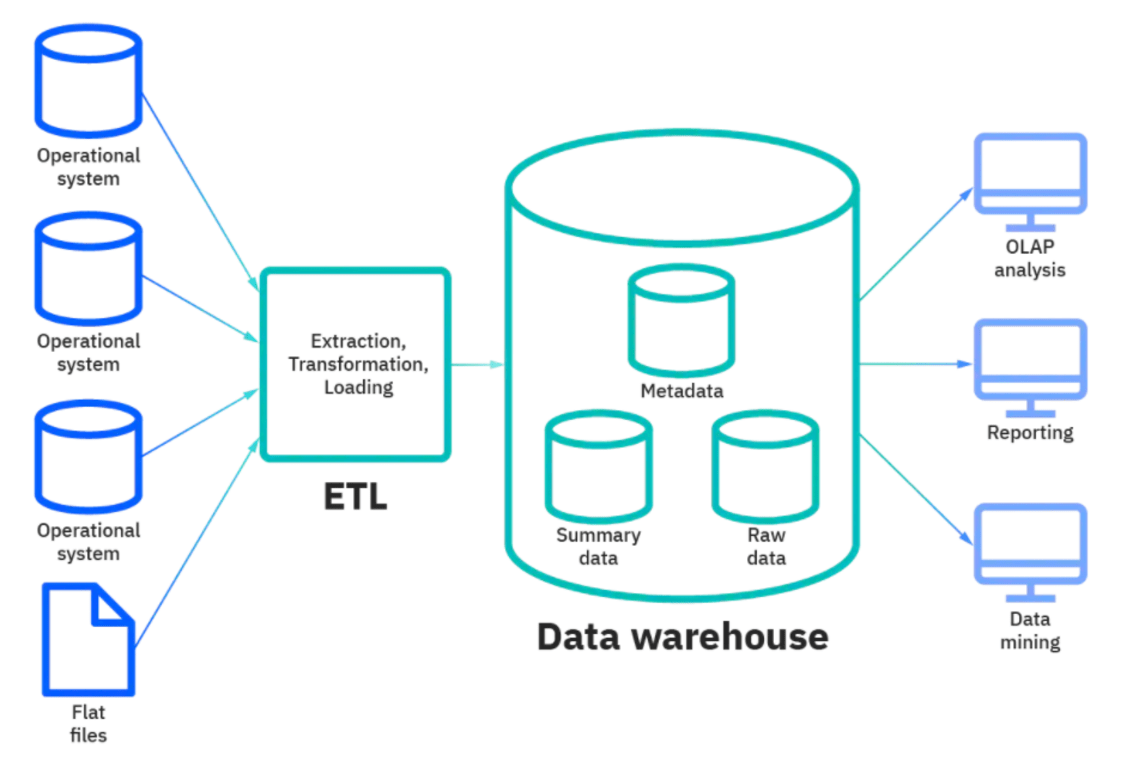
- Архитектура интеграции: слои источников, raw/staging, core/processed, а также витрины и marts. В рамках ELT во многих случаях staging действует как временная зона, где могут выполняться минимальные преобразования, после чего данные трансформируются внутри DWH.
Ключевые принципы
- Идёмпотентность процессов загрузки: повторная загрузка должна приводить к идентичному состоянию данных и не создавать дубликатов.
- Модульность: конвейеры должны быть разбиты на независимые, легко тестируемые блоки, что облегчает замену источников и адаптацию к изменениям.
- Контроль версий данных: сохраняйте метаданные о версиях данных и трансформациях, чтобы обеспечить воспроизводимость и трассируемость.
- Мониторинг и алертинг: автоматизированный мониторинг задержек, ошибок и цепочек зависимостей, в том числе мониторинг качества данных.
Инструменты и практики
-
Оркестрация процессов: Apache Airflow** - один из наиболее известных инструментов для планирования и контроля конвейеров. Он обеспечивает явные зависимости, повторяемость и мониторинг.
-
Форматы и движки: выбор Parquet/ORC форматов, которые хорошо сочетаются с pushdown-оптимизациями и эффективной компрессией.
-
Соединение источников и целевых систем: устойчивые коннекторы и адаптеры для обмена данными, обеспечение несложной миграции между источниками.
-
Пример архитектуры на практике:
В облачной среде можно рассмотреть схему, где данные поступают из операционных систем в файловые хранилища (например, S3/ADLS) в формате Parquet, затем загружаются в staging-сегмент DWH (ELT). После загрузки выполняются трансформации внутри DWH через материализованные представления и оконные функции, а конечные данные - в витринах или кубах для аналитики.
Практические подходы к выбору стратегии
При проектировании интеграционных конвейеров следует внимательно изучить требования к времени реакции, нагрузкам и качеству данных. Ниже приведены ключевые критерии и принципы принятия решений.
- Требования к задержке: если аналитика требует минимальной латентности, ELT в рамках мощного DWH может стать предпочтительным выбором, поскольку сокращает задержку между загрузкой и доступностью новых метрик.
- Нагрузка на источники: если источники данных ограничены ресурсами или требуется минимальная нагрузка на них, ETL может разгрузить источники за счет обработки на стороне ETL-инструмента.
- Гибкость эволюции показателей: ELT лучше поддерживает частую эволюцию бизнес-логики и добавление новых метрик без переработки внешнего ETL-подсистемы.
- Управление качеством данных: если критично поддерживать высокое качество на входе, ETL-подход может упростить реализацию комплексных правил в отдельном конвейере трансформации перед загрузкой.
- Совместимость и компетенции команды: выбор должен учитывать существующие компетенции по инструментарию, поддержке баз данных и практикам DevOps.
- Стоимость владения: ELT часто требует затрат на вычислительную мощность внутри DWH и более сложную инфраструктуру мониторинга, но может снизить стоимость переноса данных и ускорить аналитическую доставку.
- Риски миграции: переход на ELT может потребовать изменений в политике безопасности, управлении схемами и контроля доступа, а также последовательной миграции существующих конвейеров.
Рекомендации по внедрению
- Построение целевой архитектуры на основе зон данных: raw, processed, analytics, с четким разграничением привилегий и контроля доступа.
- Постепенная миграция: начинать с частичных проектов ELT в отдельных предметных областях, затем масштабировать.
- Внедрение механизмов контроля качества в каждый этап: энд-чейн валидации, тестирование данных и мониторинг.
- Определение правил pushdown: внедрять поэтапно, начиная с predicate и projection, оценивая влияние на источники и цену выполнения.
- Гарантии повторяемости: обеспечить идемпотентность загрузок и возможность повторного выполнения без ошибок.
- Поддержка версий схем: предусмотреть эволюцию схем без прерывания бизнес-процессов.
Реализация и пример архитектуры на практике
Рассмотрим сценарий внедрения ELT в гибридной облачной среде с использованием современного DWH и ориентирами на российские и открытые технологии. Архитектура включает:
-
Источники данных: операционная система, сторонние базы данных, файловые источники.
-
Слои загрузки: сырой слой (raw) и подготовленный слой (processed) в DWH, а также витрины для аналитики.
-
Оркестрация: Airflow обеспечивает расписания выполнения, контроль версий и зависимостей.
-
Обработчики: трансформации** - внутри DWH и частично в слоях обработки при необходимости.
-
Выгода такого подхода: скорость вывода бизнес-показателей и способность гибко адаптировать трансформации в рамках DWH, при этом сохраняя качество и согласованность данных.
-- ELT: загрузка в сырой слой и последующая трансформация внутри DWH -- 1) Загрузка сырого слоя LOAD DATA INFILE 's3://data/raw/orders.csv' INTO TABLE raw.orders_stg; -- 2) Трансформации внутри DWH ## CREATE TABLE dwh.dim_date AS SELECT DISTINCT order_date AS date_key, date_trunc('day', order_date) AS date FROM raw.orders_stg; ## CREATE TABLE dwh.dim_customer AS SELECT customer_id, upper(name) AS name, region FROM raw.orders_stg GROUP BY customer_id, name, region; ## CREATE TABLE dwh.fct_sales AS SELECT o.order_id, o.customer_id, o.amount, o.tax, d.date_key ## FROM raw.orders_stg o JOIN dwh.dim_date d ON o.order_date = d.date; -
В данном примере прослеживаются принципы ELT: данные загружаются в сырой слой, затем выполняются трансформации в DWH. Это обеспечивает гибкость для добавления новых показателей и адаптации логики трансформаций без изменения внешних конвейеров.
Мониторинг, качество данных и управление изменениями
- Контроль качества: внедрите валидаторы для входных данных, проверки целостности ключей и соответствия типов данных. Регулярно запускайте регрессионное тестирование трансформаций.
- Трассируемость: ведите журнал версий схем и трансформаций, фиксируйте зависимые объекты (таблицы, представления) и их версии.
- Мониторинг конвейеров: отслеживайте задержку между источником и целевым хранилищем, частоту ошибок и стабильность трансформаций; используйте алерты и дашборды.
- Управление изменениями: регламентируйте миграции схем и конвейеров, внедряйте процесс ревью и тестирования новых трансформаций до развёртывания в продуктив.
Key takeaways
- ELT и ETL - две парадигмы загрузки с разной политикой трансформаций; выбор зависит от требований к скорости, масштабу и качеству данных.
- Pushdown-процессы позволяют переносить вычисления ближе к данным, уменьшая сетевые издержки и улучшая производительность, но требуют осторожного управления и поддержки со стороны источников.
- Архитектура DWH должна включать слои сырого и обработанного данных, допускающую гибкую эволюцию трансформаций и удобную трассируемость.
- Батчевые и стриминговые схемы обработки должны подбираться под бизнес-логики и SLA; ELT по преимуществу хорошо работает в сочетании с современными DWH и формати Parquet/ORC.
- Оркестрация, контроль качества и мониторинг критически важны для устойчивой интеграции больших объёмов данных.
- Выбор стратегии требует учета компетенций команды, финансовых ограничений и инфраструктурных возможностей, а миграцию нужно проводить поэтапно.
- Интеграционные паттерны и форматы данных должны поддерживать версионирование, идемпотентность и повторяемость конвейеров.
FAQ
- Что такое ELT и ETL и чем они отличаются?
- ETL означает извлечение, трансформацию и загрузку. Трансформации выполняются вне целевого хранилища, в отдельном промежуточном слое, после чего данные загружаются в DWH. ELT означает извлечение, загрузку и трансформацию внутри целевого хранилища; первичная загрузка производится без значительных преобразований, а преобразования выполняются уже в DWH. Основная разница - где выполняются вычисления и какие ресурсы задействованы для трансформаций.
- В каких случаях предпочтителен ELT?
- Когда целевое хранилище обладает мощной вычислительной инфраструктурой, поддерживает эффективные механизмы pushdown и параллелизм, и бизнес-требования допускают гибкость в развитии трансформаций в DWH. ELT подходит для крупных объемов данных и быстрого вывода новых метрик.
- Что такое pushdown и как он влияет на производительность?
- Pushdown - перенос вычислений ближе к источнику данных, чтобы уменьшить передачу данных и ускорить обработку. Влияет на производительность за счет снижения объема передаваемых данных и выполнения сложных операций в местах с оптимизированными механизмами выполнения. Однако не все операции можно pushdown; требует поддержки со стороны источников и хранилища.
- Какие риски сопутствуют ELT?
- Необходимость сильного контроля качества на уровне DWH, рост требований к вычислительной мощности и сложность управления зависимостями между трансформациями. Также возрастает зависимость от корректной работы оптимизаторов и возможностей источников.
- Как определить, какие операции следует pushdown?
- Начните с фильтров и проекций: чаще всего они дают наибольший эффект. Далее рассмотрите агрегации и функции, доступные в источнике. Непременно проверьте, что результаты совпадают с ожидаемыми и что производительность улучшилась без ущерба для качества данных.
- Какие форматы данных наиболее эффективны в контексте ELT/Pushdown?
- Parquet и ORC - столбцовые форматы с хорошей компрессией и ускорением операций чтения; они облегчают pushdown и ускоряют аналитические запросы. Avro полезен для схемной эволюции и передачи схем вместе с данным.
- Какие организационные изменения требуются при переходе на ELT?
- Необходимо усиление роли DevOps и мониторинга конвейеров, расширение компетенций по SQL-анализу внутри DWH, интеграция контроля версий схем и бизнес-логики, а также выстраивание процессов тестирования и аудита изменений.
- Какие технические риски следует учитывать при миграции на ELT?
- Риск перегрева вычислительных узлов в DWH, несогласованность трансформаций, проблемы с идемпотентностью и повторяемостью загрузок, сложности в управлении межоперационными зависимостями.
- Как выбрать инструменты для orchestration и ETL/ELT?
- Ориентируйтесь на совместимость с существующей инфраструктурой, поддержке форматов данных и возможности масштабирования. Apache Airflow - популярное решение для оркестрации; выбор конкретного движка трансформаций зависит от ваших архитектурных потребностей и бюджета.
- Какие признаки указывают на необходимость пересмотра архитектуры загрузки?
- Рост времени выполнения конвейеров, увеличение затрат на обработку в промежуточных слоях, частые изменения бизнес-логики без отражения в ETL-процессах, проблемы с качеством данных и низкая предсказуемость сроков поставки аналитики.
Эта глава подчеркивает, что выбор между ETL и ELT, а также стратегия pushdown должны строиться на конкретной бизнес-цели, технической базе и организационных возможностях. Реализация требует постепенного внедрения, локального тестирования и постоянного мониторинга качества данных - все это обеспечивает устойчивую и масштабируемую интеграцию данных в современном DWH.


