

Планирование загрузок: расписания, режимы синхронизации и задержки
Планирование загрузок в системе интеграции данных представляет собой ключевой элемент устойчивой и предсказуемой эксплуатации платформы. Эффективная настройка расписаний, выбор режимов синхронизации и грамотное управление задержками позволяют обеспечить свежесть данных, минимизировать нагрузку на источники и обеспечить предсказуемые сроки выполнения ETL-процессов. В данной главе рассмотрены принципы архитектуры планирования в Airbyte, конкретные подходы к формированию расписаний, выбор режимов синхронизации и механизмы управления задержками, включая практические рекомендации по внедрению и мониторингу.
Планирование загрузок - это не merely расписания задач; это синергия между операционной дисциплиной, требованиями к данными и ограничениями инфраструктуры. В рамках этой главы освещаются архитектурные решения, лежащие в основе планирования, принципы выбора режимов синхронизации в различных сценариях, а также алгоритмы управления временем выполнения и задержками с целью достижения баланса между свежестью данных и устойчивостью системы.
- Ключевые концепции: согласованность данных, задержка исполнения, пропускная способность, устойчивость к сбоям.
- Архитектура планирования в Airbyte и интеграция с внешними оркестраторами.
- Рекомендованные практики по выбору режимов синхронизации и настройке задержек.
- Мониторинг, диагностика и способы адаптации расписаний в условиях изменений нагрузки.
Краткое содержание главы
- Архитектура планирования загрузок и роль компонента планировщика в Airbyte и сопутствующих оркестраторах.
- Расписания: cron-подобные выражения, временные окна, динамические расписания и учет временных зон.
- Режимы синхронизации: full_refresh, incremental и CDC, принципы выбора и влияния на планирование.
- Задержки и управление очередями: jitter, backoff, лимиты параллелизма и влияние на freshness данных.
- Управление зависимостями между коннекторами, интеграция с внешними оркестраторами и сценарии эксплуатации.
- Мониторинг эффективности загрузок: метрики, алерты, анализ сбоев и оптимизация расписаний.
Архитектура планирования загрузок
Архитектура планирования в Airbyte строится вокруг трех основных компонентов: планировщика задач, исполнителей загрузок и хранилища метаданных. Планировщик принимает входящие параметры: источник данных, целевую систему, режим синхронизации, расписание и дополнительные настройки. На основе этих данных формируются задачи (jobs), которые помещаются в очередь и распределяются по рабочим процессам исполнительной подсистемы.
Ключевые принципы архитектуры:
- Согласованность и идемпотентность. Каждое повторное выполнение должно приводить к одному и тому же результату, чтобы повторные попытки не приводили к неконсистентности или дублированию данных. Реализация идемпотентности требует четкого определения ключей операций, использования state-объектов и аккуратной обработки ошибок.
- Модульность и расширяемость. Планировщик должен поддерживать как встроенные механизмы Airbyte, так и внешние оркестраторы (например, Airflow, Dagster, Prefect). Архитектура должна позволять замещать или дополнять конкретные модули (расписания, очереди, обработку ошибок) без глобального влияния на систему.
- Вариативность загрузок. Архитектура должна корректно обрабатывать параллельные задачи для разных коннекторов, учитывая ограничения источников и сетевой инфраструктуры, а также зависимости между коннекторами, когда результаты одной загрузки необходимы другой.
- Учет времени и зоны. Планировщик должен точно поддерживать временные зоны, переходы на летнее время и смену календарей, что особенно критично для глобальных операционных режимов.
На уровне реализации архитектура может включать в себя состояние расписания, хранение модуля очередей, алгоритмы подбора следующей задачи, обработку задержек и повторных попыток. Взаимодействие с внешними оркестраторами реализуется через API-интерфейсы, которые предоставляют три функции: запуск задачи, мониторинг статуса и регистрацию завершения. Такая интеграция позволяет разделять ответственность между планированием и выполнением, обеспечивая гибкость и устойчивость к изменениям в бизнес-логике и инфраструктуре.
Встроенные механизмы планирования Airbyte должны поддерживать следующие возможности: определение частоты загрузок, настройку окна времени, выбор режима синхронизации, передачу параметров коннектору и указание зависимостей. В контексте архитектуры следует уделить внимание стратегиям задержек (backoff, jitter), обработке ошибок и повторных попытках, а также механизмам приоритизации задач и ограничению параллелизма. Эффективная архитектура обеспечивает предсказуемые сроки выполнения, но также должна быть адаптивной к изменениям нагрузки и измененным требованиям к данным.
Подходы к расписаниям
Расписания формируют основу планирования и должны учитываться на уровне глобальной политики загрузок и на уровне конкретного коннектора. Существует несколько базовых подходов, которые можно адаптировать под требования бизнеса:
- Фиксированные расписания. Рутинные загрузки выполняются по заданной периодичности: каждые N минут/часов или в конкретные временные интервалы. Такой подход обеспечивает простоту и предсказуемость, но может приводить к пиковым нагрузкам и задержкам в периоды высокой активности источников.
- cron-подобные выражения. Гибрид фиксированных расписаний с возможностью более точной спецификации временных окон. Cron-выражения позволяют задать сложные схемы повторений, например, загрузку каждый рабочий день в 02:00, с повторением через каждые 4 часа в отдельных окнах. Этот подход лучше подходит для сценариев с различной активностью источников в разные дни недели.
- Временные окна и окна загрузок. Определение конкретного окна времени, в течение которого выполняются загрузки, например, ночью или в начале суток. Такой подход уменьшает конкуренцию за ресурсы и снижает влияние на источники, которые чувствительны к нагрузке.
- Динамические расписания. Расписания могут адаптироваться в зависимости от внешних факторов: объема данных, задержек предыдущих загрузок, предупреждений о сбоях. Например, в случае задержки по данным в одном источнике можно расширить окно на следующий период или перенести выполнение на более позднее время.
- Зависимости и оркестрация. Некоторые коннекторы требуют последовательности выполнения (например, сначала загрузка сырьевых данных, затем аггрегации и загрузка в хранилище). В таких случаях расписания строятся с учетом графа зависимостей, чтобы обеспечить корректную последовательность и актуальность данных.
Учет временных зон является критическим аспектом, особенно в глобальных средах. Все расписания следует хранить в глобальном каноническом формате времени (обычно UTC) и на стороне исполнителя приводить к локальным временным зонам в зависимости от требования конкретного источника или целевой платформы. Это обеспечивает точную привязку к бизнес-окнам и минимизирует риск рассинхронизации данных между регионами.
Режимы синхронизации: full_refresh, incremental и CDC
Режим синхронизации определяет, как данные извлекаются и обновляются в целевой системе. В Airbyte для каждого коннектора может быть выбран один или несколько режимов:
- Full refresh. В рамках этого режима выполняется полная загрузка всех данных за каждый запуск, после чего целевой набор данных заменяется новым. Такой подход прост в реализации и обеспечивает чистую консистентность, но может быть дорогим по времени и ресурсам для больших объемов данных.
- Incremental. При инкрементной загрузке извлекаются только новые или изменившиеся данные, которые затем добавляются к существующему набору в целевой системе. Этот режим требует поддержки механизмов инкрементального извлечения, таких как указатель/курсор или отметка времени последнего обновления.
- Change Data Capture (CDC). CDC отслеживает изменения в источнике в реальном времени или близко к нему и реплицирует их в целевую систему. CDC обеспечивает наименьшую задержку и высокую актуальность, но требует дополнительной инфраструктуры и поддержки со стороны источника и коннектора.
Выбор режима зависит от бизнес-требований к свежести данных, ограничений источников и целевых систем, а также от сложности трансформаций. В контексте планирования загрузок режимы влияют на стратегию расписаний: CDC требует более высокой частоты обновлений и более быстрой реакции на события, тогда как full_refresh может быть безопасной базовой стратегией для источников с медленной изменчивостью данных. Incremental - компромиссный подход, подходящий для большинства систем, когда поддерживается корректная обработка уникальности и целостности ключевых полей.
Имеются практические аспекты, которые следует учитывать при выборе режима. Во-первых, наличие корректной информации о ключевых полях и их неизменности критично для корректной работы incremental и CDC. Во-вторых, целевые системы должны поддерживать обновление данных без дублирования - например, через upsert-операции или поддержку естественных ключей. В-третьих, синхронизация с CDC может потребовать более сложной обработки ошибок и более точной идентификации источника изменений, что влияет на архитектуру планирования и мониторинга.
Задержки и управление очередями
Задержки между планированием и выполнением загрузок, а также задержки между последовательными запусками, существенно влияют на freshness данных и пользовательское восприятие актуальности информации. Эффективное управление задержками включает несколько аспектов:
- Jitter. Введение небольшого случайного распределения времени начала задач помогает равномерно распределить нагрузку между параллельно выполняемыми задачами и снизить риск перегрузки источников в пиковые интервалы.
- Exponential backoff. При сбоев повторные попытки следует выполнять с возрастающей задержкой. Это снижает риск истощения источников и сетевого оборудования и позволяет системе восстанавливаться после временных проблем.
- Ограничение параллелизма. Контроль числа одновременных загрузок предотвращает переполнение целевых систем и сетевых каналов. Реализация верхнего предела параллелизма должна учитывать зависимость между коннекторами и доступные ресурсы.
- Очереди и буферы. Использование очередей позволяет аккуратно мигрировать данные из планирования в исполнение, обеспечивая плавность нагрузки и возможность масштабирования без потери управляемости.
- Тайм-за-данные (time-to-live) и лимит задержки. Установление лимитов задержки между расписанием и фактическим выполнением помогает поддерживать заданный уровень актуальности и позволяет оперативно реагировать на изменения условий.
Управление задержками требует баланса между желаемой свежестью данных и ограничениями инфраструктуры. В контексте планирования следует формулировать сигналы для динамической адаптации задержек: метрики задержек, количество пропущенных запусков, статистика ошибок, текущий уровень занятости очередей. Важно сохранять прозрачность для операторов: какие задержки применяются, какие параметры эксплуатируются и как быстро система может вернуться к нормальному режиму после сбоев.
Управление зависимостями и координация между коннекторами
Зависимости между коннекторами требуют координации и корректной очередности выполнения. В рамках планирования необходимо:
- Выстраивание графа зависимостей. Определение порядка выполнения задач обеспечивает корректное движение данных от источника к целевой системе. Это особенно важно, когда результат одной загрузки служит входом для другой (например, сначала загрузка сырых данных, затем их трансформации и загрузка в аналитическое хранилище).
- Обеспечение атомарности в рамках зависимостей. При наличии нескольких связанных коннекторов следует рассмотреть возможность группирования задач в атомарные единицы исполнения, чтобы избежать частичной загрузки и несогласованности.
- Обработка конфликта ресурсов. При параллельной работе нескольких коннекторов с общими источниками или целями необходимо внедрить механизмы задержек и ограничений, чтобы избежать перегрузки источников и сетевых каналов.
- Синхронизация версий схем. При изменении схем коннекторов важно синхронизировать требования к данным между зависимыми задачами и поддерживать совместимость схемных изменений.
Интеграция с внешними оркестраторами позволяет разделить ответственность за граф зависимостей на уровне бизнес-процессов и прочих доменов данных. В такой архитектуре планировщик Airbyte взаимодействует с оркестратором через контрактные интерфейсы, позволяя задавать зависимости, триггеры и источники событий. Это обеспечивает более гибкое управление сложной сетью загрузок и расширение возможностей мониторинга и устранения неполадок.
Взаимодействие с внешними оркестраторами
Интеграция с внешними оркестраторами часто становится естественным продолжением эволюции планирования. Основные принципы:
- Триггеры на уровне событий. Внешний оркестратор способен инициировать загрузку в Airbyte в ответ на события: обработку файла, загрузку в staging-слой, появление новой версии данных и т. п. Это обеспечивает более оперативную реакцию на изменения в источниках данных.
- Графы зависимостей на уровне оркестратора. Оркестратор позволяет централизованно описывать зависимости между множеством коннекторов и доменов данных, сохраняя логику планирования независимо от реализации конкретного коннектора.
- Управление повторными попытками и просмотр статуса. Оркестратор обеспечивает единый механизм повторных попыток и единый взгляд на статус загрузок, что упрощает диагностику и обслуживание.
- Совместная обработка ошибок. При интеграции следует явно определить поведение систем в случае сбоев: когда применяется повторная попытка, какие алерты формируются и какие данные считаются терпимыми к задержке.
Подобная интеграция улучшает гибкость планирования и позволяет адаптировать операционные режимы к изменяющимся требованиям бизнеса и инфраструктуры. В то же время необходимо обеспечить согласование политик безопасности, конфиденциальности и доступа между системами, участвующими в оркестрации.
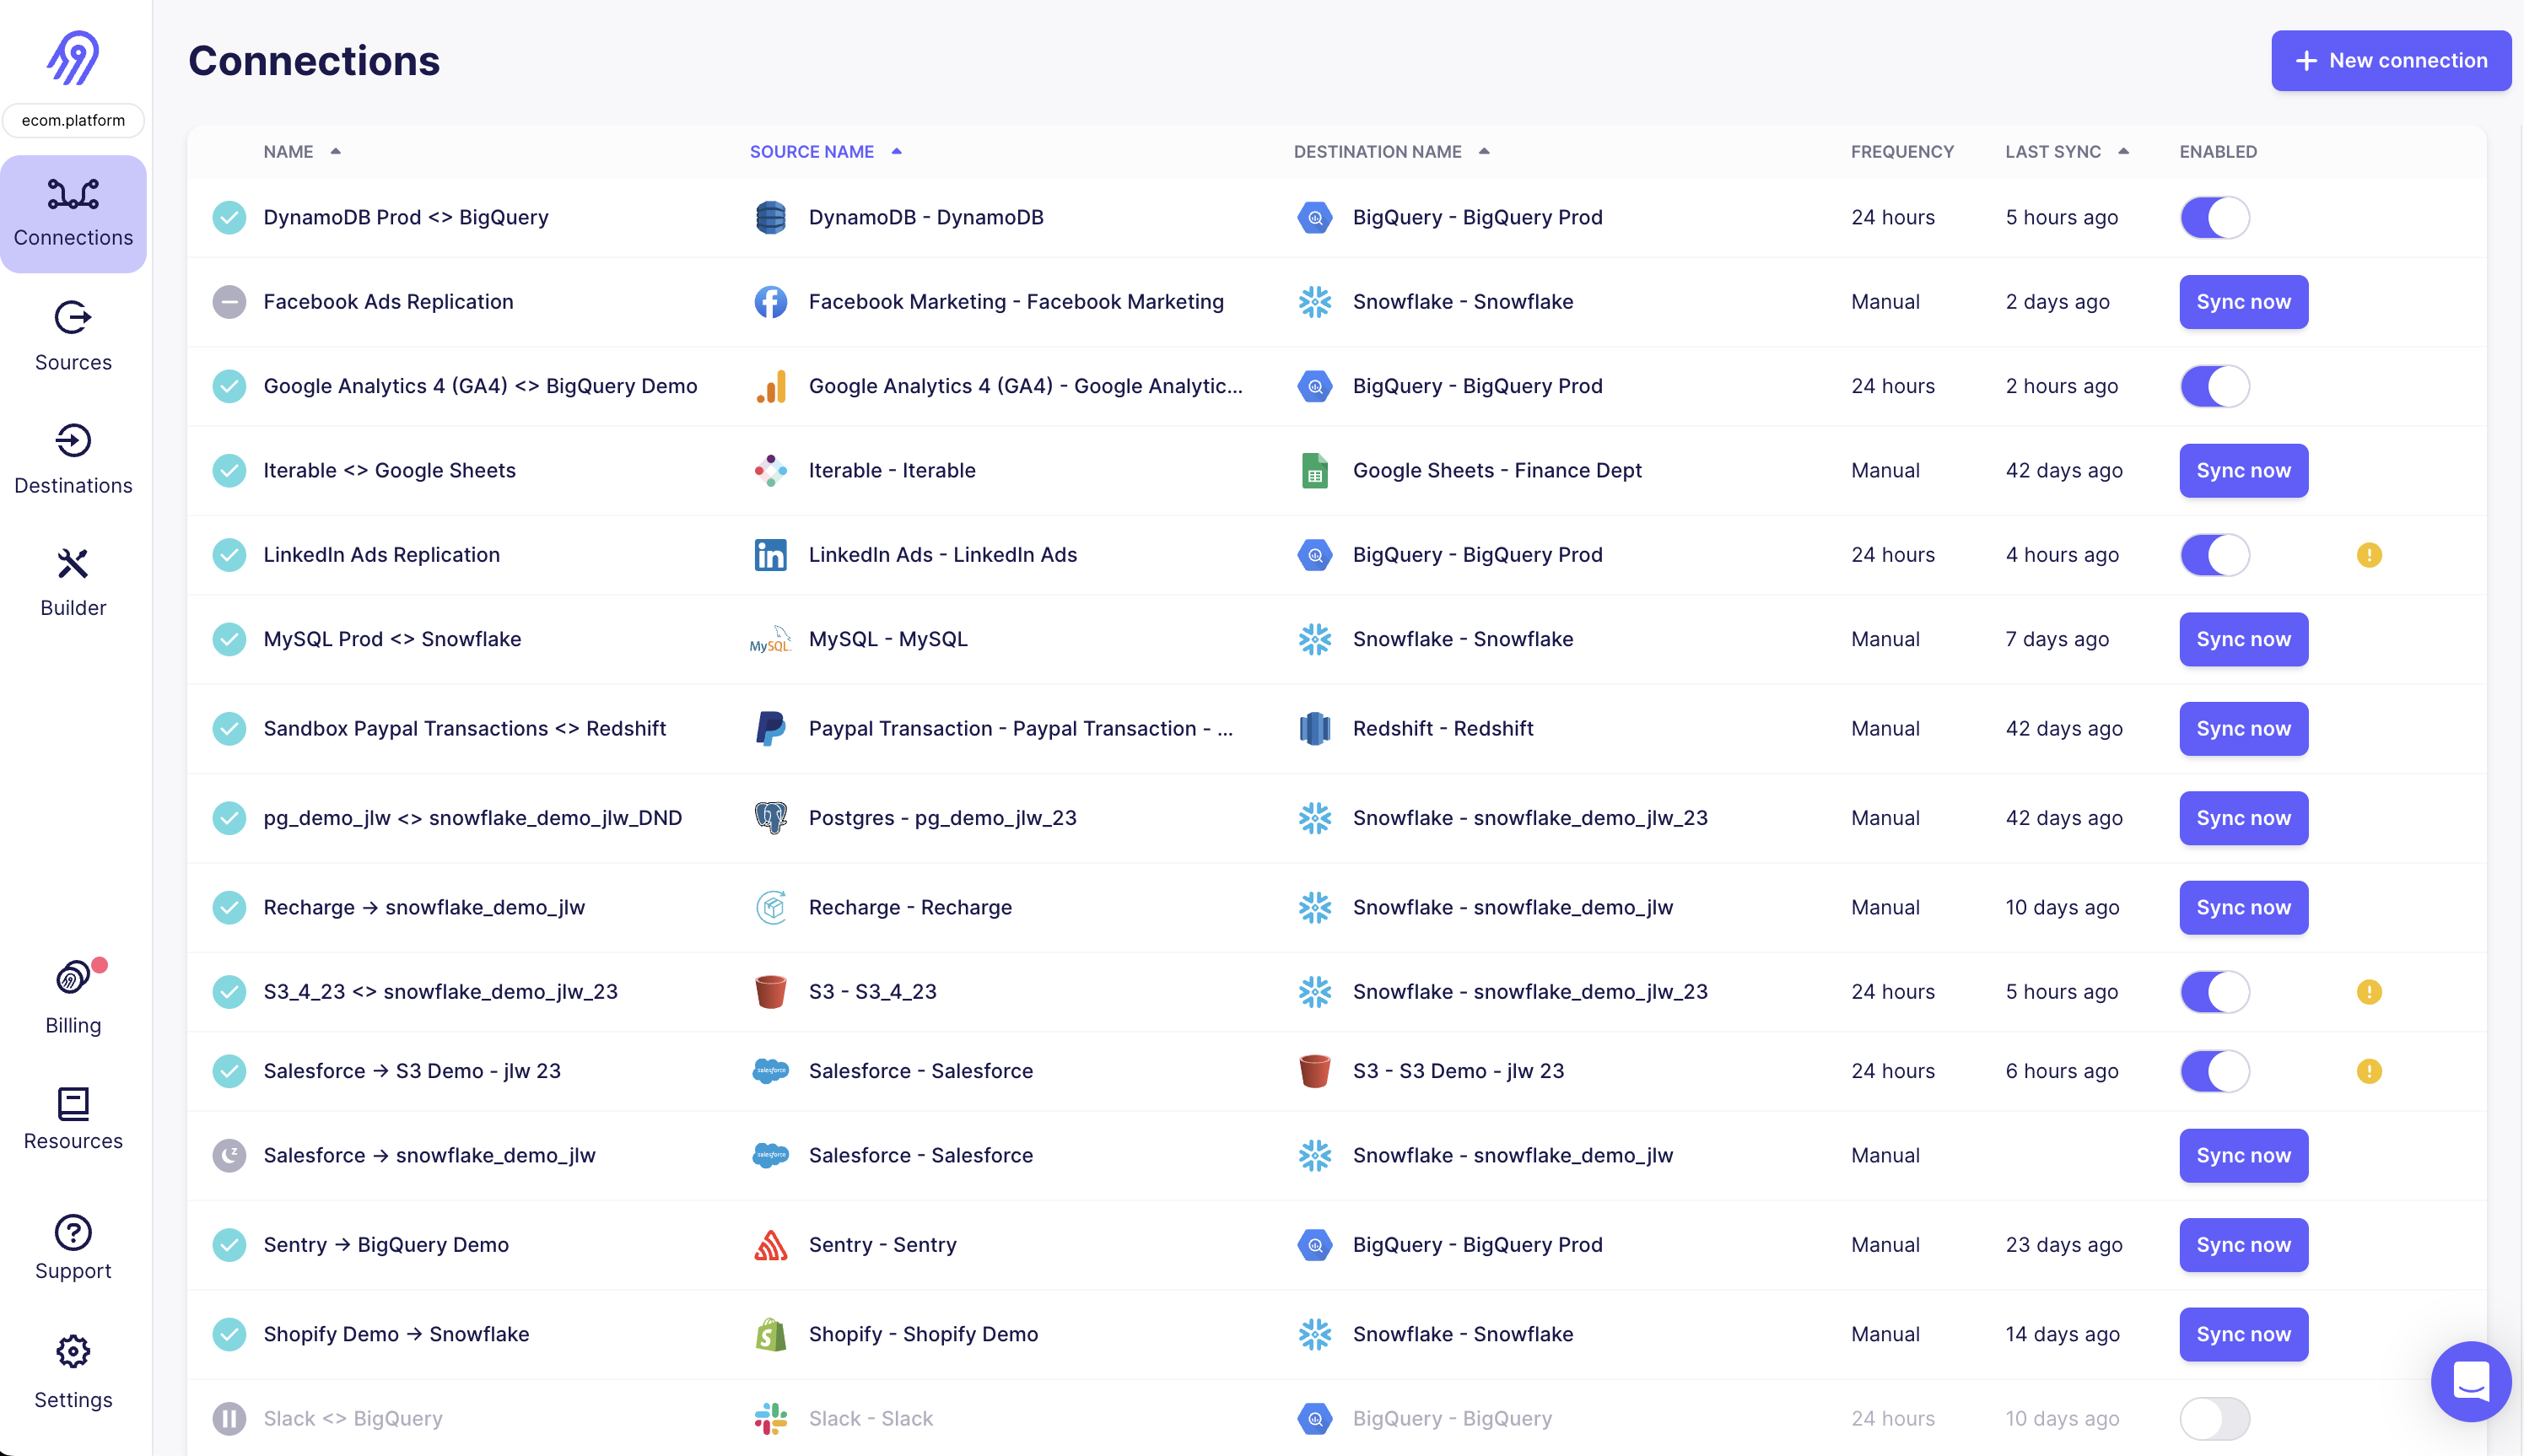
Мониторинг эффективности загрузок и диагностика
Эффективное планирование невозможно без мониторинга и ясной картины того, как работают загрузки. Основные показатели включают:
- Время выполнения задач и задержки. Время от планирования до завершения загрузки и средняя задержка для критических коннекторов.
- Нагрузка на источники. Пиковые периоды и распределение запросов по времени, чтобы избежать перегрузок.
- Время простоя и доля успешных запусков. Процент успешных загрузок и частота сбоев.
- Лаг данных (data lag) и "freshness". Расстояние между актуальным состоянием источника и тем состоянием данных, которое присутствует в целевой системе.
- Пропускная способность и эффективность использования ресурсов. Объем обработанных данных за единицу времени и соотношение между планируемым и фактически выполненным объемом.
- Доля повторных попыток и средняя задержка повторов. Частота сбоев и скорость восстановления после ошибок.
Для корректного мониторинга следует внедрить единый канон метрик: стандартизированные названия метрик, консистентные единицы измерения и понятные пороги. Важна возможность аггрегировать показатели по источникам, целевым системам и доменам данных, что позволяет выявлять узкие места и приоритезировать работу над улучшениями.
Диагностика проблем включает следующие этапы: сбор логов и трассировок, анализ временных окон и очередей, проверка зависимостей и соответствие режимов синхронизации, тестирование на тестовых данных и проверку изменений в схемах коннекторов. Важно поддерживать режим доступности сведений об ошибках и рекомендациях по устранению. Это ускоряет восстановление и снижает риск повторения аналогичных сбоев в будущем.
Практические сценарии реализации
Рассмотрим несколько типовых сценариев, иллюстрирующих подходы к планированию загрузок на практике.
- Сценарий 1: Регулярные инкрементальные загрузки с минимальной задержкой. В рамках этого подхода используется incremental режим для большинства источников, запуски происходят по cron-расписанию с малыми интервалами и jitter-ом. Важно определить корректные курсоры и методы обработки пропусков, чтобы не пропускать данные или дублировать их.
- Сценарий 2: Ночной цикл для крупных источников, с ограничениями на нагрузку. Встречаются периоды, когда источники чувствительны к нагрузке. Используется временное окно ночью, чтобы снизить влияние на источники и минимизировать задержки между этапами загрузки.
- Сценарий 3: CDC-реактивность для бизнес-подразделений. Когда требуется высокая актуальность, применяется CDC-режим с частыми триггерами и минимальной задержкой. Планирование включает максимально допустимый уровень параллелизма и детальные правила обработки ошибок.
- Сценарий 4: Взаимозависимые домены данных. Для аналитических сценарием домены данных строят граф зависимостей, где загрузка витрин данных инициируется после завершения загрузок сырья. Оркестратор реализует сложные зависимости и информирует об изменениях в графе.
## Пример конфигурации для внешнего оркестратора (упрощенная иллюстрация)
## Используется для демонстрации концепции триггирования и зависимостей
dag:
  name: data_sync_salesforce_to_warehouse
  schedule_interval: "0 2 * * *"
  timezone: UTC
  tasks:
    - **id**: extract_salesforce
      type: connector_run
      connector: salesforce
      sync_mode: incremental
      max_retries: 5
      retry_backoff: 300
    - **id**: transform_and_load
      type: transform_and_load
      dependencies: [extract_salesforce]
      target: data_warehouse
Приведенный пример иллюстрирует базовую концепцию: расписание задает окно выполнения, задачи задаются с зависимостью, а повторные попытки включены для устойчивости к временным сбоям. В реальном проекте конфигурация будет значительно более детализированной и будет соответствовать конкретной технологии оркестратора и целевой инфраструктуре. Важно помнить, что конкретика конфигураций зависит от выбранного стека и инфраструктуры, и любые примеры должны сопровождаться документацией по интеграции и политиками безопасности.
Key takeaways
- Планирование загрузок - это баланс между свежестью данных и устойчивостью системы: выбор расписаний и режимов синхронизации напрямую влияет на задержку, нагрузку на источники и качество данных.
- Архитектура планирования должна быть модульной и гибкой: возможность интеграции с внешними оркестраторами и поддержка идемпотентности критичны для масштабируемых проектов.
- Расписания требуют учета временных аспектов: временные зоны, переходы на летнее время и согласование бизнес-окнов - обязательные элементы.
- Режимы синхронизации влияют на архитектуру планирования: выбор между full_refresh, incremental и CDC определяет частоту, глубину и ресурсы, необходимые для загрузок.
- Управление задержками - ключ к контролируемой fresherness и предсказуемости: jitter, backoff и ограничение параллелизма позволяют эффективно расправляться с неопределенностями нагрузки.
- Зависимости между коннекторами требуют ясной координации и графа зависимостей: корректная последовательность задач предотвращает рассогласование данных.
- Мониторинг и диагностика должны быть встроены в процесс планирования: метрики времени, задержек, нагрузки и ошибок позволяют своевременно реагировать и оптимизировать расписания.
FAQ
- Как выбрать режим синхронизации для конкретного коннектора?
- Выбор зависит от требований к актуальности данных и ограничений источника. CDC обеспечивает минимальную задержку и высокую актуальность, но требует поддержки источника и коннектора, а также дополнительной инфраструктуры. Incremental подходит для большинства сценариев, когда коннектор поддерживает корректный курсор и изменение поля-ключа. Full_refresh предпочтителен для источников с несовместимыми механизмами обновления или когда необходимо полное переинициализировать целевую систему. Важно проверить консистентность данных и возможность восстановления после сбоев в выбранном режиме.
- Как минимизировать задержки между планированием и выполнением?
- Применяйте небольшой jitter для равномерного распределения нагрузки, используйте динамическое масштабирование параллелизма и ограничение очереди. Для критичных источников можно увеличить приоритет задач и уменьшить интервалы между запусками, но контролируйте влияние на источники и целевые системы. Важно мониторить лаг и корректировать расписания на основе значений SLA.
- Как обеспечить согласованность данных при параллельной загрузке нескольких коннекторов?
- Определите граф зависимостей и устанавливайте атомарные группы задач там, где требуется согласованность. Используйте корректные схемы идентификации и upsert-операции в целевой системе. Применяйте механизмы очередей и очередей с приоритетами, чтобы критичные коннекторы не находились в состоянии гонки.
- Как обрабатывать сбои и повторные попытки в планировании?
- Применяйте экспоненциальный backoff и лимиты повторных попыток, фиксируйте максимально допустимое время ожидания и используйте контроль прерывания. Логи ошибок должны быть структурированы и передаваться в централизованный мониторинг. При повторном сбое рекомендуется рассмотреть изменение режимa синхронизации или корректировку расписания.
- Какие показатели мониторинга наиболее критичны?
- Время выполнения задач, задержка, лаг данных, доля успешных запусков, пропускная способность и количество повторных попыток. Также важно отслеживать время простоя и распределение нагрузки между источниками и целевыми системами.
- Как учитывать временные зоны и переходы на летнее время?
- Хранить расписания в UTC и конвертировать во временные зоны исполнителей по мере необходимости. При планировании учитывать переходы на летнее время и непостоянство локальных окон. Непрерывная документация политик по временам выполнения и единая конфигурация времени помогают поддерживать согласованность.
- Как интегрировать Airbyte с внешним оркестратором?
- Определите контрактные интерфейсы для запуска задач, мониторинга статуса и завершения. Используйте триггеры на события и графы зависимостей в оркестраторе для управления сложной логикой. Важно обеспечить согласование политик безопасности, доступа и монитора между системами.
- Как минимизировать влияние на источники данных во время загрузок?
- Применяйте временные окна, ограничение параллелизма и jitter для равномерного распределения нагрузки. Используйте режимы incremental или CDC там, где это возможно, чтобы снизить объем перемещаемых данных и нагрузку на источники.
- Какие подходы к тестированию расписаний на стадии разработки?
- Используйте среду тестирования планирования с моделированными нагрузками и данными. Валидируйте корректность графа зависимостей, проверяйте обработку сбоев и повторных попыток, тестируйте переходы между режимами синхронизации и сценарии восстановления.
- Какие лучшие практики по обеспечению идемпотентности загрузок?
- Стандартизируйте уникальные идентификаторы операций, используйте state-объекты и хранение контрольных сумм. Обновляйте целевые системы через upsert-операции или явные ключи, чтобы повторные запуски не приводили к дублированию. Документируйте политики обработки повторных попыток и обеспечения консистентности на уровне архитектуры.


