

Логирование, трассировка и диагностика распределённых задач
В распределённых потоковых системах, подобных Apache Flink, логирование и трассировка выступают в роли фундаментальных инструментов эксплуатации: они позволяют отслеживать поведение системы, выявлять узкие места и восстанавливать логику выполнения в сложных циклах обработки. Архитектура Flink разделяет ответственность между JobManager и TaskManager, что накладывает особые требования к сбору и корреляции журналов и трассировок: логи должны быть структурированными, контекст должен сохраняться на протяжении всей цепочки операторов, а трассировка - распространяться через границы задач и узлов. Глава систематизирует концепции, принципы реализации и операционные практики, позволяя перейти к конкретным настройкам и инструментам интеграции.
Логирование и трассировка - это не просто декларации о событиях. Это средство обнаружения причин отказов, понимания поведения под нагрузкой, контроля задержек и анализа поведения операторов. Глубокий подход к логированию, сопровождённый продвинутыми механизмами трассировки и централизованного сбора метрик, существенно повышает надёжность решений на базе Flink и ускоряет цикл диагностики и оптимизации.
- Архитектура и компоненты логирования и трассировки Flink
- Настройка журналирования и динамические изменения уровней
- Трассировка и интеграции с внешними системами мониторинга
- Диагностика и оптимизация производительности распределённых задач
Архитектура логирования и трассировки в Flink
Архитектура Flink предполагает наличие как локальных логов на уровне компонентов, так и возможности их агрегации в централизованные хранилища. Логи обычно пишутся отдельными процессами JobManager и TaskManager и содержат информацию о контексте выполнения: идентификатор работы (jobId), вершины графа обработки (vertexId), подзадачи (subtaskIndex) и попытке выполнения (attemptId). Эти поля становятся критически важными для корреляции между логами, когда система распределена по множеству узлов.
Дизайн трассировки в распределённых системах требует передачи контекста между задачами. Следовательно, трассировочные контексты должны распространяться через границы операторов Flink. В рамках современной экосистемы это реализуется с помощью стандартов распределённой трассировки (например, OpenTelemetry) и совместимых бэкендов (Jaeger, Tempo). В идеале каждый оператор порождает единицу рабочего контекста - span - и передаёт его вниз по цепочке обработки. Это позволяет восстанавливать полный путь обработки элемента данных и видеть задержки на конкретной операции и узле.
Практически архитектура включает следующие элементы:
- локальные журналы JobManager и TaskManager; хранение их в отдельных директориях, поддержка ротации и обеспечения согласованности времени;
- централизованный сбор логов и метрик через конвейеры (ELK/EFK, Loki, Prometheus);
- инфраструктуру трассировки и журналирования, которая обеспечивает корреляцию между логами и трассировками через общие идентификаторы и контекст;
- инфраструктуру для агрегации контекста выполнения (jobId, vertexId, subtaskIndex) в формате, пригодном для анализа через поиск и визуализацию.
Важно подчеркнуть: структурированное логирование и трассировка позволяют переходить от простого поиска по текстовым сообщениям к машинному анализу - фильтрации по полям, построению дашбордов и автоматическому обнаружению аномалий. В контексте Flink именно структурированные поля и пропорциональная детализация по задачам являются основой для эффективной диагностики в продакшн-кластерах.
Инструменты и форматы
Универсальная часть инфраструктуры включает набросанные принципы: унифицированный формат записей, наличие полей с контекстом выполнения, поддержка корреляционных идентификаторов и совместимость с внешними системами мониторинга. В реальных проектах чаще всего применяется сочетание:
- централизованный сбор логов: ELK/EFK или Loki;
- трассировка: OpenTelemetry в сочетании с Jaeger или Tempo;
- метрики: Prometheus и Grafana для визуализации.
OpenTelemetry выступает мостиком между кодом приложения и трассировочной инфраструктурой, позволяя унифицировать контекст и автоматически переносить его через границы задач. В качестве практического примера можно рассмотреть организацию корреляции через передачу traceparent и tracestate в рамках каждого сообщения, проходящего через оператор Flink. Это обеспечивает целостность трассировки от источника данных до конца конвейера.
Настройка логирования и динамические изменения уровней
Правильная настройка логирования начинается с выбора формата и уровней логирования для разных компонентов. В продакшн-среде целесообразно использовать информативный уровень INFO или WARN на стандартных операциях и DEV-уровень DEBUG только в рамках ограниченного времени для диагностики. Ключевое требование - обеспечивать включение достаточных полей контекста: jobId, vertexId, subtaskIndex, timestamp, correlationId. Такой подход облегчает последующий поиск по логам и связывает их с трассировками.
Стратегия конфигурации должна учитывать два момента:
- единая политика по логированию для JobManager и TaskManager;
- возможность временного повышения детализации без перезапуска кластера или с минимальной паузой.
Рекомендованные параметры конфигурации включают:
- включение детального формата сообщений и добавление контекстной информации;
- настройку ротации логов и размеров файлов;
- ограничение объёма логов для отдельных компонентов и указание путей хранения.
Ниже приведён упрощённый пример конфигурации формата журнала для иллюстрации (перед использованием адаптируйте под ваш стек логирования и версию Flink):
<Configuration status="WARN" >
  <Appenders>
    <Console name="Console" target="SYSTEM_OUT">
      <PatternLayout pattern="%d{ISO8601} [%t] %-5level %logger{36} [jobId=%X{jobId} vertexId=%X{vertexId} subtask=%X{subtaskIndex}] - %msg%n"/>
    </Console>
  </Appenders>
  <Loggers>
    <Root level="INFO">
      <AppenderRef ref="Console"/>
    </Root>
    <Logger name="org.apache.flink" level="DEBUG" additivity="false">
      <AppenderRef ref="Console"/>
    </Logger>
  </Loggers>
</Configuration>
В этой демонстрации используются стандартные поля MDC/адресуемые через маркеры контекста (jobId, vertexId, subtaskIndex). Реальные реализации могут задействовать и другие поля, например correlationId, workerNode, или пользовательские идентификаторы событий.
Динамическое изменение уровней логирования в продакшн-окружении часто осуществляется через:
- горячую перезагрузку конфигурации логирования (если поддерживается выбранным стеком);
- использование JMX/REST-интерфейсов для изменения уровня конкретного логгера;
- временную загрузку альтернативной конфигурации для конкретного периода.
Важно помнить: любые изменения уровней должны сопровождаться мониторингом влияния на производительность и объём логов, чтобы избежать перегрузки хранилища и задержек в обработке.
Трассировка и интеграции с внешними системами мониторинга
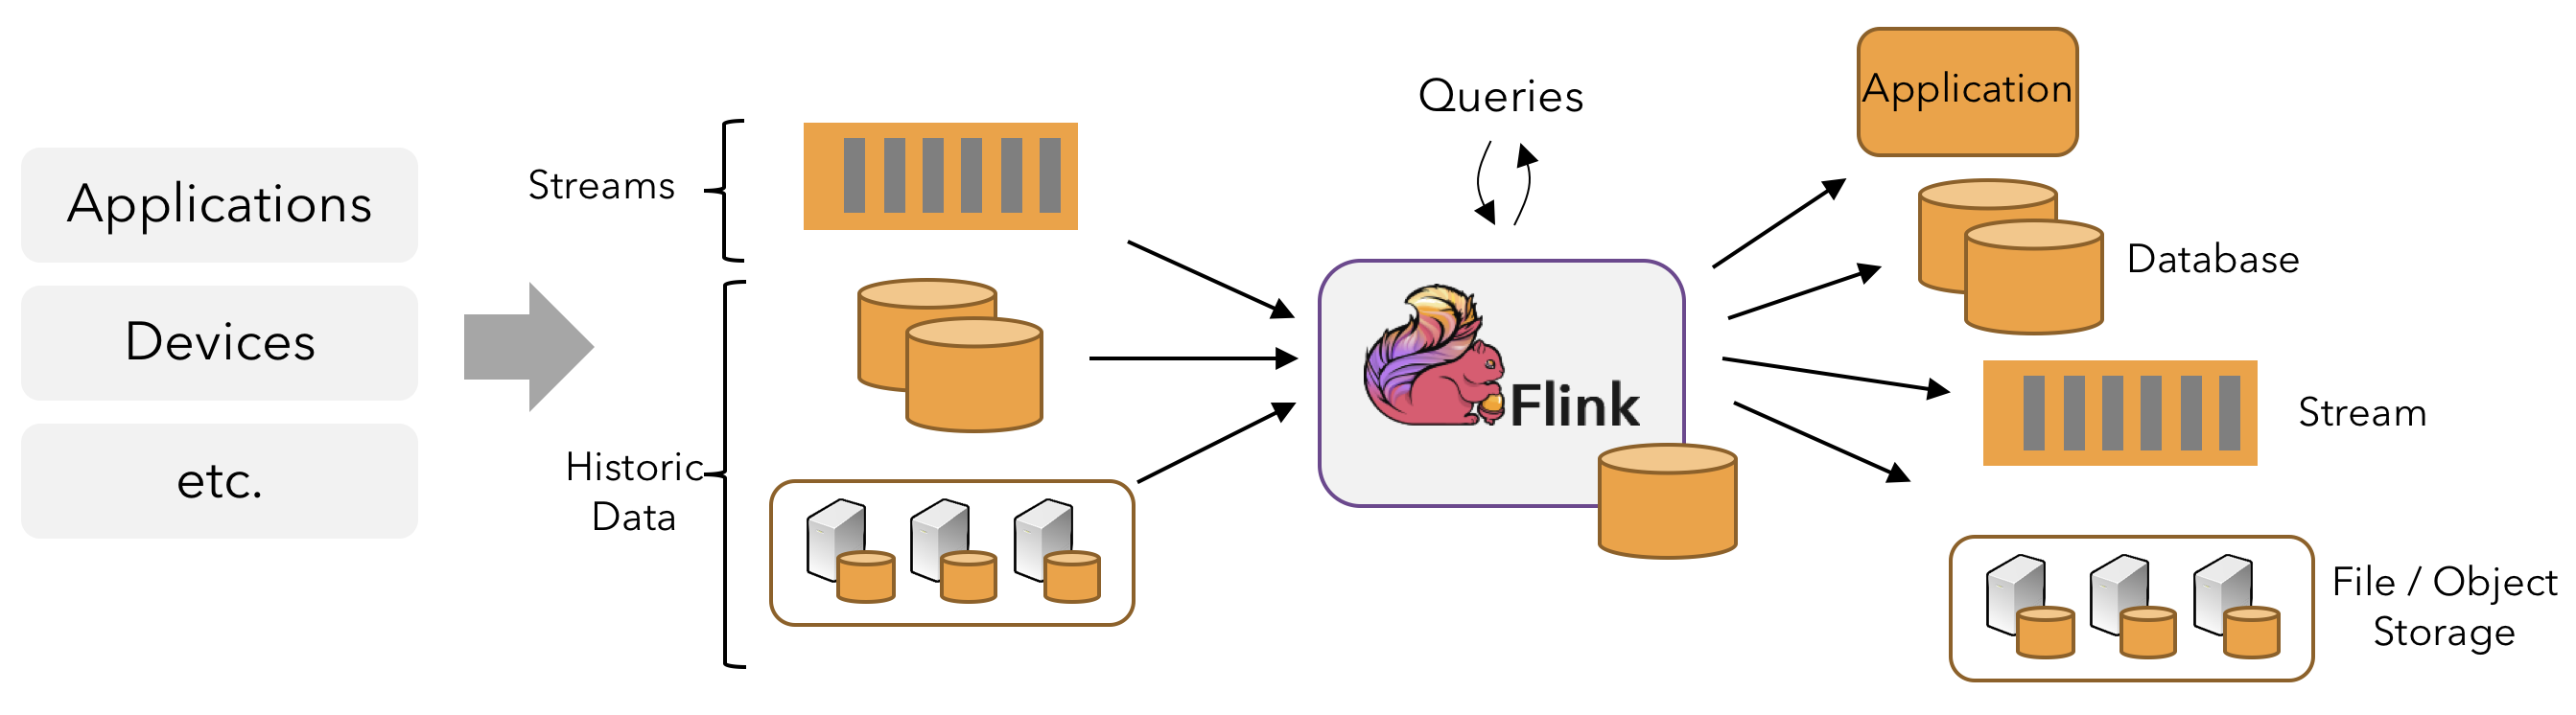
Реализация распределённой трассировки в Flink начинается с выбора бэкенда и протоколов передачи контекста. На практике чаще всего применяются OpenTelemetry в связке с Jaeger или Tempo, а также системами, поддерживающими OpenTelemetry Collector, которые принимают трассировочные данные и репортят их в целевые хранилища.
Типичные паттерны интеграции:
- Instrumentation на уровне операторов: создание span-ов для ключевых шагов обработки, установка родительских связей и добавление атрибутов, таких как jobId, vertexId, operatorName, данные о задержках, размер батча.
- Propagation контекста: перенос traceContext через границы задач с использованием стандартов W3C (traceparent, tracestate). Это обеспечивает непрерывную трассировку по всей цепочке обработки.
- Централизованный сбор: отправка трассировок в Jaeger, Tempo или иной backend через OpenTelemetry Collector или напрямую в бэкенд.
- Корреляция с логами: добавление к трассам ссылок на логи или использования MDC-поля, которое в связке позволяет быстро сопоставлять трассу и связанные логи.
Примеры инструментов и решений:
- OpenTelemetry - открытая платформа для распространённой трассировки и метрик; обеспечивает совместимость между языками и фреймворками.
- Jaeger - популярный бэкенд для трассировки, хорошо подходит для многоузловых кластеров.
- Tempo - облачный/самостоятельный сервис для трассировки, интегрируется через OpenTelemetry.
Простой пример кода на Java (упрощённая иллюстрация инструментирования в операторе Flink):
import io.opentelemetry.api.GlobalOpenTelemetry;
import io.opentelemetry.api.trace.Span;
import io.opentelemetry.api.trace.Tracer;

public class InstrumentedOperator {
  private static final Tracer tracer = GlobalOpenTelemetry.get().getTracer("flink-example");

  public void process(Item item) {
    Span span = tracer.spanBuilder("process-item")
                      .setAttribute("item.id", item.getId())
                      .startSpan();
    try {
      // основная логика обработки
    } finally {
      span.end();
    }
  }
}
В реальных условиях следует учитывать персистентность контекста между операциями: организация контекст-передачи через все участки конвейера, сохранение определённых атрибутов в каждом шаге и использование Propagators OpenTelemetry для передачи контекста через сетевые вызовы и сообщения между задачами.
Ещё один практический момент - настройка экспорта трасс в Jaeger/Tempo. Пример конфигурации для OpenTelemetry Collector (OTel Collector) может выглядеть так:
receivers:
  otlp:
    protocols:
      grpc: {}
      http: {}
exporters:
  jaeger:
    endpoint: "jaeger-collector:14250"
service:
  pipelines:
    traces:
      receivers: [otlp]
      exporters: [jaeger]
Этот конвейер позволяет централизовать трассировку и обеспечивать совместимость между различными языками и сервисами внутри экосистемы.
Диагностика и оптимизация производительности
Логирование и трассировка в большом объёме могут вносить ощутимую нагрузку на кластер. Поэтому важна стратегия балансировки информативности и производительности. Ниже приведены практические подходы к диагностике и оптимизации:
- Природа проблем: задержки в поставке данных, возрастание задержек между операторами, чрезмерная генерация логов на одном из узлов, пропадание метрик.
- Аналитика по логам: структурированные логи позволяют фильтровать по jobId, vertexId, субзадаче и временному диапазону, что упрощает выявление узких мест и повторяющихся ошибок.
- Взаимосвязь логов и трассировки: корреляция между трассировкой и логами позволяет точно определить, на каком шаге конвейера возникает задержка или ошибка.
- Мониторинг метрик: важно сочетать логи и трассировку с метриками (TPS, задержка, backlog, использование памяти/CPU, GC-времена) для комплексной картины производительности.
- Практические кейсы: анализ задержек в определённых операторах, обнаружение перегруженных задач, диагностика ошибок в рамках повторной обработки.
Ниже приводится пример конфигурации OpenTelemetry Collector для объединения трасс и экспорта в Jaeger иные бэкенды, который может быть адаптирован под конкретную инфраструктуру:
receivers:
  otlp:
    protocols:
      grpc: {}
      http: {}
exporters:
  jaeger:
    endpoint: "jaeger-collector:14250"
  logging:
    level: debug
service:
  pipelines:
    traces:
      receivers: [otlp]
      exporters: [jaeger, logging]
Важно помнить: корректная диагностика требует структурированной политики хранения логов и политики ретенции. Необходимо заранее определить сроки хранения, требования к доступу и стоимость передачи/хранения. В некоторых случаях полезна оффлоадинг-архивизация логов в долгосрочные хранилища, чтобы снизить нагрузку на активные ноды.
Key takeaways
- Логирование и трассировка являются критически важными для надёжной эксплуатации Flink: они позволяют отслеживать поведение, выявлять узкие места и связывать события внутри распределённого конвейера.
- Архитектура должна обеспечивать контекстовую корреляцию между логами и трассировками: jobId, vertexId, subtaskIndex и контекст выполнения должны присутствовать в сообщениях.
- Использование OpenTelemetry в сочетании с Jaeger или Tempo упрощает распределённую трассировку и интегрируется с централизованными конвейерами мониторинга.
- Логи должны быть структурированными и поддерживать динамическое изменение уровней без значительного влияния на производительность.
- Централизованные решения для логирования и трассировки (ELK/EFK, Loki; OTEl Collector + Jaeger/Tempo) позволяют эффективно масштабировать диагностику по кластеру.
- Диагностика должна сочетать анализ логов, трассировки и метрик: это ускоряет выявление причин задержек и ошибок.
- Практическая instrumentation требует минимизации накладных операций в hot-path и продуманной передачи контекстов между задачами.
- Планируйте хранение и ретензию логов: это критически влияет на стоимость и доступность исторических данных для анализа.
- Внедряемые решения должны быть совместимы с существующими процессами CI/CD и операционными процедурами, чтобы обеспечить повторяемость и контроль версий конфигураций.
- При интеграции с внешними системами следует учитывать безопасность и управляемость: контроль доступа к конфигурации, шифрование трафика и надлежащие политики мониторинга.
FAQ
- Что такое различие между логами и трассировкой, зачем оба инструмента нужны?
- Логи предоставляют детализированное текстовое описание событий внутри компонентов и задач. Трассировка - это распределённая карта поведения запроса через весь конвейер: цепочка вызовов и задержек между операциями. Оба инструмента дополняют друг друга: логи детализируют события, трассировка показывает путь выполнения и задержки по цепочке.
- Как обеспечить перенос контекста трассировки через все задачи Flink?
- Используйте стандарт OpenTelemetry и протоколы W3C (traceparent/tracestate) для передачи контекста через сообщения между операторами. Инструментирование операторов должно создавать span-ы и передавать контекст вниз по конвейеру, сохраняя родительские связи.
- Какие уровни логирования разумны в продакшн-среде?
- Обычно INFO или WARN как базовый уровень; DEBUG или TRACE - только в рамках временной диагностики и в ограниченных рамках. Важно обеспечить структурированность логов и наличие полей контекста, чтобы через поиск можно было легко связать логи с трассировками.
- Какие инструменты выбрать для сбора логов и трассировки в Flink?
- Логи: ELK/EFK или Loki; трассировка: OpenTelemetry в сочетании с Jaeger или Tempo. Выбор зависит от существующей инфраструктуры, бюджета и требований к масштабу. В реальных проектах целесообразно сочетать два подхода: централизованный сбор логов и распределённую трассировку.
- Как рассчитать стоимость хранения логов и как её снизить?
- Стоимость зависит от объёма логов и длительности ретенции. Рекомендовано использовать ротацию файлов, уровни логирования и архивирование старых данных в долгосрочные хранилища. Периодически пересматривайте политику хранения и удаляйте устаревшие данные согласно регламентам.
- Как определить, что трассировка работает корректно?
- Убедитесь, что трассировки проходят через всю цепочку задач, что все spans имеют связи с родительскими элементами, а front-end-дашборды показывают задержки по каждому операторам и узлу. Периодически запускайте синтетические сценарии, чтобы проверить полноту собираемой трассировки и корректность выходных данных.
- Какие практические кейсы возникают при диагностике?
- Неправильная корреляция между логами и трассировками в распределённых задачах; избыточная генерация логов, влияющая на производительность; задержки в экспортёрах трассировки; неполная передача контекста между операторами; нехватка памяти из-за обильного логирования.
- Можно ли отключить локальные логи на отдельных узлах без риска потери диагностики?
- Да, но следует сохранять критические поля контекста и обеспечить возможность временного поднимания уровня логирования для отдельных узлов в случае диагностики. Требуется выверенная политика_ROTATION и ретенции, чтобы не перегружать хранилище.
- Какие шаги предпринять при внедрении OpenTelemetry в существующий кластер Flink?
- Определите набор операторов, где требуется instrumentation; внедрите span-ы на ключевых шагах; настройте Propagators для переноса контекста; настройте OTEL Collector и бэкенд для трассировки; настройте структурированные логи и корреляцию между ними; проведите пилотный запуск и постепенно расширяйте instrumentation по мере необходимости.
- Какие риски и ограничения следует учитывать при внедрении?
- Прямая накладка на производительность из-за дополнительного трейса и логирования; необходимость согласовать политики управления секретами и доступом к внешним системам мониторинга; обработка больших объёмов данных и требования к хранению; совместимость версий клинета/серверной части OpenTelemetry и бэкендов.
Глава предложена в формате, адаптированном под технический профиль: акцент на архитектуре и протоколах, конкретные рекомендации по конфигурации и примеры кода для инструментирования, а также примеры интеграций с внешними системами мониторинга и трассировки. В сочетании с практическими подходами к диагностике и оптимизации это даёт целостную картину для инженера по администрированию Flink и эксперта по данным и цифровой трансформации.


