

Междатная репликация и DR: MirrorMaker 2.0 и альтернативы
Междатная репликация данных в рамках стека Apache Kafka представляет собой критическую часть стратегии отказоустойчивости и устойчивости streaming-платформ. Глава посвящена архитектуре межкластерной репликации, алгоритмам согласованности, а также практикам выбора и внедрения MirrorMaker 2.0 и альтернативных решений. Рассматриваются принципы передачи данных между дата-центрами, управление оффсетами и дедупликацией, а также подходы к мониторингу и тестированию DR-плана. В конце - практические рекомендации и типовые сценарии внедрения.
Краткое введение
В условиях распределенной инфраструктуры бизнес-операции требуют устойчивого хранения и своевременного доступа к потокам данных независимо от сбоев отдельных дата-центров. Междатная репликация решает задачу переноса топиков и потоков событий из одного кластера Kafka в другой, обеспечивая возможность быстрой перенастройки хоста потребителей, минимизацию потерь данных и снижение времени простоя. В рамках этой темы MirrorMaker 2.0 выступает как стандартный инструмент в рамках открытого экосистемного набора инструментов Apache Kafka, дополняя или заменяя коммерческие решения там, где необходима адаптивная архитектура репликации, прозрачная интеграция с Kafka Connect и высокая гибкость конфигурации. Альтернативные решения включают коммерческие репликаторы, а также подходы на базе конструкторских Connect-подключений с собственной логикой маршрутизации и дедупликации. Важной целью является выработка единого подхода к проектированию DR-архитектур, определению RTO и RPO, а также созданию процессов мониторинга, тестирования и безболезненного выполнения failover.
- Краткое содержание главы
- Обзор концепций междатной репликации, архитектурные паттерны и требования к согласованности
- MirrorMaker 2.0: архитектура, принципы работы, конфигурация и интеграция с Kafka Connect
- Алгоритмы согласованности, управление оффсетами и риски DR
- Альтернативы MirrorMaker 2.0: выбор между открытым инструментарием и коммерческими решениями
- Практическая реализация и аспекты мониторинга, тестирования и эксплуатации
Концепции и архитектура междатной репликации
Междатная репликация рассматривается как процесс доставки данных топиков из одного кластера Kafka (источник) в другой кластер (цель) так, чтобы потребители целевого кластера имели доступ к тем же потокам событий независимо от сбоев в источник или сетевых ограничений. Основные концепции:
- Репликация в разных географических локациях: задача поддержания согласованности и доступности данных между дата-центрами, минимизация задержек и времени простоя при отказах.
- Права и безопасность: межкластерная передача требует настройки TLS, аутентификации (SASL) и инфраструктуры управления доступом (ACLs) для обоих кластеров, включая шифрование данных в пути и на диске.
- Модель доставки: межкластерная репликация может поддерживать различные модели доставки сообщений, в зависимости от требований к консистентности и задержке. В рамках Kafka чаще всего применяется модель "как есть" с возможной дедупликацией на получателе, что воспринимается как компромисс между задержкой и гарантией доставки.
- Управление оффсетами: целевой кластер имеет свою систему оффсетов потребления. Репликация должна корректно сопоставлять источники и целевые оффсеты, чтобы потребители целевого кластера могли продолжать обработку без пропусков и дубликатов.
- Схема управления ролями: DR-подходы принимают стратегию активного дублирования (Active-Active) или активного резервирования (Active-Passive). Выбор зависит от бизнес-требований к задержке, сложности эксплуатации и риска дублирующих обработок.
Архитектурно междатная репликация часто изображается как две связанные инфраструктуры: источник и целевой кластеры, соединенные слоем репликации. Взаимодействие между кластерами строится через брокеры Kafka и прокси-слой репликации, который может реализовывать политику отбора топиков, фильтрацию, преобразования и маршрутизацию сообщений. В реальных системах применяются дополнительные слои мониторинга, алертинга и автоматизации failover, чтобы обеспечить быстрое обнаружение проблем и минимизацию времени простоя.
Важным аспектом является выбор паттерна репликации: синхронная против асинхронной, репликация отдельных топиков против полного набора топиков, выбор между консистентной дедупликацией на уровне потребителей или на уровне репликатора. Эффективность зависит от пропускной способности сети, размера журналов оффсетов и задержки, с которой данные становятся доступными на целевом кластере. В рамках MirrorMaker 2.0 и аналогичных решений целостность данных и предсказуемость задержки достигаются за счет управляемых очередей, ограничений по параллелизму и детерминированной логики маршрутизации.
Архитектурные паттерны и требования к инфраструктуре
- Потребность в низкой задержке: для DR-решений критично уменьшать задержку между публикуемыми событиями и доступом к ним в целевом регионе.
- Масштабируемость: потребность обрабатывать большие объемы топиков и сообщений, что требует горизонтального масштабирования компонентов репликации.
- Надежность: устойчивость к сбоям в сетях и узлах кластера с автоматизированным повторным подключением и повторной отправкой.
- Согласованность и дедупликация: баланс между минимизацией дубликатов и задержкой доставки, особенно в случаях сетевых разрядок и partitioning.
- Управление конфигурацией: единая конфигурация для источника и цели, поддержка нескольких класторов и политик перераспределения нагрузки.
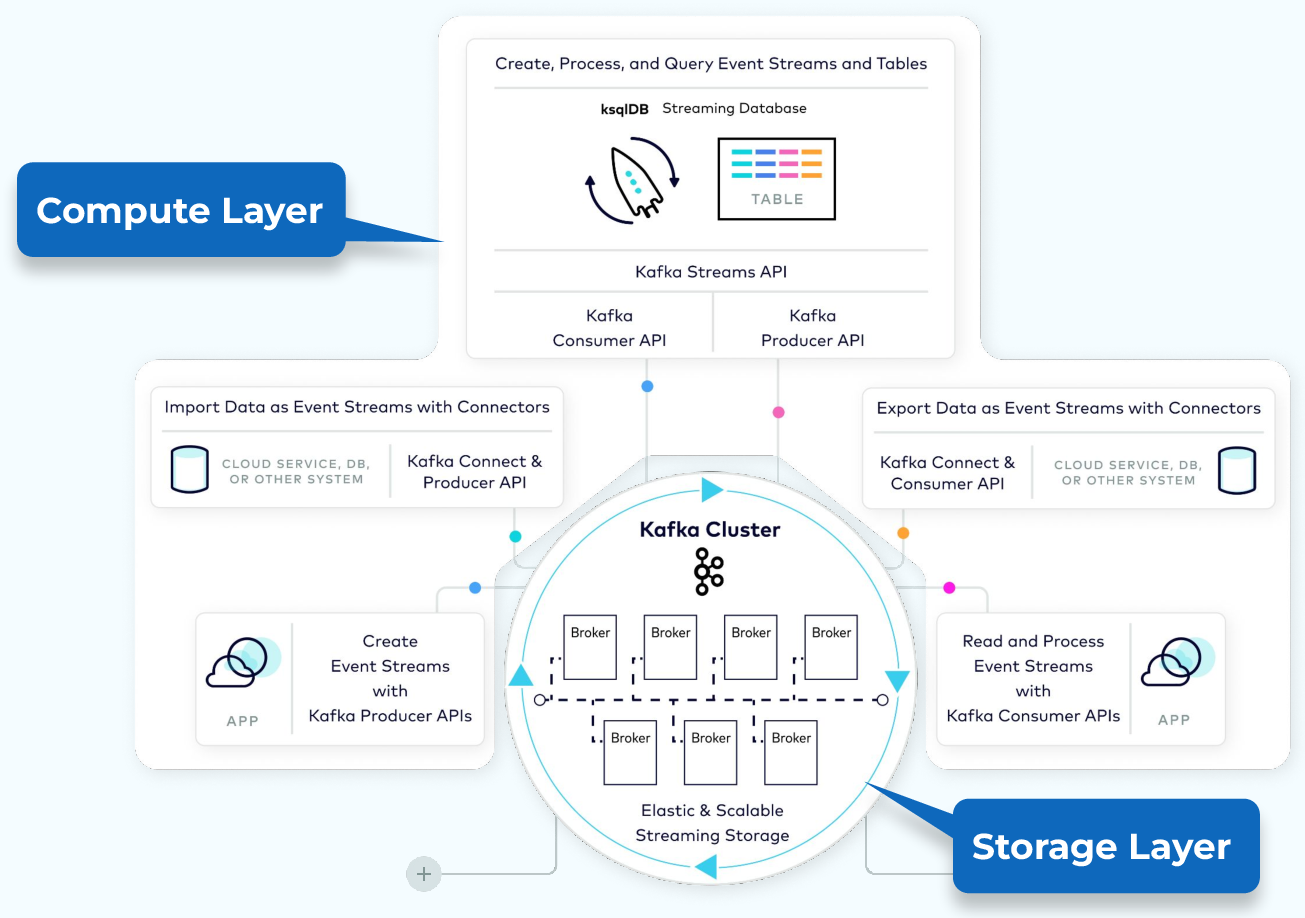
MirrorMaker 2.0: архитектура, протоколы и конфигурация
MirrorMaker 2.0 (MM2) представляет собой эволюцию оригинального MirrorMaker и построен на базе инфраструктуры Kafka Connect. Он обеспечивает управляемую, масштабируемую межкластерную репликацию, используя концепцию репликатора. Основные элементы архитектуры:
- Архитектура на основе Kafka Connect: MM2 запускается как часть кластеров Connect, используется механизм соединителей MirrorSource и MirrorTarget, что позволяет централизовать логику переноса, обработки ошибок и мониторинга.
- Платформа и паттерны replication policy: MM2 поддерживает политики репликации, которые определяют, как обрабатывать топики, файлы% и маркеры времени, как разрешать конфликты оффсетов и управлять дедупликацией. Конфигурационно можно указать включение/исключение топиков, фильтры и режимы маршрутизации.
- Управление оффсетами: целевые оффсеты по потокам событий отражают состояние потребления в целевом кластере и должны соответствовать концепции точной доставки, при этом возможны дополнительные меры защиты от дублирования при повторном выполнении репликации.
- Безопасность и сетевые требования: MM2 требует безопасного соединения между кластерами. Конфигурации включают параметры TLS/SASL, а также сервисы аутентификации и авторизации.
- Разделение ролей и режимы развертывания: MM2 поддерживает distributed mode через Connect cluster и может работать как независимый сервис с собственными узлами, что обеспечивает отказоустойчивость и масштабируемость. В некоторых случаях может использоваться более простой standalone режим для небольшой инфраструктуры, но для DR-инфраструктуры чаще предпочтительнее distributed режим.
Архитектура потока данных в MM2
- Источник: топики и сообщение-потоки публикуются в кластере источника. Сообщения сериализуются в рамках стандартной Kafka-цепочки, сохраняются в журналах.
- Репликация: MM2 считывает данные из источника и публикует их в целевой кластер. Это не просто копирование файлов журналов; это на уровне топиков и партишенов, с учетом согласованности и управления оффсетами.
- Цель: потребители целевого кластера читают реплицированные топики так, как будто данные публиковались в этом кластере напрямую. Для потребителей в целевом кластере могут применяться собственные схемы обработки, агрегации и аналитики.
Функциональные аспекты конфигурации
-
Выбор источника и цели: в конфигурации MM2 требуется определить набор кластеров источника и назначения, указав их bootstrap-сервера и, при необходимости, настройки безопасности.
-
Фильтрация и маршрутизация топиков: поддерживаются правила включения/исключения топиков, а также политика маршрутизации, которая определяет, как реплицировать топики между кластерами.
-
Управление нагрузкой: параметры, ограничивающие параллелизм, скорость репликации и максимальное число незавершенных операций, позволяют адаптировать MM2 к инфраструктурным возможностям и требованиям по задержкам.
-
Мониторинг и логирование: MM2 интегрируется с существующими системами мониторинга и логирования, что обеспечивает видимость состояния репликации, задержек и ошибок.
## Пример конфигурации MirrorMaker 2.0 в виде псевдо-структуры (для иллюстрации)
## В реальной среде используйте формат и ключи, поддерживаемые вашей версией Kafka и MM2.
clusters:
  source:
    bootstrap.servers: "source-kafka1:9092,source-kafka2:9092"
    security.protocol: SASL_SSL
  target:
    bootstrap.servers: "target-kafka1:9092,target-kafka2:9092"
    security.protocol: SASL_SSL
replication.policy.class: "org.apache.kafka.connect.mirror.DefaultReplicationPolicy"
topics.include.list: "events-.*|metrics-.*"
topics.exclude.list: "internal-.*"
tasks.max: 6
poll.interval.ms: 1000
Применение и интеграция
-
Развертывание: MM2 разворачивается в рамках инфраструктуры Kafka Connect, что упрощает управление конфигурациями, обновлениями и мониторингом по сравнению с кастомными решениями.
-
Обновления и совместимость: при обновлениях MM2 следует учитывать совместимость конфигураций между версиями Kafka и Connect, а также влияние на существующие политики репликации.
-
Мониторинг и диагностика: ключевые метрики включают задержку репликации, пропускную способность, количество записей, ошибок и повторных попыток. Визуализация даёт оперативное представление о «здоровье» DR-цепочки.
Алгоритмы согласованности, управление оффсетами и риски DR
Главной сложностью межкластерной репликации является баланс между задержкой, пропускной способностью и гарантией доставки без потерь и дубликатов. В MM2 и аналогичных решениях применяются следующие принципы:
- Дедупликация на стороне потребителя или репликатора: чтобы снизить риск дубликатов после переноса между кластерами, применяются стратегии дедупликации на уровне потребительских приложений или внутри системы репликации (идемпотентные продюсеры, контроль дублей).
- Оффсетная совместимость: целевые оффсеты должны соответствовать состоянию потребления в целевом кластере. В противном случае потребители могут пропустить сообщения или столкнуться с повторной обработкой.
- Политика доставки: MIRROR-репликация может быть реализована как "как есть" с повторными отправками в случае сбоев, что обеспечивает устойчивость к потерям, но требует обработки дубликатов на уровне потребителя. В некоторых случаях применяется режим «аккуратная доставка» с более строгими гарантиями, но за счет увеличенного времени задержки.
- Время простоя и отказоустойчивость: DR-подходы предусматривают тестирование планов переключения, автоматическое обнаружение сбоев узлов и перенаправление трафика на рабочие кластеры. В MM2 это достигается через мониторинг состояния кластеров, конфигурацию нескольких точек доступа и автоматизированные сценарии перезапусков.
- Риск сетевых разделений: при разрыве связи между кластерами возможно временное несоответствие оффсетов и частичное отклонение данных. Эффективное управление разделами сетей и настройка тайм-аутов повторной отправки критичны для минимизации потери данных и задержек.
Реализация в рамках MirrorMaker 2.0 подразумевает, что согласованность достигается не за счет жесткой синхронности между кластерами, а за счет преднамеренной политики доставки и детерминированной маршрутизации. Это означает, что разработчики и инженеры по эксплуатации должны:
- чётко определить RPO и RTO, чтобы выбрать подходящую модель репликации и масштабируемости;
- реализовать обработку дубликатов на уровне потребителей, особенно в сценариях активного DR-плана;
- продумать обработку зависимостей между топиками и корректную маршрутизацию ключевых данных;
- обеспечить полную видимость статуса репликации через мониторинг и журналы аудита.
Альтернативы MirrorMaker 2.0 и когда их использовать
Выбор между MirrorMaker 2.0 и альтернативами зависит от бизнес-требований, бюджета и навыков эксплуатации:
- Confluent Replicator (коммерческое решение): предоставляет расширенные возможности для межкластерной репликации, включая интеграцию с Confluent Control Center, более продвинутые политики фильтрации и содержания, улучшенную диагностику и поддержку высокой доступности. Преимущества включают зрелость продукта, коммерческую поддержку и готовые сценарии эксплуатации в рамках Confluent Platform. Недостатки - лицензирование и зависимость от поставщика.
- Собственные реализации на базе Kafka Connect: создание уникального репликатора с использованием существующих коннекторов и собственных трансформеров. Такой подход обеспечивает гибкость и точную подгонку под процессы и требования организации, однако требует значительных затрат на разработку, тестирование и поддержку.
- Kubernetes-опции и Strimzi-оркестрация: для сред, которые активно используют Kubernetes, Strimzi и связанные решения упрощают разворачивание MirrorMaker 2.0 в контейнеризованной среде. Это полезно для унификации развёртываний, но требует дополнительного внимания к сетевой политике, ограничению ресурсов и мониторингу.
- В рамках открытого стека: MirrorMaker 2.0 остается основным открытым решением, обеспечивая базовые требования межкластерной репликации. В некоторых случаях можно использовать комбинированный подход: MM2 для основного сценария replication и дополнительные инструменты для уникальных кейсов дедупликации и фильтрации.
Ключевые принципы выбора:
- Требования к задержке и пропускной способности: коммерческие решения часто предлагают более предсказуемые задержки и продвинутые механизмы балансировки нагрузки.
- Масштабируемость и эксплуатационные расходы: открытые решения требуют внутренней экспертизы, но снижают общую стоимость владения при грамотной архитектуре.
- Безопасность и соответствие требованиям: выбор должен обеспечить единый подход к шифрованию данных, управлению доступом и аудиту между регионами.
- Поддержка и жизненный цикл: наличие долгосрочной поддержки, документации и готовых практик эксплуатации существенно влияет на устойчивость DR-платформы.
Практическая реализация и анализ кейсов
Этапы проектирования DR-архитектуры:
- Определение целей DR: RTO и RPO, требования к задержке, частоте обновления и объему данных, который необходимо реплицировать.
- Выбор паттерна репликации: активное дублирование или активное резервирование; решение зависит от бюджета, бизнес‑логики обработки и допущений по консистентности.
- Определение набора топиков: какие топики реплицировать, какие исключить и как обрабатывать системные топики.
- Конфигурация канала репликации: настройка источника и цели, политики фильтрации, управление оффсетами, безопасность и сетевые параметры.
- План мониторинга: сбор метрик задержки, пропускной способности, ошибок, а также создание дашбордов и алертинг‑припусков для своевременного обнаружения сбоев.
- Тестирование DR-плана: регламентированные учения и тесты переключения между регионами, имитация сбоев, проверка консистентности и корректности потребления.
- Обеспечение устойчивости к изменению требований: процедура обновления конфигураций, управление версиями и регрессионное тестирование.
Практические советы по внедрению:
- Начинайте с малого масштаба: пробная ликвидация «одного региона» и ограниченного набора топиков. Это позволяет проверить архитектуру, процесс обновления и мониторинг без риска для критических потоков данных.
- Оптимизируйте настройки задержки и параллелизма в MM2 и/или выбранной альтернативе под реальные нагрузки и сетевые условия.
- Разработайте политику обработки дубликатов и ошибок: какие дубликаты допустимы, как их детектировать и как их обработать в downstream-сервисах.
- Установите единый подход к безопасной передаче данных, включая TLS и аутентификацию между кластерами, а также контроль доступа к данным на уровне тем и групп потребителей.
- Регулярно проводите DR-учения: моделируйте реальные сбои, проверяйте целевые кластеры, обновляйте документы по DR и они должны оставаться актуальными.
## Привязанный чек-лист для внедрения и мониторинга межкластерной репликации
- Определены RTO и RPO
- Выбран паттерн репликации (Active-Active / Active-Passive)
- Настроен MM2 или альтернативный репликатор
- Определены топики для репликации и фильтры
- Реализованы дедупликации на уровне потребителя
- Настроены TLS/SASL и ACLs между кластерами
- Внедрен мониторинг задержки, ошибок и пропускной способности
- Проведены DR-практические учения и регламент обновления
Key takeaways
- Межкластерная репликация - критический компонент DR-архитектур для Kafka, требующий управления задержками, оффсетами и дедупликацией.
- MirrorMaker 2.0 предоставляет связку архитектурной простоты и гибкости благодаря интеграции с Kafka Connect и поддержке распределенного режима развертывания.
- Важно определить бизнес-цели DR (RTO, RPO) и выбрать подход, который обеспечивает требуемую балансировку между задержкой, надёжностью и стоимостью эксплуатации.
- Альтернативы MM2 включают коммерческие репликаторы, а также кастомные решения на базе Kafka Connect; выбор зависит от бюджета, потребностей в мониторинге и поддержке.
- Эффективная реализация DR требует продуманного мониторинга, тестирования и процессов эксплуатации, включая управление безопасностью и аудитом между регионами.
FAQ
- Что такое MirrorMaker 2.0 и как он работает в рамках DR‑архитектур?
- MirrorMaker 2.0 - это современный инструмент межкластерной репликации, встроенный в Apache Kafka через Kafka Connect. Он читает данные из кластера источника и публикует их в кластере назначения, поддерживая конфигурацию топиков, политики фильтрации и маршрутизации. MM2 упрощает настройку и масштабирование межкластерной передачи, обеспечивает управление оффсетами и предоставляет средства мониторинга. В контексте DR MM2 обеспечивает непрерывность данных между регионами и снижает риск потери данных при сбоях, но при этом следует учитывать возможность дубликатов и требования к консистентности.
- Какие риски связаны с межкластерной репликацией и как их минимизировать?
- Основные риски: задержка между регионами, дублирование сообщений, несоответствие оффсетов, сетевые проблемы, риск потери данных при грубом сбое. Минимизация достигается через продуманную архитектуру, выбор подходящей модели доставки, дедупликацию на уровне потребителей, настройку безопасной передачи (TLS/SASL), мониторинг и регулярное тестирование DR-плана.
- Когда предпочтительнее использовать Confluent Replicator вместо MirrorMaker 2.0?
- Confluent Replicator может быть предпочтителен, если в организации есть потребность в готовом коммерческом решении с поддержкой, централизованным управлением, продвинутыми инструментами мониторинга и интеграцией в Control Center. MM2 чаще применяется в открытом стеке, когда требуется гибкость, независимость от поставщика и более гибкая конфигурация. Выбор зависит от бюджета, требований к SLA и наличия внутренней экспертизы.
- Какие архитектурные паттерны репликации обеспечивают наилучшую устойчивость?
- Часто применяются активное DR-подключение и активная репликация (Active-Active) с независимыми потребителями в целевом кластере и продуманной дедупликацией. В некоторых случаях выбирают активное резервирование (Active-Passive) с автоматическим переключением на целевой кластер в случае недоступности источника. Важно обеспечить согласованную политику маршрутизации и мониторинг, чтобы быстро выявлять рассогласования.
- Как управлять оффсетами между кластерами и зачем это важно?
- Управление оффсетами обеспечивает согласованность потребления между кластерами. Неправильная синхронизация может привести к потере данных или дублированию. Решается через явное impersonation/aliasing потребителей, совместные политики сохранения оффсетов и согласование топиков между кластерами. В MM2 целевые оффсеты обычно отображают состояние целевого кластера и позволяют потребителям продолжать работу после переноса.
- Какие метрики критичны для мониторинга межкластерной репликации?
- Основные: задержка репликации, скорость репликации (throughput), число ошибок и повторных попыток, объём переписанных данных, статус кластеров источника и назначения, использование ресурсов (CPU, память, сеть), состояние политик фильтрации и маршрутизации, а также уровень дубликатов на уровне потребителей.
- Как организовать тестирование DR-плана в контексте репликации?
- Рекомендовано проводить регламентированные учения с моделированием разных сценариев: сбой источника, отказ сети, перегрузка канала, частичные сбои целевого кластера. В процессе тестирования следует проверять корректность переноса данных, устойчивость к дубликатам, способность потребителей переходить в режим оффлайн/онлайн и корректность восстановления после переключения.
- Какие требования к сетевой инфраструктуре обеспечивают эффективную межкластерную репликацию?
- Необходимо обеспечить низкую задержку связи между регионами, достаточную пропускную способность, резервирование сетевых путей и устойчивость к сетевым перегрузкам. Использование сегментированных сетевых политик и приоритезации трафика, а также мониторинг сетевых ошибок и латентности - критические элементы.
- Как выбрать между активной и пассивной стратегией DR для Kafka?
- Выбор зависит от бизнес-требований к задержкам и доступности. Активная стратегия обеспечивает минимальные задержки при переключении, но требует более сложного управления и большей инфраструктуры. Пасивная стратегия упрощает архитектуру, но может привести к большему времени восстановления. Оцените RTO, RPO и влияние на downstream‑потребителей, прежде чем определить стратегию.
- Какие типичные ошибки встречаются при настройке MM2 и как их избегать?
- Частые ошибки: неправильная конфигурация кластеров, несоответствие версий между MM2 и версиями Kafka, недостаточная защита сетевого канала между кластерами, отсутствие планов тестирования DR, игнорирование дедупликации на стороне потребителя. Избежать их можно через детальное тестирование конфигураций в песочнице, документирование политики репликации, систематический мониторинг и план обновления версий в рамках жизненного цикла инфраструктуры.


