

SLA, качество сервиса и управление доступностью
Современные аналитические платформы строятся на потоковой передаче данных, где задержки и потеря данных неприемлемы для бизнес-решений. В условиях распределённых кластеров Kafka критически важны понятные цели уровня сервиса (SLA), соответствующие ему показатели (SLI, SLO) и чёткие процедуры управления доступностью. Глава представляет системный подход к определению SLA, проектированию устойчивости и управлению эксплуатацией потоковых пайплайнов на базе Apache Kafka.
Kafka выступает ядром потоковой интеграции между источниками данных и аналитическими платформами. SLA здесь охватывает не только географическую доступность отдельных компонентов, но и качество передачи, консистентность и своевременность обработки сообщений, устойчивость к сбоям и оперативность восстановления после инцидентов. В главе рассматриваются архитектурные принципы, подходы к мониторингу и умному управлению ресурсами, практики ведения Runbook и DR-процедур, а также конкретные сценарии внедрения SLA в контексте аналитических систем.
- Объяснить, что считается SLA и какие показатели критически важны для потоковой передачи в Kafka.
- Рассмотреть архитектурные решения для обеспечения высокой доступности и устойчивости.
- Показать способы измерения, мониторинга и настройки предупреждений и реакций на инциденты.
- Предложить процессный подход к формированию SLAs, SLOs и операционных процедур в командной среде.
- Предложить практические рекомендации по интеграции SLA в реальные аналитические пайплайны.
Введение в SLA и качество сервиса
Эффективное управление доступностью начинается с чётких целевых параметров, которые соответствуют потребностям бизнеса. SLA в контексте Kafka должен отражать четыре взаимосвязанных аспекта: доступность (uptime) кластера и нод, задержку (latency) от происхождения события до потребителя, целостность передачи и отсутствие потерь данных, а также соответствие требованиям по порядку доставки и консистентности обработки.
- Уровень доступности можно трактовать как долю времени, когда система готова к принятию и обработке данных без существенных задержек. Этот показатель важен для сервисов, где потребители ожидают непрерывного потока событий.
- Задержка включает задержку на входе в систему, внутри Kafka и на стороне потребителей. В аналитике она влияет на точность временных окон, реальное время моделирования бизнес-процессов и качество реального времени.
- Целостность данных требует контроля за потерей данных и дублированием. В Kafka это достигается через корректную настройку репликации, минимальных коэффициентов репликации и политики выбора лидера очереди.
- Порядок доставки имеет критическое значение для событий, где последовательность событий влияет на корректность расчётов (например, временные ряды, транзакционные потоки). Здесь применяются концепции exactly-once semantics (EOS), упорядочения внутри разделов и устойчивое повторное воспроизведение.
SLI и SLOs для Kafka следует рассчитывать на уровне цепочки: от источника данных до целевых аналитических потребителей. Важна не только средняя задержка, но и распределение задержек - например, 95-й процентиль и максимум за заданный интервал. Наконец, SLA должен учитывать резервные сценарии: плановое обслуживание, обновления брокеров, миграции и DR. Взаимосвязь бизнес-целей и технических параметров должна быть прозрачной: какие потери данных допустимы в рамках бизнеса, как быстро восстанавливается пайплайн и какие штрафы или компенсации предусмотрены в контракте на уровне сервиса.
В контексте аналитических платформ особое внимание уделяется целям по своевременности поставки данных в облачные хранилища, обработку в streaming-процессинге и точности агрегаций. SLA должно включать сценарии деградации сервиса и правила перехода в безопасный режим - например, временное снижение частоты обновления дашбордов, сохранение режимов exactly-once там, где это критично, и автоматическое переключение источников в резервные пайплайны.
Архитектурные принципы обеспечения доступности Kafka
Высокая доступность Kafka достигается через сочетание архитектурных решений, продуманных политик конфигурации и стратегий развертывания. Ключевые принципы:
- Репликация и изоляция сбоев: уровень репликации должен обеспечивать устойчивость к выходу из строя одной или нескольких нод. Репликационные факторы выбираются исходя из числа брокеров и требований по отказоустойчивости. Включение минимального числа синхронных копий (min.insync.replicas) обеспечивает guarantees по целостности и предотвращает потерю данных при падении лидера.
- Выбор лидера и безопасность лидерства: можливости отказоустойчивости за счёт корректного выбора лидера партиции и предотвращения непреднамеренной потери данных. Включение политики безопасного выбора лидера и запрет unclean leader election улучшает устойчивость к потере данных во время сбоев.
- Изоляция зон доступности и географическая устойчивость: для бизнес-процессов, требующих низкой задержки и высокой доступности, целесообразно размещать ноды по зонам доступности (AZ) и поддерживать сетевые политики, минимизирующие латентность. Рассматриваются сценарии межрегионального дублирования через MirrorMaker 2.0 или аналогичные инструменты интеграции.
- Конфигурационные параметры SLA: параметры типа replication.factor, min.insync.replicas, unclean.leader.election.enable, acks и другие непосредственно влияют на баланс между задержкой и безопасностью. Правильная настройка позволяет уменьшить риск потери данных и деградацию сервиса в условиях сбоев.
- Эволюционная архитектура: переход к режиму KRaft (без ZooKeeper) и внедрение более централизованной мета-управляемости способны снизить задержки и повысить управляемость. Однако переход требует детального планирования, тестирования совместимости и постепенного мигрирования.
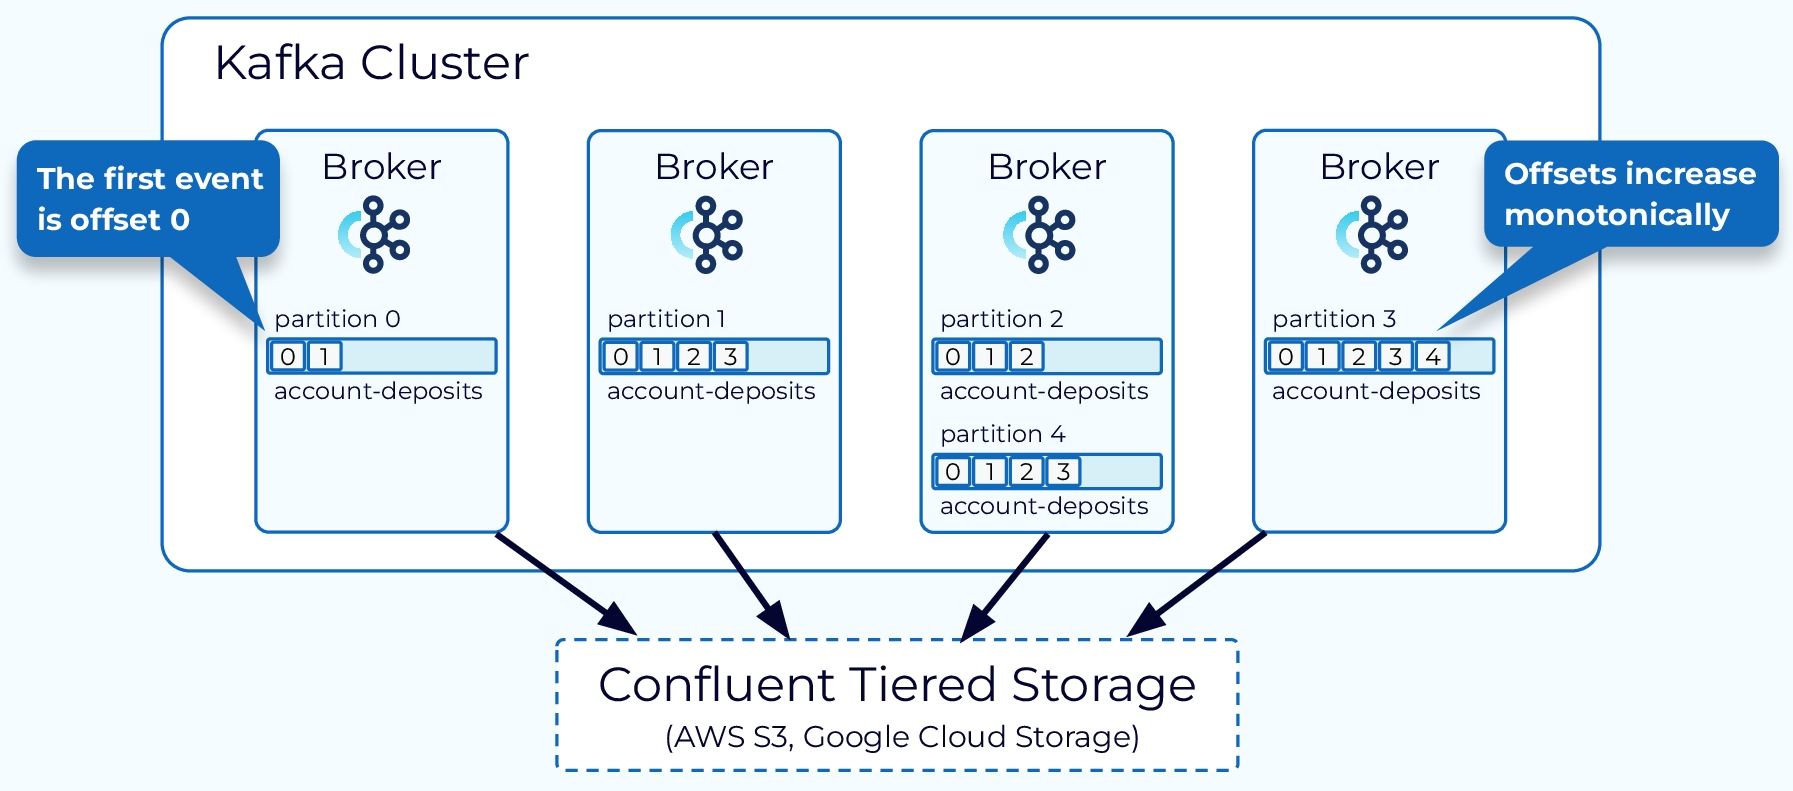
Концептуальная схема архитектуры доступности может выглядеть как многоуровневая система: несколько брокеров в кластере, репликация партиций, клиентские коннекторы и обработчики в рамках потребителей/потребительских групп, мониторы статуса и управляющие сервисы. В реальных проектах полезно внедрять rack-awareness и автоматическое перераспределение нагрузок при изменении состава кластера. Важно предусмотреть DR-планы, которые охватывают синхронную репликацию, геораспределение и процедуры быстрого переключения на резервную инфраструктуру.
## Пример конфигурации по умолчанию для обеспечения доступности
## server.properties (брокер)
broker.id=1
log.dirs=/var/lib/kafka/logs
num.partitions=12
default.replication.factor=3
offsets.topic.replication.factor=3
transaction.state.log.replication.factor=3
min.insync.replicas=2
unclean.leader.election.enable=false
Пояснения к этому фрагменту:
- default.replication.factor и related параметры определяют базовую устойчивость топиков, создаваемых по умолчанию.
- min.insync.replicas устанавливает минимальное число синхронных копий, необходимых для признания записи успешно записанной. Это критично для избежания потери данных в условиях отказа.
- unclean.leader.election.enable=false запрещает выбор лидера из не синхронных реплик, что повышает согласованность и снижает риск потери данных, но может увеличить время восстановления при некоторых сбоях.
В дополнение к конфигурации требуется продуманная архитектура темпоральной изоляции: контроль над тем, какие брокеры активны в каждый момент времени, мониторинг состояния ISR и автоматическое перераспределение партиций между брокерами для балансировки навеса и отказоустойчивости. Эффективная стратегия предполагает не только техническую настройку, но и организационные аспекты: четкую ответственность за зоны, регламент обновлений, тестирование планов восстановления и частоту проведения DR-практик.
Мониторинг и сигналы тревоги
Уровень SLA напрямую зависит от способности системы выявлять отклонения и быстро реагировать на инциденты. В контексте Kafka мониторинг должен охватывать:
- Доступность кластера: доля времени, в течение которого все ключевые ноды и сервисы доступны, без критических ошибок.
- Задержки и латентность: от момента поступления события до его обработки потребителем (end-to-end latency). Важны как средние значения, так и квантильные показатели (например, 95-й и 99-й перцентили).
- Потери данных: число сообщений, которые не были сохранены или потеряны вследствие сбоев, и время их задержки в повторном воспроизведении.
- Поддержка порядка и Exactly-Once Semantics: контроль за тем, чтобы транзакции и обработка сохраняли корректный порядок и минимизировали дублирование.
- Задержка в ISR и статус партиций: количество партиций с неполным набором копий, Offline Paritions и Under-replicated partitions - ключевые индикаторы устойчивости к сбоям.
- Производительность потребителей и микро-пайплайнов: задержки путешествия данных от источников к целевой аналитике, а также устойчивость к перегрузкам.
Для реализации мониторинга применяются современные стеки Prometheus/Grafana и экспортёры JMX. Важно иметь целевые SLI/SLO на уровне службы, сервиса и отдельных пайплайнов, с четким соглашением о дедлайнах и допустимых пределах ошибок. В конфигурации мониторинга следует включать:
- Метрики по каждому уровню: брокеры, топики, потребители, потоки данных потоковой обработки (Stream Processing).
- Метрики задержки и потребления ресурсов: CPU, память, диск, сеть.
- Метрики по здоровью ZooKeeper или KRaft, зависимости и сетевые задержки, если применимо.
Практика показывает, что достижение нужного SLA требует заранее заданных порогов, которые не должны приводить к резкому всплеску alert-iness при обычных пиковых нагрузках. Важно также внедрять эластичные механизмы масштабирования и автоматическую перераспределяемость нагрузки между узлами и кластерами.
- Процедуры оповещений: четкие правила эскалации, временные окна для устойчивой диагностики и минимальные границы реагирования на инциденты.
- Runbooks: детальные инструкции по устранению инцидентов, в частности по восстановлению после потери копий, переключению в DR-локи и регламентированному перезапуску компонентов.
- Автоматизация: оркестрация действий через Infrastructure as Code, чтобы свести к минимуму человеческий фактор.
Определение SLA, SLI и SLO, и практическая настройка
Определение SLA требует согласования между бизнес-целями и техническими ограничениями. В контексте Kafka существует три уровня:
- SLI (Service Level Indicator) - конкретный показатель качества услуги: например, end-to-end latency, вероятность потери данных, процент успешных завершений транзакций.
- SLO (Service Level Objective) - целевые значения этих показателей на заданный интервал времени: например, 95-й перцентиль задержки менее 300 мс, недопустимая потеря данных не более 0.01%.
- SLA (Service Level Agreement) - юридически фиксированное соглашение, связывающее бизнес-цели и технические параметры, включая ответственность за нарушение, планы компенсаций и сроки восстановления.
Практическая настройка SLA в Kafka-пайплайнах требует следующих шагов:
- Определение бизнес-слоев и пайплайнов: какие цепочки данных критичны для бизнеса, какие сроки обработки необходимы для дашбордов, какие индикаторы требуют строжайшей точности.
- Определение SLI и SLO: для каждого пайплайна устанавливаются цели по доступности и задержке, а также пороги по потере данных и порядка.
- Архитектурная карта: выбор репликации, политики выбора лидеров, распределение топиков по AZ, резервирование и DR-планы.
- Мониторинг и алерты: настройка дашбордов и предупреждений, отслеживание отклонений и их коррекция.
- Тестирование SLA: регламентированные тесты на стресс и восстановление, периодические DR-тренировки и ретроспективы.
- Управление изменениями: формализация изменений в инфраструктуре и конфигурациях для минимизации риска нарушения SLA.
С точки зрения реализации в Kafka-Hadoop-аналитике важна интеграция SLI/SLO в существующую экосистему мониторинга. В качестве примера можно рассмотреть задачу обеспечения end-to-end задержки в пределах заданного диапазона в рамках цепочек источников данных, передачи через Kafka и потребления аналитическими сервисами. В этом контексте полезны следующие методики:
- Модель времени: согласование времени между источниками и приемниками (синхронизация времени, коррекция временных зон, требования к clocks на серверах).
- Безопасная передача: использование уникальных идентификаторов сообщений и идемпотентных потребителей, а также обеспечение exactly-once semantics там, где это возможно без существенного влияния на задержку.
- План деградации: если SLA не может быть соблюден, следует применить заданные сценарии деградации и переход на безопасный режим обработки, чтобы снизить риск потерь и обеспечить минимальный уровень сервиса.
В части практических рекомендаций рекомендуется:
- Внедрять SRE-подходы: на уровне контракта, операционных домов и автоматизации.
- Развивать дисциплину аварийного восстановления: план DR, тесты, регламенты эскалаций и процедуры уведомления.
- Постепенная миграция и тестирование новых стратегий: масштабирование в тестовой среде, затем в стейдж/производство, с детально задокументированными изменениями.
- Документация и прозрачность: публикация SLA, SLO и Runbooks, а также обеспечение доступа к необходимым данным для аудита.
Управление доступностью: процессы, внедрение и DR
Управление доступностью - это не только набор параметров и инструментов, но и организационная культура, в которой члены команд обладают ясной ответственностью за поддержание SLA. В этом разделе рассмотрены ключевые процессы:
- Планирование и договоренности: определение уровня сервиса для каждого пайплайна, формулирование требований к доступности и задержкам.
- Runbook и тревоги: документирование готовых к исполнению сценариев при инцидентах, включая шаги диагностики, восстановление и коммуникацию.
- On-call и эскалации: поддержка кросс-функциональных команд, процедура уведомления и ответов в непрерывной работе.
- DR-процедуры: сценарии полной потери региона, межрегиональное дублирование, автоматическое восстановление и миграции пайплайнов на резервную инфраструктуру.
- Change management: контроль конфигураций и обновлений, регламент планового обслуживания и ответ на непредвиденные изменения.
- Пост-инцидент анализ: анализ причин инцидентов и внедрение профилактических мер, формирование обновлений SLA и Runbooks.
Практическая часть управления доступностью требует интеграции с инструментами управления инфраструктурой и каталогами сервисов. Эффективная организация требует, чтобы каждый пайплайн имел своего ответственного за SLA, поддерживал документацию и регулярно проводил DR-тренировки. В крупных командах целесообразно внедрять централизованные панели мониторинга и автоматизированные проверки соответствия SLA.
Key takeaways
- SLA для Kafka-пайплайнов должен охватывать доступность, задержку, целостность данных и порядок доставки, учитывая end-to-end путь от источника до целевой аналитики.
- Архитектура доступности базируется на грамотной настройке репликации, минимальном числе синхронных копий, выбора лидера и региональной изоляции, возможно с использованием MirrorMaker 2.0 для DR.
- Мониторинг должен быть ориентирован на SLI/SLO и включать метрики по кластерам, топикам, потребителям и задержкам, с понятной эскалацией инцидентов.
- Практическая настройка SLA требует формализации SLI/SLO, архитектурных решений, тестирования, документирования Runbooks и регулярных DR-тренировок.
- Управление доступностью - это сочетание технических практик и организационной дисциплины: планирование, Runbooks, on-call, change management и пост-инцидентный разбор.
- Корреляция SLA и бизнес-целей должна быть прозрачной: какие потери данных допустимы, какие задержки приемлемы и какие компенсационные меры предусмотрены в рамках соглашения.
- Важно поддерживать баланс между безопасностью (минимальные данные и устойчивость) и производительностью (низкие задержки и высокие показатели throughput) в рамках SLA.
- При необходимости можно использовать простые конфигурационные примеры в Kafka (например, минимальные требования по репликации и безопасной записи), чтобы обеспечить базовую устойчивость.
- Вовлечение команд разработки операций в процесс определения SLA и верификацию через тесты - ключ к успешной эксплуатации:
своевременная диагностика, быстрый доступ к Runbooks и устойчивые процессы изменения конфигураций.
FAQ
- Что такое SLA в контексте Apache Kafka и почему он важен для аналитических платформ?
SLA - это договорённость об уровне сервиса, включающая параметры доступности, задержки, целостности данных и порядка доставки. В аналитических пайплайнах SLA обеспечивает предсказуемость времени поставки данных, качество дашбордов и надёжность бизнес-решений. Kafka как потоковая инфраструктура должна сохранять баланс между безопасностью данных и скоростью обработки, чтобы бизнес-цели не становились жертвой сбоев в инфраструктуре.
- Какие показатели считаются критичными для SLA в Kafka?
Ключевые SLI включают end-to-end задержку, процент успешных доставок, долю сообщений без потери, уровень порядка внутри партиций, число Under-ReplicatedPartitions и время восстановления после сбоев. SLO - это целевые значения для этих показателей на заданном интервале, например: 95-й перцентиль задержки менее 300 мс, потеря данных не более 0.01% за месяц.
- Как выбрать стратегию репликации и какие параметры влияют на доступность?
Выбор replication.factor и min.insync.replicas - критические решения для доступности. Более высокий replication.factor улучшает устойчивость к сбоям, но может увеличить задержку и нагрузку на сеть. min.insync.replicas обеспечивает, что запись считается успешной только при наличии достаточного числа синхронных копий. Важно также отключить unclean.leader.election, чтобы минимизировать риск потери данных во время сбоев, даже если это увеличивает время восстановления.
- Какие архитектурные решения снижают риск потери данных в условиях сбоев?
Распределение топиков по нескольким узлам, поддержка AZ-изоляции, использование MirrorMaker 2.0 для DR, а также переход к режиму KRaft для упрощения управления метаданными. Важно иметь план реагирования на сбои, включая автоматическое переключение на резервную инфраструктуру и контрольный перечень действий.
- Как организовать мониторинг SLA на практике?
Разработайте набор SLI/SLO для каждого пайплайна, внедрите центральный мониторинг (Prometheus) и панели Grafana, настройте предупреждения и эскалацию. Включите мониторинг кластера (ISR, offline partitions), задержку на входе и выходе, нагрузку на узлы и потребителей. Регулярно проводите DR-тесты и пост-инцидентные разборы.
- Какие риски стоят перед внедрением SLA в реальных проектах?
Основные риски - несогласованность между бизнес-целями и техническими ограничениями, неполная видимость процессов и метрик, недостаточное тестирование изменений, а также проблемы с координацией между командами разработки и эксплуатации. Преодоление этих рисков достигается через четкое управление изменениями, Runbooks, регулярные DR-практики и участие бизнес-заинтересованных лиц.
- Какие технические практики помогают соблюдать SLA без ухудшения производительности?
Разделение пайплайнов по критичности и целям SLA, гибкое масштабирование, приоритетизация трафика, эффективная конфигурация репликации, оптимизация топологий потребителей и упрощение архитектуры за счёт KRaft. Не менее важно помнить про качественное тестирование изменений и мониторинг в режиме реального времени.
- Можно ли применить Exactly-Once Semantics (EOS) в Kafka и какие trade-offs?
EOS достигается через параметры транзакций и архитектуру обработки. EOS снижает риск дублирования и потерь, но может увеличить задержку и сложность пайплайна. В SLA можно устанавливать частичные EOS стратегии там, где критична целостность, а для остальных участков - обеспечить idempotent-обработку и повторное воспроизведение без потерь.
- Как связать DR-процедуры с SLA?
DR-процедуры должны быть частью SLA и Runbooks. В случае выхода из строя региона следует автоматически перенаправлять пайплайны на DR-локацию, сохранить данные и поддерживать согласованность. Периодические DR-тесты и ретроспективы позволяют снизить риск сбоев и улучшить время восстановления.
- Какие открытые инструменты и продукты стоит учитывать при реализации SLA?
Open-source: Apache Kafka (core), MirrorMaker 2.0 для DR, Prometheus/Grafana для мониторинга. Российские или локальные решения: возможны инструменты мониторинга и управления, соответствующие требованиям к данным и аудитам. В любом случае выбор инструментов должен основываться на совместимости с текущей инфраструктурой, масштабируемости и возможности автоматизации.
- Какой подход к документированию SLA является наиболее эффективным?
Документация SLA должна быть понятной для бизнес-пользователей и операционных команд. Включайте: цели SLA и SLO по пайплайнам, перечень топиков и критичных потоков, план восстановления, Runbooks на случай инцидентов, регламент тестирования SLA и эскалацию. Регулярно обновляйте документацию после изменений в архитектуре, тестах или бизнес-целях.
- Как организовать процесс внедрения SLA в командной среде?
Определите ответственных за SLA на уровне команд, создайте кросс-функциональные группы, внедрите общий сервисный контракт, развивайте культуру постоянного улучшения, применяйте техники Site Reliability Engineering (SRE) и регулярные ретроспективы по инцидентам. Встроенная аналитика SLA в повседневную работу поможет избегать избыточной бюрократии и ускорить принятие решений.
- Какие примеры типовых ограничений SLA для аналитических пайплайнов?
Примеры ограничений: 99,9% доступности кластера в рабочие часы, 95-й перцентиль задержки ниже 500 мс для потока ingestion, не более чем 0,1% потери сообщений за месяц, устойчивость к перегрузке в пиковые периоды. Конкретные цифры зависят от бизнес-рисков, требований к своевременности и возможности восстановления.
- Какие шаги помогут ускорить внедрение SLA в проекте?
Определите критичные пайплайны, сформулируйте SLI/SLO, задайте минимальные требования к репликации и целостности, создайте Runbooks и начальные панели мониторинга, проведите DR-учения и периодическую валидацию SLA в тестовой среде, затем постепенно перенесите в продакшн. Постоянно обновляйте документацию и расширяйте мониторинг по мере роста пайплайнов.
- Какие Caveats следует учитывать при внедрении SLA в гибридной и многооблачной среде?
Учитывайте задержки сети между облачными регионами, планируемые отключения и миграции, различия в конфигурациях сервисов и доступности, соответствие требованиям регуляторной среды. В рамках SLA необходимо предусмотреть гибкость в данных условиях, подготовить DR-планы и тестировать их под реальными сценариями.
Глава завершает систематизированное представление принципов SLA, которые применимы к потоковой интеграции на базе Apache Kafka в аналитических платформах. Важнейшими аспектами остаются точное определение целей, устойчивость к сбоям, продвинутый мониторинг и дисциплинированная эксплуатация. Реализация SLA требует не только технического подхода, но и организационной культуры, где ответственность за поддержание сервиса лежит на конкретных командах, и где данные и процессы следуют общему стандарту качества.


