

Введение: роль потоковой интеграции данных и Kafka в аналитических платформах
Современные аналитические платформы требуют не просто хранения и пакетной загрузки данных, но и непрерывной подачи источников в режимах реального времени. Потоковая интеграция данных становится ядром архитектуры, обеспечивая своевременную доступность событий, обновление показателей и оперативную корреляцию между системами. В этом контексте роль Apache Kafka выходит за рамки отдельного компонента: это инфраструктура обмена данными, которая поддерживает масштабируемые потоки, устойчивость к сбоям и интеграцию с экосистемой обработки и хранения. Цель главы - рассмотреть, как архитектура Kafka строит безопасные, надежные и управляемые потоки данных для аналитических платформ и какие практики следует применять на разных этапах проекта - от проектирования до эксплуатации.
В ходе изложения будут освещены принципы потоковой подачи данных, ключевые концепции Kafka, типовые интеграционные паттерны с аналитическими хранилищами и инструментами обработки, а также практические соображения по управлению качеством данных, безопасностью и мониторингом. Рассматриваемая перспектива ориентирована на архитекторов, инженеров данных и методологов, работающих в рамках цифровой трансформации и стремящихся к единообразной и воспроизводимой постановке задач потоковой интеграции.
- Потоковая интеграция как базовая архитектурная практика для аналитических платформ и её влияние на скорость принятия решений.
- Архитектура Kafka: брокеры, топики, партиции, репликация, оффсеты и гарантии доставки.
- Стратегии обработки и интеграции: CDC, источники и потребители, коннекторы, обработка на потоке и схема обработки событий.
- Эксплуатационные и управленческие аспекты: безопасность, мониторинг, управление конфигурациями, эволюция схем.
Краткое содержание главы
- Потоковая интеграция в контексте аналитических платформ и роль Kafka как инфраструктуры обмена данными.
- Архитектура кластера Kafka и механизмы обеспечения надежности, порядокности и масштабируемости.
- Форматы данных, схемы и управление эволюцией данных в реальном времени.
- Интеграционные паттерны для аналитики: CDC, коннекторы, потоковая обработка и совместное использование данных.
- Эксплуатация, безопасность и управление качеством данных в продукционной среде.
Архитектура и принципы потоковой интеграции в Kafka
Компоненты кластера Kafka и их функции
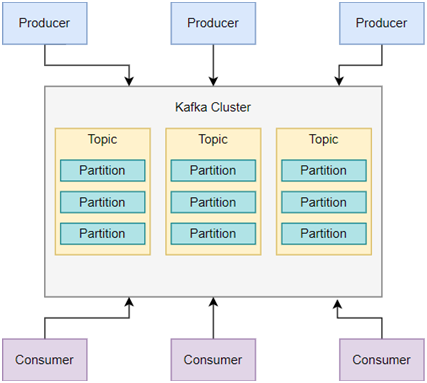
Ключевым элементом является кластер, состоящий из набора брокеров, который совместно хранит данные в топиках. Каждый топик разбивается на партиции, что обеспечивает параллелизм и масштабируемость. Партиции позволяют распределить нагрузку между брокерами и обеспечивают упорядоченность внутри каждой партиции, но не между всей темой. Продюсеры публикуют записи в топики, консьюмеры читают данные, формируя группы потребителей для горизонтального масштабирования обработки. Важной концепцией является хранение оффсетов - указателей, где именно в последовательности событий остановился потребитель, что обеспечивает устойчивость к сбоям и возможность повторного потребления.
Надёжность достигается через репликацию партиций на несколько брокеров. Это позволяет продолжать обработку и доступ к данным даже в случае выхода из строя одного узла. Репликацию необходимо планировать с учётом задержек сети и требований к задержке обработки. Архитектура Kafka, таким образом, сочетает в себе распределённость, упорядоченность внутри партиций и устойчивость к сбоям за счет репликации.
Механизмы доставки, порядок и семантики
Kafka поддерживает несколько семантик доставки сообщений: at-least-once, exactly-once(постепенно внедряемая в рамках поставщиков и клиентов) и at-most-once в базовой форме. Для аналитических сценариев чаще всего критичны точная доставка и отсутствие дублирования там, где это возможно, но также учитывается цена на производительность. Важно обеспечить идентичность потоков и корректную обработку повторных событий, особенно при повторном подключении потребителя или повторных попытках доставки до стадии обработки. Механизмы commit оффсетов и идемпотентных продюсеров помогают минимизировать дублирование и сохранять порядок внутри партиции.
Масштабируемость, устойчивость и операционная практика
Масштабируемость достигается за счет добавления партиций и брокеров в кластер, а устойчивость - через стратегию репликаций и конфигурации сетевых и аппаратных параметров. В операционной практике критичны мониторинг задержек, пропускной способности, уровня загрузки отдельных брокеров и задержек в цепочке консумирования. Важны процедуры обновления версий, откаты и минимизация простоев: таких подходов как blue-green deployment для конфигураций, rolling обновления и тщательное тестирование совместимости версий. Эффективная эксплуатация требует тесной интеграции с процессами изменения схем, мониторинга метрик и автоматизации оповещений.
Семантики потребления и управление оффсетами
Контроль за оффсетами позволяет каждому потребителю отслеживать свое положение в потоке. В крупных системах применяется группировка потребителей и диапазон событий, обрабатываемых параллельно. Управление оффсетами должно учитываться в сценариях повторного проигрывания в случае ошибок обработки, а также в ситуациях ребалансировки групп потребителей. При проектировании аналитических нагрузок следует выбирать соответствующую стратегию обработки: повторная обработка может быть допустима в некоторых случаях, но требует корректной Idempotence-логики на уровне приложений.
Архитектурные паттерны потоковой интеграции
Типовые паттерны включают раcпределение нагрузки через несколько топиков, разделение по доменам (domain-driven topics), а также использование конвейеров, где один топик служит источником для другого после обработки. В аналитических контекстах часто применяются паттерны CDC (Change Data Capture) для передачи изменений из транзакционных систем в потоковую среду, коннекторы для интеграции источников и потребителей, а также обработчики на потоке (stream processors) для агрегаций, фильтраций и расчета KPI в реальном времени.
Модели данных, форматы и схемы
Форматы сообщений: выбор между Avro, JSON и Protobuf
Сообщения в Kafka могут иметь различные форматы. JSON прост в использовании и понятен для экспериментов, однако не обеспечивает строгой типизации и эффективной компрессии. JSON-подобные схемы часто безболезненны на старте, но сложнее обеспечить единообразие и эволюцию схем. Avro и Protobuf предлагают компактность, схемы и эффективную сериализацию, что особенно ценно в больших потоках. Выбор формата должен учитывать требования к совместимости, скорости обработки и масштаба, а также доступность инструментов в экосистеме аналитики и обработки.
Управление схемами: Schema Registry и совместимость
Для обеспечения согласованности данных между источниками и потребителями применяется реестр схем (Schema Registry). Он позволяет хранить версии схем, обеспечивать совместимость между выпусками и предотвращать несоответствия во время изменений. В аналитических проектах критично поддерживать эволюцию схем без нарушений существующих конвейеров. Важна политика совместимости: назад- или вперед-совместимость, режим эволюционных версий и поддержка миграций значений полей.
Эволюция схем и управление совместимостью
Эволюция схем должна подчиняться строго установленным правилам, чтобы предотвращать сломы в уже работающих конвейерах. Практики включают добавление новых полей без изменения существующих, использование дефолтных значений, резервирование зарезервированных полей и явную миграцию исторических данных. В аналитической среде важно отслеживать ветви изменений и поддерживать совместимость для потребителей, которые могут быть распределены по версиям приложений. Такой подход минимизирует простои и обеспечивает устойчивую обработку на протяжении жизненного цикла продукта.
Взаимосвязь с хранилищами и каталогами метаданных
Данные в потоках часто связываются с хранилищами данных и каталогами метаданных в аналитических платформах. Потоки сигнализируют об изменениях, а хранилища отвечают за долговременное хранение и аналитические запросы. Важна согласованность между схемами данных и каталогами данных, чтобы обеспечить корреляцию между источниками, lineage и целевыми моделями. В практике это требует согласованной политики именования топиков, согласованных схем и версионирования, а также инструментов для каталогирования и мониторинга зависимости между данными.
Интеграционные паттерны для аналитических платформ
CDC и потоковая загрузка в хранилище данных
CDC обеспечивает передачу изменений из транзакционной базы данных в виде потоков событий. Это особенно полезно для обновления таблиц фактами и измерениями в аналитических хранилищах без пакетной загрузки. Реализация CDC через Kafka позволяет сгладить задержки между источником и аналитикой и поддерживать актуальность данных. Важна корректная обработка временных меток и согласование ключей изменений с целевыми моделями данных.
Интеграция через коннекторы: Kafka Connect и паттерны взаимодействия
Kafka Connect выступает как стандартный механизм интеграции источников и приемников с минимальной кодовой базой. Он обеспечивает готовые коннекторы к базам данных, файловым системам, платформам облачных данных и другим системам. Для аналитических платформ крайне полезны коннекторы, которые позволяют синхронно или асинхронно переносить данные, поддерживая транзакционные границы и управляемые параметры задержки. В реальной среде рекомендуется использовать коннекторы, которые хорошо совместимы с используемой схемой данных и имеют активное сообщество поддержки.
Потоковая обработка и преобразование данных: Kafka Streams и ksQDB
После публикации в Kafka данные можно обрабатывать на потоке с помощью Kafka Streams или поверх SQL-движков типа ksqlDB. Эти решения позволяют выполнять агрегации, фильтрацию, оконные вычисления и джойны без выхода из потока. Поточная обработка ускоряет ответы на оперативные запросы и снижает задержку между поступлением события и его отражением в аналитике. В контексте аналитических платформ важно обеспечить детерминированные результаты, обработку ошибок и облегчённое повторное выполнение запросов.
Архитектурные паттерны для аналитических сценариев
Типовые сценарии включают: (1) непрерывную загрузку свежих данных в дата-лейк и дата-морт; (2) фоновую агрегацию и подготовку витрин для BI-слоёв; (3) управление качеством данных через потоковую валидацию и мониторинг. Эффективная реализация требует тесной интеграции между коннекторами, схемами и обработчиками. В качестве дополнительного акцента стоит подчеркнуть важность устойчивого моделирования данных и обеспечения прозрачности lineage для аудита и соответствия требованиям.
Эксплуатация и безопасность
Управление доступом, аудит и безопасность данных
Защита данных в потоковых конвейерах требует многоуровневого подхода: TLS шифрование на транспортном уровне, аутентификация и авторизация через SASL/ACL, сегментация по префиксам топиков и ограничение прав пользователей и сервисов. В целях аудита следует регистрировать события безопасности, логирование действий пользователей и операций изменения конфигураций. В аналитических проектах безопасность должна сопоставляться с требованиями корпоративной политики и регламентами по защите данных.
Мониторинг производительности и операционная устойчивость
Необходимо мониторить задержки публикации и потребления, пропускную способность топиков, загрузку брокеров и задержки в репликации. Метрики должны быть связаны с SLA аналитических нагрузок: временами отклика, точностью и стабильностью обновления витрин. Операционные практики включают автоматические оповещения, регулярные тесты отказоустойчивости, а также процедуры обновления конфигураций без простоев.
Управление конфигурациями, версиями и эволюцией
Построение устойчивой среды требует строгого управления конфигурациями, версионирования топиков и согласованности между клиентскими версиями. При внедрении изменений следует планировать тестовую среду, миграцию схем и безопасные стратегии переключения нагрузки на новые версии. Эффективная практика предполагает документирование изменений, регламент на откат и сценарии тестирования совместимости в условиях реального потока.
Соответствие требованиям и управление качеством данных
Ключевым элементом является обеспечение качества данных в потоке: целостность, полнота и консистентность. Это достигается через политику контроля в начале конвейера, валидацию на уровне коннекторов, проверку схем и ретрофит логики обработки. В рамках аналитических проектов следует выстраивать процессы мониторинга качества, включая автоматическое уведомление о несоответствиях и регламентированное разрешение инцидентов.
Применение в реальных сценариях
Современные компании применяют Kafka как единый слой обмена данными между оперативной системой транзакций, хранилищем данных и аналитическими панелями. Примеры сценариев включают: (1) онлайн-торговля, где события заказов, платежей и обновлений статуса синхронизируются в реальном времени для дэшбордов и оперативной аналитики; (2) мониторинг бизнес-процессов, где CDC и потоковая обработка обеспечивают своевременное выявление отклонений и детектирование аномалий; (3) управление данными в дата-маркете, где витрины для BI обновляются по каждому событию, а схемы данных эволюционируют с минимальными рисками для существующих потребителей. В реальных проектах важно учитывать организационные аспекты: разделение ответственности между командами данных, операционной поддержкой и бизнес-подразделениями, наличие процессов контроля качества и совместной работы над каталогами данных.
Key takeaways
- Потоковая интеграция через Kafka предоставляет архитектурную основу для аналитических платформ с требованием к актуальности данных и отказоустойчивости.
- Архитектура кластера Kafka, включая партиции и репликацию, обеспечивает масштабируемость и устойчивость к сбоям, но требует продуманного управления оффсетами и семантиками доставки.
- Форматы данных и схемы должны быть хорошо продуманы; использование Schema Registry упрощает эволюцию данных и совместимость между источниками и потребителями.
- CDC, коннекторы и потоковая обработка являются ключевыми паттернами интеграции для аналитики в реальном времени и формируют основу для эффективной архитектуры данных.
- Безопасность, мониторинг и управление качеством данных являются критически важными для продукционных сред и соответствия требованиям регуляторов.
- Эффективная реализация требует тесной интеграции между коннекторами, схемами и обработчиками, а также ясной организационной модели для команд, отвечающих за данные.
- При проектировании инфраструктуры необходимо учитывать требования к задержке, порядку обработки и возможности детерминированной повторной обработки в случае ошибок.
FAQ
- Что такое потоковая интеграция и почему Kafka стал стандартом для аналитических платформ?
Потоковая интеграция - это непрерывная доставка данных из множества источников в целевые хранилища и сервисы обработки в реальном времени. Kafka стал стандартом благодаря своей архитектуре распределенного журнала событий, возможности масштабирования через партиции, устойчивости к сбоям за счет репликаций и гибким семантикам доставки. Он поддерживает единый поток данных между системами, упрощает интеграцию различной экосистемы и обеспечивает согласованность между источниками и потребителями в условиях высокой динамики показателей.
- Как выбрать между at-least-once и exactly-once семантикой доставки в Kafka?
At-least-once обеспечивает надежность доставки, но может приводить к дубликатам в обработке. Exactly-once достигается через сочетание идемпотентных продюсеров, согласованных оффсетов и строгой обработки на потребителе, что снижает вероятность повторной обработки. Выбор зависит от характера обработки: если повторная обработка допустима и можно реализовать идемпотентность, можно начать с at-least-once и постепенно переходить к exactly-once в критичных участках конвейера, где нужно исключить дублирование.
- Какие параметры кластера Kafka критичны для аналитических нагрузок?
Ключевые параметры включают число партиций на топик, размер кластера (количество брокеров), лимиты пропускной способности, параметры репликации и задержек, настройки оффсетов и конфигурации потребителей. В аналитике особенно важно обеспечить низкую задержку, достаточную пропускную способность и устойчивость к сбоям. Регулярная проверка согласованности версий и мониторинг эффективности конвейера помогают поддерживать требуемые SLA.
- Как организовать схему данных и эволюцию без нарушения совместимости?
Реализация требует использования Schema Registry и политик совместимости: назад- или вперед-совместимости, версионирования схем и планирования миграций. Добавление новых полей с дефолтными значениями, поддержка дефолтов и явная миграция исторических данных помогают минимизировать риск. В аналитике это особенно важно, чтобы старые потребители не терпели сбоев, а новые могли работать с обновленными данными.
- Что такое CDC и как реализовать его через Kafka?
CDC внедряется через потоковую передачу изменений из исходной СУБД в Kafka: события отражают вставку, обновление и удаление, что позволяет поддерживать витрины и хранилища актуальными. Реализация требует надежной идентификации ключей изменений, соблюдения сортировки и обработки временных меток, а также интеграции с коннекторами и схемами для корректной передачи изменений в целевые системы аналитики.
- Как обеспечить безопасность и соответствие требованиям в Kafka-платформе?
Необходимо реализовать TLS для шифрования, SASL для аутентификации и ACLs для авторизации. Важно сегментировать доступ по топикам и сервисам, вести аудит действий и поддерживать согласованные политики безопасности и регламентов обработки данных. Регулярно проводятся аудиты и тестирования на проникновение, а также процедуры обновления конфигураций без влияния на производительность.
- Какие паттерны интеграции наиболее эффективны для аналитических целей?
Эффективны паттерны CDC для синхронизации изменений, коннекторы для унификации источников и получателей, а также потоковая обработка для агрегаций и формирования витрин данных. Комбинация паттернов зависит от конкретной архитектуры: иногда целесообразно разделить трафик на несколько топиков по доменам и использовать оконные вычисления для KPI в реальном времени.
- Какие распространенные ошибки встречаются при внедрении и как их избежать?
Типичные ошибки - недостаточное планирование схем и совместимости, неподготовленная инфраструктура для масштабирования, пренебрежение мониторингом задержек и ошибок, а также отсутствие четкой организации по данным и ответственности за конвейеры. Избежать их можно через раннее проектирование схем, тестирование с реальными сценариями, детальный план эксплуатации и формирование команды, отвечающей за данные и их lineage.
- Как оценивать эффективность проекта по потоковой интеграции?
Эффективность оценивается по скорости доставки изменений, точности данных в витринах, времени задержки от источника до аналитики и уровню доступности сервиса. Важны показатели SLA, качество данных, скорость адаптации к изменениям бизнес-требований и экономическая окупаемость проекта с учетом снижения задержек, повышения качества решений и обеспечения прозрачности потоков.
- Какие реальные организационные изменения сопровождают внедрение Kafka в аналитических платформах?
Необходимо выстроить процессы совместной разработки между командами данных, эксплуатации и бизнес-подразделениями, внедрить практики управления версиями схем и конвейеров, организовать централизованное наблюдение за метриками и регулятивное соответствие. Создание культурной традиции документирования lineage и ответственности за данные помогает достигать устойчивых результатов и позволяет быстрее адаптироваться к меняющимся требованиям рынка.


