

Оптимизация выполнения: Catalyst, Tungsten, AQE и динамическое распараллеливание
Современные аналитические хранилища характеризуются необходимостью обрабатывать колоссальные объёмы данных с минимальной задержкой. В Apache Spark ключевые механизмы оптимизации выполнения запросов формируют сложную цепочку: от построения плана и его оптимизаций до эффективного исполнения с минимальными накладными расходами. Глава посвящена трем краеугольным компонентам и одному критически важному подходу к адаптации выполнения под реальные условия - Catalyst, Tungsten, Adaptive Query Execution (AQE) и динамическое распараллеливание. Рассматриваются архитектура, принципы работы и практические аспекты внедрения в крупномасштабных дата-центрах и аналитических хранилищах.
Рассматриваемая совокупность технологий обеспечивает устойчивость к вариативности данных, оптимизирует использование CPU и памяти, снижает shuffle-издержки и ускоряет первые секунды отклика для интерактивной аналитики. В контексте аналитических хранилищ важна не только скорость одного запроса, но и сохранение управляемости плана на уровне всей системы: как Catalyst находит эффективные планы, как Tungsten снижает накладные расходы исполнения, как AQE подстраивает план во время выполнения, учитывая фактические характеристики данных. Данная глава предлагает архитектурную карту, описания алгоритмов и рекомендации по настройке для проектов, где Spark выступает ядром аналитического конвейера.
- Архитектура Catalyst и ее влияние на оптимизацию запросов
- Движок Tungsten: память, кодогенерация и исполнение
- Adaptive Query Execution и динамическое распараллеливание: принципы и паттерны
- Практические подходы к внедрению в аналитические хранилища и работу с внешними формальными слоями (Delta Lake, Iceberg)
Catalyst: архитектура и этапы оптимизации
Catalyst служит основой всей цепочки оптимизации в Spark. Он реализует последовательность преобразований плана: от логического плана до физического плана выполнения, включая анализ, разрешение ссылок и статистик, а также применение правил оптимизации. В контексте аналитических хранилищ главная ценность Catalyst состоит в возможности автоматически:
- объединять условия фильтрации и проекции на ранних этапах;
- внедрять предикат-пушдаун к источникам данных (Parquet, ORC, источники DataSource V2);
- выполнять константное упрощение выражений и устранение избыточной работы;
- управлять выбором физических стратегий через Cost-Based Optimization (CBO) на основе статистики.
Что лежит в основе Catalyst
Catalyst состоит из нескольких слоев, стягивающих логику построения плана и его оптимизации:
- LogicalPlan и Analysis: разбирают запрос, разрешают ссылки на столбцы, таблицы и типы, связывают столбцы с их источниками, валидируют схемы.
- Optimizer: реализует правила на основе правил и оценки стоимости. Здесь реализуются как правило-бейзед оптимизации (Rule-Based Optimization, RBO), так и (с большей ролью в Spark последних версий) Cost-Based Optimization (CBO), который учитывает статистику распределения данных.
- Physical Planning: формирует физические планы выполнения через набор стратегий (Strategies) и выбирает лучший план, учитывая стоимость и предполагаемую эффективность.
- Code Generation: в рамках Whole-Stage Codegen создаётся сгенерированный непосредственно код для конвейера операций, что позволяет снизить накладные расходы на вызовы методов и улучшить локальность данных.
Этапы обработки и роль статистик
Ключевые этапы включают анализ и нормализацию запроса, разрешение неопределённых атрибутов и типов, затем применение правил RBO и, при наличии статистики, включение CBO. В аналитических сценариях статистика становится краеугольной: точность распределения значений, картина частотности значений по источнику и корреляции между столбцами влияют на выбор Планa (например, порядок присоединений, выбор стратегий объединения). Для аналитических хранилищ критически важно регулярно собирать статистику для внешних источников: таблиц Parquet/ORC, Delta Lake, Iceberg и т. д. В противном случае CBO теряет опорные данные и выбирает менее эффективные операции.
Правила и принципы применения
Среди правил Catalyst встречаются такие направления, как:
- PushdownPredicate и PruneFilters: перенос фильтров к источнику данных и сокращение объёма проходящих данных.
- Constant Folding и Simplification: развёртывание константных выражений и упрощение условий.
- Null-safe операции и коррекция типов: устранение ложных совпадений и неявных преобразований.
- Join Reorder и Join Hints: переупорядочивание соединений на основе оценок стоимости, когда статистика доступна.
CBO становится особенно полезным, когда источники данных богаты статистикой. В аналитических хранилищах он позволяет перестраивать планы в зависимости от реального объема данных, плотности распределения и суммы выборок, снижая расходы на Shuffle и неэффективное объединение. Встроенная поддержка DataSource V2 облегчает сбор статистик на уровне источников и передаёт их в Catalyst для принятия решений.
Интеграции и практические аспекты
Интеграция Catalyst с внешними источниками данных требует правильной конфигурации источников: Parquet/ORC с поддержкой predicate pushdown, Delta Lake/ Iceberg - с учётом специфик транзакций и версии схем. Рекомендовано периодически запускать ANALYZE TABLE (или эквивалентные команды в рамках Delta/ Iceberg) для обновления статистик. В реальном проекте важно помнить, что слишком агрессивное pushdown может привести к перерасходу энергии на вычисления в источнике или к несовместимым сценариям чтения. Оптимальной является конфигурация, дающая Catalyst достаточно информации для выборов, но не перегружая источники.
- Применение Catalyst в аналитических хранилищ требует внимания к данным метаданных: актуальные схемы, обновления таблиц и режимы транзакций. Многие практики рекомендуют держать статистику актуальной и включать CBO для ключевых цепочек обработки.
- Для проектов с Delta Lake или Iceberg целесообразно совместить AQE и DPP (Dynamic Partition Pruning) с умной настройкой shuffle и квази-динамической перестановкой параллелизма.
from pyspark.sql import SparkSession
spark = SparkSession.builder.appName("CatalystExample").getOrCreate()
## Включение базовых возможностей оптимизации
spark.conf.set("spark.sql.cbo.enabled", "true")
spark.conf.set("spark.sql.adaptive.enabled", "true")
Tungsten: движок выполнения и его эффекты
Tungsten представляет собой эволюцию движка выполнения Spark, нацеленного на минимизацию накладных расходов виртуальной машины JVM и повышение эффективности вычислений за счёт более плотной памяти, прямого доступа к данным и генерации кода на лету. Элементы Tungsten обеспечивают значительную экономию CPU cycles и улучшение пропускной способности обработки за счёт более эффективной памяти и конвейерной обработки.
Архитектура памяти и кодогенерация
Tungsten внедряет принципы:
- Упор на Umgang memory management: управление памятью через гибридную схему, совместно с управлением памятью исполнения и данным в столбцах.
- UnsafeRow и бинарная репрезентация: компактная, колоночная и быстрая сериализация/десериализация, что уменьшает нагрузку на сборщик мусора и ускоряет проход по данным.
- Whole-Stage Codegen: компиляция длинных участков выполнения в единый фрагмент кода JVM, позволяющий удалить лишние проходы по структурам данных и снизить накладные расходы на вызовы функций. Это ускоряет линейные стадии агрегаций, фильтраций и трансформаций.
- Векторизация и ускорение вычислений: по возможности Spark использует векторизированную обработку столбцов форматов Parquet/ORC, что дополнительно увеличивает пропускную способность.
Эти механизмы совместно приводят к существенному снижению задержек и росту пропускной способности, особенно на больших таблицах с широкими колонками и сложными агрегациями. Однако у Tungsten существуют ограничения: некоторая динамика планов может приводить к ухудшению времени компиляции кода, для очень больших планов с многочисленными выражениями кодогенерация может быть затратной по памяти на этапе генерации. В таких случаях полезно использовать режимы плавного включения возможностей по мере необходимости.
Форматы данных, память и совместимость
Tungsten тесно связан с форматом данных и схемой хранения: эффективная сериализация и д максимальная совместимость с файловыми форматами, поддерживающими Columnar Storage (Parquet, ORC). При этом оптимизация памяти требует внимательности к размерам буферов и настройкам memory management, особенно в окружениях с ограниченными ресурсами или многопользовательской загрузкой. В аналитических хранилищах рекомендуется балансировать между эффективной кодогенерацией и стабильной доступностью памяти, чтобы избежать неожиданной перезагрузки узлов или нехватки мазута памяти.
Практические следствия и рекомендации
- Включение Whole-Stage Codegen обычно даёт заметный выигрыш для больших и сложных запросов: агрегации, объединения и фильтрации.
- В условиях сильной параллелизации и значительного объёма данных стоит следить за размером сгенерированного кода. При крупных планаx кодогенерация может достигать больших объёмов, и в некоторых случаях разумно ограничить её настройками среды выполнения.
- Правильная настройка памяти (как on-heap, так и off-heap) и управление границами памяти критично для стабильности выполнения.
Adaptive Query Execution: адаптивная оптимизация выполнения и динамическое распараллеливание
AQE представляет собой стратегию адаптации выполнения запроса на лету на основе реальных характеристик данных, полученных во время исполнения. Главная идея - сдвиг планов в ответ на фактические данные, которые не были известны на момент компиляции. Это особенно ценно в аналитических хранилищах, где данные могут быть неравномерно распределены, иметь skew, или когда источники данных обладают непредсказуемой статистикой.
Принципы AQE
- Адаптивная перестройка плана: временные статистики после стадий shuffle позволяют пересмотреть план соединения, порядок присоединений и выбор стратегий объединения.
- DPP (Dynamic Partition Pruning): динамически устранение лишних разделов на ранних стадиях выполнения, сокращая количество обрабатываемых данных.
- Переработка shuffle-стратегий: на основе фактических размеров shuffle и количества чтений - выбор числа разделов после shuffle, coalescing и перераспределение нагрузки.
AQE успешно работает в сочетании с Catalyst и Tungsten: Catalyst формирует первоначальный план, AQE в ходе выполнения может менять стратегию соединения и сортировки, а Tungsten обеспечивает эффективное исполнение полученного плана с учётом изменений.
Механизмы и сценарии применения
- Адаптивное включение/выключение DPP: когда AO (adaptive optimizations) обнаруживает, что часть данных существенно отличается по размеру, AQE может включить динамическое удаление разделов.
- Переключение стратегий join: если загруженность или размер неравно распределённых данных отличается, AQE может перейти к более подходящей стратегии соединения, например к BroadcastHashJoin для малых таблиц или к ShuffleHashJoin для больших.
- Адаптация числа разделов shuffle после выполнения: Spark может уменьшать или увеличивать количество разделов после shuffle в зависимости от реального трафика, тем самым снижая накладные расходы на этапы shuffle.
Практические примеры и настройки
В реальных условиях AQE эффективен при наличии непредсказуемых профилей данных и сложных цепочках операций, где статистика источников не отражает итоговую картину. Чтобы включить AQE и сопутствующие механизмы в PySpark, можно использовать следующие настройки:
- Включение Adaptive Query Execution
- Разрешение коалесценции разделов
- Включение DPP
- Включение коэффициентов планирования на уровне CBO
from pyspark.sql import SparkSession
spark = SparkSession.builder.appName("AQEExample").getOrCreate()

## Включение адаптивной оптимизации
spark.conf.set("spark.sql.adaptive.enabled", "true")
## Включение коалесценции разделов после shuffle
spark.conf.set("spark.sql.adaptive.coalescePartitions.enabled", "true")
## Включение Dynamic Partition Pruning
spark.conf.set("spark.sql.dynamicPartitionPruning.enabled", "true")
## Включение Cost-Based Optimizer
spark.conf.set("spark.sql.cbo.enabled", "true")
## Опционально: управление числом разделов на shuffle
spark.conf.set("spark.sql.adaptive.shuffle.targetPostShufflePartitionSize", "128MB")
AQE требует внимательного контроля за статистикой и устойчивостью к изменению планов. В аналитических хранилищах применение AQE может привести к значительному снижению времени отклика для интерактивной аналитики и уменьшению сетевых и вычислительных издержек на больших конвейерах.
Динамическое распараллеливание и мониторинг
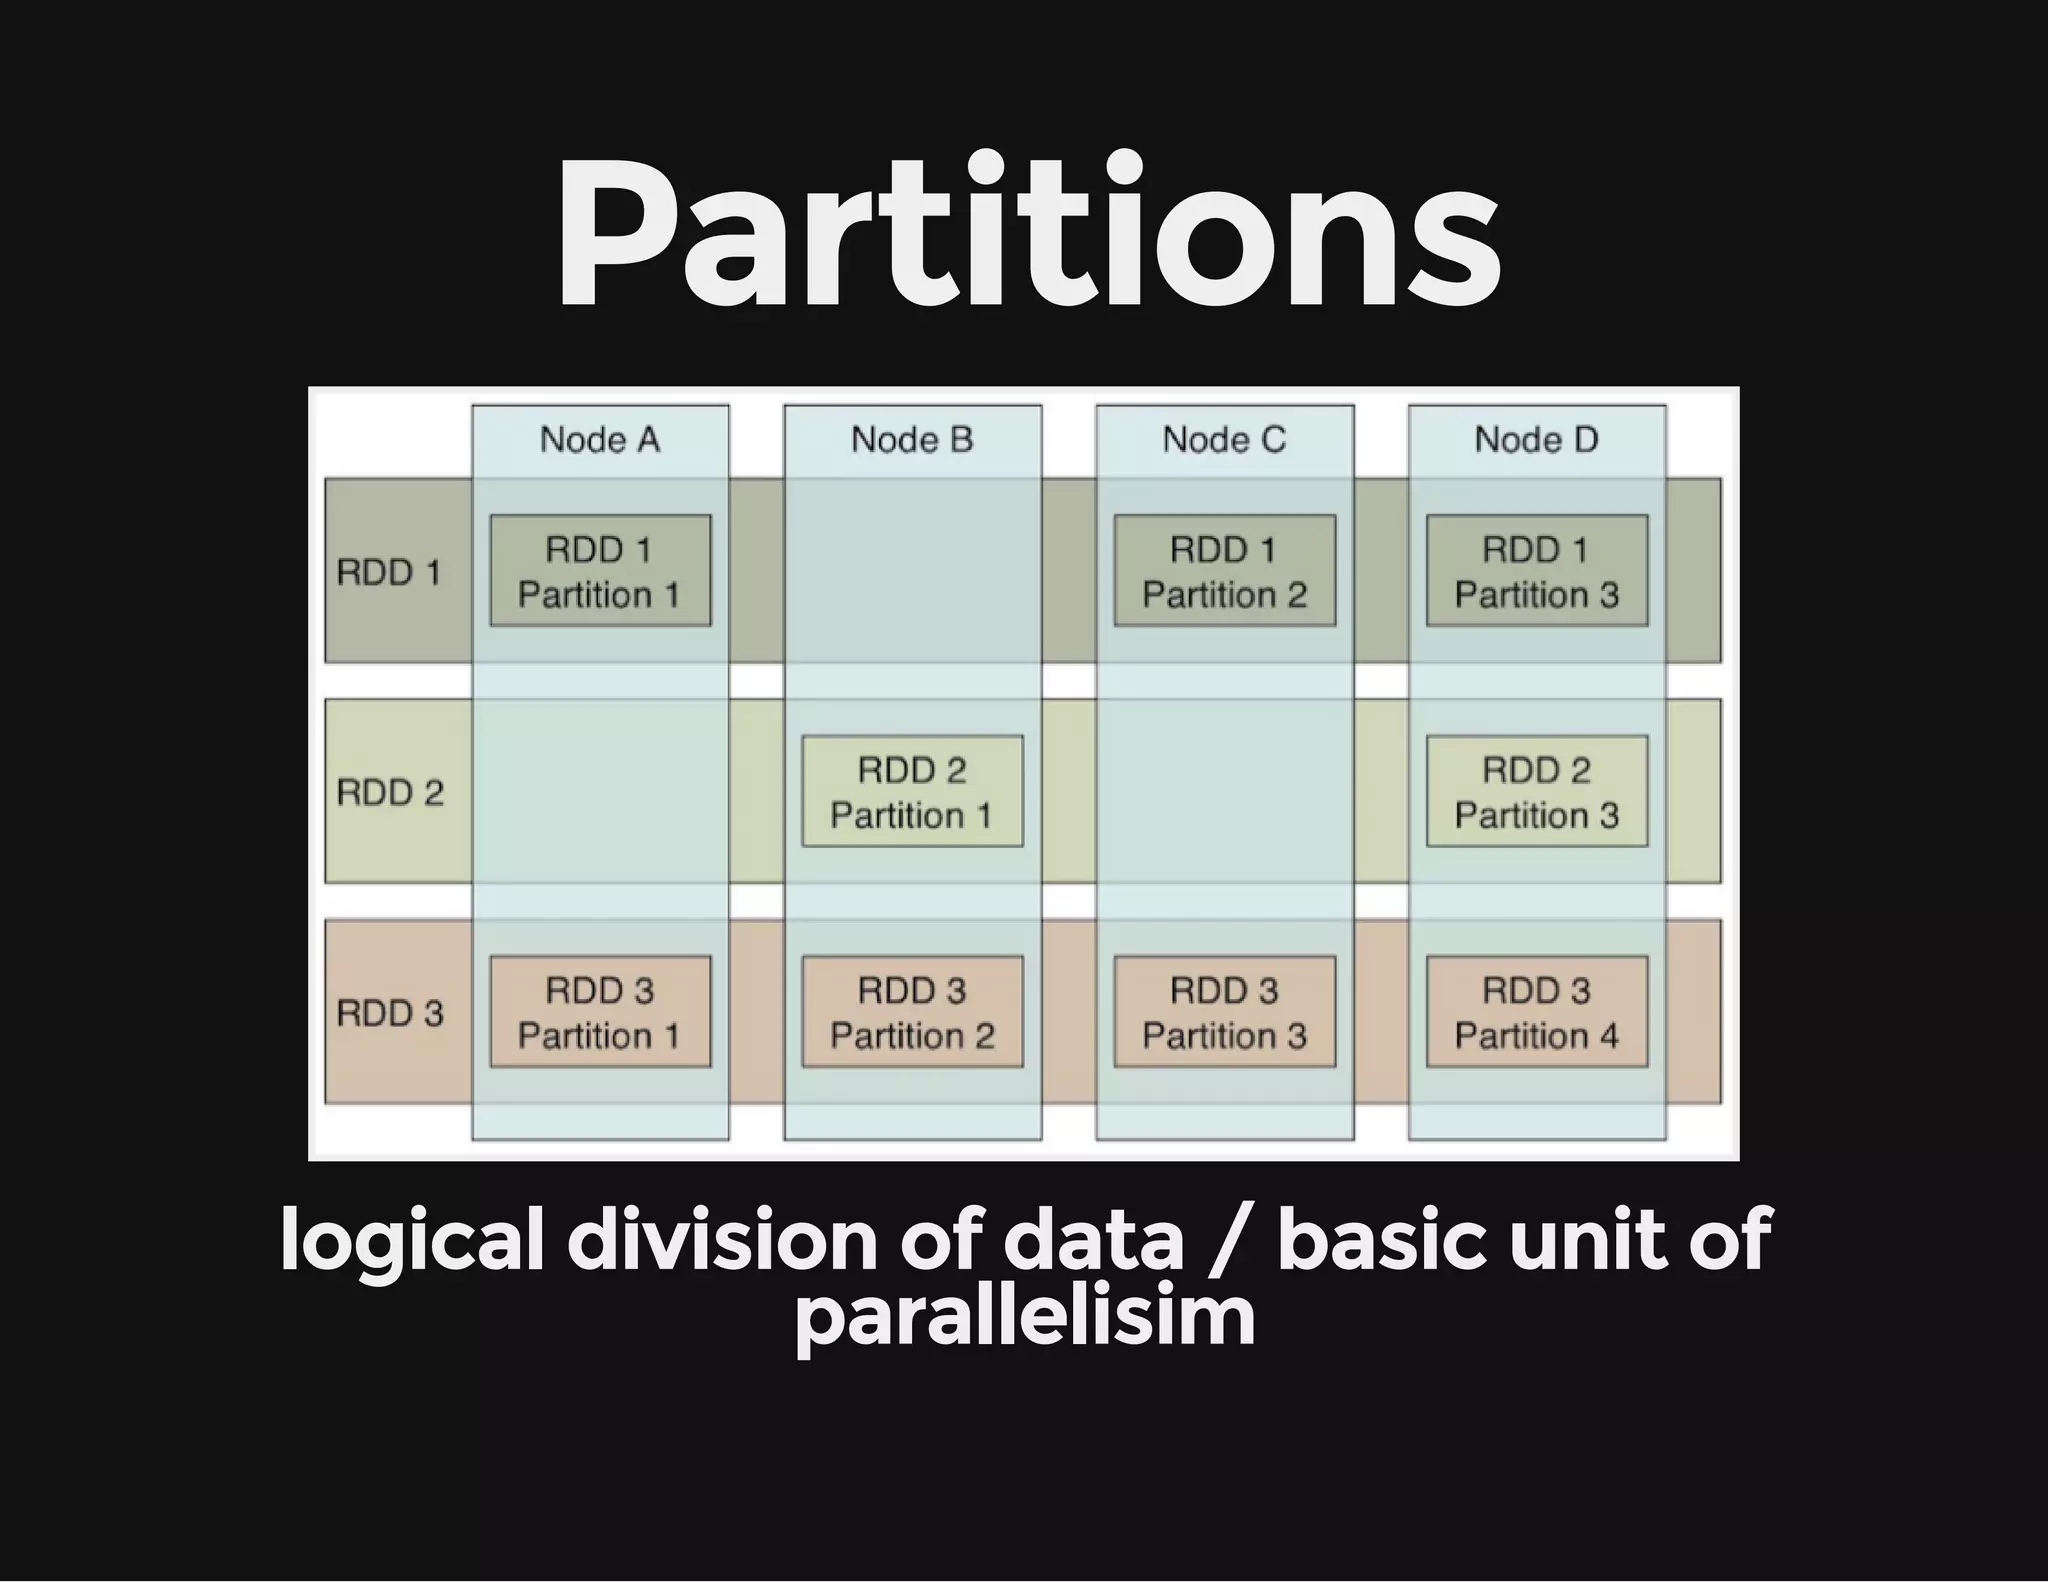
Динамическое распараллеливание в Spark - это комплекс механизмов, который адаптирует распределение задач между executors на основе текущей загрузки и объёма данных. Это осуществляется через:
- динамическое Allocation Executors: добавление/удаление executors в кластере для удержания желаемой загрузки;
- адаптивное управление числом shuffle-партитивов: перераспределение нагрузки между задачами после shuffle;
- интеграция с AQE для изменения физического плана во время выполнения.
Эти принципы особенно полезны в аналитических хранилищах, где данные могут быть динамичными и характер нагрузки может меняться в течение суток.
Практические аспекты внедрения в аналитические хранилища
Опыт внедрения в реальных проектах подсказывает, что оптимизация выполнения - не только настройка компонентов Spark, но и процессный подход к инсталляции, мониторингу и управлению качеством данных. Ниже приведены практические направления, которые применяются в современных аналитических инфраструктурах.
Стратегии настройки и эксплуатация
- Стратегия по включению AQE и CBO: активируйте AQE по умолчанию на средах, где данные распределены неравномерно. Включение CBO особенно полезно при работе с несколькими источниками данных, где статистика поддерживает сопоставления.
- Мониторинг и observability: используйте Spark UI и внешние средства мониторинга для анализа планов исполнения, времени выполнения и распределения задач. Регулярно собирайте статистику по источникам и поддерживайте её актуальной.
- Управление ресурсами кластера: применяйте динамическое выделение и настройку памяти так, чтобы Spark мог адаптироваться к пиковым нагрузкам без перегрузки узлов.
- Интеграции и транзакции: Delta Lake и Iceberg требуют учёта режимов транзакций и версионирования; рекомендуется сохранять актуальную статистику и правильно конфигурировать источники.
Интеграции с Delta Lake и Iceberg
Delta Lake и Iceberg обеспечивают надёжность данных и атомарные транзакции, но требуют корректной поддержки Cataylst-AQE-DB-процессов:
- Delta Lake: статические и динамические статистики для оптимизации плана и ускорения чтения. AQE и DPP в Delta Lake работают синхронно с локальными транзакциями; важно помнить о совместимости версий.
- Iceberg: поддержка схем и метаданных в динамическом контексте, включая паттерны чтения и записи. Catalyst и AQE должны учитывать версии и метаданные Iceberg, чтобы корректно перестраивать планы во время выполнения.
Мониторинг производительности и диагностика
- Анализ планов выполнения: сравнивайте Logical, Optimized и Physical плана, чтобы выявлять узкие места в Cataylst и Tungsten.
- Метрики выполнения: отклики, время shuffle, Shuffle Read/Write, количество задач (tasks), коэффициент параллелизма.
- Специфические паттерны: skew в данных, неравномерная нагрузка в джоинах, чрезмерная фильтрация, неэффективная кодогенерация.
Key takeaways
- Catalyst обеспечивает фундаментальные механизмы оптимизации на этапе планирования: анализ, правила и CBO, что критично для выбора эффективного физического плана в аналитических сценариях.
- Tungsten и Whole-Stage Codegen снижают накладные расходы JVM и улучшают локальность данных, но требуют внимательного управления размером сгенерированного кода и памяти.
- AQE позволяет адаптировать выполнение на лету: перестроение планов, DPP и динамическая коалесценция разделов помогают сокращать объем обрабатываемых данных и время выполнения.
- Динамическое распараллеливание и адаптивное распределение ресурсов повышают устойчивость к вариативности нагрузки и масштабируемость кластера.
- Практическая выгода достигается через сочетание Catalyst, Tungsten и AQE в инфраструктуре аналитических хранилищ: грамотная настройка источников данных, статистик и режимов выполнения.
- Важна интеграция с внешними системами (Delta Lake, Iceberg) и поддержка методов транзакций и версий; это требует согласованных подходов к планированию и мониторингу.
- Для эффективного внедрения критична систематическая практика диагностики планов, корректировка статистик и выбор схем оптимизации под конкретный профиль данных.
FAQ
- Что такое Catalyst и зачем он нужен в Spark?
Catalyst - это фреймворк для оптимизации выполнения запросов в Spark. Он преобразует логический план запроса в физический через последовательность этапов: анализ, разрешение ссылок, оптимизацию правил (RBO) и, при наличии статистик, применение Cost-Based Optimization (CBO). Catalyst обеспечивает предикат-пушдауны, упрощение выражений, переразмещение джойнов и выбор эффективного физического плана. Это позволяет Spark автоматически подстраивать план под структуру данных и источников, снижая задержки и накладные расходы.
- В чем различие между Catalyst и Tungsten?
Catalyst работает над логикой и стратегиями планирования: что и как нужно выполнять, какие операции объединять, какие фильтры перенести к источнику. Tungsten же отвечает за исполнение: память, представление данных в компактном виде, кодогенерацию (Whole-Stage Codegen) и эффективную обработку данных во время выполнения. В сочетании они обеспечивают как качественный план выполнения, так и эффективное и быстрое исполнение.
- Что даёт Whole-Stage Codegen и где он может быть ограничен?
Whole-Stage Codegen объединяет несколько операций в единый сгенерированный фрагмент кода JVM, что уменьшает накладные расходы на вызовы методов и упрощает обработку потока данных. Это даёт существенный выигрыш на больших конвейерах. Ограничения могут проявляться на очень больших и сложных планах, где размер сгенерированного кода становится значительным, что может влиять на компиляцию и потребление памяти. В таких случаях разумно настраивать параметры и, при необходимости, отключать отдельные участки кодогенерации.
- Какие преимущества даёт AQE и когда он особенно полезен?
AQE адаптивно изменяет план выполнения на основе реальных данных, получаемых во время исполнения: перестраивает соединения, выбирает стратегию агрегаций и применяет DPP. Это особенно полезно, когда данные распределены неравномерно, статистика не полностью отражает текущие условия, или когда во время выполнения становится ясно, что выбранный план неэффективен. AQE снижает время отклика в интерактивной аналитике и уменьшает сетевые издержки.
- Что такое DPP и как он работает в Spark?
DPP (Dynamic Partition Pruning) - это механизм, который на лету исключает ненужные разделы во время выполнения для JOIN-операций и фильтраций. Он сокращает количество обрабатываемых строк и снижает объем Shuffle-данных. В Spark DPP чаще всего активируется в рамках AQE и зависит от корректной статистики и сценариев выполнения.
- Как настроить Spark для аналитических хранилищ с учетом Delta Lake или Iceberg?
Delta Lake и Iceberg требуют корректной работы Catalyst и AQE с учётом транзакций, версионирования и схем. Рекомендуется держать статистику актуальной (ANALYZE TABLE или аналоги в Delta Iceberg), активировать CBO и AQE, и внимательно мониторить планы выполнения. Обоймы транзакций и версий должны быть согласованы с планами выполнения. В случае связки с Delta Iceberg рекомендуется тестировать конфигурации в staging-окружениях перед продакшном.
- Какие признаки указывают на необходимость настройки AQE и изменения параллелизма?
Если вы наблюдаете большие задержки на ранних стадиях выполнения, частые перепланирования джойнов, значительную долю данных в Shuffle и skew-образования, AQE может принести пользу. Непредсказуемость нагрузки и вариативность входных данных - прямые сигналы для включения AQE и адаптивного перенастроения числа разделов.
- Как оценивать влияние Catalyst на план выполнения?
Оценка производится через сравнение планов до и после оптимизаций: LogicalPlan vs Optimized LogicalPlan vs PhysicalPlan. В Spark UI можно увидеть план выполнения, стоимость операций и shuffle-количество. Анализ позволит понять, какие правила применяются и где происходят изменения.
- Какие принципы интеграции архитектурных компонентов важны для команд по данным?
Важно обеспечивать согласованность версий Spark, поддерживающих AQE и CBO, а также синхронизировать статистику данных с источниками. Рекомендовано наличие стандартов по обновлению статистик, тестирование новых версий в staging и всесторонний мониторинг после перехода на новую конфигурацию.
- Какие сценарии оптимизации чаще всего встречаются в аналитических хранилищах?
Наиболее частые сценарии - долгие джоины между большими таблицами, агрегации с большим числом группировок, фильтрации больших датасетов и чтение из нескольких источников. Catalyst и AQE помогают автоматически подобрать лучший план и перераспределить нагрузку. Tungsten обеспечивает эффективное исполнение, особенно когда размеры данных велики и требуется высокая пропускная способность.
Эта глава призвана дать как теоретическое основание, так и практические инструменты для проектирования эффективных конвейеров обработки данных в Spark для аналитических хранилищ. Правильная настройка Catalyst, эффективная реализация Tungsten и грамотное применение AQE в сочетании с динамическим распараллеливанием позволяют достигать устойчивых результатов на больших данных и обеспечивают конкурентоспособные сроки отклика для бизнес-аналитики и операционных задач.


