

Lakehouse и Data Lake: принципы интеграции
Lakehouse представляет собой концепцию объединения масштабируемости Data Lake и управляемости Data Warehouse. В ней хранение остаётся без ущерба для гибкости и стоимости, а обработка и консистентность - поддерживаются посредством транзакционных слоёв над объектным хранилищем. В рамках данного раздела рассматриваются архитектурные принципы, набор паттернов встроенной интеграции и практические рекомендации по реализации на стеке Apache Spark: как обеспечить ACID-транзакции, управление схемами, метаданными и версиями данных, как проектировать пайплайны ETL и ELT, а также какие решения открытого исходника и коммерческие продукты полезны в современных Lakehouse-окружениях.
Lakehouse-архитектура строится вокруг трёх ключевых компонентов: устойчивого хранилища Parquet и прочих форматов, транзакционного слоя над данным слоем и слоя метаданных с Catalog/Metastore. Хранилище состоит из файловой системы на базе object storage (S3, ADLS, GCS и т. п.) и формата Parquet, который обеспечивает эффективное сжатие и столбцовую ориентацию. Транзакционный слой, такой как Delta Lake, Apache Iceberg или Apache Hudi, добавляет в этот набор ACID-транзакции, управление схемами и версионность. Метаданные и каталог данных позволяют обеспечивать поиск, гейтвэй доступности и контроль качества без полного копирования данных. Вместе они формируют единый источник правды для аналитики, источников данных и ML-обучения.
Структура главы ориентирована на архитектуру, схемы и протоколы, а также на конкретные сценарии интеграции и реализации. Ниже приводятся ключевые концепты и принципы, за которыми следует практическая часть с примерами реализации на Spark.
- Гибридность хранения и обработки: хранение в Data Lake остаётся основной платёжной единицей, но над ним реализованы транзакционные границы и версии данных, что позволяет выполнять полноценные запросы уровня Data Warehouse и обеспечивать согласованность при конкурентном доступе.
- Транзакционные слои: Delta Lake, Iceberg, Hudi выступают как «слой над хранилищем», реализующий ACID-операции, time travel, схему и данные без блокировок, поддержку параллельного чтения и записи.
- Каталогизация и метаданные: Data Catalog обеспечивает единый поиск и доступ к наборам данных, служит источником для lineage и governance. Важно выбрать подходящий уровень интеграции со Spark и внешними аналитическими инструментами.
- Модели данных и схем: lakehouse поддерживает эволюцию схем, но требует управления совместимостью бизнес-логики и аналитических запросов. Важно проектировать поля и версии так, чтобы изменения не ломали существующие пайплайны.
- Интеграция с Spark: Spark 3.x поддерживает нативные коннекторы к Delta Lake, Apache Iceberg и Apache Hudi, обеспечивает чтение/запись, time travel и оптимизацию выполнения через фильтрацию и партиционирование. При этом важны конвенции именования, схемы таблиц и единый подход к обработке изменений.
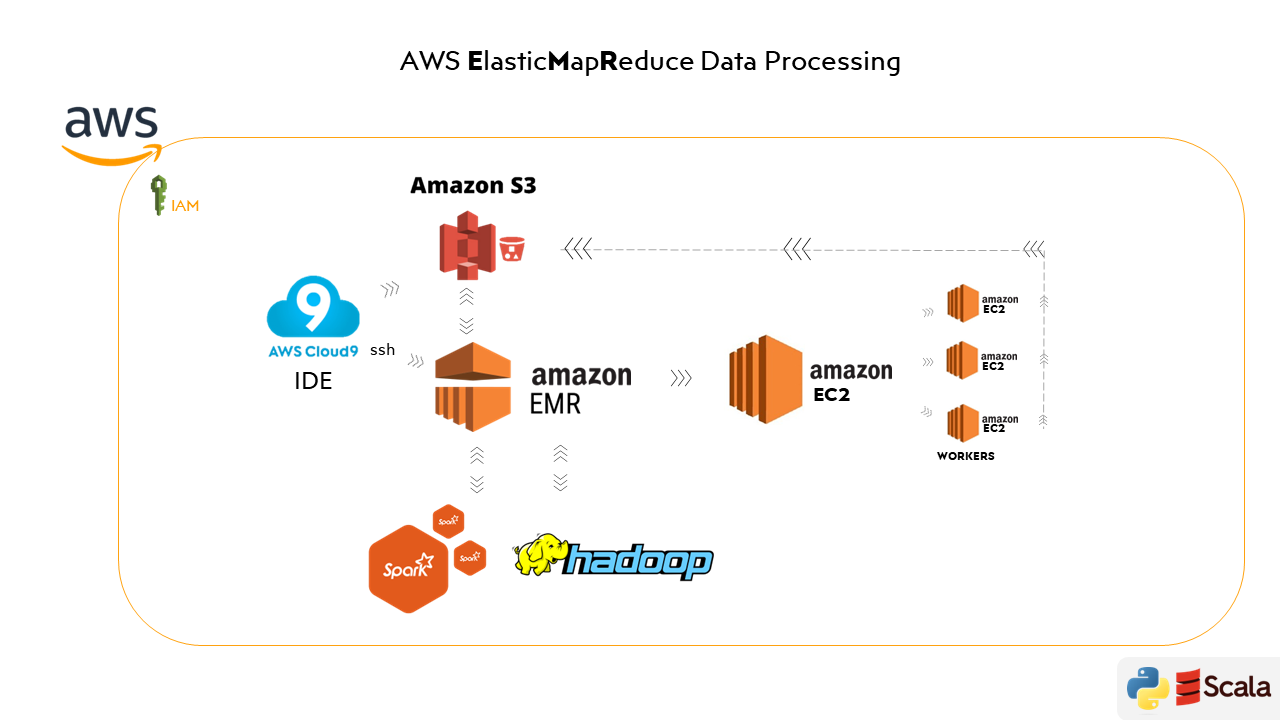
Архитектура Lakehouse и Data Lake: принципы и паттерны
Ключевые элементы архитектуры Lakehouse можно рассмотреть через три уровня ответственности: слой хранения, слой транзакций и слой метаданных. На уровне хранения используется объектное хранилище с разделением данных на секции: raw, trusted, curated. Это разделение позволяет минимизировать риск влияния дефектов на бизнес-аналитику: неиспорченные данные попадают в curated-зону, где происходят финальные агрегации и подготовка к загрузке в BI/ML.
С точки зрения протоколов и взаимодействий между компонентами в рамках Spark-инфраструктуры, важны следующие моменты:
- ACID и консистентность: транзакционный слой обеспечивает атомарность операций записи и читаемые погодные данные для одновременных процессов. В Delta Lake, Iceberg и Hudi реализована схема «оптимистической блокировки» с журналом изменений (transaction log), который служит источником истины для всех потоков чтения.
- Схемы и эволюция:: изменения в схеме (добавление/удаление столбцов, изменение типов) должны быть поддержаны без прерывания текущих пайплайнов. В рамках Lakehouse такие изменения реализуются через управление версионностью и совместимостью схем в метаданных.
- Метаданные и каталогизация: единый каталог данных (например, Apache Atlas, AWS Glue Data Catalog, DataHub) позволяет отслеживать происхождение данных, lineage, качество и доступность. Каталог обеспечивает совместимость между различными вычислительными слоями и инструментами аналитики.
- Обогащение и трансформация: пайплайны должны поддерживать "ELT-приоритет" - данные сначала загружаются в сырые зоны, затем постепенно трансформируются в управляемые слои, чтобы уменьшать задержки и повышать гибкость анализа.
- Интеграция с BI и ML: единый слой данных упрощает доступ BI-инструментам и моделям машинного обучения. Время путешествия (time travel) и версия данных помогают воспроизводимости и аудиту анализа.
В качестве примеров архитектурного выбора можно привести следующие паттерны:
- Паттерн 1: единый слой Lakehouse с тремя зонами (raw, trusted, curated) и централированием транзакций через Delta Lake. Все источники данных - через Spark-пайплайны - загружаются в raw, затем проходят преобразование и попадают в curated. Такой подход упрощает аудит и воспроизводимость.
- Паттерн 2: мультислой Lakehouse с поддержкой нескольких форматов и версий: Parquet как долговременное хранение, Flux-слой транзакций для обмена данными между командами, каталоги данных и политики доступа. Такой подход полезен в организациях с разнородной инфраструктурой и несколькими облаками.
- Паттерн 3: распределённая аналитика с гибридной моделью, когда часть данных размещается в кластерах Spark на месте, часть - на внешних аналитических платформах, но метаданные и контроль качества поддерживаются в каталоге и через транзакционный слой.
Интеграцию Spark с Lakehouse лучше рассматривать не как одноразовую миграцию, а как эволюционный процесс: сначала обеспечить базовую читаемость и доступность через формат Parquet и каталоги, затем добавить транзакционный слой, а после - полноценно развивать управление версиями, lineage и governance.
-- Пример создания внешней Delta-таблицы через Spark
-- В этой операции создаётся таблица как управляемая Delta Lake версия над существующим путём
CREATE TABLE IF NOT EXISTS delta_table
  (order_id BIGINT, customer_id BIGINT, amount DOUBLE, ts TIMESTAMP)
USING DELTA
LOCATION '/lake/data/curated/sales';
Хранение данных и схемы: Parquet, форматирование, конвенции
Parquet остаётся основным форматом хранения в Lakehouse благодаря своей эффективности для аналитических запросов: столбцовый формат обеспечивает сжатие и быстрый доступ к необходимым полям. Однако границы Parquet расширяются, когда речь идёт о транзакциях и управлении схемами. В Lakehouse допустимы следующие принципы:
- Разделение по зонам: raw-зона хранит данные в их исходной форме, часто с минимальной обработкой; trusted-зона содержит данные после несложной очистки; curated-зона - готовые к аналитике и использованию бизнес-логикой. Такое разделение упрощает линейку задач и контроль качества.
- Управление схемой: эволюция схем должна быть безопасной и детерминированной. Добавление столбцов и изменение типов возможно через команды ALTER, но важно поддерживать совместимость потребителей и версий данных. Транзакционные слои, как Delta Lake, позволяют хранить версии схем и осуществлять миграцию без прерывания выполнения пайплайнов.
- Фичи Parquet и оптимизации: поддержка predicate pushdown, статистик, сжатие, распределение файлов, партиционирование по ключам бизнес-логики. В Lakehouse важно проектировать стратегии партиционирования и кластеризации файлов для минимизации IO и увеличения скорости запросов.
- Метаданные и каталогизация: схемы, версии данных, источники, дата публикации и владельцы - всё это хранится в каталоге и прикрепляется к конкретной версии таблицы. Это критично для воспроизводимости анализа и аудита.
Базовые принципы конвенций по именованию и структурам:
- Имена таблиц и файлов должны отражать бизнес-дреды: например, curated.sales, raw.events, trusted.user_profiles. Это упрощает поиск и версионирование.
- Партиционирование, как правило, строится по временным признакам (date, month) и по бизнес-ключам, которые часто являются фильтрами в аналитических запросах.
- Эволюция схем должна быть пошаговой, с уведомлением о несовместимости. В идеале потребители, зависящие от старой схемы, должны иметь возможность перехода на новую версию без простоя.
-- Пример добавления нового столбца в Delta-таблицу (схема эволюционирует безопасно)
ALTER TABLE delta.`/lake/data/curated/sales` ADD COLUMNS (promotion_code STRING);
Замечание: поддержка изменения схем и их экзогенизация зависят от выбранного транзакционного слоя. Delta Lake обеспечивает схему эволюцию через команды ALTER TABLE, Iceberg - через аналогичные операции, но с иными ограничениями и версиями аксессоров. В любом случае, ключевой принцип - прозрачная версионирование и обратная совместимость для потребителей.
Протоколы и транзакции: ACID, согласованность, эволюция схем
Главное преимущество Lakehouse - переход к единым транзакционным свойствам над гигантскими наборами данных, которые ранее обходились без ACID-поддержки. В рамках Spark и транзакционных слоёв это реализуется через:
- ACID-транзакции на уровне файлов и журналов изменений. Любая запись добавляется атомарно и читается консистентно. Журналы изменений (transaction logs) содержат информацию о коммитах, снимках и метаданных. Это позволяет всем читателям видеть одно и то же состояние данных без блокировок чтения.
- Уровень изоляции и консистентности чтения. Читатели получают стабильное представление данных в рамках конкретной версии, что особенно важно для повторяемой аналитики и аудита.
- Эволюцию схем без прерываний. Добавление столбцов, изменение типов и удаление столбцов должны осуществляться безопасно, с поддержкой версий для обратной совместимости. Совместно с каталогами это обеспечивает согласованность между структурами данных и бизнес-потребителями.
- Time travel и версия данных. Возможность возвращаться к конкретной версии данных или к конкретной временной точке упрощает диагностику и регрессионный анализ.
В контексте Spark это означает, что чтение из delta.amazon/sales или iceberg таблицы может происходить без блокировки, а записи - с сохранением консистентности. Применение этих механизмов критично для расчетных пайплайнов, где данные поступают из разных источников и должны оставаться согласованными в течение длительного времени.
-- Пример чтения временного snapshot в Delta Lake
SELECT * FROM delta.`/lake/data/curated/sales` TIMESTAMP AS OF '2024-10-01 00:00:00';
Интеграция и пайплайны: ETL/ELT, управление метаданными, data lineage
Построение Lakehouse-архитектуры начинается с проектирования пайплайнов, которые поддерживают как ELT-подход, так и стратегию modularity. В основе лежат следующие принципы:
- ELT как основной паттерн: данные загружаются в сырые зоны и затем трансформируются в управляемые слои, где бизнес-логика выражается как повторяемые процессы. Это позволяет разделять задачи подготовки данных и анализа, ускоряя внедрение изменений и обеспечивая прозрачность.
- Единый журнал изменений и lineage: каждое изменение данных и схемы записывается в метаданные; lineage связывает источник данных, этап обработки и конечный набор, что критично для аудита, соответствия и качества.
- Метаданные как актив: каталог обеспечивает поиск, автоматическое обнаружение и управление версиями набора данных. В идеале Catalog должен поддерживать интеграцию с инструментами качества данных, мониторинга и BI.
- Управление качеством: наличие встроенных тестов на данные (data quality) и политики согласования для предотвращения попадания грязных данных в curated-зону. Great expectations и аналогичные решения могут быть частью конвейера качества.
При реализации важно определить роли и ответственности команд, выстроить процессы мониторинга и алертинга по качеству данных и обеспечить устойчивость к сбоям. В реальных сценариях может потребоваться миграция от старых подходов к более прозрачной и управляемой архитектуре - с постепенным переходом на Lakehouse без прерывания операций.
- Каталоги и совместимость: интеграция через Hive Metastore или Glue Data Catalog обеспечивает совместимость Spark SQL, BI и ML-инструментов. В Lossless-окружении возможно использование внешнего каталога и совместной политики доступа.
- Интеграция с аналитическими платформами: BI-инструменты, модели ML и аналитические сервисы - все они должны иметь доступ к тем же версиям данных через единый слой. Time travel и версия данных значительно упрощают воспроизводимость анализа.
- Пример паттерна: ingestion -> raw -> trusted -> curated -> data products. Каждая стадия отвечает за свой уровень качества и доверия, что упрощает управление версиями и согласованность между командами.
-- Пример записи данных в Delta Lake как часть ELT-пайплайна
-- Шаг 1: загрузка сырых данных
spark.read.format("json").load("/ingest/raw/events/").write.format("delta").mode("append").save("/lake/data/raw/events");

-- Шаг 2: преобразование и загрузка в trusted
val events = spark.read.format("delta").load("/lake/data/raw/events")
val cleaned = events.filter("event_type IS NOT NULL").withColumn("processed_at", current_timestamp())
cleaned.write.format("delta").mode("overwrite").save("/lake/data/trusted/events");

-- Шаг 3: агрегация и загрузка в curated
val agg = spark.read.format("delta").load("/lake/data/trusted/events")
  .groupBy("customer_id").agg(sum("amount").as("total_spent"), max("processed_at").as("last_seen"))
agg.write.format("delta").mode("overwrite").save("/lake/data/curated/summary");
Замечание: в приведённом примере демонстрируется общий подход ELT-пайплайна. Реальный разбор зависит от объема данных, частоты обновления и требований к SLA. В реальных системах часто используется автоматизация повторяющихся шагов через orchestration-инструменты (например, Airflow, Dagster) и инструменты мониторинга качества.
Управление данными и безопасность
Lakehouse требует системной защиты данных на уровне мастер-данных, доступов, аудита и соответствия. В контексте Spark и Lakehouse рекомендуется:
- Реализовать ролей и политик доступа через Catalog и внешний слой IAM/ACL. Разграничение между пользователями и приложениями: что можно читать, писать и изменять в разных зонах.
- Внедрять процессы проверки качества данных и автоматическое уведомление в случае отклонений. Это обеспечивает своевременный отклик на дефекты и уменьшает риск распространения ошибок.
- Контролировать дублирование и версионирование: поддержка time travel помогает управлять регрессиями, а хранение нескольких версий выявляет генезис проблем.
| Пример открытых решений | Характеристика |
|---|---|
| Delta Lake (open-source) | ACID-транзакции над Parquet, time travel, schema evolution, немного более тесная интеграция с Spark. |
| Apache Iceberg | Формально независимый формат, поддержка больших схем, артефактная совместимость, мульти-форматная архитектура. |
| Apache Hudi | Хорош для инкрементной загрузки и потоковых пайплайнов, поддерживает параллельное чтение и запись. |
Важно помнить, что выбор между Delta Lake, Iceberg и Hudi зависит от существующей инфраструктуры, требований к миграции и специфики пайплайнов. В рамках одного проекта можно комбинировать решения для разных сценариев, но следует обеспечить согласованность версий, единый каталог и единый подход к тестированию.
Практические сценарии и реализации
Рассматривая типичные сценарии интеграции Lakehouse в Spark-проекты, можно выделить несколько рабочих паттернов:
- Паттерн 1. Единый аналитический «синглтейп» для BI и ML: сырые данные аккумулируются в raw-зоне, затем трансформируются в trusted и curated; аналитические платформы получают доступ к curated-данным через единый каталог. В этом сценарии общеупотребимы Delta Lake и Iceberg как транзакционные слои над Parquet.
- Паттерн 2. Потоковая загрузка и стейт-фул анализ: данные поступают через структурированное streaming-подключение и напрямую записываются в Delta Iceberg/Hudi-таблицы; это позволяет держать аналогическую «снимку» состояния системы в реальном времени и поддерживать качественный анализ в рамках time travel.
- Паттерн 3. Распределенная совместность и совместное использование: несколько команд совместно работают над общим lakes, друг другу предоставляют доступ к данным через единый каталог. В таком контексте важна согласованность политик доступа, версий и качества.
Ключевые практики реализации:
- Проектирование зон хранения и ясных соглашений об именовании и версиях.
- Выбор соответствующего транзакционного слоя: Delta Lake для тесной интеграции с Spark и широкой поддержки функций; Iceberg - для крупных схем и сложной архитектуры; Hudi - для сценариев инкрементных потоков.
- Встроенная проверка качества данных и автоматизация уведомлений по ожидаемым моделям.
- Мониторинг и аудит: сбор метрик качества, lineage, долю ошибок, задержек конвейеров.
-- Пример DDL для создания CURATED-таблицы с использованием Delta Lake
CREATE TABLE IF NOT EXISTS curated.sales_summary (
  region STRING,
  total_amount DOUBLE,
  sale_date DATE
)
USING DELTA
## PARTITIONED BY (sale_date)
LOCATION '/lake/data/curated/sales_summary';
Вопросы совместимости с аналитическими платформами и инструментами
Интеграция Lakehouse с BI и аналитическими платформами требует единых стандартов данных, доступности и согласованности. В большинстве случаев это достигается через:
- Единый каталог и единые схемы: BI-инструменты получают доступ к данным через общую модель, обеспечивая консистентность между отчетами и моделями.
- Поддержка time travel: аналитика может «возвращаться» к конкретной версии набора данных для повторного анализа или аудита.
- Стратегии префиксных и динамических прав доступа: это позволяет ограничивать доступ к данным на разных уровнях, включая сырые данные и управляемые наборы.
Рекомендации по внедрению:
- Начинайте с малого: организуйте единый каталог для нескольких наборов данных и обеспечьте доступ BI-слоям.
- Постепенно внедряйте транзакционный слой: Delta Iceberg или Hudi должны быть соответствующим образом настроены и инкорпорированы в пайплайны.
- Включайте мониторинг: собирайте метрики по времени задержки, QC-ошибкам, доле успешных транзакций и доступности версий.
- Учитывайте требования к безопасности и соответствию: настройте политики доступа и ретенции, соответствующие регламентам.
-- Пример чтения данных через Spark из Delta Lake для BI-пайплайна
val curated = spark.read.format("delta").load("/lake/data/curated/sales_summary")
curated.createOrReplaceTempView("sales_summary_view")
Key takeaways
- Lakehouse объединяет преимущества Data Lake и Data Warehouse через транзакционный слой и каталог метаданных, обеспечивая единый источник правды.
- Транзакционные слои Delta Lake, Apache Iceberg и Apache Hudi позволяют реализовать ACID, time travel и эволюцию схем над Parquet-данными.
- Архитектура должна быть спроектирована вокруг зон raw/trusted/curated, с чёткой политикой доступа и управлением версиями.
- ELT-подход в рамках Lakehouse упрощает адаптацию бизнес-логики и ускоряет доставку данных в BI и ML.
- Каталогизация данных обеспечивает поиск, lineage и governance, что критично для аудита и соответствия.
- Выбор конкретного транзакционного слоя зависит от требований к масштабируемости, поддержке схемы и интеграции с существующей инфраструктурой.
- Непрерывный мониторинг качества данных и управляемость изменений - ключ к устойчивой эксплуатации Lakehouse.
FAQ
- Что такое Lakehouse и чем он отличается от традиционного Data Lake или Data Warehouse?
- Lakehouse - это архитектура, которая обеспечивает надстройку над Data Lake (object storage, Parquet) транзакционным слоем и каталогом данных, позволяющим выполнять SQL-запросы с консистентностью и временем путешествия по версиям данных. В отличие от чистого Data Lake, он поддерживает ACID и управляемость схем. В отличие от Data Warehouse - сохраняет масштабируемость и гибкость Data Lake, но обеспечивает Warehouse-уровень качества данных и согласованности через транзакционные слои.
- Какие транзакционные слои существуют и чем они отличаются?
- Delta Lake, Apache Iceberg и Apache Hudi - наиболее распространённые варианты. Delta Lake оптимизирован для тесной интеграции со Spark и предоставляет сильную поддержку ACID, time travel и схему эволюции; Iceberg проектацирован для масштабируемости и гибкости в больших схемах и многоплатформенной работе; Hudi ориентирован на инкрементальные и потоковые пайплайны с эффективной миграцией между версиями и частичной загрузкой.
- Как выбрать между Delta Lake, Iceberg и Hudi?
- Рассматривайте требования к масштабу, степени изменений схем, необходимости времени путешествия и интеграции с существующим стеком инструментов. Delta Lake часто является хорошим выбором для Spark-проектов в рамках экосистемы Databricks и открытых проектов. Iceberg может быть предпочтителен для больших схем и мультиоблачной интеграции, а Hudi - для сценариев инкрементных загрузок и потоковых пайплайнов.
- Что следует учесть при проектировании зон хранения?
- raw-наборы - неизменяемые исходные данные; trusted - очистка и нормализация; curated - готовые к аналитическим запросам данные. Правильное разделение упрощает аудит, governance и обеспечение качества данных и помогает гибко управлять временем обновления.
- Как обеспечить эволюцию схем без срывов пайплайнов?
- Используйте транзакционные слои, которые поддерживают версионирование и совместимость схем. Планируйте изменения схем как серию версий и уведомляйте потребителей. Применяйте тесты на совместимость и автоматические проверки, чтобы не ломать существующие запросы.
- Какие паттерны интеграции Lakehouse с BI и ML существуют?
- Подключение через единый каталог обеспечивает согласованный доступ к наборам данных. Time travel упрощает воспроизводимость аналитических исследований и регрессионный анализ. ELT-подход позволяет серверам BI и ML работать на curated-зоне, а сырые данные удерживаются для аудита и повторной обработки.
- Какие практики управления качеством данных в Lakehouse предпочтительны?
- Внедрять политику качества данных, автоматические тесты (data quality checks) и уведомления. Мониторинг задержек, пропусков и ошибок - необходим для своевременного реагирования. Интеграция с инструментами проверки и тестирования данных обеспечивает устойчивость пайплайнов.
- Какую роль играет каталог данных в Lakehouse?
- Каталог данных служит единой точкой доступа к наборам данных, обеспечивает поиск и lineage, хранит версии и метаданные. Он упрощает governance, контроль доступа и аудирование, а также облегчает совместную работу между командами.
- Какие примеры кода уместны в главе?
- Приведены минимальные примеры DDL и чтения/записи через Spark для иллюстрации концепций. Большие фрагменты кода приводиться лишь там, где они критичны для объяснения реализации и не перегружают текст. В большинстве случаев достаточно описаний и структурированных блоков, чтобы подчеркнуть паттерны архитектуры и принципы.
- Какую роль играет безопасность и соответствие требованиям в Lakehouse?
- Безопасность должна быть встроена на всех уровнях: доступ к сырым данным, управляемым и curates-уровням, а также аудит и политика ретенции. Важно интегрировать доступ через каталог и IAM и соблюдать требования по регламентам в отрасли, включая хранение критически важных данных и контроль версий.
Глава подготовлена с ориентиром на техническую глубину: архитектура, схемы, транзакционные принципы, интеграции и практические шаблоны реализации на Apache Spark. Предыдущие разделы и примеры демонстрируют, как проектировать и внедрять Lakehouse-подходы, обеспечивая устойчивость пайплайнов, управляемость данных и высокий уровень аналитической готовности.


