

Форматы данных и кодеки: Parquet, ORC, Avro, JSON, CSV
Современная архитектура больших данных опирается на гибкое разделение данных на форматы и кодеки, которые вкупе с системами хранения обеспечивают производительность, масштабируемость и устойчивость к изменению требований. В курсе по Apache Spark с нуля такие форматы выступают опорой для эффективного построения ETL и аналитических пайплайнов. В этой главе рассматриваются принципы организации хранения, ключевые различия между Parquet, ORC, Avro, JSON и CSV, а также практические подходы к выбору формата и настройке взаимодействия с Spark.
Понимание форматов данных лежит в основе эффективности: выбор правильного формата влияет на скорость чтения, объем дискового пространства, возможность использования статистик и бабушек (bloom-фильтры), эволюцию схем, а также на совместимость с потоковыми источниками и целями. В разделе приводятся архитектурные детали, сценарии применения и конкретные рекомендации по реализации в ETL-процессах, чтобы обеспечить устойчивые и предсказуемые функции аналитики больших данных.
- Краткое содержание главы
- Архитектура и принципы форматов данных: почему форматы столбцовый и строковый влияют на производительность Spark
- Основные форматы: Parquet, ORC, Avro, JSON, CSV - сравнительный обзор и случаи применения
- Эволюция схем и совместимость: как форматы поддерживают изменение структуры данных
- Производительность и интеграции: компрессия, кодеки, predicate pushdown и конфигурации в Spark
- Практические решения для ETL: как выбирать формат на этапах загрузки, трансформации и загрузки в озеро данных
Архитектура и принципы форматов данных
Современные форматы данных для больших данных ориентированы на эффективную обработку в рамках распределённых систем и гибкость в отношении схем. Основная идея состоит в разделении структуры на два слоя: физическое представление данных (как они хранятся на носителе) и логика чтения/записи (как данные интерпретируются на уровне операций Spark и SQL). В этом контексте Parquet и ORC являются столбцовыми форматами, а Avro - строковым форматом с сильной поддержкой схем. JSON и CSV - текстовые, ориентированные на межоперационный обмен и простоту загрузки.
Ключевые архитектурные элементы:
- Столбцовая организация данных: Parquet и ORC сохраняют данные по столбцам в виде columnar chunks, что позволяет считывать только интересующие столбцы и эффективно применять predicate pushdown.
- Метаданные и footer: Parquet и ORC хранят схему и статистику в конце файла (footer/metadata), что позволяет раннюю оптимизацию на уровне чтения и фильтрации без загрузки всего блока.
- Эволюция схем: Avro, Parquet и ORC поддерживают эволюцию схем различными способами. Avro известен продуманной совместимостью схем между версиями, Parquet - поддержкой некоторых изменений, допускающих добавление полей без значения по умолчанию.
- Кодеки и компрессия: Parquet и ORC применяют сочетания кодеков (RLE, dictionary, bit-packing) и компрессии (Snappy, Zstandard, GZIP, LZO), что влияет на баланс между скоростью чтения и степенью сжатия.
- Инструменты доступа: Spark использует встроенный Catalyst и Tungsten-ускорители для столбцовых форматов, обеспечивая эффективную выборку и векторизованное чтение. predicate pushdown и статистика в метаданных существенно ускоряют обработку больших наборов данных.
Эти принципы определяют, какие форматные решения применяются в конкретных задачах: аналитика на больших объёмах, инкрементальные загрузки данных, поточные источники, интеграции с экосистемами (Hadoop, облачные хранилища). В зависимости от характеристик рабочих нагрузок выбираются соответствующие форматы и наборы опций в Spark, чтобы минимизировать пропуски и увеличить пропускную способность пайплайнов.
Основные форматы: Parquet, ORC, Avro, JSON, CSV
Каждый формат имеет свою сильную сторону и ограничения. Ниже приводится краткий обзор и рекомендации по применению в контексте Spark.
-
Parquet
- Архитектура: столбцовый формат, ориентированный на секционирование данных по row groups и column chunks, с эффективной компрессией и статистикой в метаданных.
- Преимущества: высокие показатели аналитики благодаря чтению лишь необходимого набора столбцов; поддержка сложных вложенных структур; эффективные операции predicate pushdown и агрегации; хорошая совместимость с Spark SQL.
- Ограничения: менее эффективен для транзакционных нагрузок и частого обновления отдельных строк по сравнению с Avro.
- Типичное применение: аналитика, BI-отчеты, хранилища данных в Lakehouse, большие выборки столбцов.
-
ORC
- Архитектура: колонно-ориентированный формат с оптимизированной структурой метаданных и поддержкой функций фильтрации на уровне стека чтения.
- Преимущества: высокая компрессия и быстрая выборка по столбцам; эффективная поддержка статистик и индексирования; часто превосходит Parquet в некоторых сценариях чтения и обработки больших наборов данных.
- Ограничения: экосистема инструментов может быть менее однородной по сравнению с Parquet в некоторых стеках.
- Типичное применение: аналитика в Hadoop-экосистеме, схемы со сложной структурой, требования к жестким условиям масштабирования.
-
Avro
- Архитектура: строковый формат с самодостаточной схемой, которая сериализуется вместе с данными.
- Преимущества: простая совместимость схем между версиями, эффективна в потоковой обработке и обмене сообщениями; лёгкость обновления на уровне данных.
- Ограничения: не обеспечивает столь эффективную по столбцам выборку, как Parquet/ORC, для аналитических рабочих нагрузок; не столь эффективен для больших наборов столбцов, когда требуется выборка только части данных.
- Типичное применение: потоковые источники и темы, межсистемные интеграции, обмен структурированными сообщениями.
-
JSON
- Архитектура: текстовый формат без жесткой схемы, легко читается и пишется; поддерживает вложенные структуры.
- Преимущества: простота интеграций, гибкость при обмене данными между системами различной собственности; хорошо подходит для первоначального ввода данных.
- Ограничения: парсинг и разбор типов данных накладывают накладные расходы; отсутствие жесткой схемы усложняет автоматическую валидацию и оптимизацию запросов.
- Типичное применение: ingestion ingress, прототипирование источников, обмен сообщениями между микросервисами.
-
CSV
- Архитектура: текстовый формат с разделителями; часто без строгой схемы и типизации.
- Преимущества: максимальная простота и совместимость; удобство переноса между системами.
- Ограничения: отсутствие явной схемы, проблемы с типизацией и кавычками; больше рисков ошибок в интерпретации данных.
- Типичное применение: первоначальная загрузка данных, экспорт из межсистемной интеграции, промежуточное хранение.
| Формат | Архитектура | Преимущества | Недостатки | Типичные сценарии |
|---|---|---|---|---|
| Parquet | столбцовый | predicate pushdown, статистика, хорошая сжатость | сложнее обновления; требует планирования схемы | аналитика, озеро данных, BI-отчеты |
| ORC | столбцовый | отличная компрессия, быстрые операции чтения | экосистема может быть менее однородной | крупномасштабные аналитические задачи |
| Avro | строковый | гибкая эволюция схем, эффективен для потоков | менее эффективен для столбцовой аналитики | потоковые данные, обмен сообщениями |
| JSON | текстовый | простота, fleksibilnost | парсинг и типизация накладны | ingestion, интеграции между системами |
| CSV | текстовый | универсальная совместимость | без схемы, риск ошибок типов | загрузка данных, промежуточные слои |
Для каждого формата характерна своя проверенная практика настройки в Spark. Важно помнить, что парадоксально, но иногда текстовые форматы JSON/CSV применяются на входном этапе, после чего данные сохраняются в Parquet/ORC для дальнейшей аналитики. Это позволяет разделить этапы: гибкость ingest и эффективность анализа.
Эволюция схем и совместимость
Управление схемой - ключевой аспект устойчивости ETL-практик. Avro изначально спроектирован для эволюции схем: добавление новых полей и изменение типов допускается с сохранением обратной совместимости при условии соблюдения правил регистрации. Parquet и ORC поддерживают изменение схем за счет добавления полей и обновления метаданных, но из-за структуры footer/metadata некоторые изменения требуют перегенерации набора файлов или применения специальных опций чтения.
Spark предоставляет несколько механизмов для поддержки эволюции схем:
- явная схема на чтении: определение схемы данных при загрузке, чтобы обеспечить единообразие типов на этапе трансформации;
- mergeSchema: опция чтения Parquet/ORC, которая объединяет схемы из нескольких файлов, если они различаются;
- использование Avro-схем при чтении и записи: Avro-файлы часто сопровождают данные схемой, что упрощает обратную совместимость.
Важно учитывать, что строгие схемы, заданные на чтение, могут обеспечить более детерминированное поведение, однако требуют бухгалтерии при внесении изменений в источники. Применение соответствующих опций Spark и аккуратное проектирование схем помогают свести к минимуму риск несовместимостей: новые поля могут иметь значение по умолчанию, а старые поля могут быть помечены как устаревшие, чтобы не нарушить существующие пайплайны.
Производительность и интеграции: компрессия, кодеки и режимы чтения
Производительность чтения/записи во многом определяется компрессией, кодировкой и структурой формата. Столбцовые форматы позволяют Spark пропускать неиспользуемые столбцы, что существенно сокращает I/O. В Parquet и ORC применяются различные кодеки: dictionary encoding для строковых столбцов может существенно снизить размер, а RLE-подобные схемы - ускорить чтение повторяющихся значений. Компрессия (Snappy, Zstandard, GZIP, LZO) дополняет эту картину: выбор компрессии влияет на вычислительную стоимость распаковки и общий размер файлов.
Predicate pushdown - механизм, который позволяет сформировать фильтр на уровне метаданных файла, чтобы не считывать целые блоки данных. Это критически важно для аналитических нагрузок, где фильтрация по дате, идентификатору или другим ключам может исключить необходимость обработки больших объемов данных. Статистика в конце файла (min/max по столбцам) ускоряет такие операции.
Оптимизация чтения Spark включает:
- выбор формата по задаче: Parquet/ORC для аналитики и Avro для потоков;
- настройку компрессии и encoding в зависимости от структуры данных;
- использование статистик и метаданных для ускорения планирования запросов;
- включениеекторной чтения и векторизации там, где поддерживается форматом.
На уровне реализации Spark обеспечивает механизм чтения и записи через DataFrameReader и DataFrameWriter. В интеграционных сценариях можно задействовать дополнительные опции:
- чтение Parquet: выбор схемы, включение mergeSchema, фильтрация на уровне файла;
- запись Parquet: настройка формата, выбор компрессии и уровня бинарной совместимости;
- чтение/запись Avro: активируется через пакет spark-avro, поддерживает совместимость и эффективную сериализацию.
## Пример простой записи Parquet с компрессией
df.write.option("compression", "snappy").parquet("path/to/output")
## Пример чтения Parquet с применением схемы и объединением схем из файлов df = spark.read.schema(mySchema).option("mergeSchema", "true").parquet("path/to/input")Ограничения и подводные камни следует учитывать на этапе проектирования: смешанные форматы в одном пайплайне требуют аккуратного управления конверсиями, поддержанием согласованности типов и единообразной эволюции схем. Важно обеспечить совместимость между источниками и целями, особенно в стекe, где данные проходят через несколько этапов обработки и хранятся в различных формате.
Интеграции в Spark: чтение, запись и схемы
Spark предоставляет богатый набор возможностей для работы с форматов данных. В ETL-процессе это означает:
- чтение данных из Parquet/ORC/Avro: поддержка разделов, схем, типов и вложенных структур;
- запись в Parquet/ORC/Avro: сохранение структур, с возможной настройкой компрессии и схем;
- работа с JSON и CSV как входами в первые этапы загрузки, с последующим конвертированием в более эффективные форматы для аналитики.
Практически полезно помнить о следующих аспектах:
- выбор формата для входа и выхода: JSON/CSV часто применяются на входе для ingestion, Parquet/ORC - на выходе для аналитики;
- поддержка схем: Spark может прямо использовать Avro-схемы, что упрощает совместимость версий;
- разделение данных: партиционирование и bucketing помогают ускорить запросы и улучшить параллелизм чтения;
- совместимость облачных хранилищ: Parquet/ORC хорошо интегрируются с HDFS и объектными системами (S3, ADLS), где метаданные позволяют быстрее индексировать и проставлять фильтры;
- интеграции с каталогами: Spark может работать с Data Catalog через внешние сервисы (Hive Metastore и др.), что упрощает управление схемами и версиями.
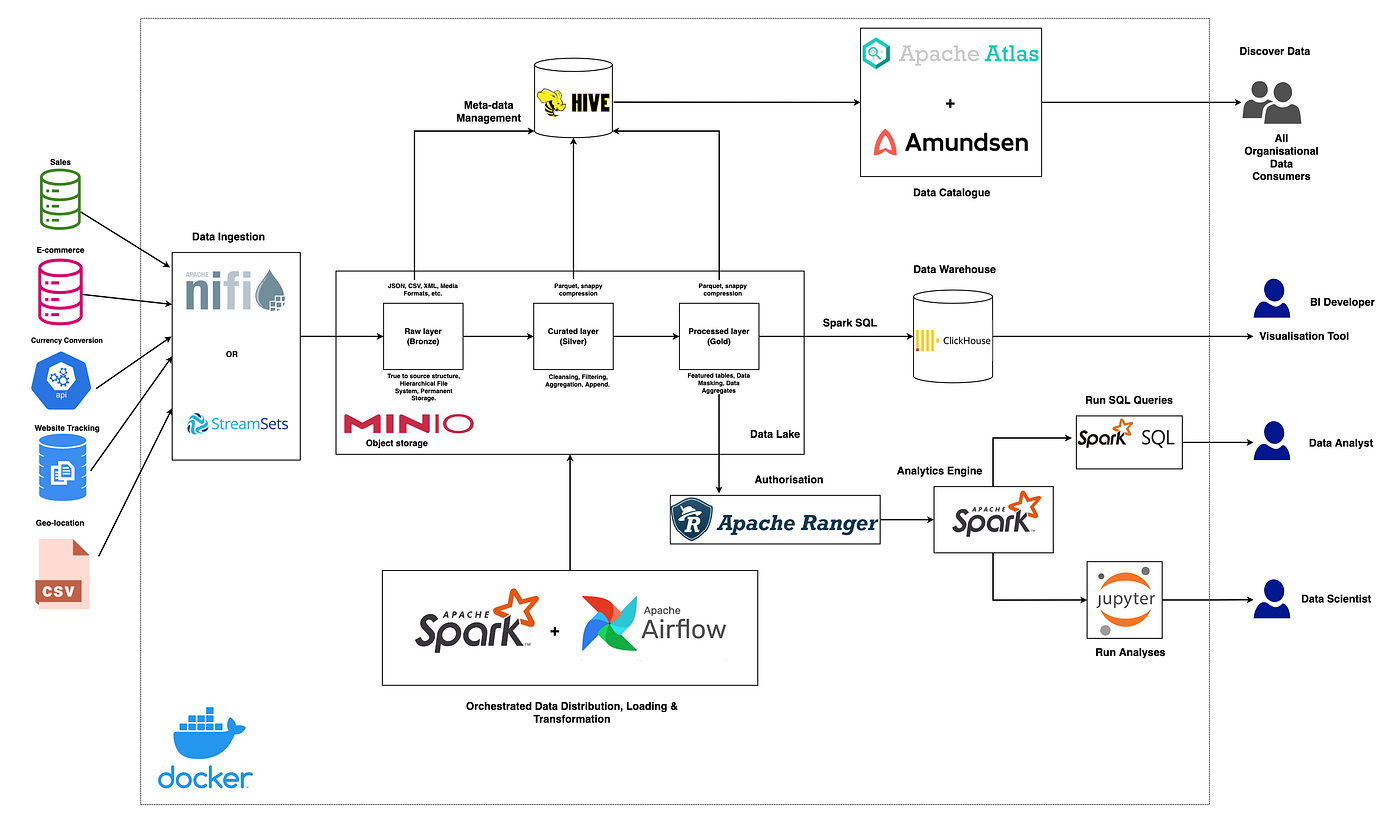
В контексте архитектуры Lakehouse предпочтительнее использовать Parquet или ORC в качестве основной базы для аналитических таблиц, сохраняя исходные данные в Avro или JSON на этапе ingest, чтобы обеспечить гибкость и скорость, а затем конвертировать часть потоков к формату Parquet для ускорения аналитических запросов.
Кейсы проектирования ETL: выбор форматов и практики
При проектировании ETL-пайплайнов важно учитывать характер данных, частоту загрузок и требования к обработке. В большинстве случаев разумно использовать следующий набор правил:
- для аналитики и BI - Parquet как основной формат хранения; он обеспечивает эффективный доступ к столбцам и поддержку сложных запросов;
- для потоковой передачи и обмена сообщениями - Avro, который поддерживает схему и эволюцию без резких изменений в существующем пайплайне;
- на входе в пайплайн - JSON или CSV как гибкость для источников данных; затем преобразованные данные переходят в Parquet или ORC;
- для партнерских интеграций и внешних систем - Avro или JSON в зависимости от требуемой поддержки консистентности схем и скорости сериализации/десериализации;
- для больших объемов и сложного вложенного типа - Parquet с поддержкой сложных типов; ORC может оказаться предпочтительным в сценариях с интенсивными запросами к большим объемам данных и потребностью в компрессии.
Практический подход состоит в формировании единого слоя хранения, где на этапе ingestion данные приводятся к одному из эффективных форматов (чаще Parquet), а на этапе доступа - используются особенности конкретных рабочих нагрузок: аналитика, машинное обучение или потоковые пайплайны.
В рамках практических кейсов возможно сочетание форматов в рамках одного процесса: данные из Kafka приходят как Avro/JSON, затем сохраняются в Parquet для аналитических и производительных целей, а архивные копии - в ORC для длительного хранения. Важной частью является документирование принятых правил по схеме и версионированию, чтобы обеспечить повторяемость пайплайна и минимизировать риск рассинхронизации между источниками и целями.
Key takeaways
- Форматы Parquet и ORC являются столбцовыми и поддерживают эффективное чтение только необходимых столбцов за счет row groups, column chunks и статистики.
- Avro обеспечивает гибкую эволюцию схем и эффективную сериализацию для потоковых интеграций; JSON и CSV полезны на входе для ingestion благодаря простоте, но требуют преобразования для аналитики.
- Выбор формата зависит от задачи: аналитика - паракеты/ORC, потоковые сценарии - Avro, обмен сообщениями - Avro/JSON, первоначальная загрузка - JSON/CSV.
- Эволюция схем требует аккуратного управления версиями: Avro хорошо поддерживает совместимость, Parquet/ORC - через mergeSchema и дополнительные опции чтения.
- Производительность зависит от компрессии и кодеков: выбор компрессии, использование predicate pushdown и статистик уменьшают объем считываемых данных и ускоряют планирование запроса.
- Spark предоставляет мощные инструменты для чтения/записи форматов: совместимость с каталогами, поддержка схем и оптимизаций через DataFrameReader/DataFrameWriter.
- Правильная архитектура включает разделение ingest-слоя и аналитического слоя: сначала ingest в гибком формате (JSON/CSV/Avro), затем экспорт в Parquet/ORC для аналитики и долгосрочного хранения.
FAQ
- Что такое predicate pushdown и зачем он нужен в контексте Parquet и ORC?
Predicate pushdown - это механизм, позволяющий Spark не извлекать данные из файлов, которые не удовлетворяют заданному условию. Форматы Parquet и ORC хранит статистику по столбцам и структурированный метаданные, что позволяет проводить фильтрацию на уровне чтения файлов. Это значительно уменьшает объем считываемых данных и ускоряет выполнение запросов, особенно на больших наборах данных.
- Какие форматы лучше для хранения витрин аналитики и почему?
Для витрин аналитики чаще выбирают Parquet или ORC. Они обеспечивают эффективное хранение столбцовых данных, поддержку статистик и быструю выборку только необходимых столбцов. Parquet особенно популярен благодаря широкой совместимости в экосистеме Hadoop и Spark, что упрощает построение пайплайнов и использование открытых инструментов.
- Как выбрать между Parquet и ORC для новой задачи?
Выбор зависит от конкретной рабочей нагрузки: Parquet хорошо подходит для общих аналитических сценариев и широкой экосистемы; ORC может давать преимущества в случае очень больших объемов данных и сложной схемы, где нужна наилучшая компрессия и скорость чтения. В большинстве проектов начальный выбор делает по Parquet, затем при необходимости проводится профилирование и возможно переход на ORC для отдельных веток пайплайна.
- Как реализовать эволюцию схем без разрушения существующих пайплайнов?
Используйте совместимые механизмы эволюции: Avro-полная поддержка схем, а для Parquet/ORC - опции чтения mergeSchema, явное указание схемы на чтение. В проектах рекомендуется хранить справочник схем в центральном каталоге и документировать правила добавления полей, их значений по умолчанию и способы обработки устаревших полей.
- Как обеспечить эффективную интеграцию между ingest и аналитическим слоями?
На этапе ingest используйте гибкие форматы, такие как JSON/CSV; затем конвертируйте данные в Parquet/ORC для аналитического слоя. Это обеспечивает гибкость на входе и высокую производительность на этапе анализа. Важно поддерживать единые схемы и управление версиями, чтобы пайплайн не ломался при изменении источников.
- Какие параметры компрессии чаще всего применяются к Parquet и почему?
Чаще всего выбирают Snappy и Zstandard. Snappy обеспечивает хороший баланс скорости распаковки и уровня сжатия, что выгодно для скоростной аналитики. Zstandard - более высокая степень сжатия при сопоставимой скорости распаковки и может быть предпочтительно при ограничении пространства хранения или для очень больших наборов данных.
- Какие риски связаны с несовместимыми схемами между источниками и целями?
Основные риски - падение читаемых данных, ошибки типов, неверная трактовка полей и нарушение контрактов между конвейерами. Рекомендуется держать единый реестр схем, использовать строгую валидацию при загрузке и аккуратно регламентировать эволюцию схем через версионирование.
- Какой формат выбрать для потоковых ценностей и практически каких ограничений следует ожидать?
Для потоковых сценариев часто используют Avro из-за его хорошей поддержки эволюции схем и эффективной сериализации. JSON может применяться на входе упрощённых окон потока для обмена сообщениями, однако для больших потоков предпочтительнее Avro, чтобы снизить накладные расходы на парсинг и сериализацию.
- Как Spark влияет на выбор формата на практике?
Spark оптимизирован под Parquet и ORC благодаря встроенным свойствам столбцовых форматов и индексации статистик. Он обеспечивает предикат-пушдауны, векторизированное чтение и эффективное выполнение через Catalyst и Tungsten. JSON и CSV чаще применяются на стадии ingest и демарширования, а затем конвертируются в Parquet/ORC для анализа.
- Какие рекомендации по документации и контролю версий схем стоит внедрить в команды?
Рекомендуется создать единый источник схем (расписание версий, соответствующие Avro-схемы, таблицы соответствия), документировать правила эволюции и регламентировать статус каждого поля (активен/устарел). Использование интеграций с каталогами данных и контроль версий поможет обеспечить повторяемость и устойчивость пайплайнов.


