

Архитектура DuckDB: принципы встроенного аналитического движка
DuckDB позиционируется как встроенный аналитический движок, который может работать внутри приложений или в рамках сервиса, не требуя отдельного сервера. Его архитектура спроектирована так, чтобы максимально использовать преимущества единичного процесса, колонночного хранения и параллельного исполнения запросов, обеспечивая при этом полноту SQL-аналитики и возможность интеграции с внешними источниками данных и инструментами обработки. В основе лежат три ключевых направления: эффективное хранение и сканирование колонн, продвинутая техника планирования и исполнения запросов, а также прочная концепция транзакционной согласованности и взаимодействия с внешним миром данных.
DuckDB реализует ряд архитектурных паттернов, характерных для современных встроенных аналитических движков: модульность и слабая связность компонентов, хорошо определённые контракты между слоями, применение vectorized execution, поддержка LLVM-кодогенерации, а также механизм расширений, который позволяет добавлять функции и источники данных без изменений базового ядра. Это позволяет DuckDB балансировать между гибкостью интеграций и производительностью, достигаемой за счёт конвейерной обработки и оптимизаций на этапе выполнения.
-
Главная идея архитектуры: окружение внутри одного процесса, которое действует как единый аналитический движок со своей собственной моделью хранения, планирования, исполнения и транзакций, но без необходимости разворачивать полноценный серверной архитектуры. Такая модель снижает задержки на коммуникацию между компонентами и упрощает внедрение в существующие пайплайны и приложения.
-
Важные компоненты: система хранения, сканеры и форматы данных, оптимизатор и планировщик запросов, исполнительный движок с векторизованной обработкой, модуль транзакций и согласованности, а также интерфейсы для расширения функциональности и интеграции.
-
Основные принципы: минимизация копирования данных при передаче между операторами, агрессивная фильтрация и проекция на стадии сканирования, динамическое принятие решений о выборе физических операторов, использование кодогенерации для расплавления узких узлов в специализированный код, а также поддержка внешних форматов без необходимости загрузки данных в отдельное хранилище.
Далее рассмотрим ключевые архитектурные области DuckDB, начиная с принципов хранения и управления данными, переходя к планированию и исполнению запросов, а затем к интеграциям в современные data stack и практическим аспектам эксплуатации.
Архитектурные принципы и модель взаимодействий
DuckDB строится вокруг идей встроенного аналитического ядра и модульной архитектуры. В ядро входит несколько взаимодополняющих слоёв:
-
Хранение и доступ к данным: колонночный формат, страницы и колонки, компрессии, кодирование и физическая организация данных на диске и в памяти. Такой подход обеспечивает эффективный доступ к нужным столбцам и минимизацию чтения данных, что особенно полезно для аналитических запросов с большими наборами столбцов.
-
Планирование и оптимизация: сначала строится логическое представление запроса, затем выполняется оптимизация с учётом статистики и доступных индикаторов выполнения. DuckDB применяет различные техники predicate pushdown, проекционное сокращение и стратегию выбора физических операторов, чтобы максимально уменьшить объем обрабатываемых данных.
-
Исполнение: vectorized execution обеспечивает обработку данных в больших «векторных пачках», что повышает пропускную способность за счёт эффективного использования кешей процессора и SIMD-инструкций. Кодогенерация на этапе исполнения позволяет сгенерировать специализированный код под конкретный запрос, что может снизить интерпретационные накладные расходы.
-
Транзакции и согласованность: DuckDB реализует механизм транзакций внутри процесса, поддерживает режимы уровня изоляции и управление конкурентным доступом через MVCC. Это обеспечивает предсказуемую семантику чтения и возможность выполнения параллельных запросов без потери консистентности данных.
-
Расширяемость и интеграции: модуль расширений и поддержка функций позволяют подключать новые форматы данных, источники и аналитические функции. DuckDB действует как «встраиваемая база» для аналитики, но при этом сохраняет совместимость с открытыми стандартами и популярными данными в формате Parquet, CSV и др.
Понимание этого слоя за слоем важно для проектирования систем аналитики на базе DuckDB. Ниже приведены основные направления, которые детализируются в следующих разделах.
Хранение данных, колоночность и сканеры
Хранение данных в DuckDB сконструировано вокруг колонночной модели. Каждая колонка физически организована по структурам, которые позволяют быстро извлекать значения по одному столбцу, что критично для аналитических запросов с большими наборами данных и высоким уровнем агрегаций. Кроме того, DuckDB поддерживает компрессию и разные кодировки, которые снижают размер данных в памяти и на диске, уменьшают пропускную способность ввода-вывода и улучшают кешируемость.
-
Сканеры и источники данных: DuckDB реализует нативные сканеры для собственных форматов хранения и для внешних источников, включая Parquet, CSV и другие. На этапе сканирования выполняются фильтрации и проекции, чтобы минимизировать количество обрабатываемых кусков данных. Хорошая статистика и метаданные Parquet позволяют эффективно выполнять predicate pushdown и prune-проекции на ранних стадиях конвейера.
-
Промежуточные данные и временные структуры: векторные батчи данных служат единицей обработки. Каждый батч содержит набор значений для выбранных столбцов, что обеспечивает предсказуемую память и упрощает оптимизацию кэш-эффективности. В DuckDB применяются техники соотношения памяти и диска: когда объём данных превышает доступную память, часть операций может быть аллокирована на диск (например, внешний сорт, объединение и другие операции).
-
Кодирование и компрессия: для разных типов данных применяются соответствующие схемы кодирования (например, dictionary encoding, RLE и другие техники) и компрессии. Это не только экономит память, но и ускоряет сканирование за счёт уменьшения объема передаваемых данных в память процессора.
-
Модуль хранения и управление данными: DuckDB имеет единый Storage Manager, который абстрагирует физические файлы, кэширование, блоки и их маппинг в память. Это облегчает реализацию импортов/экспортов и интеграцию с внешними файловыми системами и объектными хранилищами.
-
Метаданные и каталог: архитектура DuckDB поддерживает Catalog для хранения информации о таблицах, схемах, типах, зависимостях и сигнатурах функций. Это обеспечивает устойчивость к изменениям схемы и возможность повторного использования планов планирования после анализа изменений.
Важно понимать, что архитектура хранения прямо влияет на эффективность выполнения запросов. Чем лучше структура колонн и чем smarter реализованы сканеры, тем раньше в конвейере происходит отбрасывание данных и тем меньше потребляется вычислительной мощности на последующих этапах.
Планирование, оптимизация и исполнение запросов
Глубина архитектуры DuckDB проявляется в том, как строится и реализуется план выполнения запроса. Процесс сервисно разделён на несколько стадий:
-
Логический план: анализ запроса преобразуется в логическую форму, которая отражает семантику и зависимости операций. На этом этапе устанавливаются базовые принципы выполнения, такие как фильтрация, группировка, соединение и порядок агрегаций.
-
Базовый анализ иBinder: на этапе binding имена колонок и таблиц связываются с соответствующими типами и источниками данных. Этот этап критически важен для корректного разрешения зависимостей в больших схемах.
-
Оптимизация: DuckDB применяет несколько техник оптимизации, включая predicate pushdown, projection pushdown и стратегию выбора физических операторов. Специализированные алгоритмы могут reorder join-партнёры, выбирать между хэш-джоином и merge-джоином, а также использовать внешнюю сортировку и агрегацию при необходимости. Векторизация на этапе исполнения неотъемлема для снижения накладных расходов на обработку.
-
Физический план и кодогенерация: после выбора физических операторов формируется физический план. Затем запускается кодогенерация с применением LLVM, чтобы сгенерировать специализированный, высокоэффективный код для конкретного запроса. Это существенно ускоряет операторные конвейеры, особенно в тяжелых аналитических запросах с агрегациями и сложными фильтрациями.
-
Исполнение: исполнительный движок обрабатывает данные в виде потоков векторных батчей. Каждый оператор - сканер, фильтр, проекция, агрегация, соединение - реализует «pipeline», позволяя результатам передаваться по цепочке без промежуточных копий. Совокупная производительность достигается за счет fuse-подобной обработки на лету и минимизации создания временных структур.
-
Мониторинг и объяснение плана: DuckDB поддерживает команды EXPLAIN и PRAGMA для диагностики. Это позволяет аналитикам и инженерам оптимизировать запросы, настраивать параметры и выявлять узкие места в обходе выполнения.
-
Параллелизм и синхронность: DuckDB распараллеливает выполнение запросов по нескольким ядрам. Это включает координацию памяти, синхронную работу над векторными батчами и обеспечение корректной синхронизации при изменениях данных или параллельной записи в каталоги.
-
Транзакции и согласованность: встроенная система транзакций обеспечивает согласованность чтения и записи внутри одного процесса, используя MVCC. Это даёт возможность выполнять сложные аналитические задачи без блокировок на время чтения, сохраняя корректность анализа.
Основная идея: сократить путь данных от загрузки до результатов через минимизацию промежуточного копирования, использование векторизаций и генерацию кода, что позволяет DuckDB достигать высоких скоростей на больших объёмах данных даже в контексте встроенной архитектуры.
Интеграции в современные data stack и сценарии внедрения
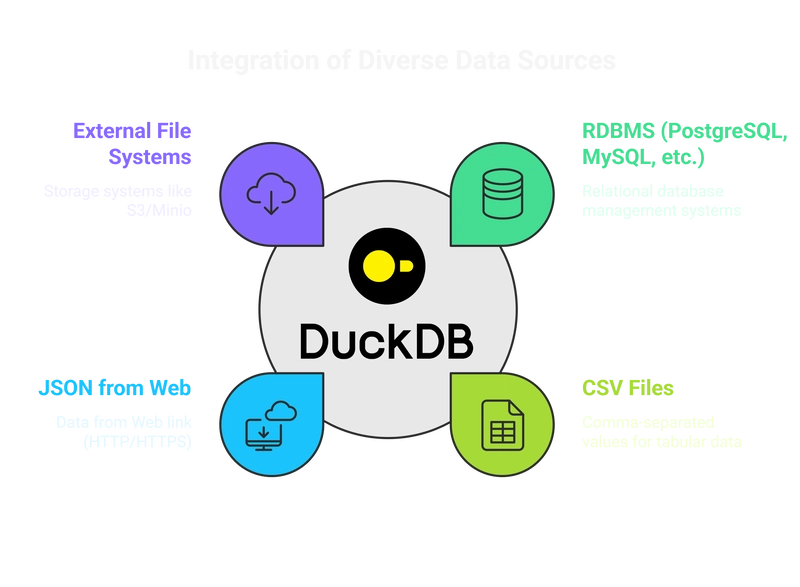
Одной из существенных сильных сторон DuckDB является его способность «встроиться» в существующие данные и инфраструктуру без масштабной перестройки. Встроенный движок может работать как автономным аналитическим модулем внутри приложений и сервисов, так и как SQL-аналитический слой поверх данных, хранящихся в Parquet, CSV или даже в облаке.
-
Интеграции с языковыми средами: DuckDB предоставляет нативные интерфейсы для Python, R, Java и C++, что облегчает включение аналитики DuckDB в пайплайны машинного обучения, ETL-процессы и BI-практику. Важно учитывать совместимость версий и минимизацию задержек при обмене данными между процессами.
-
Объектные хранилища и формат данных: возможность прямого чтения Parquet и других форматов без предварительной загрузки данных в локальное хранилище снижает задержки и упрощает режим «in-situ» анализа data lake. Predicate pushdown и статистика метаданных Parquet помогают ускорить исполнение, уменьшая объем обработки.
-
Расширяемость через плагины и функции: DuckDB поддерживает расширения, что позволяет интегрировать внешние форматы, источники и пользовательские функции. Это особенно важно в сценариях, где требуется соединить чисто аналитическую обработку с domain-specific вычислениями или специфическими источниками данных.
-
Встраивание в пайплайны ML и BI: DuckDB может служить SQL-слоем для подготовки данных, агрегаций и предобработки перед передачей в модели. В контексте цифровой трансформации это позволяет снизить задержку между сбором данных и принятием оперативных решений, предоставляя единый язык запросов в рамках всей цепочки.
-
Примеры практических сценариев:
- Аналитика поверх данных озера данных: анализ кросс-срезов по Parquet-файлам на бюджетном кластере без копирования данных в отдельное аналитическое хранилище.
- Встроенная аналитика в сервисе: DuckDB как часть API сервиса для быстрой выборки статистик и предиктивной аналитики без явной передачи данных в удалённый сервер.
-
Рекомендации по внедрению:
- Определить роль DuckDB: как локальный слой анализа в приложении, как ETL-станция или как слой подготовки для ML.
- Выбрать источники данных: в первую очередь Parquet и другие колоннарные форматы; учитывать наличие метаданных и возможности predicate pushdown.
- Управление ресурсами: задать лимиты памяти и параллелизма с учётом накладных расходов на кодогенерацию и векторизацию для конкретных сценариев.
- Мониторинг и профилирование: активировать режим EXPLAIN и сбор телеметрии по выполнению запросов, чтобы постоянно улучшать планирование и настройки.
Интеграции DuckDB в data stack должны рассматриваться как связующая точка между разными слоями: источниками данных, инструментами аналитики и процессами подготовки данных. Важно помнить, что архитектура DuckDB создана с мыслью о минимизации передачи данных и быстрого исполнения на месте, что особенно ценно в современных архитектурах, где часть анализа держится «на месте» в непосредственном месте потребления.
Практические аспекты настройки и производительности
Эффективная работа DuckDB тесно связана с грамотной настройкой конфигураций и пониманием ограничений архитектуры. Важные направления здесь включают:
-
Память и параллелизм: определение бюджета памяти на запросы и числа рабочих потоков влияет на производительность и устойчивость к пиковым нагрузкам. Параллелизм помогает ускорить обработку больших выборок, но требует соответствующей координации памяти и избегания перегрузки CPU кэшей.
-
Конфигурационные параметры: включение и отключение кодогенерации, настройка предикатов и фильтров, управление внешними источниками и режимами компрессии. В зависимости от рабочих нагрузок, качественные сетапы могут различаться: от чистой агрегации до сложного соединения больших наборов данных.
-
Стратегии исполнения: выбор физических операторов для конкретных задач, таких какJoins: hash join против sort-merge; агрегации: агрегационные функции и их реализации; обработка больших данных через внешнюю сортировку или использование альтернативных стратегий.
-
Мониторинг и профилирование: использование EXPLAIN, объяснение плана, анализ узких мест, распределение времени между сканированием, фильтрацией, агрегацией и кодогенерацией. Непрерывный мониторинг помогает адаптировать бизнес-процессы к изменяющимся данным и нагрузкам.
-
Надёжность и транзакции: MVCC внутри DuckDB обеспечивает изоляцию и согласованность в рамках встроенного ядра. В сценариях, где требуется стабильная аналитика поверх активно изменяющихся данных, поддержка операций COMMIT/ROLLBACK внутри процесса становится особенно ценной.
-
Интеграционная совместимость: при внедрении DuckDB в существующий стек следует учитывать совместимость с источниками данных, форматами файлов и сторонними инструментами. Вопросы совместимости часто касаются форматов чтения и записи, функций и расширяемости.
-
Примеры конфигурационных решений:
- Упор на скорость: увеличить параллелизм и разрешение на использование кодогенерации, сохранить визуализацию плана для анализа.
- Упор на устойчивость: снизить максимальный объём потребляемой памяти, включить ограничение на использование памяти на единицу запроса, выполнить профилирование типичных запросов.
Эти аспекты способствуют эффективной эксплуатации DuckDB в рамках аналитических платформ и позволяют адаптировать движок под специфические требования бизнеса и инфраструктуры.
Key takeaways
- DuckDB - это встроенный аналитический движок с колоннарной структурой хранения, векторизованной обработкой и кодогенерацией, ориентированный на низкие задержки и высокий throughput в рамках одного процесса.
- Архитектура разделяет хранение данных, планирование и исполнение запросов, поддерживая MVCC и параллелизм, что обеспечивает консистентность и масштабируемость внутри приложения.
- Эффективность достигается за счёт раннего фильтра и проекции на стадии сканирования, использования векторных батчей и сгенерированного на лету кода для узких путей выполнения.
- DuckDB оптимально подходит для интеграции в data lake и встраивания в современные data stacks благодаря поддержке Parquet/CSV, нативным интерфейсам для Python/R/Java и модульной системе расширений.
- Важной практикой является правильная настройка памяти и параллелизма, мониторинг планов выполнения и использование EXPLAIN для постоянного улучшения производительности.
- Архитектура DuckDB упрощает создание аналитических пайплайнов рядом с приложениями, уменьшая задержки между сбором данных и принятием решений.
- Встраивание DuckDB требует стратегий по управлению ресурсами, совместимости форматов и мониторингу качества выполнения запросов для достижения устойчивой производительности.
FAQ
- Что такое архитектура DuckDB и чем она отличается от традиционных серверных аналитических баз данных?
- DuckDB - это встроенный аналитический движок, работающий внутри процесса приложения. Он не требует развертывания отдельного сервера, что снижает задержки и упрощает интеграцию. Основное отличие состоит в том, что выполнение запросов происходит в рамках одного процесса с общими ресурсами приложения, а не через отдельный сетевой сервер. Это позволяет эффективно использовать локальные ресурсы, векторизовать обработку и генерировать специализированный код под запрос.
- Какие принципы лежат в основе векторизированной обработки в DuckDB?
- Векторизированная обработка обрабатывает данные пакетами фиксированной величины (батчами), что позволяет существенно повысить пропускную способность за счёт эффективного использования кешей CPU и SIMD-инструкций. Такой подход снижает накладные расходы на интерпретацию отдельных кусков данных и позволяет быстро фильтровать, проецировать и агрегировать данные.
- Как реализуются транзакции и согласованность внутри DuckDB?
- DuckDB реализует MVCC и локальные транзакции внутри процесса, что обеспечивает изоляцию чтения и согласованность при параллельной обработке запросов. Это позволяет выполнять аналитические запросы на данных без блокировок, связанных с внешними сервисами, и поддерживает корректную семантику чтения при наличии одновременного обновления данных.
- Как DuckDB работает с внешними источниками данных, например Parquet?
- DuckDB поддерживает чтение Parquet и других форматов непосредственно во время анализа. predicate pushdown и метаданные позволяют минимизировать объем обрабатываемых данных и ускорить выполнение запросов без предварительной загрузки данных в отдельное хранилище. Это особенно полезно в сценариях data lake и «in-situ» аналитики.
- Какие сценарии внедрения наиболее эффективны для DuckDB?
- Встроенная аналитика в приложении или сервисе: быстрое добавление SQL-возможностей без разворачивания сервера. Аналитика поверх data lake: быстрый доступ к Parquet/CSV без копирования данных. Подготовка данных для ML и BI: DuckDB выступает как слой подготовки и агрегаций перед передачей в модели или BI-платформы.
- Какие ограничения и риски связаны с использованием DuckDB в продакшене?
- Основные ограничения связаны с масштабируемостью в рамках очень больших параллельных нагрузок и ограничениями памяти на отдельном узле. Встраиваемый характер может требовать согласованности политики ресурсного контроля и мониторинга в рамках общего окружения. В некоторых случаях для очень больших кластеров может потребоваться интеграция DuckDB как часть более крупной архитектуры через этапы, где DuckDB обслуживает отдельные каналы анализа.
- Как отслеживать и диагностировать проблемы в планах выполнения?
- Используйте EXPLAIN и анализ плана выполнения для понимания того, какие операторы будут исполнены, как применяются фильтры и проекции, и как выполняется агрегация. Это позволяет выявлять узкие места, например медленные сканеры или неэффективные соединения, и корректировать конфигурацию.
- Какие роли роли играют расширения и функциональные плагины в DuckDB?
- Расширения позволяют доделать недостающие форматы, источники данных или функции без изменения ядра движка. Это упрощает адаптацию DuckDB под специфические бизнес-требования и интеграцию с существующим стеком технологий.
- Какова стратегия интеграции DuckDB в data mesh или data lake архитектуру?
- DuckDB может служить слоем аналитики поверх data lake, предоставляя единый язык запросов и ускоряя подготовку данных для машинного обучения и BI. При этом важно определить границы ответственности между DuckDB и остальной инфраструктурой: где ведётся хранение данных, где выполняется подготовка, и как синхронизируются Source-of-Truth данные.
- Каковы наиболее важные метрики для оценки производительности DuckDB в вашей системе?
- Время выполнения запроса (latency), throughput (количество обработанных запросов за единицу времени), использование памяти на запрос, частота использования кодогенерации и степень фильтрации на стадии сканирования. Помимо этого, качество планов выполнения и эволюция плана по отношению к изменениям данных являются критически важными метриками оптимизации.
Эта глава об архитектуре DuckDB предназначена для специалистов, занимающихся разработкой и внедрением аналитических платформ. Она подчеркивает принципы встроенного аналитического движка, объясняет, как различные компоненты взаимодействуют между собой для достижения высокой производительности и гибкости интеграций, и предоставляет практические ориентиры для проектирования архитектурных решений в контексте современных data stack.


