

Интеграция источников данных: коннекторы к Hadoop, Iceberg, Delta Lake, RDBMS и streaming источникам
В промышленной среде экосистема данных характеризуется большим количеством источников, строгими требованиями к безопасности и регулятивной ответственности, а также необходимостью устойчивой работы сервисов в автономном режиме. Интеграция источников данных через коннекторы Trino позволяет единообразно выполнять аналитические запросы поверх Hadoop, Hive/Metastore, Iceberg, Delta Lake, реляционных баз данных и потоковых источников. Глава фокусируется на архитектуре коннекторов, паттернах взаимодействия и практических сценариях внедрения в индустриальных условиях: как обеспечить безопасность, наблюдаемость и отказоустойчивость, не теряя при этом производительность и консистентность данных.
Краткое содержание главы
- Архитектура коннекторов в Trino: принципы, взаимодействие с каталогами и планировщиком запросов.
- Подключение Hadoop/HDFS, Iceberg и Delta Lake: согласованность схем, форматов и миграции.
- RDBMS и streaming источники: JDBC-коннекторы, CDC и интеграция с Kafka/Pulsar.
- Безопасность, контроль доступа и соответствие требованиям: аутентификация, авторизация, шифрование и аудит.
- Мониторинг, диагностика и отказоустойчивость: метрики, трассировка, ретраи и устойчивые схемы отказоустойчивости.
- Практические сценарии внедрения в промышленной среде: планирование миграций, управление рисками и кейсы.
Архитектура и принципы интеграции коннекторов
Интеграция источников в Trino строится вокруг концепции каталогов (catalogs), которые представляют собой абстракцию над конкретным коннектором и набором параметров доступа к источнику. Каталоги позволяют централизовать конфигурацию и обеспечить единый уровень доступа к данным, независимо от формата или технологии хранения. В промышленной среде это особенно важно, поскольку больше всего критических решений зависит от согласованности политик безопасности и регуляторных требований.
Ключевые принципы:
- Распределённая архитектура: коннекторы запускаются на рабочих нодах Trino и используют локальные кэши и метаданные источников. Это позволяет снижать сетевую нагрузку и уменьшать задержки запросов.
- Централизованная аутентификация и авторизация: интеграция с Kerberos, LDAP или OAuth позволяет единообразно управлять правами доступа ко всем источникам через единый контрольный слой.
- Pushdown-оптимизации: когда это возможно, выражения (фильтры, проекции) проецируются на источник данных, уменьшая объем передаваемых данных и ускоряя обработку.
- Миграция схем: обеспечение плавного перехода схемы и совместимости типов данных между различными системами хранения и форматами таблиц.
- Обеспечение согласованности: подходы к версионированию схемы, схеме эволюции таблиц и безболезненной конвертации форматов.
Эти принципы лежат в основе выбора конкретных коннекторов и конфигураций для промышленной среды. В частности, при работе с большими объемами полуструктурированных и структурированных данных критически важно обеспечить согласованность схем, минимизацию задержек и устойчивость к сетевым перебоям. В рамках архитектуры рекомендуется четко отделять характерные константы безопасности и режимы доступа от специфики конкретных источников через политики Catalog-уровня, а не через реализацию каждого коннектора по отдельности.
Выбор паттернов доступа и интеграции
- Для Hadoop/HDFS и Hive Metastore целесообразно использовать коннектор, который поддерживает мета-данные Hive и локализованные каталоги с хранением таблиц в формате Parquet или ORC. Это упрощает управление схемами и обеспечивает совместимость с Iceberg и Delta Lake.
- Iceberg и Delta Lake позволяют управлять схемами и эволюцией таблиц, обеспечивая детерминированность обновлений и точную обработку метаданных. В промышленной среде это снижает риск рассинхронизации между источниками и аналитическими слоями.
- Для RDBMS разумно использовать JDBC/ODBC-совместимый коннектор с поддержкой pushdown-фильтров и ограничений на объем выборки, чтобы не перегружать сеть и планировщик во время пиковых нагрузок.
- Стриминговые источники (Kafka, Pulsar) требуют особого внимания к точности времени и порядку сообщений, а также к возможности образовывать CDC-потоки, чтобы поддерживать миграцию в режим near real-time.
Коннекторы к Hadoop и объектным форматам: Hadoop, Iceberg и Delta Lake
Работа в промышленной среде чаще всего приводит к необходимости взаимодействия с данными, сохранёнными в Hadoop экосистеме, а также с современными таблица-форматами Iceberg и Delta Lake, которые дают более мощные средства управления схемами и разделами данных.
- Hadoop/Hive Metastore: коннектор к Hadoop-площадкам обеспечивает доступ к данным в HDFS и к метаданным Hive Metastore. Поскольку Hive Metastore служит общим реестром схем, Trino может эффективно использовать его для кэширования и планирования запросов, а также для корректного разрешения типов и имен столбцов при соединении с Iceberg или Delta Lake.
- Iceberg: Iceberg как таблица-формат поддерживает эволюцию схем, управление разделами и транзакционные_WRITE-поведения поверх распределённых хранилищ. Trino оборачивает Iceberg-коннектор в единый интерфейс запроса, позволяя выполнять аналитические запросы на актуальных состояниях таблиц без миграции данных.
- Delta Lake: Delta Lake обеспечивает упаковку схемы, транзакционную целостность и временные снимки. Интеграция через коннектор Delta Lake в Trino позволяет проводить безошибочные запросы поверх промышленных данных, поддерживая схему evolutions и «time travel» для аудита и рыночных исследований.
Практические аспекты реализации:
- Конфигурация каталога должна явно указывать тип источника, путь к данным и параметры сравнения схем. В реальном мире это может быть реализовано через централизованные параметры каталога, что позволяет безопасно развернуть обновления без дублирования конфигурации.
- В целях производительности рекомендуется включать кэш схем и metadata-кэш. Это снижает задержки при планировании запросов, особенно для больших наборов Iceberg/Delta Lake таблиц.
- В части безопасности критически важно обеспечить шифрование в пути (TLS) между узлами Trino и источниками, а также на уровне данных в храниле (at rest) в соответствии с отраслевыми требованиями.
## Пример (упрощённый) конфигурации каталога для Iceberg через Hive Metastore
connector.name=iceberg
iceberg.catalog.type=hive
iceberg.catalog=hive
hive.metastore.uri=thrift://metastore-host:9083
## безопасность и иные параметры могут задаваться отдельно
## Пример (упрощённый) конфигурации каталога Delta Lake
connector.name=delta_lake
delta_lake.catalog.type=hive
delta_lake.metastore.uri=thrift://metastore-host:9083
Данные примеры иллюстрируют общий подход: каталог должен содержать указание на источник, тип каталога и адрес метаданного сервиса. В реальных реализациях набор свойств будет расширен в зависимости от версии Trino, дистрибутива и политики безопасности предприятия.
Обеспечение согласованности и миграция схем
- Схема evolution: Iceberg и Delta Lake поддерживают эволюцию схем без блокировки таблиц, что полезно для непрерывной аналитики в условиях частых изменений источников данных.
- Совместимость типов: необходимо заранее определить соответствие типов между источниками и целевой аналитической моделью, особенно при сочетании Parquet/ORC с форматами облачных хранилищ и RDBMS.
- Тестирование изменений: в промышленной среде поведение схем должно быть протестировано на тестовом кластере перед применением изменений в проде.
RDBMS и streaming источники: JDBC, CDC и стриминг
Интеграция реляционных баз данных и стриминговых систем требует специфических подходов к обеспечению согласованности, задержки и пропускной способности.
- RDBMS через JDBC/ODBC: коннектор к RDBMS обеспечивает доступ к данным с поддержкой pushdown-фильтров и агрегаций. В промышленных условиях важно, чтобы выборки были оптимизированы под конкретные рабочие нагрузки: цепочки заказов, логи операций, финансовую аналитику и т. п. Важна совместимость типов и корректная обработка функций, особенно в случаях бр руки etl/pipeline.
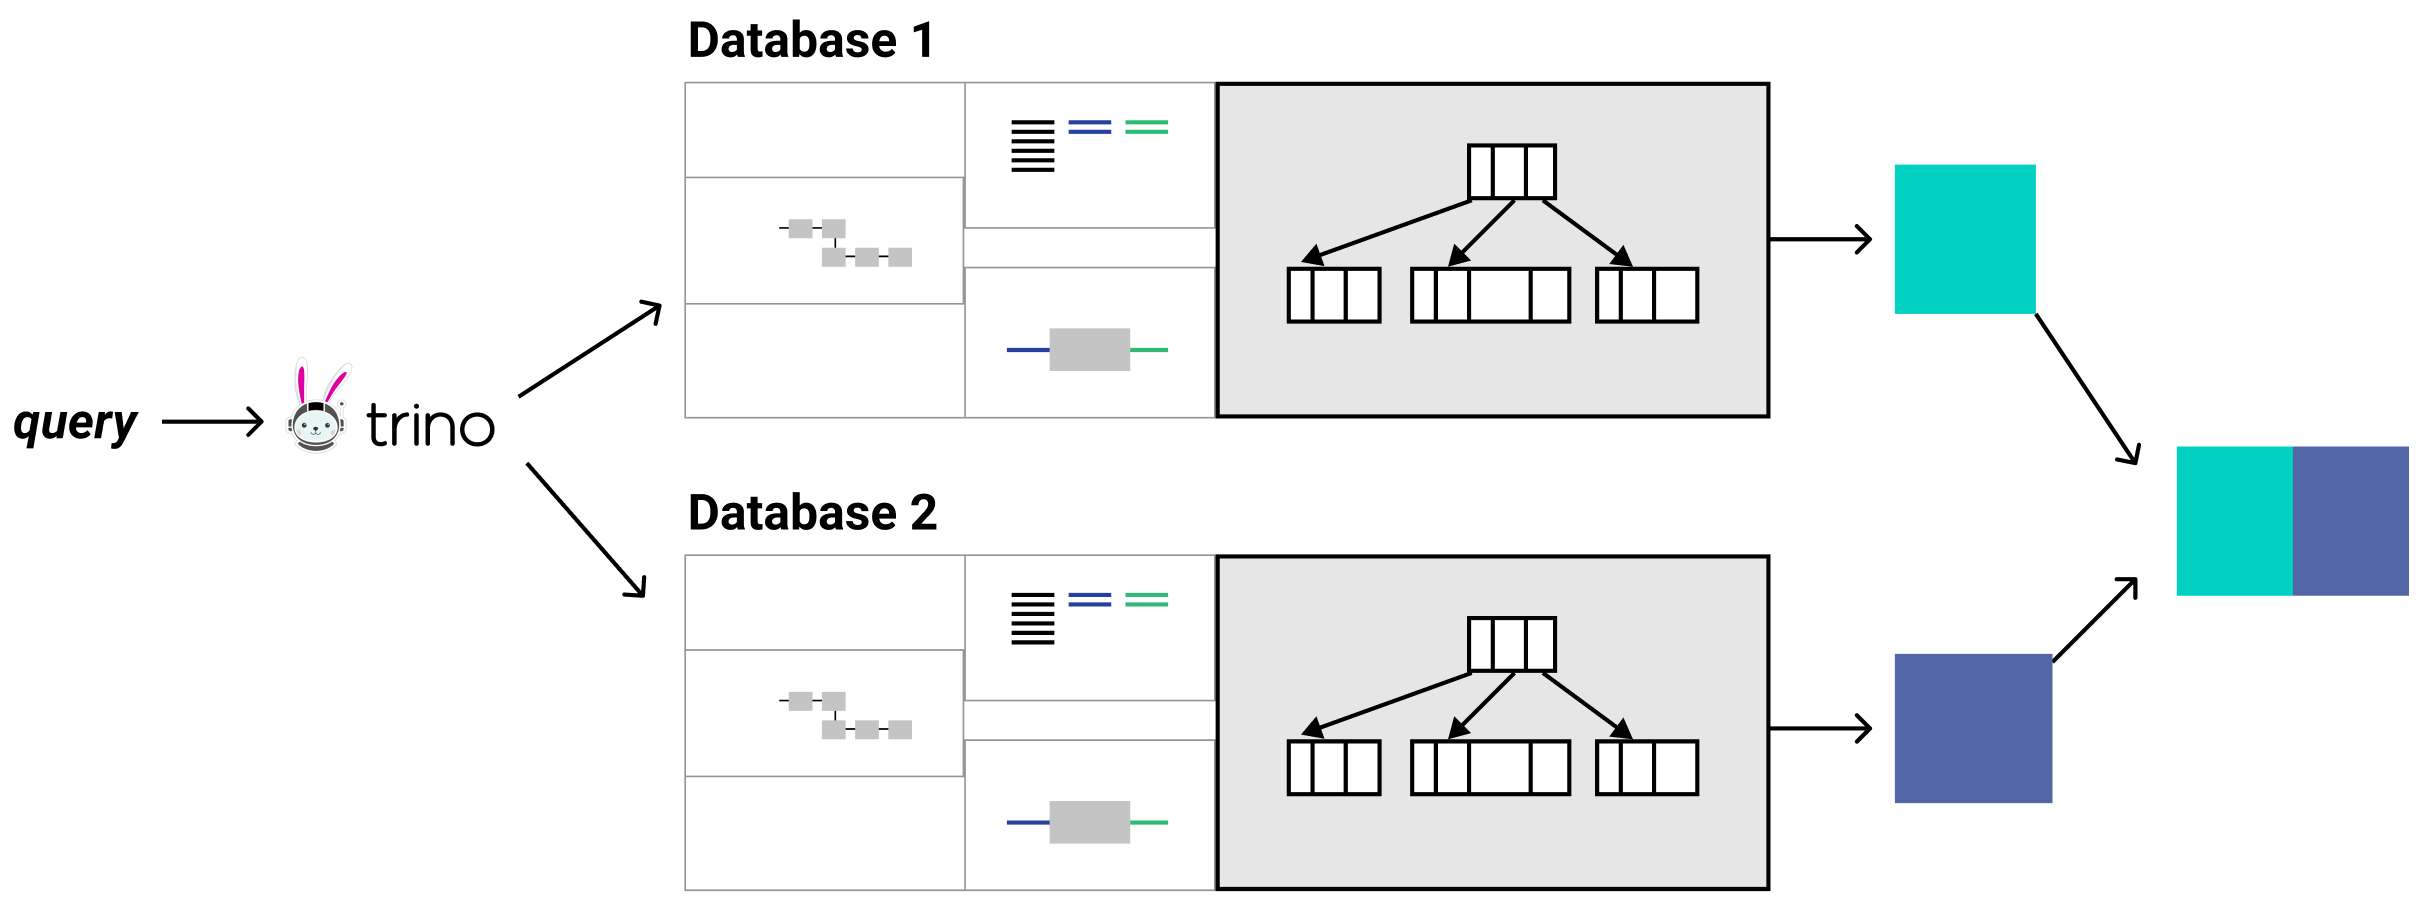
- Change Data Capture (CDC): CDC-источники позволяют фиксировать изменения в источнике и реплицировать их в потоковую систему (например, Kafka). Коннектор Trino может использовать CDC-источники для построения near real-time аналитики и слияния данных с историческими наборами.
- Стриминговые источники: Kafka и Pulsar часто используются как стабилизированные фронты потоковых данных. В Trino эти источники читаются как таблицы/секвенции, что позволяет интегрировать их с Hive Iceberg/Delta Lake или с традиционными RDBMS. Важно учитывать порядок сообщений, задержки и повторную обработку в случае сбоев.
Практические замечания:
- Для CDC-потоков полезно обеспечить поддержку уникальных идентификаторов записей и идемпотентности операций на уровне источника и на уровне коннектора.
- При работе со стриминг-источниками необходимо понимать лимиты задержек и пропускной способности, а также возможные схематические различия между источниками CDC и статическими таблицами.
- Pushdown-поддержка фильтров на уровне источника может существенно снизить сетевой трафик и ускорить обработку, но иногда требует согласованности поколений типа/форматов между источником и Trino.
Пример конфигурации для CDC и стриминга
## Конфигурация коннектора Kafka для чтения CDC-потока
connector.name=kafka
kafka.bootstrap-servers=kafka-broker1:9092,kafka-broker2:9092
kafka.connector-name=cdc_events
kafka.table-names=mydb.orders
## дополнительные параметры для надёжной доставки и сериализации
## Конфигурация JDBC-коннектора для RDBMS
connector.name=jdbc
jdbc.url=jdbc:mysql://db-host:3306/mydb
jdbc.user=dbuser
jdbc.password=secret
jdbc.validaterows=100
В промышленной практике такие примеры служат ориентиром и требуют адаптации под конкретную версию Trino, используемый дистрибутив и корпоративные политики безопасности.
Безопасность и соответствие требованиям
Гарантированная безопасность и соответствие регулятивным требованиям являются краеугольными камнями внедрения коннекторов в промышленной среде. Реализация должна охватывать аутентификацию, авторизацию, шифрование, аудит и мониторинг доступа.
- Аутентификация: часто применяется Kerberos combined with TLS- encrypted connections между клиентами и сервером, а также интеграция с LDAP/OAuth либо другими системами идентификации.
- Авторизация: granular access control на уровне Catalogs, схем, таблиц и даже отдельных столбцов. В промышленных системах часто необходима роль- и политик-ориентированый подход с учётом принципа наименьших привилегий.
- Шифрование: TLS-каналы для данных в движении; прозрачное шифрование на уровне хранилища (напр., S3/ADLS/ HDFS) в сочетании с управлением ключами.
- Аудит и соответствие: регистрирование запросов к источникам, доступов к данным и изменений конфигураций каталога. Это критично в соответствии с регуляторными требованиями и внутренними политикам по безопасности.
- Обеспечение соответствия монитору и логирования: включение детализированных логов коннекторов и мониторинг неправильных попыток доступа или аномалий в плане.
Практически это может означать:
- Единый механизм управления политиками доступа для всех коннекторов.
- Использование централизованных хранилищ секретов и ротацию ключей.
- Внедрение аудиторских журналов и автоматическую корреляцию событий с запросами.
Безопасность конфигураций и практические рекомендации
- Не хранить чувствительные данные конфигурации в открытом виде; применяйте секрет-менеджеры и конфигурационные сервисы.
- Разграничение доступов между администраторами каталога и бизнес-пользователями; применение принципа наименьших привилегий.
- Регулярные аудиты прав доступа и контроль изменений в конфигурациях каталогов.
Мониторинг, диагностика и отказоустойчивость
Мониторинг коннекторов и связанной инфраструктуры обеспечивает устойчивую работу аналитических нагрузок в промышленной среде. Важны как оперативная диагностика, так и долгосрочное планирование нагрузок и отказоустойчивости.
- Метрики производительности: задержка выполнения запросов, пропускная способность, частота ошибок, время планирования.
- Наблюдаемость: трассировка запросов и операций, распределённая трассировка через OpenTelemetry, централизованный сбор логов и метрик.
- Отказоустойчивость: ретраи с экспоненциальной задержкой, ограничение числа повторов, изоляция сессий, поддержка идемпотентности на источниках и в коннекторах.
- Разделение тревог и мониторинга: автоматические алерты по порогам задержек, успешная/неуспешная загрузка, статус коннекторов и доступность Metastore.
Метрики и таблица мониторинга
| Метрика | Что измеряет | Целевое значение (пример) |
|---|---|---|
| query_latency_ms | среднее время выполнения запроса | < 1000 ms |
| connector_health | статус коннектора | healthy |
| metastore_latency_ms | задержка доступа к Hive Metastore | < 200 ms |
| replication_lag_ms | задержка между источником и потребителем | < 5000 ms |
| error_rate | доля ошибок по коннектору | < 0.1% |
Диагностика и трассировка
- Инструменты трассировки: использование OpenTelemetry для распределённой трассировки запросов, чтобы выявлять узкие места в цепочке обрабок данных, начиная от клиента до источников и обратно.
- Логирование: стандартные форматы логов должны включать идентификатор запроса, каталог, таблицу, источники и параметры сессии, что облегчает ретроспективный анализ.
- Инцидент-менеджмент: регламент по эскалации и развёртыванию патчей, минимизация простоя за счёт заранее протестированных сценариев восстановления.
Отказоустойчивость и устойчивые режимы
- Ретраи и backoff: гибкое управление количеством повторов и времени ожидания между ними; ограничение количества повторов на каждом узле.
- Изоляция сессий: ограничение влияния ошибок на соседние запросы, чтобы обеспечить устойчивость всей системы.
- Idempotency: проектирование операций коннекторов и ETL-процессов так, чтобы повторные попытки не приводили к дубликатам и неконсистентности.
- Резервирование и георознесение: поддержка нескольких зон доступности и репликаций метаданных для обеспечения доступности даже при локальных сбоях.
Практические сценарии внедрения в промышленной среде
Рассмотрим несколько типовых кейсов, которые иллюстрируют как архитектурно и операционно выстраивать интеграцию источников данных в промышленной среде.
- Кейсы классификации источников: комбинирование Hadoop/HDFS с Iceberg для архивов и Delta Lake для активной аналитики, сопоставление с RDBMS для транзакционных операций и CDC-потоки для близких к реальному времени данных.
- План миграции: сначала организовать совместный каталог для тестовых наборов данных, затем мигрировать целевые запросы к промышленной аналитике, сохраняя старые источники на переходной стадии.
- Тестовые стратегии: функциональное тестирование для схем, нагрузочное тестирование под реальными объемами, регрессионное тестирование для координации обновлений.
- Управление безопасностью: внедрить единый контроль доступа и аудит для всех коннекторов, обезопасить конфигурации и секреты.
Практические рекомендации:
- Реализация унифицированной политики доступа через Catalog-level ACLs для каждого коннектора.
- Внедрение централизованного мониторинга и алертинг, включающего триггеры на задержку, ошибки и пропуски.
- Постепенная миграция на Iceberg/Delta Lake с использованием временных «плейсхолдеров» и сохранением истории изменений.
- Регулярные обзоры архитектуры коннекторов и обновление версий по мере выхода улучшений в области безопасности и производительности.
Key takeaways
- Коннекторы Trino предоставляют единый слой доступа к разнообразным источникам: Hadoop/HDFS, Iceberg, Delta Lake, RDBMS и стриминг-источники, что упрощает моделирование аналитики.
- Архитектура catalog-подхода обеспечивает централизованную конфигурацию, безопасный доступ, планирование и кэш метаданных, что критично в промышленных условиях.
- Безопасность и соответствие требованиям должны быть встроены на уровне Catalog, включая Kerberos/OAuth, TLS, аудит и разграничение прав.
- Поддержание наблюдаемости через метрики, трассировку и логи критично для оперативной диагностики и долгосрочного планирования масштабирования.
- Эволюция схем Iceberg и Delta Lake позволяет безопасно управлять изменениями данных без прерывания аналитики и поддерживает аудируемость.
- CDC и стриминг источники требуют особого внимания к идемпотентности, порядку сообщений и задержкам, чтобы не возникло несогласованности между источниками и аналитикой.
- В промышленной среде целостная миграция требует планирования, тестирования и контроля рисков, с поддержкой паттернов ретраи, изоляции и резервирования.
FAQ
- Какие факторы влияют на выбор конкретного коннектора для Hadoop/ Iceberg/ Delta Lake в промышленной среде?
- Выбор коннектора определяется форматом хранения, потребностями в эволюции схемы и уровне поддержки метаданных. Iceberg и Delta Lake обслуживаются через соответствующие коннекторы, которые обеспечивают версионирование, управление разделами и совместимость с Hive Metastore. Важно проверить совместимость версии Trino, используемого дистрибутива и требования к безопасности. В промышленных задачах ключевым фактором является способность конфигурации каталога централизованно управлять доступом и логированием.
- Как обеспечить безопасное подключение к источникам данных через Trino?
- Реализуйте единый слой аутентификации (Kerberos/LDAP/OAuth) и TLS между клиентами и серверами. Используйте централизованный секрет-менеджер для хранения паролей и ключей, применяйте политикy минимальных привилегий на Catalog уровне. Включите аудит доступа и мониторинг изменений конфигураций. Регулярно обновляйте версии коннекторов и аккуратно тестируйте обновления на тестовой среде.
- Какие ключевые параметры влияяют на производительность при интеграции коннекторов?
- Время планирования и задержка доступа к метаданным (Metastore), возможность pushdown-фильтров на источник, размер батча чтения данных, эффективность кэширования схем, и латентность сетевых соединений. Iceberg/Delta Lake улучшают производительность за счёт оптимизированного чтения и работы с элементами метаданных, но требуют корректной настройки кэширования и параметров планировщика.
- Как обрабатывать схему evolution в Iceberg и Delta Lake и как это влияет на Trino?
- Iceberg и Delta Lake поддерживают эволюцию схем без блокировок таблиц, что облегчает обновления структур данных. В Trino это отражается через обновляемые метаданные таблиц и совместимость с источниками. Важно протестировать сценарии добавления/изменения столбцов на тестовом кластере и обеспечить корректность отображения новых структур в SQL-запросах и BI-инструментах.
- Как обеспечить консистентность данных и идемпотентность при работе с CDC/стриминг-источниками?
- CDC-потоки должны иметь уникальные идентификаторы записей и корректное поведение при повторной доставке. В сочетании с Trino это достигается за счёт идемпотентных операций на источнике и обработке повторов на уровне коннектора. Следует выбирать окружающую инфраструктуру с детерминированной обработкой, поддержкой временных штампов и устойчивостью к дублированию сообщений.
- Какие подходы к мониторингу и трассировке подходят для промышленной среды?
- Использование распределённой трассировки (OpenTelemetry) для всей цепочки: клиента → Trino → коннектор → источник. Ведётся централизованный сбор метрик и логов. Важно построить дашборды для задержек, ошибок, и времени планирования, а также настроить алерты по критическим порогам. Регулярно проводятся аудиты логов и тесты аварийного переключения.
- Как обеспечить устойчивость соединения к Hadoop в условиях сетевых перегрузок?
- Внедрите ретраи с адаптивным backoff и ограничение числа повторов, используйте локальные кэши метаданных для снижения частоты обращений к Metastore, настройте горизонтальное масштабирование нод Trino и убедитесь в устойчивости сети между кластером Trino и Metastore. Разработайте план аварийного переключения и мониторьте задержки метаданных.
- Как минимизировать риски при миграции существующих ETL-процессов на Trino?
- Начинайте с переходного слоя Catalog и тестовой среды: мигрируйте небольшие наборы данных, сравните результаты, внедрите контроль качества и аудит. Постепенно расширяйте зону влияния, параллельно сохраняя существующие источники как резерв. Включите в план требования к безопасности и конфигурациям. Важна регламентированная схема тестирования после каждого изменения конфигураций.
- Какие особенности стоит учитывать при внедрении CDC-потоков в промышленной среде?
- CDC-потоки могут создавать высокий объем событий и требуют стабильной инфраструктуры Kafka/Pulsar, гарантий порядка и точного времени событий. Важно поддерживать консистентность между источиком и аналитикой, тестировать обработку ошибок и повторной доставки, а также интегрировать CDC в безопасный и регламентированный канал передачи данных.
- Какие меры необходимо принять для миграции схем и форматов без простоя?
- Разработайте этап миграции с параллельной обработкой: существующие источники продолжают работать в оригинальном формате, новая конфигурация запускается параллельно, данные сверяются и форматы приводятся к единой схеме. Используйте временные слепки и «time travel» для аудита, а также тестовую среду для верификации изменений перед их публикацией в прод.


