

Ингестия данных: источники, частота обновления и требования к задержке
Ингестия данных в Hadoop представляет собой связующее звено между операционными источниками и аналитической средой большого масштаба. Она должна обеспечивать не только доставку данных в хранилище и вычислительные пласты, но и соблюдение требований к задержке, качество данных, согласованность и управляемость потоков. В контексте ETL-процессов в Hadoop ingestion выступает как фактор, определяющий архитектурные решения, выбор форматов и схем передачи данных, способы обработки бесшовного обновления и возможность масштабирования под растущую нагрузку. Глава рассматривает источники данных, частоту обновления и требования к задержке как системообразующие элементы архитектуры, влияющие на последующие этапы обработки, хранение и анализ.
В рамках практики корпоративного обучения данная тема соединяет концептуальные принципы с архитектурными решениями и операционной реализацией. Рассматриваются характерные источники данных, принципы измерения задержки и freshness, архитектурные паттерны ingestion, выбор форматов и схем хранения, а также практики мониторинга, управления качеством данных и обеспечения устойчивости интеграционных потоков в рамках Hadoop-экосистемы.
- Краткое содержание главы
- Источники данных и их характеристики, выбор форматов, контроль качества и идемпотентность.
- Частота обновления и требования к задержке: целевые показатели, trade-off с пропускной способностью и стоимостью хранения.
- Архитектура ingestion в Hadoop: коннекторы, каналы транспорта, схемы эволюции схем и поддержка изменений.
- Управление хранением и метаданными: партиционирование, форматы столбцовые, каталогизация и контроль версий схем.
- Метрики, мониторинг и управление качеством данных: SLA, observability, валидаторы, lineage.
- Практические сценарии внедрения и пути к масштабированию.
Источники данных и их характеристики
Ингестия данных начинает путь с выбора источников и способа их передачи в Hadoop. Источники можно условно разделить на внешние и внутренние, на дискретные батчевые потоки и непрерывные потоки. Внутренние источники часто представляют собой транзакционные базы данных, ERP-системы, системные журналы и сервис-логи. Внешние источники включают SaaS-платформы, облачные хранилища, файлы на FTP/HTTP, IoT-устройства и сторонние дата-поставщики. Важно различать режимы поступления данных: batch-поля, CDC (Change Data Capture) из оперативных систем, потоковые источники, регулярные выгрузки файлов и API-интеграции.
Ключевые параметры, формирующие архитектуру ingestion, включают:
-
Форматы данных и сериализация. В аналитической среде Hadoop предпочтение отдают колоночным форматам Parquet и ORC, а также формату Avro для сериализации потоковых сообщений и схем. JSON применяется для гибкой передачи полей, но требует дополнительной обработки для схемной совместимости и парсинга. Выбор формата влияет на эффективность хранения, скорость чтения и совместимость с инструментами обработки (Spark, Hive, Presto).
-
Контракты данных и схема. В рамках ingestion необходимы твердые контракты (data contracts) и механизм валидации схем на уровне входа. Эволюция схем должна поддерживаться без радикальных изменений в downstream-процессах, используя совместимые изменения (evolution) и версионирование.
-
Idempotentность и exactly-once semantics. При интеграции с источниками, где дубликаты возможны (CDC, повторные выгрузки, повторные сообщения), важно проектировать ingestion так, чтобы повторная обработка не приводила к ошибкам или дублированию. Эксист-однократная обработка достигается через ключи записей, детерминированные вычисления и детальное управление транзакциями.
-
Управление временем и семантикой. В ingestion необходимо определить event time, processing time и watermarks. Это позволяет корректно обрабатывать задержанные сообщения, поддерживать корректность окон и операций временного анализа.
-
Архитектурная роль консюмера данных. Ингесторы могут выступать как потоковые коннекторы (Kafka, NiFi) и как батчевые агенты, которые периодически читают данные из файловых источников или API. Разделение потоков и батчей позволяет оптимизировать задержку на уровне канала передачи и снизить риск перегрузки.
-
Примеры архитектурных решений. В реальном проекте часто комбинируются коннекторы к потоковым системам (Kafka) и файловым источникам (HDFS), что позволяет гибко управлять латентностью, обеспечивать восстановление после сбоев и вести детальный аудит движения данных.
Таблица ниже демонстрирует типичные источники и соответствующие решения, которые поддерживают ingestion в Hadoop. Она иллюстрирует соответствие между источниками, форматами и рекомендациями по обработке.
| Источник | Формат данных | Частота обновления | Рекомендации по ingestion |
|---|---|---|---|
| Реляционные базы данных (CDC) | Avro/Parquet через CDC-поток | Мгновенная или near real-time | Использование потоковых конструкторов (CDC) и иллюстраций watermark-метрик; обеспечение idempotentности и детального мониторинга изменений |
| Файлы на файловых системах (логи, архивы) | Parquet/ORC или Avro | Батчевые окна, дневной цикл | Блокировка на уровне файла, устойчивость к дублированию через детекцию контрольных сумм; динамическое добавление партиций |
| API и SaaS-данные | JSON/Parquet | Варьируется, часто near real-time | Нормализация схем, rate limiting, кэширование и повторная попытка с экспоненциальной задержкой |
| Социальный и клик-данные | Parquet/ORC | Потоковые или батчовые | Стратегия partitioning по времени, поддержка событийного времени и поздних данных |
Источники данных требуют внимания к качеству, контрактам и устойчивости к изменениям. В ingestion критически важно планировать обработку late data, предусмотреть повторные загрузки, обеспечить контроль версий схем и корректную маршрутизацию в слои хранения. Успешная реализация также подразумевает выбор баланса между строгой схемой и гибкостью форматов, чтобы минимизировать переработку данных при изменении требований.
Частота обновления и требования к задержке
Задержка (latency) и свежесть данных являются ключевыми параметрами для оценивания эффективности ingestion. Эти требования зависят от бизнес-контекста: финансовые торговые платформы требуют практически мгновенной доставки изменений, операционные аналитические панели - задержки в пределах секунд-минутов, а долговременный дамп данных для архивирования - часы и дни.
-
Типы задержки. Разделяют несколько уровней: processing delay (время обработки на конвейере), delivery delay (время, необходимое для передачи данных между источниками и хранилищем) и end-to-end delay (от события в источнике до его отражения в аналитической модели). В реальной системе end-to-end задержка часто составляет от долей секунды до нескольких минут, в зависимости от архитектуры, размера потоков и требований к консистентности.
-
Батч vs потоки. Батчевые подходы фокусируются на периодических запусках, что упрощает консистентность и переработку, но увеличивает задержку. Потоковые технологии позволяют достигать минимальной задержки, но требуют более сложной архитектуры управления состоянием, обработкой watermarks и обработкой поздних событий.
-
SLA и требования к freshness. SLA по задержке обычно формулируются как целевое окно обработки и отражение данных в аналитических витринах. В рамках корпоративного курса целесообразно прописать сценарии: Near Real-Time (NRT) 0-60 секунд, Real-Time 1-5 секунд, Near Real-Time с двумя-канальной архитектурой для резервирования - 5-15 секунд; Batch-инжест в 15-60 минут и более. Важно связывать SLA с cost-to-serve: более агрессивные задержки обычно требуют большего уровня параллелизма, большего объема хранения зейк и более сложной обработки.
-
Trade-offs и масштабируемость. Чем ниже задержка, тем выше требования к инфраструктуре: более быстрые очереди сообщений, низкие задержки сетевого трафика, более быстрые дисковые подсистемы, более агрессивное параллелизм и более тонкий контроль потока (backpressure). С другой стороны, более длительные батч-процессы позволяют снизить стоимость и упростить контроль точных обработок, но ограничивают оперативную аналитику. В реальности часто применяется гибридный подход: базовый батч на дневной цикл + потоковая подсистема для критичных сервисов и высокочастотных отчетов.
-
Обработка поздних данных и корректировка. В ingestion необходимо предусмотреть поздние события (late data) и задержанные обновления, которые могут нарушать окна обработки и консистентность. Подходы включают управление водоразделами временных окон (watermarks), дописывание в исторические партиции и автоматическую коррекцию ошибок в downstream-процессах.
-
Архитектурные паттерны для задержки. Для снижения задержки часто применяют паттерны: (1) разделение потоков на «мгновенные» для критичных источников и «постепенные» для остального, (2) использование соответствующих очередей и коннекторов, (3) кэширование на стороне потребителя и (4) горизонтальное масштабирование конвейеров обработки и хранилища. Важно заранее определить границы пропускной способности и стратегию перераспределения вычислительных мощностей при пиковых нагрузках.
В рамках техники инжестии важно устанавливать целевые показатели задержки по каждому каналу и регулярно проводить слепки и синхронные тесты, чтобы понять влияние изменений в источниках и конфигурации. Архитектура должна быть адаптивной: способность уменьшать или увеличивать параллелизм, перераспределять ресурсы и переключаться между батчевым и потоковым режимами без потери согласованности.
Архитектура ingestion в рамках Hadoop
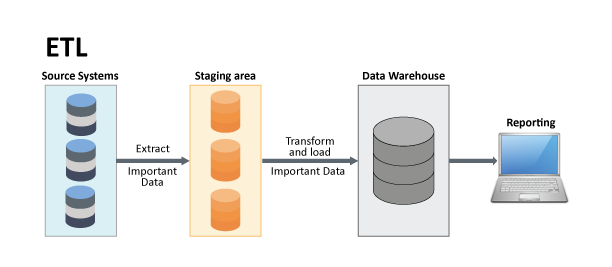
Контекст ingestion состоит из цепи компонентов, которые обеспечивают передачу данных от источников к хранилищам и вычислительным слоям Hadoop. В фундаменте лежит разделение ролей на источники, транспортировку и приемку, а затем на обработку и хранение. Рассматриваем базовую модель, которая сочетает потоковую передачу и батчевую загрузку:
-
Источник данных. Это точки входа: CDC-потоки из оперативных баз данных, файлы на файловой системе, API-эндпойнты, журналы приложений и логи. В большинстве реальных проектов используются несколько источников, что требует общего уровня абстракций и конвергентной схемы маршрутизации.
-
Канал транспортировки. Для потоковых данных центральной ролью часто выступает система сообщений (например, Apache Kafka) как транспортный слой, обеспечивающий буферизацию, упорядочение и репликацию. Для батчевых источников применяются коннекторы к файловым системам, FTP/S3 и другим источникам, которые обеспечивают загрузку и инкрементальное чтение.
-
Ингест-агенты. Эти элементы отвечают за извлечение, нормализацию и передачу данных в целевые слои. В потоковой архитектуре агентами чаще становятся связующие коннекторы и преобразовательные модули, поддерживающие консьюмер-коллекторную модель. В батчевых конвейерах - расписанные задания, которые периодически читают данные, валидируют схему и записывают в целевые слои.
-
Преобразование и хранение. После получения данные приводят к согласованной схеме и формату, обычно Parquet или ORC, и размещаются в области landing, затем partitioning и индексация переходят в аналитические слои. Важно обеспечить совместимость изменений схем и поддерживать версионирование, чтобы downstream-потребители смогли адаптироваться к обновлениям.
-
Мониторинг и качество. В рамках архитектуры ingestion должны быть встроены механизмы мониторинга задержек, ошибок, пропускной способности и целостности данных. В качестве инструментов качества данных применяются правила валидации, дедупликация и ретенш данных.
-
Интеграции и протоколы. Архитектура должна поддерживать совместимость между системами, использовать устойчивые протоколы и безопасные каналы, а также обеспечивать контроль доступа и аудит передачи данных. При выборе источников и транспортных слоев предпочтение отдается устойчивым к сбоям протоколам и готовности к горизонтальному масштабированию.
Применение конкретных инструментов в ingestion должно соответствовать целям задержки и устойчивости. В рамках технического курса выделим две ключевые open-source технологии, которые часто используются как ядро для поточной и батчевой ingestion:
-
Apache Kafka как транспортный слой для потока данных. Kafka обеспечивает масштабируемую, устойчивую к сбоям очередь сообщений с различными режимами доставки, поддержкой разделов и репликаций, что позволяет строить архитектуру с низкой задержкой и высокой пропускной способностью.
-
Apache NiFi как коннекторная платформа для интеграции источников и доставки данных в различные хранилища. NiFi гибко управляет потоками, поддерживает потоковую обработку и батчевые сценарии, предоставляет инструментальные средства по маршрутизации, конвертации и трассировке данных.
На верхнем уровне организации потоков ingestion можно оформить так, чтобы каждый источник данных имел свой коннектор и свой канал передачи. Kafka выступает как основной «мягкий трубопровод» для потоков, тогда как NiFi может организовывать архивацию, конверсию и доставку в различные целевые слои (HDFS, Hive, HBase, Kudu). Включение этих технологий требует аккуратной настройки задержек, обработки ошибок и повторных попыток, чтобы минимизировать потери и обеспечить управляемость.
-
Протоколы и конвергенция. Для эффективной интеграции применяются такие протоколы как Kafka протокол, HTTP/REST для API, а также протоколы обмена через Avro или Protobuf. Схема конвергенции обеспечивает единый формат входящих данных на стадии ingest и согласование полей на downstream-слоях.
-
Эволюция схем. Поддержка изменений схем - важная часть архитектуры ingestion. Это достигается через внедрение схемных референсов, версионирование полей и обратную совместимость. В частности, Avro/Parquet позволяют истории полей сохранять совместимость и поддерживать миграцию данных без прерывания эксплуатации.
-
Таблица: паттерны интеграции (иллюстративная)
| Паттерн | Инструменты | Что обеспечивает | Задачи |
|---|---|---|---|
| Потоковая ingestion | Kafka | Буферизация, упорядочение, репликация | Низкая задержка, обеспечивающая поставку в реальном времени и устойчивость к сбоям |
| Коннекторная интеграция | NiFi | Маршрутизация потоков, конвертация форматов, контроль качества | Миграция данных из разных источников в единую схему, управление ошибками и задержками |
Архитектура ingestion в Hadoop требует ясной стратегии разделения обязанностей, поддержания согласованности и обеспечения гибкости для изменений источников и требований. В рамках курса важно проработатьRAFT (Reliability, Availability, Fault Tolerance) и обеспечить упреждающее тестирование потоков, мониторинг задержек и детерминированную обработку ошибок.
Протоколы, коннекторы и управление изменениями схем
-
Протоколы обмена. При выборе протоколов следует учитывать требования к латентности, надёжности и экономии пропускной способности. Например, JMS и AMQP применяются в контекстах интеграции между корпоративными сервисами, тогда как Kafka-протокол обеспечивает эффективную транспортировку больших объемов событий в реальном времени.
-
Коннекторы к источникам. В рамках ingestion часто применяют коннекторы к RDBMS (через CDC-потоки), файловым хранилищам и API. Важно обеспечить поддержку повторной отправки без потери данных, а также возможность ретрансляции в случае сбоев.
-
Эволюция схем. При изменениях схем ключевым является поддержка схемной эволюции без нарушения существующих потребителей. Это достигается через совместимое изменение полей, использование версионирования и конвертацию снепшотов данных. В практической реализации это позволяет поддерживать непрерывность аналитических процессов при обновлениях источников.
Управление данными и хранение
Эффективное хранение данных в Hadoop достигается за счет партиционирования, использования эффективных форматов и каталогизации. В ingestion разделение по времени (time-based partitioning) является базовым подходом - например, по дате загрузки или по диапазонам времени событий. Дополнительно применяют уровни партиционирования по бизнес-атрибутам (организация, регион, источники) для ускорения запросов и оптимизации хранения.
-
Форматы хранения. Parquet и ORC - предпочтительные форматы для аналитических запросов в Hadoop благодаря колонной структуре, сжатию и эффективной поддержке сложных типов данных. Avro используется как средство сообщения и сериализации в потоках, где важна эволюция схем и компактная передача.
-
Хранилище и каталоги. Landing-зоны в HDFS/HDFS-сообщества могут быть организованы как разделяемые пространства. Hive/Impala/Presto читают из этих зон, используя базу данных High-level и внешние таблицы. Важна поддержка обновляемости и совместимости между парадигмами. В дополнение может применяться хранилище столбцов Kudu для операций со средними задержками и быстрой записью и чтением.
-
Партиционирование и управляемость. Эффективное партиционирование требует продуманной стратегии: временная партиция, субпартиционирование по регионам, источникам и прочим бизнес-сенсорам. Динамическое добавление партиций и автоматический сбор metadata позволяет снизить задержки на чтении и писать данные эффективнее.
-
Метаданные и каталогизация. Управление данными требует транспортировки и учета метаданных. Apache Atlas или Amundsen могут служить системами каталога и lineage, что облегчает соответствие требованиям регуляторной отчетности и data governance. В рамках одного раздела достаточно упомянуть один пример, чтобы не перегружать текст. Атрибуты таких систем включают происхождение данных, владельца, версии схем и взаимосвязи между данными.
-
Таблица: подходы к хранению и каталогизации
| Компонент | Роль | Преимущества | Примечания |
|---|---|---|---|
| Parquet/ORC | Колонный формат | Эффективная компрессия, быстрые сканы | Поддерживает сложные типы и обновления схем |
| Hive/Impala/Presto | SQL-интерфейс | Удобство анализа, совместимость | Важна консистентность схем и partitioning |
| Apache Atlas | Каталогизация | Управление данными, lineage | Подходит для регуляторных задач |
Управление данными в Hadoop требует не только технических решений, но и методологий по управлению качеством, версии и соответствию. В ingestion особенно важно обеспечить консервацию качественных данных на протяжении всего жизненного цикла: от источника до конечной аналитики. Это включает в себя мониторинг, валидацию и ретенцию, чтобы снизить риски в проектах по цифровой трансформации.
Метрики, мониторинг и качество данных
Эффективная ingestion-система обладает встроенными механизмами мониторинга и качества данных. Необходимо определить набор ключевых метрик, которые позволяют отслеживать задержку, пропускную способность, точность и полноту данных.
-
Метрики задержки и freshness. Включают end-to-end latency (от события до доступности в аналитическом слое), processing latency внутри конвейеров и backlog (объем не обрабатываемых событий). Эти показатели помогают определить узкие места и определить, где требуется увеличение параллелизма или переработка потоков.
-
Точность и полнота данных. Метрики качества включают долю успешных загрузок, процент ошибок в валидаторах схем, уровень дубликатов и пропусков. Поддержка детектирования аномалий в данных (например, резкое изменение объема событий) помогает предотвратить и локализовать проблемы.
-
Контроль версий схем и согласованность. В ingestion важно иметь четко регламентированное управление версиями схем. Это обеспечивает совместимость downstream- процессов и позволяет безопасно обновлять колонны, изменять типы и добавлять новые поля без прерывания анализа.
-
Линейность и аудит данных. Линейность данных позволяет проследить путь каждого элемента данных: источник -> конвейер -> целевые слои. Это важно для аудита, согласования данных и регуляторных задач.
-
Мониторинг инфраструктуры. Включает мониторинг очередей сообщений, задержек сетей, производительности дисковых подсистем и кластера вычислений. Неформализованные сигналы в системах мониторинга часто приводят к пропуску или задержкам при пиковых нагрузках.
-
Таблица: метрики ingestion
| Метрика | Что измеряет | Как использовать | Примечания |
|---|---|---|---|
| End-to-end latency | Время от события до аналитики | Целевой порог SLA | Учитывает все этапы, включая запись и обработку |
| Backlog | Объем не обработанных запросов | Прогнозирование перегрузок | Хорош для планирования масштабирования |
| Data quality error rate | Доля ошибок в загрузке | Открытие причин и исправление | Включает дубликаты, пропуски и нарушения контрактов |
| Schema drift | Изменения структуры данных | Управление миграциями и совместимостью | Обеспечивает устойчивость downstream-слоев |
| Data lineage | Пути данных | Аудит и соответствие | Важный элемент governance |
Мониторинг должен быть встроен на каждом уровне ingestion: от источника данных до целевых слоев. Набор инструментов и подходов может включать наблюдаемые дашборды, алертинг по SLA и автоматическую идентификацию отклонений. Важная задача - обеспечить способность оперативно реагировать на проблемы, автоматически перераспределять ресурсы и задействовать резервные каналы.
Практические сценарии и внедрение
Успешное внедрение ingestion в Hadoop требует последовательности действий и управляемого перехода к архитектуре большого масштаба. Рассмотрим общий путь:
-
Этап планирования. Определение источников, частоты обновления, требуемой задержки и бизнес-целей. Определение форматов хранения и форматов потоков, а также требований к качеству данных и governance.
-
Выбор архитектурного паттерна. Решение между полностью потоковым, батчево-проходным или гибридным подходом. Промежуточные решения часто включают «слой ingestion» на базе Kafka для потоковых данных и батчевые загрузки файлов в параллельной обработке.
-
Реализация базового конвейера. Настройка коннекторов к исходникам, определение форматов данных, построение landing-зоны в HDFS, настройка партиционирования и схем. Вводится базовый набор правил качества и валидаторов схем.
-
Мониторинг и валидация. Включение метрик задержки, качества данных, lineage и алертинг. Включение процесса backfill и планов на случай сбоев, а также подготовка к поздним данным.
-
Масштабирование и эволюция. По мере роста объема данных и числа источников расширяется инфраструктура: добавляются консьюмеры, перераспределяется вычислительный ресурс, добавляются новые коннекторы для источников. Введение новых форматов и схем должно происходить согласованно с downstream-потребителями.
-
Примеры конфигурации без кода. В рамках методического пособия рекомендуется описать конфигурационные принципы и архитектурные решения без привязки к конкретным примерам кода. В случае необходимости можно привести минимальные иллюстративные конфигации в виде описаний параметров (например, компрессия Parquet, размер batch-пакета, параметры Kafka для прерыва).
Key takeaways
-
Ингестия - это связующее звено между источниками данных и Hadoop-хранилищами, требующее учета задержки, форматов и схем.
-
Выбор форматов и схем влияет на пропускную способность, производительность запросов и устойчивость к изменениям.
-
Внедрение паттернов CDC, потоковой передачи через Kafka и коннекторов типа NiFi позволяет строить гибкие и устойчивые ingestion-конвейеры.
-
Задержка и freshness зависят от бизнес-требований и требуют компромиссов между стоимостью, пропускной способностью и устойчивостью.
-
Управление метаданными, версионированием схем и качеством данных является неотъемлемой частью ingestion и governance.
-
Мониторинг end-to-end задержки, backlog и качество данных позволяет оперативно реагировать на сбои и поддерживать SLA.
-
Подход к внедрению должен быть поэтапным: планирование, архитектура, реализация, мониторинг и масштабирование.
FAQ
- Что такое latency и freshness в контексте ingestion и почему они важны для Hadoop?
Latency - это задержка между возникновением события в источнике и его отражением в аналитическом слое. Freshness - степень актуальности данных в момент запроса. Обе концепции критичны: низкая задержка позволяет оперативной аналитике реагировать на события, высокая freshness обеспечивает точность данных. В Hadoop они зависят от сочетания батчевых и потоковых конвейеров, форматов данных и механизмов обработки. В рамках курса рекомендуется определять целевые пороги по каждому источнику и уровню данных, а затем проектировать конвейеры так, чтобы соответствовать установленным SLA.
- Какие источники требуют наибольшего внимания к задержке?
Источники с реальной потребностью во времени реагирования - это финансовые транзакции, онлайн-операции и события пользовательского поведения в реальном времени. CDC-источники, веб-API и IoT-данные часто требуют минимальной задержки, тогда как архивные файлы и batched-данные могут tolerировать более широкие окна. В архитектуре ingestion следует выделить «мгновенные» каналы и обеспечить минимальные очереди и обработку без потери данных.
- Какие форматы данных лучше использовать для ingestion в Hadoop?
Выбор форматов зависит от целей хранения и анализа. Parquet и ORC - предпочтительные форматы для аналитической нагрузки благодаря колонной структуре и эффективной компрессии. Avro - удобен для сериализации потоковых сообщений и поддержки схемной эволюции. JSON удобен для гибкой передачи и API-интеграций, но требует дополнительной обработки для эффективного анализа. При проектировании ingestion следует сочетать эти форматы так, чтобы обеспечивать эффективное хранение и ускоренное чтение.
- Как обеспечить идемпотентность при ingestion из источников CDC или API?
Идемпотентность достигается через ключевые идентификаторы записей, детерминированные вычисления и повторно применимые операции записи. В CDC источниках это может быть achieved через уникальные ключи изменений и устойчивые идентификаторы версий. При повторной доставке можно использовать upsert-подходы и детерминированные правила конвертации, чтобы избежать дубликатов и неконсистентности.
- Какие архитектурные паттерны подходят для гибридного ingestion?
Гибридный подход сочетает потоковую ingestion через Kafka для критичных событий и батчевые загрузки для менее чувствительных к задержке данных. NiFi может выступать как оркестратор и конвертер, связывая источники с целевыми слоями, тогда как Kafka обеспечивает транспортировку и буферизацию. Этот подход позволяет балансировать требования по задержке, устойчивости и стоимости.
- Какие меры по качеству данных являются обязательными в ingestion?
Обязательные меры включают валидацию схем, дедупликацию, обработку пропусков, контроль согласованности и поддержку lineage. Важно устанавливать контракт данных, версионирование схем и модули тестирования, чтобы предотвратить неожиданные изменения в downstream-потребителях. Мониторинг ошибок и автоматические алерты помогают быстро обнаруживать проблемы и сохранять качество аналитических данных.
- Как обеспечить масштабирование ingestion в больших Hadoop-проектах?
Необходимо проектировать конвейеры с горизонтальным масштабированием: добавление коннекторов, увеличение числа разделов в Kafka, распределение задач по кластерам Spark/Flink и расширение зон хранения. Важна модульная архитектура, независимые очереди для критичных источников и четкие принципы управления пропускной способностью, чтобы можно было динамически адаптироваться к пиковым нагрузкам без потери согласованности.
- Какова роль метаданных в ingestion и зачем нужен каталог данных?
Метаданные обеспечивают контекст и управляемость данных: происхождение, ответственность, версия схем, lineage и регуляторные требования. Каталоги данных упрощают поиск, соответствие требованиям и аудит. В рамках ingestion Apache Atlas (или аналогичные системы) может быть применен для обеспечения прозрачности и контроля над данными на каждом этапе конвейера.
- Какие риски связаны с ingestion и как их минимизировать?
Основные риски включают потерю данных, дубликаты, неконсистентность схем, задержки и сбои конвейеров. Риск минимизируется через использование CDC для точной репликации изменений, idempotentных процессов, детального контроля версий схем, устойчивых конвейеров и мониторинга. Также рекомендуется планировать резервирование каналов, реализовывать ретрансляцию и проводить регулярные тесты восстановления.
- Как внедрять ingestion в контексте цифровой трансформации?
Внедрение ingestion должно быть частью стратегического плана цифровой трансформации: начинается с определения требований к задержке и данным, выбора архитектурных паттернов и инструментов, затем реализуется пилотный конвейер, после чего масштабируется. Важно обеспечить прозрачность, governance и управление изменениями, чтобы новые источники могли интегрироваться без прерывания текущей эксплуатации и с минимальными затратами на изменение downstream-потребителей.
Глава охватывает базовые принципы ingestion в Hadoop: источники, частота обновления и требования к задержке, архитектурные решения, хранение и качество данных, а также практические пути внедрения. В сочетании с примерами паттернов интеграции и практическими подходами к мониторингу и управлению данными, данное исследование формирует основу для эффективной реализации ETL-процессов в условиях больших данных и цифровой трансформации организаций.


