

Гибридные источники данных в Apache Flink: архитектура, реализация и влияние на задержку, согласованность и устойчивость системы

Введение: контекст и назначение гибридных источников данных в Apache Flink
Гибридные источники данных представляют собой алгоритмическую и инженерную концепцию, позволяющую обрабатывать последовательность данных из разных источников в рамках одного потока Flink. В рамках современных архитектур данных такие сценарии становятся обычной необходимостью: исторические данные, хранящиеся в пакетных хранилищах, дополняются потоками изменений в реальном времени, поступающими из систем стриминга. В основе гибридного источника лежит идея объединения нескольких отдельных источников чтения в единое логическое ядро, которое читает данные в заданном порядке и обеспечивает согласованность их состояния на протяжении переключений между источниками. Такой подход существенно упрощает реализацию лямбда-архитектуры данных, усиленно применяемой в аналитике, машинном обучении и моделировании бизнес-процессов.
Истоки концепции восходят к потребности целостной постановки задачи, когда целевые данные хранятся разрозненно: снимки в распределённых файловых системах (Hadoop Distributed File System, Hadoop HDFS, или облачных хранилищах вроде Amazon S3), журнал изменений в транзакционных логах или брокерах сообщений (например, Apache Kafka), а также другие базы данных - реляционные или нереляционные. До выхода в Flink версии 1.14 задача интеграции таких разнотипных источников требовала параллельного запуска нескольких заданий, составления собственных коннекторов и сложной логики согласования состояния. В этом контексте HybridSourceпревратился в стандартный API поверх существующих коннекторов, обеспечивая последовательное чтение нескольких источников и их динамическое переключение с сохранением целостности данных.
Рассматривая архитектуру гибридного источника, следует отделять концептуальные слои: определение цепочки источников, управление их состоянием и координацию переключения. Важной частью является механизм ограничения источников, который обеспечивает корректную и предсказуемую инициализацию начальных позиций для каждого из них. Этот подход позволяет пользователю смещать границу между пакетной обработкой и потоковой обработкой, соблюдая требования к времени задержки, согласованности и надёжности.
Стратегически гибридные источники позволяют достигнуть следующих преимуществ:
- снижение задержек чтения за счёт плавной интеграции данных из нескольких источников;
- упрощение архитектуры дерева задач и упорядочивания состояний;
- возможность реализации лямбда-архитектуры без множества самостоятельных задач;
- расширяемость: повторное использование существующих коннекторов и поддержка пользовательских комбинаций.
Однако подобная архитектура несёт и риски: повышенную сложность координации состояний, необходимость точной синхронизации между источниками и потенциальные издержки на согласование позиций, особенно при динамическом переключении. В рамках настоящей статьи мы детально рассмотрим архитектуру, механизмы реализации, эксплуатационные аспекты и практические рекомендации по внедрению гибридных источников в экосистеме Apache Flink.
Архитектура гибридного источника: Split, SplitEnumerator и SourceReader
Ключ к Understandable моделированию гибридного источника в Flink лежит в трёх базовых компонентах стандартной архитектуры источников потоков: Split, SplitEnumerator и SourceReader.
-
Split (разделение) представляет собой фрагмент данных, который может быть прочитан независимо от остальных. Он задаёт единицу параллелизма внутри источника: файл, участок журнала, сегмент очереди сообщений или иной логический блок. Разделения служат грануляцией чтения и позволяют диспетчеру задач Flink равномерно распределять работу между считывателями. В контексте гибридного источника каждый источник имеет набор разделений, которые подготавливаются перечислителем и передаются в читающие задачи.
-
SplitEnumerator - это механизм генерации и распределения разделений между читающими задачами. Он функционирует как отдельный оператор-фабрика в диспетчере заданий (JobManager) и отвечает за балансировку нагрузки, хранение незавершённых операций и повторное назначение разделений при сбоях. В HybridSourceEnumerators реализуется логика, которая поддерживает передачу состояния между уровнями и позволяет переключать источники в рамках одной цепи.
-
SourceReader - это непосредственный механизм чтения данных из конкретного разделения. Он подписывает курс на чтение того или иного источника и последовательно обрабатывает данные, создавая поток событий в рамках задачи. В контексте гибридного источника каждый SourceReader может быть связан с разными типами источников, которые последовательно сменяются в процессе обработки.
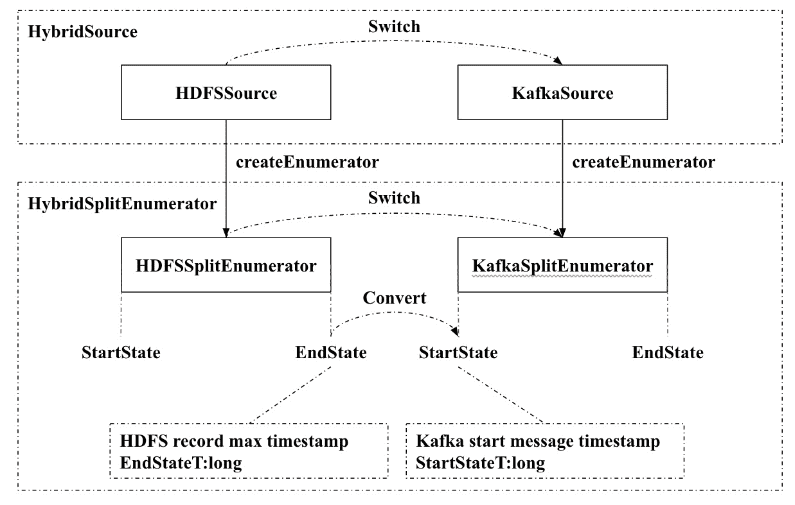
Гибридный источник строится на основе цепочки источников, формируемой через промежуточный конструктор HybridSourceBuilder. Основная идея - "склеить" последовательность из нескольких источников, где каждый следующий источник может иметь свой собственный механизм инициализации позиций, ограничений и стратегий переключения. У реализации есть важная особенность: предшествующие источники ограничиваются (bounded), а последний источник часто может быть ограничен или неограничен в зависимости от конкретной конфигурации и требований к задержке. Такое моделирование обеспечивает целостность и упорядоченность чтения, особенно когда первая часть цикла отвечает за исторические данные, а последующая - за данные в реальном времени.
В заключение архитектурного оформления: гибридный источник - это не просто набор коннекторов; это управляемая цепь чтения, где каждый элемент может иметь собственную логику инициализации, состояния и переключения между источниками. Это позволяет повторно использовать существующие коннекторы и устанавливать строгие правила перехода между источниками, обеспечивая согласованность и устойчивость всей цепи.
Формирование цепочки источников: HybridSourceBuilder и принципы ограничения источников
Формирование цепочки источников в рамках HybridSource начинается с базового источника и последующего добавления вторичных источников через строителя. В архитектуре, где важна предсказуемость порядка чтения и контроль над состояниями, принцип ограничения источников играет центральную роль.
-
HybridSourceBuilder позволяет конструировать цепочку источников через концепцию отложенного создания экземпляров (lazy instantiation). Это означает, что для каждого элемента цепочки создаётся соответствующий SourceEnumerator, а следом - конкретный источник на этапе переключения или запуска. Такой подход позволяет не создавать все источники сразу, а строить их по мере необходимости, тем самым экономя ресурсы и снизив задержки запуска.
-
SourceFactory выступает как абстракция, ответственная за создание конкретных источников во время построения направленного ациклического графа (DAG) выполнения всей задачи. В контексте динамических переключений SourceFactory может отложенно создавать следующий источник на основе контекста переключения, что особенно полезно при чтении данных из файлов и последующей передачи чтения в потоковую систему.
-
Принцип ограничения источников требует, чтобы все источники, кроме последнего, были ограничены (bounded). Это означает, что они имеют ограниченную конечность чтения и после завершения своего диапазона передачи данных следующий источник может начать чтение. Последний источник может быть ограничен или неограничен (bounded или unbounded), в зависимости от потребности и конфигурации потока.
-
Начальные и конечные позиции - это ключевые параметры для каждого источника в цепочке. Для ограниченных источников устанавливаются конкретные начальные позиции, а для последнего источника часто не требуется такой строгой градации, когда он реализован как неограниченный поток. В общем случае конец одного источника служит "передачей" для начала следующего источника, что обеспечивает непрерывность читания и согласованность между ними.
Данный подход позволяет строить практически произвольные цепочки: начиная с файловых источников, затем переходя к источникам журналов изменений (binlog) или к топикам в Kafka. Важной особенностью является факт, что каждый источник может задавать собственную стратегию старта и ограничения, а переход между ними выстраивается через механизмы переключения, в том числе через использования информации о позициях, полученной в предыдущем источнике.
Роль SourceFactory и динамическое создание источников во времени переключения
Одной из сложнейших задач гибридного источника является динамическое создание источников во время выполнения переключений. В реальной системе ситуация может выглядеть так: большой файловый источник требует длительного чтения, что политически не оптимально совмещать с непрерывной подачей последующего источника. В таких случаях необходимо заранее определить момент переключения и передать конечную позицию из текущего источника в последующий.
-
SourceFactory - это посредник, который, получая контекст переключения, способен создать следующий источник на основе информации из предыдущего перечислителя. В частности, в динамическом сценарии перехода файл → Kafka, SourceFactory может использовать конец файла (END_POSITION) в качестве начальной позиции для Kafka-потока. При этом важна точная передача временной метки окончания и её трактовка в следующем источнике.
-
Принцип передачи позиций во время переключения основывается на обмене состояниями между уровнями: текущий перечислитель сообщает конечную временную метку и статус обработки, а новый источник на основе этого значения устанавливает свою START_POSITION. В Java-API такие механизмы реализованы через конкретные интерфейсы переключения, тогда как Python API ограничен в части динамического переключения и передачи состояний.
-
В контексте реализации на Java метод switchContext предоставляет доступ к информации о предыдущем перечислителе, включая его END_POSITION. Это позволяет формировать новый источник с начальной позицией, основываясь на достигнутом прогрессе. Фактически SourceFactory выполняет роль адаптера между разными типами источников и их механизмами начала чтения.
-
Динамическое создание источников во времени переключения требует аккуратной синхронизации и детальной логики обработки ошибок. В частности, необходимо учитывать возможные задержки между завершением чтения текущего разделения и началом чтения следующего источника, чтобы избежать потери данных или дублирования. Это особенно критично для сценариев, где первый источник является историческим и завершение может произойти после долгого времени чтения.
Итак, роль SourceFactory состоит в том, чтобы позволить гибридному источнику открывать следующий источник именно в момент переключения и на основе информации, полученной из предыдущего источника, не нарушая порядок и целостность данных. Это позволяет строить маршруты чтения, которые корректно переходят от пакетной обработке к потоковой и обратно, при сохранении связности состояний между источниками.
Механизм переключения между источниками: порядок чтения и управление состоянием
Переключение между источниками в гибридном источнике - это управление порядком чтения и согласованием состояния между соседними сегментами цепи. В стандартной реализации гибридного источника первый источник читается до завершения своего диапазона, затем начинается следующий, и так далее, образуя линейную последовательность чтения. Такой подход обеспечивает простую логику и предсказуемость для аналитиков и инженеров.
-
Порядок чтения - это порядок, в котором источники добавляются в HybridSourceBuilder и в котором они должны читать данные. Обычно сначала идёт источник для исторических данных, затем источник, отвечающий за текущие изменения. В рамках этих условий первый источник имеет ограничение (bounded), а последующий может быть ограничен, либо нет, в зависимости от конкретной реализации.
-
Управление состоянием включает сохранение состояния разделений и позиции каждого источника. SplitEnumerator отвечает за состояние разделённых частей и их распределение между SourceReaders. При переключении состояние предыдущего источника передаётся в новом источнике через начальные позиции. Важно, чтобы состояние последнего разделения на уровне перечислителя было сохранено и корректно применено к следующему источнику, чтобы избежать повторного чтения уже прочитанных данных и пропуска данных.
-
В некоторых сценариях переключение может происходить динамически - не по достижению полного завершения первого источника, а на заранее заданном моменте времени. В этом случае SourceFactory и механизм переключения должны поддерживать передачу конечной временной метки (END_TIMESTAMP) через логику switchContext, чтобы новый источник начал работать с временной метки, соответствующей моменту переключения. Такой подход обеспечивает корректную синхронизацию временных контекстов и предотвращает потерю данных.
-
Вопрос синхронизации между источниками особенно остро стоит при работе с файловыми источниками. Файловые источники могут иметь нетривиальные характеристики задержки чтения больших файлов, а Kafka, с другой стороны, требует поддержания потока непрерывного чтения. Правильно реализованное переключение учитывает это различие и минимизирует задержки, используя динамическое создание источников и корректную передачу позиций.
Таким образом, механизм переключения между источниками в HybridSource - это сочетание упорядоченной последовательности чтения, аккуратного сохранения состояний и динамической адаптации к временному контексту переключения. Это обеспечивает единое поведение для пользователей и поддерживает требования к нумерации и согласованию позиций.
Управление позициями: начальные и конечные позиции для источников
Одной из критических задач гибридного источника является управление позициями чтения, которые определяют, где именно читать данные в каждом источнике и как переключаться между ними. В рамках HybridSource это достигается за счёт явной установки начальных позиций у каждого источника, а для некоторых источников - и конечных позиций (end states) после их завершения.
-
Начальная позиция - это указатель начала чтения для данного источника. Для источников типа Kafka или других стриминговых систем начальная позиция может быть задана заранее через систему инициализации. Например, для Kafka начальная позиция может быть определена как смещение в топике на заданное значение времени или офсет.
-
Конечная позиция - это состояние, которое определяет завершение чтения текущего источника. Для файловых источников это часто максимальная временная метка записей файла или иной консолидированный показатель завершённости. Конечная позиция служит передаточным механизмом для следующего источника: когда текущий источник достигнет своей END_POSITION, следующему источнику нужно считать начальную позицию на основе этой END_POSITION.
-
В контексте динамического переключения концевые позиции передаются через SourceFactory. Конечная позиция одного источника становится начальной позицией следующего, благодаря чему сохраняется непрерывность и отсутствие пропусков в потоке данных. Этот механизм особенно важен, когда файловый источник служит предварительным этапом и должен перейти к Kafka, начиная с момента, соответствующего окончанию чтения файла.
-
Важное замечание: начальные и конечные позиции должны обрабатываться так, чтобы не возникало противоречий между различными источниками. Это означает, что каждый источник должен иметь возможность объявлять свои ограничения и корректно обрабатывать ситуацию, когда начальная позиция выходит за пределы диапазона, доступного в источнике. В таких случаях необходимо аккуратно обработать исключения и обеспечить корректный отклик на переключение.
Управление позициями в гибридных источниках требует точной координации между перечислителями и SourceReaders, а также прозрачности состояния для системы мониторинга и администрирования. Реализация правильной схеме управления позициями напрямую влияет на задержку, пропускной способность и целостность данных в критичных сценариях.
Пример реализации: чтение из файла и Kafka через HybridSource
Чтобы иллюстрировать концепцию гибридного источника, рассмотрим типичный сценарий: чтение данных из файлового хранилища до заданной временной метки и последующее переключение на топик Kafka для непрерывного поступления.
-
В качестве примера на языке Java можно сформировать следующие элементы: FileSource и KafkaSource являются базовыми источниками, где FileSource считывает записи из тестового каталога, а KafkaSource читает сообщения из топика. Затем HybridSource объединяет их в цепочку: файл вначале, затем Kafka. Пример иллюстративен и демонстрирует, как можно задать начальные позиции для Kafka через временную метку switch_timestamp.
-
Реализация через HybridSourceBuilder предполагает создание источника с отложенной инициализацией на основе предыдущего перечислителя. Это значит, что при переключении между источниками SourceFactory использует информацию о предыдущем перечислителе для формирования нового источника. В реальном проекте это позволяет задавать начальные позиции для Kafka на том же времени, где файл закончил чтение, тем самым обеспечивая целостность и непрерывность данных.
-
Важное практическое замечание: в рамках Python API динамическое переключение и создание источников во времени переключения не поддерживается в полной мере. Для производственных задач на Java API это решение позволяет реализовать сложные сценарии наподобие лямбда-архитектуры, когда исторические данные и потоковые данные объединяются в одном потоке.
-
Реализация, приведенная в источнике, может быть повторена в реальных условиях с необходимостью настройки параметров: константы времени начала чтения, форматы сериализации, настройки брокеров (bootstrap servers) и групп потребителей, а также стратегий ограничений. Такой подход демонстрирует, насколько гибко и мощно может быть реализована концепция гибридного источника в рамках действующей экосистемы Flink.
Этот пример демонстрирует логическую схему: сначала охватить исторические данные через файловый источник, затем перенести чтение в потоковую систему Kafka, поддерживая непрерывность и целостность, используя сигналы переключения и передачу позиций между источниками.
Влияние на задержки и согласованность: преимущества и ограничения гибридных источников
Гибридные источники в Apache Flink обещают синергии в отношении задержек чтения и согласованности данных. Однако, как и любая инженерная методика, они обладают как преимуществами, так и ограничениями.
-
Преимущества:
- **Ускорение аналитики***: единственный поток чтения упрощает разработку и мониторинг, снижая задержки между источниками.
- **Управление согласованностью***: благодаря передаче позиций и контролю состояния между источниками, данные читаются в последовательности и с минимальными расхождениями во времени.
- **Лямбда-архитектура и ML***: возможность сочетать исторические данные с потоковыми данными облегчает реализацию моделей ML, построенных на бинарном сочетании времён.
- **Повторное использование коннекторов***: гибридный источник строится поверх существующих коннекторов, что упрощает внедрение и снижение издержек на разработку.
-
Ограничения и риски:
- **Дополнительная задержка на согласование***: переключение между источниками требует согласования состояний, что может добавлять задержку в критических сценариях.
- **Сложность реализации***: поддержка динамического переключения требует точной координации между перечислителями, SourceFactory и Reader, что может усложнить отладку.
- **Управление состоянием***: в условиях сбоев необходимо обеспечить корректное восстановление состояния и повторное воспроизведение данных без потерь.
- **Python API ограничения***: в контексте Python API гибридные сценарии могут быть ограничены по сравнению с Java API, что влияет на выбор языка разработки в зависимости от проекта.
-
Произведение баланса между задержками и согласованностью требует детального проектирования и моделирования задержек на уровне архитектуры. В отдельных сценариях может оказаться эффективной изолированная последовательная обработка без переключения или использование других подходов, таких как дополнительные микросервисы или параллельное выполнение нескольких заданий Flink.
Эти принципы помогают архитекторам принимать обоснованные решения: когда включать гибридные источники, как настраивать начальные и конечные позиции, какие источники лучше сочетать, и как оценивать влияние на задержку в производственной среде.
Исторические данные против потоковых данных: лямбда-архитектура и применение в ML
Лямбда-архитектура - концептуальная модель объединения обработок пакетной и потоковой обработок в рамках одной системы, где исторические данные обрабатываются пакетно, а текущие события - в потоке. В контексте гибридных источников она находит практическое применение: файл или другое пакетное хранилище может служить слоем исторической информации, тогда как Kafka или иной стриминг-сервис обеспечивает потоковую составляющую.
-
Базовые принципы:
- Исторические данные доступ к пакетной информации в HDFS/S3, которые сохраняются на долгий срок и читаются циклическим образом.
- Потоковые данные - непрерывный поток событий из Kafka и подобных систем, которые должны читаться с минимальной задержкой.
-
Применение к ML:
- Исторические данные часто необходимы для обучения и калибровки моделей: признаки могут включать месяцы или годы ранее, чтобы обучить модель на сезонных или долгосрочных трендах.
- Потоковые данные служат для онлайн-обновления и адаптивного обучения моделей, улучшения прогнозов в реальном времени и обработки событий по мере их поступления.
-
Проблематика:
- Комбинация исторических и потоковых данных может вести к задержкам в чтении и синхронизации серий, особенно в условиях динамического переключения.
- Необходимость поддерживать согласованность между двумя источниками и контроль версий данных.
Гибридные источники предоставляют инфраструктурную основу для реализации лямбда-архитектуры внутри Flink: исторические данные в одном источнике, потоковые данные в другом, объединенные в единое чтение. Это упрощает разработку, снижает сложность кода и ускоряет создание рабочих сценариев анализа и ML.
Эволюция функциональности: изменения после Flink 1.14
Версия Flink 1.14 стала значимой в плане внедрения универсального API гибридного источника поверх существующих коннекторов. Это изменение позволило повторно использовать коннекторы и сочетать источники данных в единой цепочке. Основные моменты эволюции включают:
- введение API гибридного источника поверх стандартного Source API, что означает совместимость с существующими коннекторами;
- поддержка формирования цепочек источников через HybridSourceBuilder, что позволяет более гибко управлять последовательностью чтения;
- введение концепции ограниченных источников (bounded) и неограниченных источников (unbounded) в контексте цепочки, и правила перехода между источниками;
- возможность передачи позиций из предыдущего источника в последующий через SourceFactory, что обеспечивает корректное переключение и согласованность состояний;
- частичные улучшения в API Java, включая подход к динамическому созданию источников во времени переключения.
Эти изменения сделали гибридные источники жизнеспособной и удобной архитектурной опцией для реализации лямбда-архитектуры в рамках Flink и расширили спектр применений, включая ML-пайплайны, где требуется объединить пакетные и стриминговые данные.
Интерфейсы программирования: Java и Python API, ограничения и возможности
Гибридные источники реализуются на двух основных языковых интерфейсах Flink: Java и Python. Они имеют различия и ограничения, которые необходимо учитывать при выборе языка реализации.
-
Java API:
- Полностью поддерживает динамическое переключение между источниками через SourceFactory и переключения на уровне перечислителей.
- Позволяет обращаться к контексту переключения через switchContext и получать доступ к предыдущему перечислителю и его END_POSITION.
- Поддерживает создание произвольных цепочек через HybridSourceBuilder и интеграцию существующих коннекторов.
- Предоставляет гибкость в настройке начальных и конечных позиций, а также особенностей ограниченности конкретных источников.
-
Python API:
- Частично поддерживает гибридные сценарии.
- В контексте динамического переключения и передачи позиций между источниками поддержка может быть ограничена.
- Обычно применяется в сценариях быстрого прототипирования и там, где основной стек разработки ориентирован на Python, но при необходимости гибридного поведения лучше использовать Java API или смешанную реализацию, чтобы обеспечить полноту функциональности.
-
Ограничения и возможности:
- Возможности интеграции с внешними системами чтения ограничиваются тем, насколько конкретный коннектор поддерживает начальные и конечные позиции, а также переключение между состояниями.
- Реализация через SourceFactory требует аккуратной обработки ошибок и восстановления состояния после сбоев.
- При выборе языка важно учитывать требования к мониторингу, трассировке и поддерживаемости в инфраструктуре организации.
Таким образом, Java API предоставляет наиболее полный набор инструментов для реализации гибридных источников, включая динамическое переключение и точную координацию состояний, тогда как Python API может быть ограничено в части функциональности, но остаётся полезным для быстрого прототипирования и разработки.
Интеграция с технологическими стеками: HDFS/S3, Kafka и другие хранилища
Гибридные источники интегрируются с различными системами хранения и обработки данных, что делает их гибким инструментом для современных корпоративных архитектур.
-
HDFS/S3 (Hadoop Distributed File System / Simple Storage Service) выступают как источники исторических данных. Эти хранилища обеспечивают долговременное хранение снимков состояния и событий, пригодных для пакетной обработки и повторной загрузки. В контексте гибридного источника они выступают в роли первого элемента цепи, обеспечивая начальные позиции до switch-перерыва.
-
Kafka и другие брокеры сообщений выступают как источники потоковых данных. Необходимо обеспечить корректную настройку начальных позиций (offsets или timestamp) и обеспечить беспрерывность чтения во время переключения. Kafka часто применяется как непрерывный источник после временного pensions чтения данных из файлов.
-
Другие хранилища:
- Реляционные и нереляционные базы данных (PostgreSQL, MySQL, Cassandra и т.д.) могут быть интегрированы как отдельные источники, которые могут переходить в цепочке гибридного источника.
- Облачные облачные источники (облачные объёмы, объекты в AWS, GCP, Azure) могут выступать как части цепи, читающие данные и предоставляющие дополнительную функциональность.
-
Мониторинг и согласование:
- Интеграция с инструментами мониторинга (Prometheus, Grafana) необходима для отслеживания задержек, пропускной способности и согласованности между источниками.
- Важно обеспечить трассировку по переключениям, чтобы выявлять задержки и сбои на конкретных источниках.
Интеграция с технологическими стеками требует продуманной архитектуры и согласованности в плане времени, форматов данных и управление состоянием. Гибридные источники дают гибкость, но требуют тщательного проектирования и настройки для обеспечения надёжной эксплуатации.
Метрики эффективности: производительность, задержки, целостность и мониторинг
Эффективность гибридных источников следует оценивать по нескольким ключевым метрикам, которые соответствуют общим целям обеспечения задержек, целостности данных и управляемости процессов.
-
Производительность чтения:
- Пропускная способность источников и степень параллелизма чтения.
- Эффективность переключения между источниками и влияние на общее время обработки.
-
Задержки:
- Время задержки между поступлением событий и их обработкой в рамках единого потока.
- Дополнительные задержки, связанные с согласованием позиций и переключениям между источниками.
-
Целостность и согласованность:
- Верность порядка чтения и отсутствие дублирования между источниками.
- Согласование состояний между перечислителями и Reader'ами при переключениях.
-
Мониторинг и наблюдаемость:
- Инструменты и показатели для отслеживания состояния источников, задержек и ошибок.
- Логи переключения и реакции системы на сбои.
-
Надёжность и устойчивость:
- Гарантии по восстановлению состояния после сбоев.
- Способы повторного воспроизведения данных и минимизация потерь.
Эти метрики помогают разработчикам и администраторам принимать решения о конфигурациях, корректировать параметры ограничений и оптимизировать конфигурацию цепочек источников для конкретных бизнес-задач.
Риски и ограничения: контроль состояния, архитектурная сложность и устойчивость
Как и любая продвинутая архитектура, гибридные источники несут риски, связанные с контролем состояния, сложностью архитектуры и устойчивостью.
-
Контроль состояния:
- Необходимость точного сохранения состояния между источниками и между перечислителями и Reader’ами.
- Возможность несовпадения состояний между источниками, когда переключение не синхронизировано или приводит к потерям/повторному чтению.
-
Архитектурная сложность:
- Добавление новых источников, управление их ограничениями и переходами требует внимательного проектирования и тестирования.
- Мониторинг и отладка сложной цепи источников может стать сложной задачей.
-
Устойчивость:
- Обращение к нескольким системам хранения может увеличить риск сбойных сценариев из-за несовместимости форматов, задержек или ошибок старта.
- Необходимо строить устойчивые механизмы восстановления после сбоев, в том числе повторная загрузка и повторное переключение.
-
Безопасность:
- Согласование доступа к различным источникам требует единых политик безопасности и аудита, чтобы избежать утечки данных между источниками.
-
Совместимость:
- При обновлении Flink версий возможны изменения в API гибридного источника, что требует тестирования совместимости.
Управление этими рисками требует тщательного проектирования, тестирования и мониторинга, а также документирования архитектуры для команды.
Конкурентный анализ: альтернативные решения и их дифференциация
Гибридные источники являются одним из вариантов интеграции пакетной и потоковой обработки в рамках экосистемы Apache Flink. В сравнении с альтернативами следует рассмотреть следующие подходы:
-
Запуск отдельных заданий Flink для каждого источника и последующая агрегация на уровне потребления. Это обеспечивает простоту реализации, но требует синхронизации данных между двумя или более заданиями, что может привести к большему времени задержки и сложному управлению состоянием.
-
Использование отдельных коннекторов для каждого источника без унифицированной цепи. Такой подход может быть проще в реализации, но не обеспечивает совместного управления состоянием и переключением между источниками.
-
Встраивание внешних механизмов обработки данных (например, Apache Beam) для реализации лямбда-архитектуры. Этот путь требует интеграции нескольких технологий и может повлиять на производительность и задержку.
-
Прямое использование коннекторов без гибридного слоя. Это упрощает архитектуру, но не обеспечивает последовательного чтения через разные источники.
Гибридные источники в Flink(diff) позволяют устранить некоторые ограничения и достичь сочетания баланса между управлением состоянием и эффективной обработкой. Важно помнить, что конкретный выбор зависит от требований к задержкам, согласованности и устойчивости, а также от доступности инструментов мониторинга и опытной команды.
Применение в экономических секторах: финансы, телеком, ритейл, производственные отрасли
Гибридные источники находят применение в различных отраслях, где требуется эффективное объединение исторических данных и потокового анализа.
-
Финансы:
- Слияние исторических торговых данных с текущей рыночной динамикой для построения моделей риска и алгоритмической торговли.
- Лямбда-архитектура может быть реализована через файлы изменений и Kafka-логи.
-
Телекоммуникации:
- Аналитика клиентских событий в реальном времени в сочетании с репозиториями исторических данных.
- Прогнозирование перегрузок и аномалий на основе совокупности данных.
-
Ритейл:
- Анализ покупательского поведения на основе исторических данных и текущих транзакций в реальном времени.
- Построение персонализированных рекомендаций и мониторинг цепочек поставок.
-
Производственные отрасли:
- Мониторинг оборудования в реальном времени в комбинации с историческими данными для прогнозирования отказов и технического обслуживания.
- Аналитика производственных процессов на основе данных, поступающих из разных систем.
Эти применения демонстрируют, как гибридные источники способны объединить различные виды данных и поддержать эффективные бизнес-аналитики и ML-пайплайны.
Практические рекомендации и лучшие практики реализации
- Определяйте требования к задержке и согласованности на уровне архитектуры, чтобы выбрать правильную стратегию ограничения и переключения между источниками.
- Используйте Java API для гибридных источников, если планируется динамическое переключение и точная координация состояний между источниками.
- Применяйте SourceFactory для передачи позиций между источниками, особенно в сценариях файловый источник → Kafka.
- Тщательно тестируйте переходы между источниками в условиях сбоев, включая сценарии неполного завершения чтения одного источника.
- Внедряйте мониторинг задержек, ошибок и переходов между источниками; используйте инструменты визуализации для отслеживания состояния цепи.
- Планируйте ресурсные потребности: гибридные источники требуют координации между диспетчером задач и SourceReaders, что может увеличить требования к памяти и сетевым каналам.
- Верифицируйте совместимость языков (Java vs Python) в рамках ваших разработческих стэков; если необходим полный набор функций динамического переключения - предпочтение Java API.
- Применяйте тестовые наборы данных, включающие как исторические, так и референсные потоки, для валидации согласованности при переключении.
Эти рекомендации позволяют избежать типовых ошибок, обеспечивают корректную реализацию и повышают устойчивость гибридной архитектуры.
Перспективы и будущее развитие гибридных источников в Flink
Гибридные источники остаются важной частью экосистемы Apache Flink, и их роль будет расширяться в будущих версиях. Основные направления развития могут включать:
- улучшение поддержки Python API для гибридных сценариев, чтобы расширить аудиторию разработчиков и ускорить прототипирование;
- дальнейшая оптимизация механизмов переключения и управления состоянием для снижения задержек и повышения устойчивости;
- расширение набора поддерживаемых источников и более глубокую интеграцию с различными хранилищами и брокерами сообщений;
- улучшение инструментов мониторинга и трассировки для сложных цепочек источников;
- усовершенствование тестирования гибридных цепей и автоматизированной валидации согласованности.
Эти направления будут способствовать ещё более широкому принятию гибридных источников в корпоративной архитектуре и позволят глубже интегрировать их в ML‑пайплайны и аналитические платформы.
Вопрос-Ответ:
-
Вопрос: Что такое гибридные источники в Flink и зачем они нужны?
Ответ: Гибридные источники объединяют несколько источников данных в одну последовательность чтения, позволяя обрабатывать исторические и потоковые данные в рамках одного потока. Это упрощает архитектуру, позволяет реализовать лямбда-архитектуру и обеспечивает управляемую согласованность состояний между источниками. -
Вопрос: Какие ключевые компоненты образуют гибридный источник?
Ответ: Основными компонентами являются Split (разделение данных), SplitEnumerator (генерация и распределение разделений) и SourceReader (чтение разделений). В гибридной конфигурации эти элементы работают вместе через HybridSourceBuilder и SourceFactory для формирования цепочки источников. -
Вопрос: Как осуществляется переключение между источниками?
Ответ: Переключение строится на передаче состояния между перечислителями и источниками через SourceFactory. Конечная позиция текущего источника становится начальной позицией следующего, обеспечивая непрерывность чтения и корректное время контекстов. -
Вопрос: Какие источники чаще всего комбинируют в HybridSource?
Ответ: Частые пары - файловые источники (HDFS/S3) для исторических данных и топики Kafka для потоковых данных. Также возможны объединения с использованием других систем баз данных и хранилищ. -
Вопрос: Какие ограничения существуют в Python API?
Ответ: Python API может не поддерживать полностью динамическое переключение и передачу позиций между источниками. Для полноты функциональности чаще применяется Java API. -
Вопрос: Какие метрики важны для оценки гибридного источника?
Ответ: Важны задержки чтения, пропускная способность, точность порядка чтения, целостность данных, устойчивость к сбоям и качество мониторинга состояния цепи источников. -
Вопрос: Какой подход выбрать для реализации в финансовом секторе?
Ответ: В финансовом секторе рекомендуется использовать гибридные источники для реализации лямбда-архитектуры, чтобы сочетать исторические данные с текущими рыночными изменениями, минимизируя задержки и обеспечивая согласованность данных. -
Вопрос: Какие практические риски следует учитывать?
Ответ: Основные риски - сложность реализации, риск потери данных при переключении, необходимость точного управления состоянием, влияние переключения на задержку и зависимость от стабильности внешних источников. -
Вопрос: Какие направления развития будут востребованы в будущем?
Ответ: Расширение поддержки Python, улучшение динамических переключений, увеличение числа поддерживаемых источников и более глубокая интеграция мониторинга и трассировки.
Эти вопросы охватывают ключевые тезисы статьи и позволяют быстро вспомнить основную логику гибридных источников в Flink, их архитектуру, реализацию и практическое применение в современных корпоративных сценариях.
Примечание: Все разделы статьи структурированы так, чтобы обеспечить последовательность идей - от общего к частному, от архитектуры к практике, с акцентом на технические детали и принципы проектирования. В тексте использованы ключевые термины и пояснение аббревиатур при первом упоминании. Статья нацелена на профессиональную аудиторию аналитиков, архитекторов, руководителей data-направлений и ИТ-директоров.