

SQL-on-Hadoop: сравнение функциональности и ограничений Hive, Impala, Spark SQL
SQL-подход к Hadoop-технологиям за последние годы стал основой аналитических рабочих нагрузок в дата-лакaх. Разные движки - Hive, Impala, Spark SQL - предлагают схожий интерфейс SQL, но различаются по архитектуре, стратегиям выполнения, поддержке функций и интеграциям в экосистему. Выбор подходящего решения требует не только оценки текущих требований к latency и объёму данных, но и понимания компромиссов между совместимостью диалекта, планированием выполнения и операционными рисками. В данной главе приведено систематическое сравнение функциональности и ограничений Hive, Impala и Spark SQL, с акцентом на архитектурные принципы, механизмы оптимизации и шаги миграции.
Краткое введение
SQL-on-Hadoop в первую очередь ориентирован на возможность выполнять аналитические запросы поверх больших массивов данных, хранящихся в HDFS или в стораджах, интегрированных через Metastore. Hive исторически позиционировался как пакетная система, где запросы конвертируются в задачи MapReduce или Tez; Impala - этоMPP-движок с целью интерактивного анализа; Spark SQL формирует другой подход через оптимизатор Catalyst и генерацию кода в Tungsten, что даёт выдающееся качество исполнения при сложных операциях. В реальных продуктивных кластерах часто присутствуют несколько движков для разных сценариев: Hive - для пакетной загрузки и ETL-пайплайнов, Impala - для быстрых ответов по BI-запросам, Spark SQL - для гибридной аналитики, переработки и сложной подготовки данных. Все они работают поверх общего набора форматов хранения и схем, но достигают целей различными путями: через разные планы выполнения, методы оптимизации и режимы исполнения.
- Архитектура и схемы интеграции задают стиль взаимодействия движков с данными, хранением метаданных и безопасностью.
- Диалекты SQL и совместимость определяют, насколько просто перенести существующие отчеты и запросы между движками.
- Оптимизация выполнения и планирование - ключ к удовлетворительной задержке и предсказуемости отклика.
- Интеграции и миграционные ограничения - важны для долгосрочной архитектуры и эффективности эксплуатации.
Архитектура и модели выполнения
Hive, Impala и Spark SQL имеют различную базовую архитектуру и подход к выполнению запросов. Различия проявляются в способах расчета планов, хранении метаданных, обработке данных и использовании памяти. В этом разделе раскрываются ключевые принципы каждой реализации и обобщаются последствия для производительности и эксплуатации.
Hive: от MapReduce/Tez к современным режимам выполнения
Исторически Hive переводил SQL в серии задач MapReduce. Позже появились фреймворки Tez и LLAP (Low Latency Analytical Processing), которые позволили снизить задержку и повысить пропускную способность. Основные элементы архитектуры:
- Metastore как единое хранилище схем и метаданных, доступное всем узлам выполнения.
- HiveServer2 обеспечивает соединение клиента и координацию выполнения запросов.
- Многообразие движков: MapReduce, Tez, а современных версий также поддержка Spark как внешнего процесса выполнения в рамках Hive-питающего слоя.
- Векторизованный движок (Vectorized Query Processing) и LLAP - ускорение за счет упаковки столбцов, SIMD-операций и кэширования hot-данных на узле.
Преимущества: простая интеграция в традиционные пайплайны, надёжная совместимость с форматом ORC/Parquet и знакомым SQL-диалектом HiveQL. Ограничения: задержки на уровне MapReduce могут быть неприемлемыми для интерактивной аналитики без Tez/LLAP; управление памяти и планирование может потребовать дополнительных настроек.
-- пример (уровень концепции) --
SELECT user_id, COUNT(*) FROM events WHERE event_date >= '2024-01-01' GROUP BY user_id;
Impala: MPP-движок для интерактивной аналитики
Impala выступает как самостоятельный MPP-движок с нативной архитектурой исполнения на уровне каждого узла. Основные элементы:
- Импалад/каталог-(Catalogd) и статустор (Statestored) обеспечивают метаданные и согласованность схем.
- Обособленные исполнительные узлы (impalad) обрабатывают фрагменты данных в памяти с минимальной задержкой.
- Поддержка Parquet и ORC, разделение по партициям с эффективной фильтрацией и предикат- пушдауном.
- Локальные планы выполнения с высокой степенью параллелизма, SIMD-ускорение и косвенная генерация кода, что способствует предсказуемому latency.
Преимущества: минимальная задержка, поддержка интерактивной аналитики, простые сценарии BI и «все в одном кластере». Ограничения: исторически меньше гибкости в некоторых сложных трансформациях и ограниченный набор функций, сравнительно с Spark SQL; сложные миграционные пути при переходе на фреймворки с более богатыми API.
-- пример (уровень концепции) --
SELECT user_id, SUM(amount) AS total FROM orders
WHERE order_date BETWEEN '2024-01-01' AND '2024-01-31'
GROUP BY user_id
ORDER BY total DESC
LIMIT 100;
Spark SQL: Catalyst, Tungsten и гибкость подготовки
Spark SQL строится на платформе Spark, которая применяет Catalyst - мощный оптимизатор на уровне правил, и Tungsten - ускорение выполнения через кодогенерацию и управление памятью. Основные элементы:
- Catalyst: набор правил преобразования логического плана в физический с возможностью расширения за счет пользовательских правил.
- Tungsten: фокус на эффективной работе с памятью и сборке исполнительного кода на лету для конкретного запроса.
- Поддержка широкого спектра API (SQL, DataFrame DSL), интеграция с источниками данных, каталогами и форматами.
- Встроенная поддержка кэширования, оптимизированного доступа к столбцам, гибкая настройка параллелизма и также поддержка ML-пайплайнов.
Преимущества: высокая гибкость, единая платформа для обработки и анализа, хорошая поддержка сложной аналитики, транзакций через внешний уровень в сочетании с источниками. Ограничения: может потребовать дополнительной настройки и мониторинга ресурсов, особенно в больших кластерах; некоторые диалекты не совпадают полностью с HiveQL и Impala SQL без адаптации.
-- пример (уровень концепции) --
EXPLAIN SELECT user_id, SUM(amount) FROM sales
WHERE region = 'EU' GROUP BY user_id;
Диалекты SQL и совместимость
Каждый движок предлагает собственную реализацию SQL-диалекта, поддерживая базовый стандарт SQL, но с особенностями по функциям, синтаксису и уровню совместимости. Важна не только поддержка синтаксиса, но и доступность функций, поведения агрегаций, оконных функций и типов данных. Это влияет на миграцию существующих запросов и рефакторинг BI-отчетов.
- HiveQL сохраняет традиционную совместимость с широким набором функций в рамках экосистемы Hive. Он поддерживает сложные типы данных (struct, array, map) и операции через UDF/UDAF, но иногда приходится учитывать различия в реализации оконных функций и специальных функций.
- Impala SQL фокусируется на конкурентоспособности интерактивной аналитики. В сравнении с Hive и Spark SQL, Impala часто предлагает более ограниченный набор некоторых оконных функций, но обеспечивает предикаты и агрегации в реальном времени с высокой эффективностью.
- Spark SQL обладает широкой функциональностью и высокой степенью расширяемости за счет Catalyst и пользовательских функций. Он поддерживает многие диалекты SQL, но не всегда идентично HiveQL или Impala SQL; миграция запросов может потребовать адаптации к различиям в оконных функциях, функции json/temp view и в поведении UDF.
Типовые различия, на которые стоит обратить внимание:
-
Поддержка оконных функций и подзапросов: в Spark SQL и Hive они достаточно мощные, у Impala они иногда требуют конкретной реализации или обходных путей.
-
Поддержка ACID и транзакций: Hive поддерживает ACID через ORC-формат и определённые настройки; Impala исторически ограничивал транзакции, Spark SQL - через внешние источники или специфические конфигурации, чаще ориентирован на консистентные чтения из внешних систем.
-
Типы данных и сложные структуры: все тройка поддерживает struct/array/map, но синтаксис и ограничение операций может различаться.
-
Подключения и UDF: каждая платформа имеет свой модельный подход к UDF/UDAF, совместимости и реестрам функций.
-
Современная стратегия миграции: миграция запросов между Hive, Impala и Spark SQL обычно требует адаптации к различиям в диалектах, а также в поведении планировщика и оптимизатора. В крупных проектах часто применяют конвертеры для подмножества запросов и тесты на консистентность результатов.
Таблица сравнения диалектов
| Характеристика | Hive (HiveQL) | Impala SQL | Spark SQL |
|---|---|---|---|
| Поддержка оконных функций | Да, но иногда с ограничениями в отдельных версиях | Частично, зависит от версии | Полная, через Catalyst |
| ACID/транзакции | Поддержка через ORC-ACID (определённые версии) | Ограниченная поддержка | Через внешние источники и транзакционные хранилища |
| Форматы хранения | ORC, Parquet, текст | Parquet, ORC | Parquet, ORC, JSON и др. через DataSource API |
| Поддержка UDF/UDAF | Да, обширная экосистема | Да, но ограничение по совместимости | Да, гибкая экосистема и внешние зависимости |
| Индексация и фильтрация | Фильтры, детализация по партициям | Эффективная фильтрация, разделы, предикат-пушдаун | Фильтрация с предикат-пушдауном, динамическая оптимизация |
| Архитектура исполнения | MapReduce/Tez/LLAP; векторизация | МPP-архитектура на узлах | Catalyst + Tungsten; единая платформа для вычислений |
| Миграционные сценарии | Хорошая совместимость в рамках экосистемы | Интенсивная интерактивная аналитика | Гибкие сценарии подготовки данных и аналитики |
Оптимизация выполнения и планирование
Эффективность запросов в каждой системе зависит от подхода к планированию, выбору стратегий выполнения и управлению ресурсами. Ниже рассмотрены ключевые моменты, которые влияют на производительность и предсказуемость latency.
Hive: Tez, Vectorization и LLAP как ответ на потребности производительности
- Tez как основной исполнительный движок позволяет устранять узкие места MapReduce и обеспечивает более графовую структуру выполнения.
- Векторизованный режим обработки данных ускоряет скалярные операции над столбцами, снижая CPU-скок и повышая коэффициент пропускной способности.
- LLAP (Low Latency Analytical Processing) позволяет держать данные ближе к вычислению и кэшировать часто используемые фрагменты, что существенно снижает latency для интерактивной аналитики.
- Применение partition pruning и predicate pushdown существенно улучшает сквозной проход по данным, особенно в больших таблицах.
Возможности и риски: Hive остаётся мощной платформой для пакетной обработки и ETL, но для интерактивной аналитики следует активировать Tez/LLAP и включить векторизацию. Непредсказуемость некоторых конфигураций/parquet/serde может потребовать тщательной настройки.
Impala: предсказуемость выполнения и устойчивость к задержкам
- Impala поддерживает высокую плотность параллелизма и оптимизацию на уровне планов выполнения, что даёт низкую задержку на объемных недиспергированных данных.
- Прекращение обращения к внешним системам, локальное планирование и выполнение на узле - основа интерактивной аналитики.
- Поддержка предикат-пушдауна, эффективной фильтрации и сортировки по партициям.
Риски и ограничения: сложность масштабирования и изменений в конфигурациях кластера может потребовать внимания к балансу ресурсов и мониторингу. В некоторых случаях функциональные ограничения по части функций и оконных операций требуют обходных путей или миграции к Spark SQL.
Spark SQL: глобальная оптимизация через Catalyst и Tungsten
- Catalyst предоставляет модульный и расширяемый конвейер оптимизации. Пользовательские правила и правила трансформации облегчают адаптацию под специфические сценарии.
- Tungsten обеспечивает эффективное использование памяти, генерацию кода и оптимизацию исполнения, что особенно критично на больших объемах данных.
- Whole-stage code generation, автоматическое выбор стратегий соединения (broadcast join, sort-merge) и кэширование улучшают латентность и производительность при повторяющихся запросах.
Риски: настройка ресурсов (executors, shuffle partitions) и мониторинг сборок - критично для стабильной производительности. В рамках больших BI-отчётов Spark SQL может потребовать оптимизаций в планировании и в настройке memory management.
-- пример (EXPLAIN-Plan в Spark SQL) --
EXPLAIN EXTENDED SELECT user_id, SUM(amount) AS total
FROM sales
WHERE region = 'EU'
GROUP BY user_id;
Интеграции и ограничения миграции
Эффективное внедрение SQL-on-Hadoop требует согласованности между движками и целевыми бизнес-процессами. Рассмотрим аспекты интеграции, совместимости и миграции.
-
Метаданные и управление схемами: общий Metastore упрощает совместное использование таблиц между Hive и Spark SQL; Impala имеет собственную модель Catalog, но поддерживает совместимость через общий набор форматов и файловых структур.
-
Форматы хранения и схемы: ORC и Parquet - общий стандарт для эффективной аналитики; JSON и прочие форматы требуют функций сериализации/десериализации и SERDE.
-
Безопасность и доступ: Kerberos, Ranger и Sentry обеспечивают доступ к данным и аудит; требования к единым политикам безопасности полезны для гибкой интеграции.
-
Совместимость наборов функций и UDF: каждая платформа имеет свою экосистему UDF/UDAF, возможно потребуется миграционный слой для критических функций.
-
Миграционные сценарии: переходы чаще всего реализуют поэтапно - миграция наборов запросов, переработка сложных оконных функций, тестирование консистентности результатов, переход к единым источникам данных и поддержка.
-
Интеграционная архитектура: для крупных компаний часто применяют общий Data Lake с несколькими движками, где каждый запрос направляется на оптимальный движок в зависимости от типа нагрузки и SLA.
-
Рекомендации по миграции: начинайте с анализа существующих запросов на совместимость; выделяйте «горячие» сценарии и конвертируйте их в Spark SQL для гибридной аналитики; используйте столбцовые форматы (Parquet/ORC) и современный Metastore; поэтапно расширяйте использование интерактивных движков (Impala, Spark) по мере стабилизации окружения.
Практические сценарии и миграционные дороги
- Интерактивная аналитика на больших датасетах: Impala или Spark SQL в связке с Parquet/ORC и с кэшированием результатов. Для ускорения latency применяют предикаты, динамические фильтры и локальные планировщики.
- Пакетная обработка и ETL: Hive с Tez или Spark SQL в режимах batch и streaming, обмен данными между слоями через общие таблицы и внешние источники.
- Гибридная аналитика и подготовка данных: Spark SQL как единая платформа для подготовки и аналитики, объединяющая полную логику бизнес-процессов и повторно используемые наборы правил.
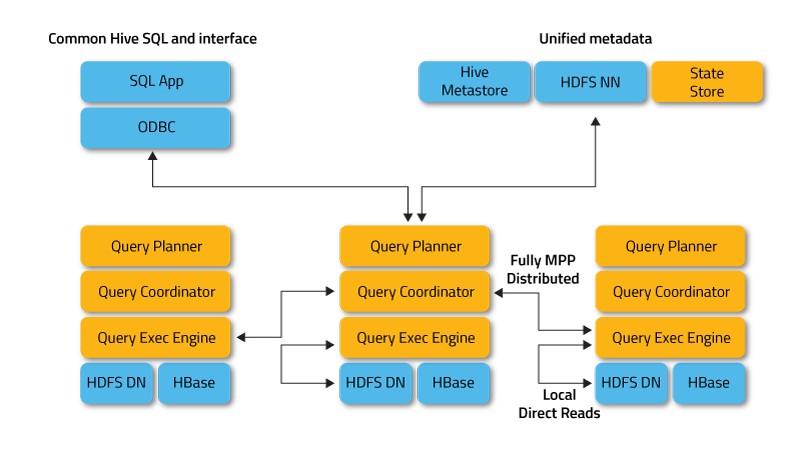
Сводная таблица: сравнительный профиль
- Архитектура: Hive - Tez/LLAP и vectorized execution; Impala - MPP-архитектура с локальным исполнением на узлах; Spark SQL - Catalyst/Tungsten.
- Диалекты: HiveQL, Impala SQL, Spark SQL** - различия в признаках SQL, оконных функций и некоторых функций.
- Время выполнения: Hive - пакетная/интенсивная ОС, Impala - интерактивная аналитика, Spark SQL - гибридная, с богатым набором оптимизаций.
- Совместимость форматов: ORC/Parquet, возможно JSON через внешние источники.
- Безопасность: общие принципы безопасности через Kerberos, Ranger/Sentry; реализация зависит от движка.
- Уровень поддержки UDF: значимый в каждом движке, с разной экосистемой.
- Выбор сценариев: Hive** - ETL и пакеты, Impala - интерактивная аналитика, Spark SQL - гибкая аналитика и подготовка данных.
Key takeaways
- Выбор между Hive, Impala и Spark SQL следует осуществлять на основе требований к latency, интерактивности и сложности аналитики.
- Архитектура каждого движка формирует ограничения и возможности: Hive - устойчив к изменениям экосистемы, но требует Tez/LLAP для интерактивности; Impala - быстрый интерактивный движок, ограниченная функциональность по сравнению с Spark; Spark SQL - гибкость и мощный оптимизатор, но потребность в настройке ресурсов.
- Диалекты SQL различаются; миграция запросов требует адаптации оконных функций, функций и синтаксиса. COMMON-CASE подход - мигрировать запросы по функциональности, сохраняя их исходную логику.
- Интеграции с хранением, безопасностью и управлением схемами критично влияют на эксплуатацию. Использование общего Metastore и совместимых форматов минимизирует трения.
- Оптимизация выполнения в Spark SQL через Catalyst и Tungsten обеспечивает лучшее предсказуемое исполнение для сложных операций, тогда как Hive/TezLLUAP позволят эффективную пакетную обработку и более простое управление.
- Для долгосрочной устойчивости целесообразна архитектура, сочетающая несколько движков: Hive для ETL-пайплайнов, Impala для интерактивной аналитики и Spark SQL для гибридной аналитики и подготовки.
- Мониторинг, настройка ресурсов и аудит безопасности являются критическими элементами, обеспечивающими стабильную работу в условиях больших нагрузок.
- Важно планировать миграцию с учётом бизнес-целей: определить «горячие» сценарии, определить требования к SLA и обеспечить совместимость форматов и метаданных.
FAQ
- Какие критерии выбора между Hive, Impala и Spark SQL для нового проекта аналитики?
- Ответ: Выбор зависит от требований к latency и объёму, сложности аналитики и доступности команд. Impala чаще подходит для интерактивной аналитики с низкой задержкой, Spark SQL - для гибридной аналитики и сложной подготовки данных, Hive - для пакетной обработки и ETL. В реальных проектах часто используют комбинацию, чтобы разделить задачи по типу нагрузки и SLA.
- Можно ли использовать все три движка на одном кластере?
- Ответ: Теоретически да, если инфраструктура поддерживает общий Metastore и совместимые форматы хранения. Практически это требует продуманной политики распределения задач, мониторинга ресурсов и согласованности версий. В таком сценарии следует избегать конфликтов конфигураций и обеспечить корректный маршрут запросов к нужному движку через управляющие слои.
- Какой механизм оптимизации в Spark SQL обеспечивает наилучшую производительность для сложных трансформаций?
- Ответ: Catalyst обеспечивает гибкую систему правил оптимизации, позволяет внедрять пользовательские правила и расширять план выполнения. В сочетании с Tungsten, который улучшает использование памяти и генерацию кода, Spark SQL может достигать высоких скоростей на больших объемах данных.
- Какие ограничения по поддержке ACID в Hive, Impala и Spark SQL?
- Ответ: Hive поддерживает ACID через ORC-формат в рамках определённых конфигураций и версий; Impala исторически был ограничен в поддержке транзакций и приближениях к ACID, хотя современные версии улучшают это. Spark SQL работает с транзакциями через внешние источники и специфические конфигурации; для критических операций целесообразно использовать внешние транзакционные хранилища.
- Какие форматы хранения данных предпочтительны для аналитических запросов?
- Ответ: Parquet и ORC** - стандарт Siemens Parquet и ORC обеспечивают эффективную колоночную выжимку, compression и ускорение чтения. Они поддерживают схемы и типы, а также фильтры и predicate-pushdown. В некоторых случаях JSON может быть эффективен для источников, но менее эффективен для аналитики без дополнительных трансформаций.
- Как обеспечить совместимость запросов при миграции между движками?
- Ответ: Начинайте с анализа существующих запросов и разделения по функциональности. Определите ключевые окна и функции, которые требуют адаптации. Постепенно конвертируйте наиболее «горячие» запросы, тестируйте консистентность результатов и внедряйте единый слой управления данными (Metastore, схемы, форматы).
- Какие риски связаны с миграцией больших BI-отчётов?
Риски включают различия в синтаксисе, несовпадение функций, задержки Plan/Execution и потенциальное изменение поведения оконных функций. Важно проводить параллельное тестирование и верификацию, а также плановую миграцию и rollback-планы.
- Какие лучшие практики для мониторинга производительности SQL-on-Hadoop?
- Ответ: Используйте централизованный мониторинг планов выполнения, задержек по SLA, статистики по памяти и shuffle, мониторинг использования кэша и FIT-логов. Включайте ведение метрик времени выполнения, задержки и ресурсоемкости.
- Каковы типовые миграционные паттерны между движками?
- Ответ: Миграционные паттерны включают конвертацию запросов по функциональности, миграцию на единый формат хранения, применение внешних источников и последующую оптимизацию планов, чтобы сохранить семантику и точность результатов.
- Какие сценарии интеграции с внешними системами являются наиболее распространёнными?
Интеграции с BI-инструментами через JDBC/ODBC, подключение к хранилищам данных (OLAP/OLTP) через коннекторы, использование Parquet/ORC как общего стандарта и совместимых Metastore-слоёв. Безопасность и аудит также требуется соблюдать с использованием Kerberos и политик доступа.


