

Инструменты подготовки данных: профилирование, очистка, трансформации, тестирование данных
Self-Service Analytics в Lakehouse требует не только доступности инструментов, но и выстроенной дисциплины подготовки данных. Эффективная подготовка служит мостом между источниками данных, семантическим слоем и бизнес-пользователями, позволяя последним работать с качественными активами в безопасной и управляемой среде. В этой главе рассмотрены практики профилирования данных, очистки и стандартизации, трансформаций, а также тестирования данных - с акцентом на архитектурные принципы, алгоритмы и интеграции, обеспечивающие воспроизводимость и доверие к данным в условиях самообслуживания.
Подготавливая данные для бизнес-пользователей в Lakehouse, важно помнить: цели подготовки - не только чистота и полнота, но и семантическая совместимость, согласованность с эталонными словарями и возможность аудита. При этом решения должны быть совместимы с подходами ELT, поддерживать lineage и соответствовать требованиям по управлению качеством и безопасностью. В рамках семантического слоя подготовка данных становится неотъемлемой частью контекста, в котором бизнес-пользователь воспринимает данные как понятные и измеримые единицы. В таком контуре профиль и качество данных приобретают не только научную, но и практическую ценность: они позволяют быстро строить доверие к аналитическим выводам и снижать риск ошибок в отчетности.
- Краткое содержание главы
- Ключевые концепции, целевые метрики и архитектурные принципы подготовки данных в Lakehouse
- Профилирование данных: цели, методы, алгоритмы и интеграция в процесс
- Очистка, нормализация и стандартизация данных: управление качеством и согласованностью
- Трансформации для self-service: подходы, инструменты и практика использования семантического слоя
- Тестирование данных: стратегии, типы тестов, данные контракты и мониторинг
Контекст и архитектура подготовки данных в Lakehouse
В современном Lakehouse каждое звено цепочки данных - источники, обработка, хранение, семантический слой и представления бизнес-пользователю - должно быть четко сопряжено между собой. Архитектура подготовки данных включает несколько слоёв:
- источник и интеґрационные конвейеры: данные поступают из разнообразных систем, включая оперативные базы, файловые хранилища и потоковые источники. Здесь ключевая задача - обеспечить единый входной формат и минимизировать вероятность потери контекста.
- слой качества и профилирования: на входе каждого конвейера стоит задача мониторинга полноты, корректности и актуальности данных. Это обеспечивает раннее выявление аномалий и управляемый риск.
- семантический слой: бизнес-термины, согласованные справочники и бизнес-правила маппирования к данным. Семантический слой требует согласованности между данными источника и ожидаемыми моделями представления для бизнес-пользователя.
- слой трансформаций и хранения: ELT-подход в Lakehouse позволяет преобразовывать данные именно там, где они хранятся, сохраняя оригинальные источники и создавая целевые виды (виртуальные или материализованные) для анализа.
- наблюдаемость, тестирование и контрактирование: механизмы тестирования, мониторинга качества и управления данными обеспечивают устойчивость к изменениям источников и позволяюют бизнесу доверяться информации.
В рамках этого контекста профилирование, очистка и трансформации должны projektно соединяться с методами управления данными и соответствовать общим требованиям по соблюдению конфиденциальности, безопасности и аудита. Архитектурные решения должны поддерживать динамическое добавление новых источников, расширение справочников и новых бизнес-правил без разрушения существующих наборов данных. Опора на стандартные протоколы обмена метаданными, версии схем и поддержку lineage обеспечивает прозрачность для аналитиков, инженеров и аудиторов.
Интеграция профилирования в процесс подготовки данных
Профилирование должно быть не отдельной операцией, а встроенным этапом жизненного цикла данных. Оно обеспечивает:
- набор метрик: полнота, корректность, консистентность, временная задержка, частотность обновления.
- детекцию дистрибутивных изменений и смены схем (schema drift).
- ранжирование рисков по каждому источнику и конвейеру.
- автоматическую генерацию правил предупреждений и уведомлений для ответственных лиц.
Инструменты профилирования должны работать как часть пайплайна и поддерживать автоматическое обновление метаданных в каталоге данных. Результаты профилирования должны быть доступны в семантическом слое, чтобы аналитики видели терминологию и бизнес-показатели в контексте качества.
Взаимодействие с семантическим слоем
Семантический слой использует метаданные профилирования для оценки пригодности источников к определенным аналитическим сценариям. Он может сигнализировать об ограничениях по данным, например, когда определенная мера зависит от пропусков или несоответствия форматов. Такой механизм позволяет бизнес-пользователям понять риск на уровне бизнес-показателя и корректировать запросы или параметры анализа.
Набор и стандарты интеграций
Для успешной реализации подобной архитектуры целесообразно зафиксировать:
- единый подход к именованию источников, версий схем и правил преобразования;
- поддержку lineage и обратной трассируемости (кто поменял что и когда);
- возможность синхронизации с каталогами данных и словарями бизнес-терминов;
- минимизацию дублирования кода через повторно используемые трансформации и шаблоны профилирования.
Профилирование данных: цели, метрики, методы
Профилирование данных - это совокупность методик по количественной оценке свойств данных и выявлению аномалий. В контексте Lakehouse и self-service analytics его задача - дать понятную картину качества и надёжности данных, на которой строится последующая очистка и трансформации. В рамках этой главы развернуто рассмотрены концепции, алгоритмы и практики, которые позволяют систематизировать профилирование и сделать его доступным для бизнес-пользователей через семантический слой.
-
Принципы профилирования
- Полнота и полнота сегментов: оценки по колонкам и по поднаборам данных, оценка доли пропусков, нулевых значений и отклонений.
- Точность и консистентность: проверка соответствия значений справочным словарям, валидности доменов и единиц измерения.
- Временная актуальность: задержки обновления, частота событий и периодичность сверки с эталонами.
- Дистрибутивность и корреляции: распределение значений, гистограммы, корреляции между полями, зависимые пары.
- Контроль на дрейф схем и данных: отслеживание изменений форматов, типов, добавления или удаления столбцов.
-
Метрики и показатели профилирования
- Картина полноты: процент непустых значений по каждому столбцу, пропусков по строкам и по группам.
- Валидность доменов: доля значений, соответствующих допустимым диапазонам и спискам.
- Нормативность форматов: соответствие объекта даты, времени, валюты локальным правилам.
- Стабильность распределения: сравнение текущих распределений с эталонными и выявление дрейфа.
- Доверие к данным: вероятность соответствия ключевых полей константам и индексам.
-
Методы и алгоритмы
- Статистический профилинг: создание гистограмм, расчет медианы, среднего, моды, дисперсии по столбцам.
- Пропусковость и чистота: подсчет пропусков, уникальность значений, проверки уникальных ключей.
- Взаимозависимости и корреляции: корреляционный анализ, зависимость между признаками, устойчивость к изменениям источников.
- Drift detection: алгоритмы сравнения распределений между периодами или источниками с использованием тестов на дрейф (например, простые статистические тесты на различие распределений).
- Аномалия и мониторинг: ML-опоры для обнаружения отклонений, сигналы тревоги и автоматическое уведомление.
-
Применение и внедрение
- Интеграция с каталогами метаданных и словарями: автоматическое обогащение профилей новой информацией и связь с бизнес-терминами.
- Уровни доступа и приватность: определение ситуаций, когда profiling данные должны быть скрыты для отдельных ролей.
- Автоматизация повторного профилирования: расписания, триггеры и регламент обновления метрик при изменении источников.
- Взаимодействие с семантикой: отображение результатов профилирования в терминах, понятных бизнес-пользователю (например, "пополняемость записи платежа", "вероятность отсутствия соответствия коду товара").
-
Пример: простой SQL-запрос профилирования
SELECT
  column_name,
## COUNT(*) AS total_rows,
  SUM(CASE WHEN column_value IS NULL THEN 1 ELSE 0 END) AS nulls,
  AVG(CASE WHEN column_value IS NULL THEN 1.0 ELSE 0 END) AS null_fraction
FROM
  analytics_schema.table_sample
GROUP BY
  column_name;
Приведенный пример иллюстрирует базовый подход к оценке пропусков на уровне столбца. На практике такие проверки дополняются более комплексными метриками и интегрируются в инструменты observability, что обеспечивает непрерывное наблюдение за качеством.
Алгоритмические и архитектурные особенности
- Центрирование на данных и индустриальных эталонах: профилирование должно опираться на единые справочники и политики качества, чтобы результаты были сопоставимы между источниками и конвейерами.
- Разделение ролей и доступ к метаданным: в нормальной архитектуре специалисты по данным работают с детальными профилями, в то время как бизнес-пользователи видят агрегированные и безопасно согласованные результаты.
- Вариативность источников: поддержка гибкой логики профилирования под разные типы источников (strukturированные БД, файлы, потоки) и масштабируемость в рамках Lakehouse.
Очистка данных и стандартизация: управление качеством и согласованностью
Очистка данных - это систематическая коррекция и приведение данных к единому формату, чтобы обеспечить сопоставимость и повторяемость анализов. В контексте Lakehouse и семантического слоя очистка должна быть не только техническим шагом, но и частью политики управления данными, где правила согласованы с бизнес-терминами и требованиями аналитического контекста.
-
Основные задачи очистки
- устранение дубликатов и конфликтов идентификаторов: обнаружение повторяющихся записей, слияние или выбор наиболее надежного источника.
- обработка пропусков и ошибок: заполнение пропусков корректными значениями, использование правил импутации, фиксация причин пропусков.
- нормализация и стандартизация форматов: приведение дат, единиц измерения, кодов стран к единым представлениям.
- привязка к справочникам и валидация доменов: контроль соответствия значений словарям, чтобы обеспечить семантическую совместимость.
-
Практики очистки в рамках архитектуры Lakehouse
- Idempotentные процедуры: повторные запуски очистки не приводят к изменению результата, что важно для повторяемости в самообслуживании.
- Разделение этапов: разделение фаз очистки на «фильтрацию пропусков», «выбор корректных значений», «переименование и нормализация» - это облегчает отладку и аудит.
- Встроенная в семантику валидность: правила должны быть тесно связаны с бизнес-терминами и принятыми контрактами данных.
- Контроль конфликтов и ревизий: хранение версий очищенных наборов данных и возможность отката к предыдущим состояниям.
-
Инструменты и подходы
- dbt как основа трансформаций и частично очистки: позволяет описывать правила в едином контексте вместе с семантикой и тестами.
- Об observability слои и мониторинг дефектов: системная регистрация ошибок очистки, уведомления ответственным лицам и визуализация трендов качества.
- Управление качеством через data contracts: определение минимального набора атрибутов, требований к валидности и ответственных за соблюдение.
-
Пример модели очистки
- Удаление дубликатов с сохранением валидной записи по определенным ключам.
- Приведение форматов телефонных номеров к единому стилю.
- Замена некорректных кодов товаров на значения из справочника и сохранение журналов соответствия.
Нормализация и согласованность в контексте семантики
Нормализация форматов и соответствие справочникам необходимы для того, чтобы бизнес-пользователь, видящий терминологию из семантического слоя, мог сопоставлять данные без дополнительных преобразований. В рамках этого процесса иногда применяется концепция “контракты данных” - договор между источниками данных и потребителями, который фиксирует ожидаемые форматы, частоту обновления и требования к валидности.
-
Принципы сокращения фрагментации данных
- единый словарь бизнес-терминов и связанных категоризаций;
- согласование правил обработки по регионам и доменам;
- поддержка версий справочников и автоматическая миграция без потери совместимости.
-
Безопасность и приватность в очистке
- маскирование чувствительных данных на уровне обработки;
- ограничение доступа к детализированной очистке для непредназначенных пользователей;
- аудит изменений и хранение журналов трансформаций для воспроизводимости.
Трансформации данных: подходы для self-service
Трансформации в Lakehouse реализуются через ELT-подход: данные сначала загружаются в хранилище в формате, близком к исходному, затем применяется набор преобразований, трансформирующих их в целевые представления для анализа. В контексте Self-Service Analytics и семантического слоя трансформации играют роль клея между исходными данными и понятной бизнес-интерпретацией.
-
Что следует учитывать при трансформациях
- идемпотентность и повторяемость: преобразование должно давать одинаковый результат при повторном выполнении.
- прозрачность lineage: каждое преобразование должно быть трассируемым и документируемым.
- поддержка семантики: названия столбцов, бизнес-термины и агрегаты должны точно отражать понятия семантического слоя.
- управление зависимостями: четко зафиксированные последовательности преобразований и зависимостей между наборами данных.
-
Архитектура и инструменты
- dbt в качестве orchestration и трансформационного слоя: позволяет описать трансформации в коде и автоматически сгенерировать зависимые артефакты и lineage.
- Spark SQL и Delta Lake для масштабных трансформаций: позволяют обрабатывать большие объемы данных с поддержкой версионности и времени.
- материализованные и виртуальные представления: выбор между ними зависит от требований к задержке, обновлениям и бюджетам на хранение.
-
Практические рекомендации
- проектирование трансформаций в рамках контрактов данных: чётко оговоренные входы, выходы, типы ошибок и ожидаемая точность.
- использование модульности: разделение сложных трансформаций на небольшие переиспользуемые блоки, которые легче тестировать и комбинировать.
- сохранение уровня абстракции: бизнес-пользователи должны видеть готовые бизнес-метрики и понятные наборы данных, а не технические детали преобразований.
- обеспечение совместимости с семантическим слоем: именование столбцов и структур данных должны соответствовать бизнес-терминам.
-
Пример концептуального пайплайна трансформаций
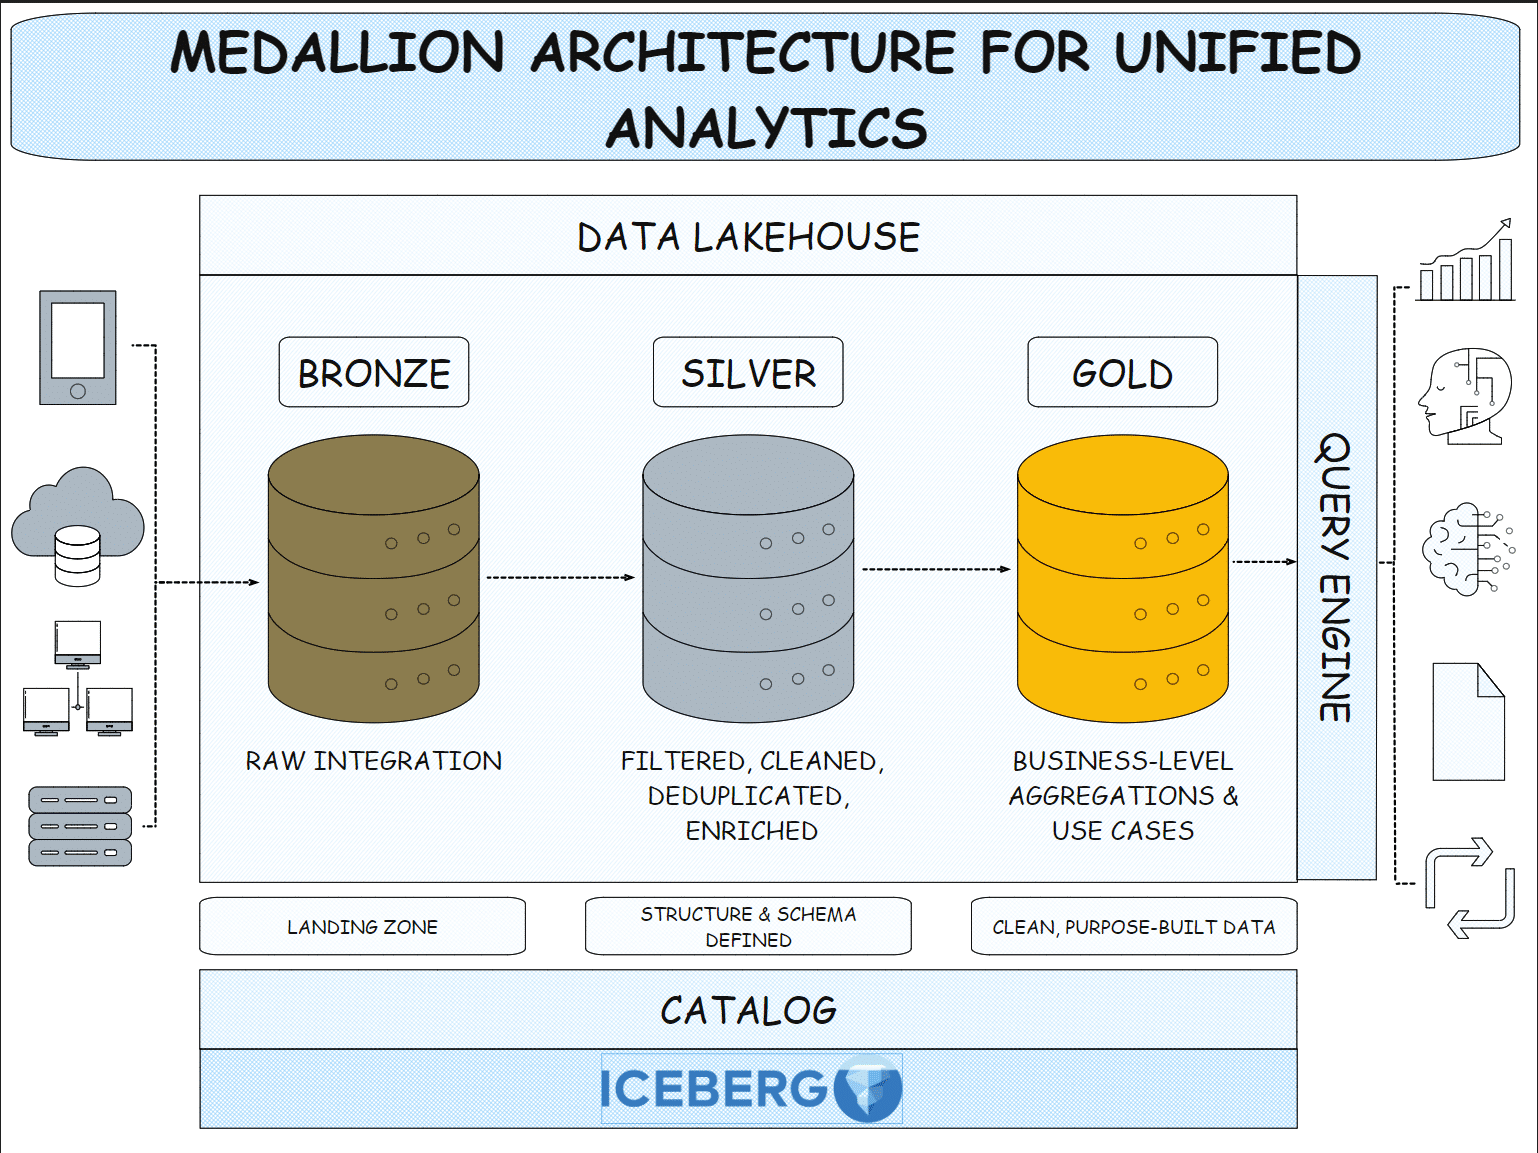
- этап загрузки: загрузка сырых данных из источников в систему хранения Lakehouse;
- этап чистки и нормализации: применяются правила очистки и нормализации;
- этап агрегаций: вычисление необходимых агрегатов и метрик в контексте бизнес-словаря;
- этап публикации: создание представлений, соответствующих семантическому слою, и материаловизация, где это необходимо.
-
Важный аспект: управление ветвлениями и версиями
- трансформации должны поддерживать версионность, чтобы можно было вернуться к предыдущим состояниям набора данных и анализа.
- контроль изменений в схемах и зависимостях, чтобы пользователи не попадали под неожиданные изменения в представлениях.
Тестирование данных: стратегии, типы тестов и мониторинг
Тестирование данных - критически важный элемент доверия к данным, особенно когда бизнес-пользователи работают через самообслуживание. Тесты должны быть не просто техническими проверками, но инструментами, которые позволяют оперативно оценивать качество информации и своевременно реагировать на изменения требований и источников.
-
Категории тестов
- структура и валидность схемы: типы столбцов, ограничения, уникальность ключей.
- целостность и согласованность данных: внешние ключи, связь между таблицами, соответствие словарям и бизнес-терминам.
- бизнес-правила и валидность контента: диапазоны значений, допустимые наборы категорий, соответствие пороговым значениям.
- полнота и доверие к данным: доля пропусков по ключевым измерениям, вероятность несоответствий между связанными наборами данных.
- дрейф и устойчивость: мониторинг изменений распределений и значений по времени.
-
Инструменты и подходы
- тестирование как часть разработки трансформаций: внедрение «test-driven data engineering» для описания требований к данным перед их созданием.
- dbt и Great Expectations как примеры инструментов тестирования данных: dbt фокусируется на структуре и тестах моделей, Great Expectations - на тестах содержания и поведения данных.
- тестовые данные и контракты: создание управляемых наборов тестовых данных, которые служат контрактами между источниками и потребителями.
- интеграция с семантическим слоем и мониторинг: визуализация результатов тестирования в контексте бизнес-терминов и сигналы тревоги при несоответствиях.
-
Процесс тестирования
- планирование тестов: определение критичных для бизнеса сценариев и ключевых метрик качества.
- автоматизация: настройка CI/CD процессов для тестирования данных при изменении пайплайнов и источников.
- исполнение тестов: регулярный прогон тестов, уведомления и регламент реагирования на дефекты.
- эскалация и исправления: определение ответственных лиц и процесс исправления для минимизации времени простоя аналитических сценариев.
-
Блоки тестирования и примеры
- валидность схемы: тесты на наличие необходимых столбцов, типов и ограничений.
- контентные тесты: проверка диапазонов значений, отсутствия некорректных кодов, валидности дат.
- тесты на согласованность: проверки связей между фактами и измерениями, соответствие справочникам.
- тесты на дрейф: сравнение текущих распределений с эталонными и сигналы изменений.
- тесты на производительность: лимиты времени выполнения запросов, задержки обновления и потребления ресурсов.
-
Пример теста
- Тест на полноту и проектный диапазон: проверка того, что каждый заказ имеет валидную дату и идентификатор клиента, и что цена находится в разумном диапазоне для соответствующей валюты.
- Тест на соответствие справочнику: каждый код товара должен присутствовать в каталоге товаров.
-
Мониторинг качества
- непрерывный мониторинг и алерты: автоматические уведомления ответственным лицам при отклонениях.
- визуализация трендов: графики дрейфа, отклонения по времени, показатели полноты и валидности.
- эскалация и регламент исправления: процессы реагирования на инциденты и их документирование.
Инструменты и интеграции: выбор путей и практик внедрения
В частности в контексте Lakehouse и семантического слоя важно выбрать набор инструментов, который обеспечивает баланс между функциональностью и сложностью внедрения. Ряд практик можно применить в рамках существующей экосистемы, сочетая open-source и платные решения, чтобы обеспечить воспроизводимость и прозрачность.
-
Примеры инструментов и их роль
- dbt: фокус на трансформациях, тестировании и управлении зависимостями. Он хорошо сочетается с семантическим слоем и дает прозрачную lineage.
- Great Expectations: ориентирован на тестирование содержания данных, контрактов и поведенческих ожиданий. Хороший дополнение к dbt для обеспечения качественного мониторинга.
- Delta Lake или Apache Iceberg: обеспечивают версионность, ACID-совместимость и управляемость схем в рамках Lakehouse, что критично для повторяемости пайплайнов.
- Инструменты мониторинга и observability: позволяют визуализировать показатели качества и дрейфа, интегрируются с системами оповещений и бизнес-аналитикой.
-
Принципы интеграции
- минимизация сложностей: выбор ограниченного набора инструментов, который покрывает потребности профилирования, очистки, трансформаций и тестирования.
- совместимость с семантическим слоем: на входе и выходе должны присутствовать понятные бизнес-термины и единый словарь.
- однозначная ответственность: четкое разделение ролей между командами данных, аналитиками и ИТ.
- безопасная экосистема: контроль доступа к данным, поддержка конфиденциальности и аудита на каждом этапе подготовки.
Key takeaways
- Подготовка данных для Self-Service Analytics в Lakehouse требует тесной интеграции профилирования, очистки, трансформаций и тестирования в единую архитектуру, поддерживающую семантический слой.
- Эффективное профилирование обеспечивает раннее обнаружение дефектов, дрейфа и риск-ориентированное управление качеством, что критично для доверия бизнес-пользователей.
- Очистка должна быть идемпотентной, хорошо документированной и связанной с бизнес-правилами и справочниками, чтобы обеспечить единый язык анализа.
- Трансформации должны быть модульными, воспроизводимыми и тесно связанными с семантикой: бизнес-термины и контракты данных должны встраиваться в процесс трансформаций.
- Тестирование данных - не просто техническая проверка, а управляемый процесс, обеспечивающий контрактами и мониторинг качества, интегрированный с CI/CD и семантикой.
- Инструменты вроде dbt и Great Expectations облегчают разработку, прозрачность и повторяемость, если они применяются в связке с Delta Lake/Iceberg и системой мониторинга.
- Важно сохранить баланс между гибкостью самообслуживания и необходимостью контроля качества и соблюдения политики данных, чтобы бизнес-пользователи имели доступ к качественным данным без угрозы рисков и нарушения регуляторных требований.
FAQ
- Что такое профилирование данных и зачем оно необходимо в Lakehouse?
Профилирование данных - это систематический процесс измерения и описания свойств данных: полноты, корректности, согласованности и др. В Lakehouse это позволяет быстро выявлять проблемы на входе пайплайна, оценивать риск дрейфа схем и обеспечивать прозрачность данных для бизнес-пользователей через семантический слой. Без профилирования сложно оценить надежность аналитических выводов и своевременно реагировать на изменения источников.
- Как сочетать очистку данных с бизнес-терминами в семантическом слое?
Очистка должна опираться на бизнес-правила и справочники. Это значит, что правила очистки, параметры и итоговые наборы данных должны быть отражены в контрактax между источниками и потребителями и отображаться в семантическом слое под бизнес-терминами. Так бизнес-пользователь видит понятные поля и понятные правила, а техничная реализация остается адаптивной и управляемой.
- Какие преимущества дает ELT-подход в трансформациях по сравнению с традиционным ETL?
ELT позволяет выполнять большинство преобразований на уровне слоя хранения, что сохраняет исходные данные и упрощает отслеживание зависимостей, версионность и повторное использование трансформаций. Это особенно важно для self-service, где аналитики требуют гибкости и прозрачности. ELT также облегчает интеграцию с семантическим слоем и снижает риск устаревших копий данных.
- Какие инструменты предпочтительнее для поддержки тестирования данных в контексте семантики?
Dbt обеспечивает структурированное описание трансформаций и тестов, а Great Expectations расширяет набор тестов за счет контрактов и содержимого. В сочетании они позволяют не только проверять схему, но и валидность контента и поведение данных в бизнес-контексте. Важна поддержка интеграции с существующим каталогом и семантическим слоем.
- Как обеспечить повторяемость и воспроизводимость пайплайнов подготовки данных?
Необходимо вести версионность схем, изменений трансформаций и правил очистки, фиксировать зависимости между источниками и целями через lineage, а также хранить артефакты качества и тестов. Автоматизация CI/CD, тестирование и мониторинг качества помогают поддерживать воспроизводимость и снижать риски, связанные с обновлениями источников.
- Что делать при дрейфе данных и изменении источников?
Включите drift-detection в профилирование, настройте автоматические уведомления и внедрите контракты данных, чтобы потребители могли понять влияние дрейфа. В ответ на дрейф следует обновлять словари и правила трансформаций, а также пересматривать сигналы в семантическом слое, чтобы сохранить согласованность бизнес-терминов.
- Как обеспечить безопасность и приватность в рамках подготовки данных для бизнес-пользователей?
Разделяйте роли доступа к данным на уровне пайплайнов и представлений, применяйте маскирование и агрегацию там, где требуется, и храните журналы изменений и трансформаций для аудита. Важна интеграция с политиками конфиденциальности и соответствие регуляторным требованиям, особенно при обработке персональных данных.
- Какие архитектурные принципы важны для поддержки самообслуживания?
Необходимо обеспечить прозрачность и доступность метаданных, корректную поддержку версионности, четкое разделение ответственности между командами данных и бизнес-пользователями, а также устойчивые конвейеры, которые легко адаптировать к новым источникам и требованиям.
- Как выбрать инструменты для подготовки данных в рамке Lakehouse?
Выбор инструментов должен основываться на совместимости с существующей архитектурой, поддержке версионности и lineage, возможности интеграции с семантическим слоем и бизнес-терминологией. Рекомендуются сочетания, которые поддерживают трансформации, тестирование и мониторинг в единой экосистеме или хорошо интегрируются между собой.
- Какие практики ускоряют внедрение подготовки данных в организациях?
Сфокусируйтесь на создании контрактов данных, модульности трансформаций, внедрении тестирования и мониторинга на ранних этапах, а также на обучении бизнес-пользователей работе с семантическим слоем. Важной частью является развитие культуры совместной ответственности за качество данных и создание устойчивой родовой структуры управления данными.
Глава представлена как целостная методическая единица, объединяющая теоретические основы и практическую реализацию в рамках Self-Service Analytics в Lakehouse. Задумка состоит в том, чтобы построить прозрачную и управляемую цепочку подготовки данных, где профилирование, очистка, трансформации и тестирование работают как единое целое, поддерживая семантический слой и доступ бизнес-пользователям без снижения качества и доверия к данным.


