

Моделирование данных для DW: схемы звездной и снежинки
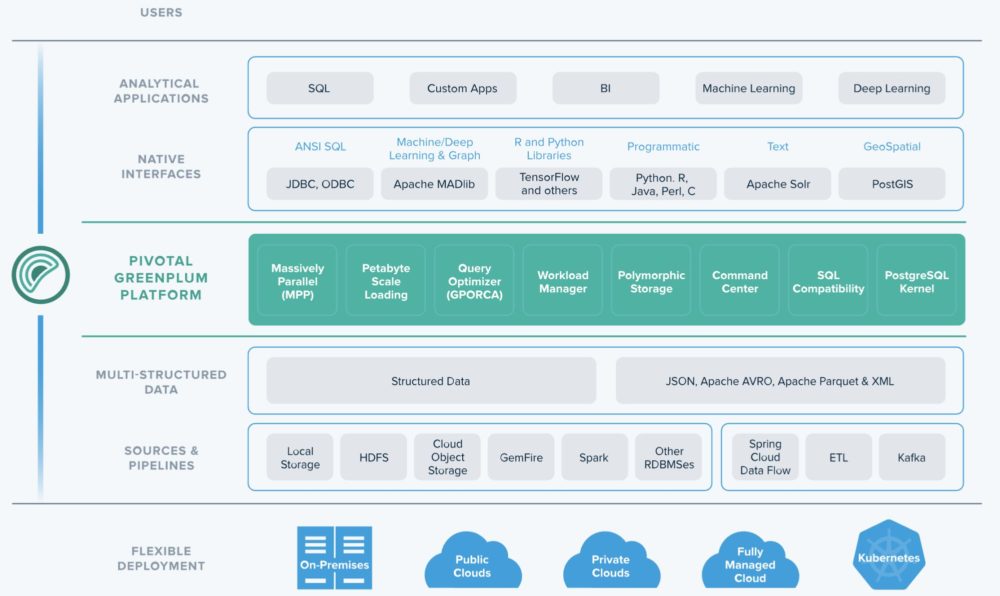
В современных аналитических проектах выбор правильной модели данных для хранилища (DW) существенно влияет на скорость ответа на запросы, упрощение поддержки и масштабируемость. В этой главе мы подробно рассмотрим две базовых концепции моделирования данных в DW: схему звездной (star schema) и схему снежинки (snowflake schema). Мы опишем, в чем они отличаются, какие преимущества и ограничения несут, какие задачи они решают в контексте внедрения хранилища данных на базе Greenplum — мощной MPP-архитектуры на основе PostgreSQL. Материал рассчитан как на новичков, так и на опытных специалистов, которые готовят инфраструктуру под BI-слой и аналитические сервисы.
Мы будем опираться на следующие базовые идеи:
- Фактовые таблицы содержат числа, агрегаты и меры бизнес-логики (объем продаж, количество заказов и т. п.), в то время как размерные таблицы содержат атрибуты, по которым эти факторы анализируются (время, клиент, товар, канал продаж и т. п.).
- В звездной схеме измерения денормализованы для ускорения выполнения запросов и минимизации количества JOIN-операций в типичных аналитических запросах.
- В снежинке часть размерных таблиц нормализована, чтобы снизить дублирование данных и сохранить консистентность атрибутов. Это помогает при большем разнообразии атрибутов, но увеличивает количество JOIN-операций.
- Greenplum как платформа DW предъявляет особые требования к распределению данных (DISTRIBUTED BY), партиционированию и планированию запросов, чтобы максимизировать параллелизм и локализацию JOIN-операций.
Основные понятия и термины
- Факт-таблица (fact table) — центральная таблица в DW, которая содержит измеряемые факторы бизнеса и данные по событию или транзакции (например, продажи: сумма, количество товаров, скидка).
- Размерная таблица (dimension table) — таблица с атрибутами, помогающими описать факты (например, время, клиент, товар, магазин).
- Ключ суррогатный (surrogate key) — искусственный идентификатор записи в размерной таблице, обычно числовой (INTEGER, BIGINT). Он заменяет натуральный ключ источника и обеспечивает независимость от изменений в внешних источниках.
- Натуральный ключ (natural key) — набор атрибутов, который однозначно идентифицирует запись во внешнем источнике. Часто используется на этапе загрузки и в ETL-слое, но внутри DW чаще заменяется суррогат-ключом.
- Гранулярность (grain) — уровень детализации фактов в DW. Определяется при проектировании: что считается одной строкой в факт-таблице (например, продажа за одну транзакцию).
- Согласованные измерения (conformed dimensions) — размерные таблицы, которые разделяются между несколькими фактами и подразделениями аналитики и обеспечивают единообразие атрибутов.
-
Slowly Changing Dimensions (SCD) — способы обработки изменений в размерных данных без потери истории. Типы:
- Type 1: прямое переписывание атрибута (история не сохраняется);
- Type 2: добавление новой версии записи с временными границами (история сохраняется);
- Type 3: добавление нового атрибута/колонки для фиксации предшествующей версии.
- Degenerate dimensions — измерения, которые выглядят как атрибуты факта и могут быть вынесены в отдельную колонку фактов (например, номер заказа).
- Junk dimensions — совокупность мелких атрибутов, который удобно объединить в одну размерную таблицу-домок, чтобы не распылить фактов по множеству мелких таблиц.
- Star schema (звездная схема) — фактовая таблица окружена несколькими размерными таблицами; размерные таблицы денормализованы и обычно содержат суррогатные ключи. Модель упрощает чтение запросов и обеспечивает быстрый доступ к агрегированным данным.
- Snowflake schema (снежинка) — размерные таблицы нормализованы в дополнительные подтаблицы (например, продукт → категория → подкатегория), что уменьшает дублирование данных, но увеличивает сложность JOIN-цепочек.
- ETL/ELT — процессы загрузки данных в DW. ETL предполагает преобразование данных до загрузки в DW; ELT — преобразование выполняется внутри DW после загрузки. Greenplum поддерживает как традиционные ETL-пайплайны, так и ELT-подходы через мощность вычислительных узлов.
Сравнение схем: звездная против снежинки
Преимущества звездной схемы:
- Ускоренные аналитические запросы за счет меньшего числа JOIN-операций.
- Простой, понятный дизайн, легкость поддержки и документирования.
- Хорошая производительность при агрегациях по нескольким измерениям.
Преимущества снежинки:
- Меньшее дублирование данных и экономия пространства.
- Лучшая нормализация упрощает обновления и поддержание целостности данных в отдельных измерениях.
Риски и ограничения:
- Звезда: возможное дублирование атрибутов в размере и риск нестыковок при обновлениях; ограниченная гибкость по изменениям в атрибутах.
- Снежинка: больше JOIN-операций, что может ухудшить производительность на больших объемах без надлежащей настройки на уровне распределения и партиционирования.
Модели в контексте Greenplum
Greenplum — это MPP-решение на базе PostgreSQL. Для эффективной реализации схем DW важно учитывать:
- Распределение данных (DISTRIBUTED BY): выбор ключа распределения критически влияет на локализацию join-операций и балансировку нагрузки между сегментами.
- Партиционирование: таблицы могут быть разделены по диапазону, списку или по хэшу; позволяет ускорить большинство аналитических запросов, особенно на временных интервалах.
- Закритическое проектирование индексов в GP: традиционное индексирование в GP менее полезно по сравнению с грамотной дистрибуцией и партиционированием; фактические ускорители — материализованные представления, агрегации на уровне сервера, правильная статистика.
- Ограничения целостности: Greenplum поддерживает внешние и временные ограничения, но некоторые ограничения не проверяются в момент выполнения (для производительности), поэтому данные целесообразно валидировать на ETL-слое.
Практические примеры
Ниже приведены простые, но реалистичные DDL и SQL-запросы для реализации звездной и снежинки в Greenplum. Примеры ориентированы на классическую предметную область продаж: дата, клиент, продукт, магазин и факт продаж.
1) Звездная схема (Star Schema)
- Размеры (dimension tables) — денормализованные.
- Факт (fact table) — центральный факт продаж.
Пример DDL (SQL):
-- Размерная таблица: дата
CREATE TABLE dim_date (
    date_sk BIGINT PRIMARY KEY,
    full_date DATE NOT NULL,
    year INT,
    quarter INT,
    month INT,
    day INT
) DISTRIBUTED BY (date_sk);

-- Размерная таблица: клиент
CREATE TABLE dim_customer (
    customer_sk BIGINT PRIMARY KEY,
    customer_id VARCHAR(50) NOT NULL UNIQUE,
    first_name VARCHAR(100),
    last_name VARCHAR(100),
    gender CHAR(1),
    country VARCHAR(50),
    segment VARCHAR(50)
) DISTRIBUTED BY (customer_sk);

-- Размерная таблица: товар
CREATE TABLE dim_product (
    product_sk BIGINT PRIMARY KEY,
    product_id VARCHAR(50) NOT NULL UNIQUE,
    product_name VARCHAR(255),
    brand VARCHAR(100),
    category VARCHAR(100),
    color VARCHAR(50),
    size VARCHAR(50),
    list_price NUMERIC(12,2)
) DISTRIBUTED BY (product_sk);

-- Размерная таблица: магазин
CREATE TABLE dim_store (
    store_sk BIGINT PRIMARY KEY,
    store_id VARCHAR(50) NOT NULL UNIQUE,
    store_name VARCHAR(200),
    region VARCHAR(100),
    city VARCHAR(100)
) DISTRIBUTED BY (store_sk);

-- Факт: продажи
CREATE TABLE fact_sales (
    sale_id BIGINT PRIMARY KEY,
    date_sk BIGINT REFERENCES dim_date(date_sk),
    customer_sk BIGINT REFERENCES dim_customer(customer_sk),
    product_sk BIGINT REFERENCES dim_product(product_sk),
    store_sk BIGINT REFERENCES dim_store(store_sk),
    quantity INT,
    revenue NUMERIC(14,2),
    discount NUMERIC(14,2),
    tax NUMERIC(14,2)
) DISTRIBUTED BY (date_sk, store_sk, product_sk);
Пример заполнения (упрощенный; данные может поставлять ETL-процесс):
INSERT INTO dim_date (date_sk, full_date, year, quarter, month, day)
VALUES (20240101, DATE '2024-01-01', 2024, 1, 1, 1);

INSERT INTO dim_customer (customer_sk, customer_id, first_name, last_name, gender, country, segment)
VALUES (1, 'CUST-001', 'Иван', 'Иванов', 'M', 'Россия', 'Retail');

INSERT INTO dim_product (product_sk, product_id, product_name, brand, category, color, size, list_price)
VALUES (1, 'P-1001', 'Смартфон X', 'TechBrand', 'Электроника', 'черный', '100GB', 299.99);

INSERT INTO dim_store (store_sk, store_id, store_name, region, city)
VALUES (1, 'S-0001', 'Москва-Центр', 'Центральный федеральный округ', 'Москва');

INSERT INTO fact_sales (sale_id, date_sk, customer_sk, product_sk, store_sk, quantity, revenue, discount, tax)
VALUES (1, 20240101, 1, 1, 1, 2, 599.98, 0.0, 0.0);
Practical аналитический запрос (пример агрегирования по времени и региону):
SELECT d.year, d.month, s.region, SUM(f.revenue) AS total_revenue, SUM(f.quantity) AS total_quantity
FROM fact_sales f
JOIN dim_date d ON f.date_sk = d.date_sk
JOIN dim_store s ON f.store_sk = s.store_sk
GROUP BY d.year, d.month, s.region
ORDER BY d.year, d.month, s.region;
2) Снежинка (Snowflake Schema)
Разделяем размерные таблицы на подтаблицы: например, продукт делится на категорию и подкатегорию; даты — на календарь и календарные атрибуты.
Пример DDL (часть снежинки):
-- Измененная размерная таблица: продукт
CREATE TABLE dim_product (
    product_sk BIGINT PRIMARY KEY,
    product_id VARCHAR(50) NOT NULL UNIQUE,
    product_name VARCHAR(255),
    brand VARCHAR(100),
    subcategory_sk BIGINT,
    price NUMERIC(12,2)
) DISTRIBUTED BY (product_sk);

CREATE TABLE dim_product_subcategory (
    subcategory_sk BIGINT PRIMARY KEY,
    subcategory_name VARCHAR(100),
    category_sk BIGINT
) DISTRIBUTED BY (subcategory_sk);

CREATE TABLE dim_product_category (
    category_sk BIGINT PRIMARY KEY,
    category_name VARCHAR(100)
) DISTRIBUTED BY (category_sk);
Пример связи и загрузки (упрощенный):
-- Установка связей между таблицами
ALTER TABLE dim_product ADD CONSTRAINT fk_product_subcat FOREIGN KEY (subcategory_sk) REFERENCES dim_product_subcategory(subcategory_sk);
ALTER TABLE dim_product_subcategory ADD CONSTRAINT fk_subcat_cat FOREIGN KEY (category_sk) REFERENCES dim_product_category(category_sk);

-- Пример загрузки (стабильный код ETL)
-- dim_product: product_sk, product_id, product_name, brand, subcategory_sk, price
Пример аналитического запроса в снежинке (соединение через подкатегории и категории):
SELECT c.category_name, sc.subcategory_name, d.year, d.month, SUM(f.revenue) AS revenue
FROM fact_sales f
JOIN dim_date d ON f.date_sk = d.date_sk
JOIN dim_store s ON f.store_sk = s.store_sk
JOIN dim_product p ON f.product_sk = p.product_sk
JOIN dim_product_subcategory sc ON p.subcategory_sk = sc.subcategory_sk
JOIN dim_product_category c ON sc.category_sk = c.category_sk
GROUP BY c.category_name, sc.subcategory_name, d.year, d.month
ORDER BY d.year, d.month, c.category_name, sc.subcategory_name;
Пример сравнения: что выбрать для вашего проекта
- Малое количество атрибутов в измерениях, частые агрегации по нескольким измерениям — уместнее звездная схема.
- Большая полнота атрибутов по каждому измерению, редкие обновления атрибутов и необходимость экономии места — снежинка может оказаться предпочтительной.
- В Greenplum ключевые решения обычно принимаются на уровне ETL-архитектуры и требований к задержке обновления. При больших объемах и необходимости совмещать «быстрые» и «точные» аналитические показатели, можно рассмотреть гибридную стратегию: первую часть запросов обслуживать через STAR, для специфических детальных разрезов — через SNOWFLAKE.
Архитектура загрузки и интеграции
Фактовые и размерные данные обычно загружаются через staging-схему и ETL/ELT-пайплайны. В контуре Greenplum особенно эффективны:
- параллельная загрузка WITH COPY ... FROM ... (CSV/Parquet);
- массовая загрузка через external tables (если данные расположены во внешнем источнике);
- использование инструментов как etl-оркестраторы: Apache Airflow, Apache NiFi, dbt (для трансформаций),
- репликация и контроль качества данных в процессе загрузки (валидирование полноты строк, проверка ограничений и консистентности).
Для ускорения аналитических запросов и агрегаций полезны:
- материаловидимые представления (materialized views);
- агрегатные таблицы (rollup/summary) обновляемые по расписанию;
- распределение по ключам и партиционирование для ускорения фильтраций по времени.
Гибридный подход и SCD-2
-
При обновлении размерной таблицы типа SCD Type 2, хорошая практика — иметь таблицы версии. Пример подхода:
- dim_customer_scd2 (customer_sk, customer_id, name, region, is_current, effective_date, end_date)
- при изменении атрибута создаётся новая версия записи с новым customer_sk и обновляется is_current для предыдущей версии.
- В Greenplum можно реализовать методику через staging и последующее обновление целевых таблиц. Важно верно проектировать индексы, чтобы минимизировать блокировки во время обновления.
Примеры технических реализаций (Open-source и российские решения)
Open-source инструменты:
- PostgreSQL/Greenplum — база DW с поддержкой SQL и расширениями;
- ClickHouse — колонно-ориентированная база данных OLAP, популярна в России и применяется для аналитики реального времени и «срезов» больших массивов данных; интегрируется как источник данных в конвейерах и может выступать как OLAP-слой наряду с GP.
- Apache Parquet/Arrow — форматы столбцов для эффективного хранения и переработки данных.
- dbt — инструмент для моделирования данных и трансформаций, совместимый с Greenplum; поддерживает тесты данных и документирование моделей.
Российские решения и практики:
- ClickHouse, разработанный в команде Yandex, является одним из самых популярных решений в России для OLAP-задач и часто применяется в сочетании с GP как вспомогательный слой аналитики или реального времени.
- Поддержка интеграций и практик внедрения DW в российских проектах часто опирается на GLUE/ETL-слои с Open-source инструментами (Airflow, dbt, NiFi) и локальными источниками данных (ERP–1С, EDI и т. п.), где данные сначала нормализуются в staging, а затем загружаются в GP.
Пример архитектуры: источник данных (1С/ERP) -> staging в Greenplum -> ETL/ELT трансформации (dbt, Airflow) -> DW (Star/Snowflake) -> BI/аналитика (Power BI, Tableau, Metabase).
Примеры ETL-операций и SQL-практик
- Подсчет агрегатов и контроль консистентности: создание вспомогательных таблиц, проверок уникальности, контроль ошибок загрузки.
-
Примеры рабочих функций:
- функции временной версии SCD (для Type 2)
- проверка изменений атрибутов и создание новой версии dimension
- Пример загрузки параллельно через COPY:
COPY dim_date(date_sk, full_date, year, quarter, month, day)
FROM '/data/staging/dim_date.csv'
WITH (FORMAT csv, HEADER true, DELIMITER ',', NULL '');
Риски и ограничения внедрения
Риск #1: неравномерная распределенность данных (data skew)
- Неправильно выбранный ключ DISTRIBUTED BY может привести к тому, что один сегмент будет перегружен, а остальные — недогружены. Это снижает эффективность JOIN-операций и общую производительность.
-
Рекомендации:
- выбирать распределение по ключам, которые чаще всего используются в JOIN-условиях (например, date_sk, product_sk, store_sk);
- тестировать на реальных сценариях запросов, использовать EXPLAIN ANALYZE;
- создавать копии таблиц-источников в разных распределённых ключах для сравнения.
Риск #2: увеличение сложности при снежинке
- SNOWFLAKE-подход снижает дублирование данных, но увеличивает количество JOIN-операций и сложность планирования запроса.
-
Рекомендации:
- использовать снежинку там, где это действительно приносит улучшения в поддержке и обновлениях;
- для критичных быстрых запросов рассмотреть денормализацию в STAR-форме для быстрого доступа.
Риск #3: поддержание целостности и версии
- Включение SCD и исторических версий усложняет ETL-процессы, требует согласования между источниками и DW.
-
Рекомендации:
- внедрить тестовые наборы и регулярные проверки целостности;
- документировать версионирование и политику SCD;
- автоматизировать тесты на каждом шаге конвейера.
Риск #4: ограничения средств и инфраструктуры Greenplum
- GP требует вычислительных ресурсов; при нехватке CPU/памяти возможны узкие места на этапах агрегаций и JOIN.
-
Рекомендации:
- планировать мощность кластера под ожидаемую нагрузку;
- использовать материализованные представления и агрегации, где стоит задача быстрого доступа;
- грамотно настраивать параметры параллелизма и распределения.
Риск #5: интеграции с внешними системами и качеством данных
- Неправильные данные и несогласованность источников приводят к некорректным аналитическим выводам.
-
Рекомендации:
- внедрить профилирование данных на входе в DW;
- автоматизировать проверки качества данных;
- обеспечить журналы и мониторинг загрузок (ETL-오로케строирование).
Выводы
- В DW на базе Greenplum выбор между звездной и снежинкой схемами зависит от характера данных и требований к быстродействию запросов, а также от числа и сложности атрибутов измерений. Звездная схема чаще оптимальна для больших объемов фактов и частых агрегаций, снежинка — для экономии места и лучшей нормализации атрибутов размерных таблиц.
- Ключ к успеху в реализации — грамотное планирование распределения (DISTRIBUTED BY) и партиционирования, а также продуманная стратегия SCD для сохранения истории и точности данных.
- Важно сочетать теоретическую модель с практикой: применяйте Open-source инструменты (PostgreSQL/GP, ClickHouse, dbt, Airflow) и ориентируйтесь на российские решения (ClickHouse) для обеспечения эффективности и локальной поддержки.
- Регулярно тестируйте производительность и корректность запросов, отслеживайте показатели задержек, выполняйте мониторинг и выполняйте очистку и реорганизацию данных по мере роста DW.
Выводы по разделам
- Теория: знание терминов, концепций и выгод/ограничений звездной и снежинкой схем критично для корректного выбора дизайна и успешного внедрения DW на Greenplum.
- Практика: реальные примеры DDL, примеры запросов и архитектурных решений помогают перенести теорию в практику.
- Технические детали: грамотная настройка распределения, партиционирования и трансформаций в ETL/ELT-проектах обеспечивает устойчивую работу DW.
- Риски: без учета распределения и изменений в измерениях можно получить узкие места, снижение производительности и некорректные данные.
- FAQ: в конце главы представлен блок вопросов и подробные ответы на основе материалов настоящей главы.
FAQ (Вопрос–Ответ)
1) В чем разница между звездной и снежинкой схемами?
- Звездная схема: одна центральная факт-таблица окружена денормализованными измерениями; меньше JOIN-операций, быстрее для большинства аналитических запросов.
- Снежинка: размерные таблицы нормализованы в подтаблицы (категории, подкатегории и т. п.); снижает дублирование данных, но увеличивает число JOIN-операций и сложность планирования запросов.
2) Какие преимущества использует Greenplum для звездной схемы?
- Быстрота агрегаций и простота запросов благодаря денормализации измерений;
- Грамотное распределение по ключам (DISTRIBUTED BY) и партиционирование для разделения нагрузок и ускорения фильтраций по времени;
- Возможность материаловиденных представлений и агрегатов для ускорения повторяющихся запросов.
3) Какие риски связаны с неправильным выбором ключа DISTRIBUTED BY?
- Неправильный ключ может привести к data skew и неэффективному параллелизму, что ухудшает производительность JOIN и агрегаций.
- Рекомендации: тестировать планы выполнения, выбирать частые JOIN-ключи и комбинировать их для распределения.
4) Как реализовывать SCD в Greenplum?
- Применение SCD Type 2 для сохранения истории — добавление новой версии записи и обновление предыдущей версии, чтобы она стала неактивной, с использованием версионности (effective_date, end_date) и текущего флага.
- В ETL-процессе важно поддерживать консистентность между фактами и измерениями и не забывать про индексацию и чистку устаревших данных.
5) Что выбрать: звездную или снежинку для проекта на российских данных?
- Если критична скорость чтения и простота поддержки, чаще предпочтительна звездная схема.
- Если важна экономия места и консистентность атрибутов в глубокой нормализации, снежинка может быть оправдана.
- В российских условиях можно использовать сочетания:星 с использованием ClickHouse в реальном времени и Greenplum для глубокой аналитиkи; dbt и Airflow помогут в координации ETL/ELT.
6) Какие практические ограничения у использования Open-source решений в России?
- Правила лицензирования и доступ к внешним данным: нужно следить за обновлениями версий и совместимостью.
- Важна локальная поддержка и документация; использование проектов как ClickHouse требует квалифицированных специалистов и грамотной интеграции в существующую архитектуру.
- В целом, открытые инструменты хорошо сочетаются с локальными источниками данных (1С, ERP) через ETL-пайплайны.
7) Как тестировать производительность DW на стадии проектирования?
- Моделируйте нагрузку реальных запросов: часто используемые агрегации, фильтры по времени, по регионам, по клиентам и т. п.
- Используйте EXPLAIN и EXPLAIN ANALYZE для планирования запросов.
- Тестируйте различныe схемы (STAR vs SNOWFLAKE) на реальном наборе данных и сравнивайте время выполнения.
- Включайте мониторинг ресурсов (CPU, память, I/O) и оценивайте влияние DISTRIBUTED BY и partitioning.
8) Какие инструменты можно использовать для ETL/ELT с Greenplum?
- dbt (для трансформаций и тестирования моделей);
- Apache Airflow (оркסטрация);
- Apache NiFi (потоки данных);
- Скрипты Python/SQL, копирование через COPY, внешние таблицы для загрузки данных.
9) Какие практики стоит применить для контроля качества данных?
- Валидация входящих данных на этапе staging;
- Тесты целостности (FK-ограничения, соответствие бизнес-правилам);
- Мониторинг задержек загрузки, контроль дубликатов и пропусков.
10) Что стоит учитывать при проектировании для будущего масштабирования?
- Выбор распределения и партиционирования с учетом роста объема и числа запросов;
- Возможность добавлять новые измерения и факты без радикальных изменений в архитектуре;
- Готовность к переходу между STAR и SNOWFLAKE в зависимости от изменений требований.
Если захотите, могу дополнить раздел примерами из вашего контекста (конкретные источники данных, отрасль, пример реального бизнес-задания) и адаптировать код под версию Greenplum, которую вы используете.


