

Описание активов и контекст
Описание активов и контекст — это основа любого курса по внедрению Data Catalog в компании. Цель раздела — дать новичку прочную основу: что такое активы данных, как они описываются и каким образом связаны между собой, какие роли и процессы отвечают за управление этими активами, и какие методики применяются для формирования полезного и понятного контекста. В рамках данного раздела мы обсудим типы активов, метаданные, термины и глоссарий, принципы классификации и управления, а также приведём конкретные примеры внедрения на практике с использованием как открытых инструментов, так и отечественных реализаций. Мы будем говорить понятным языком, но не забывать о технических деталях, чтобы вы могли перейти от теории к реальной работе в вашей компании.
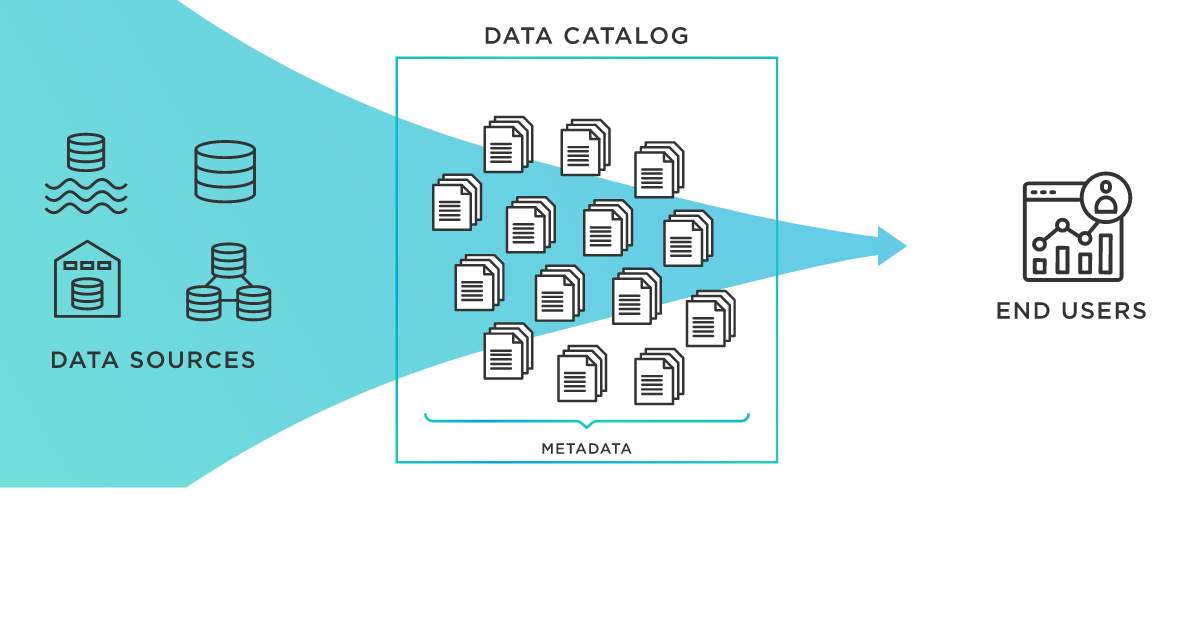
Определение активов и контекста
Актив данных — это любой ресурс в вашей информационной системе, который содержит данные или метаданные о данных и имеет ценность для бизнеса. Это может быть набор данных (датасет), таблица или представление в базе данных, пайплайн или DAG в оркестраторе, модель машинного обучения, готовая бизнес-отчётная запись, дашборд, словарь терминов, документация по данным и даже набор бизнес-правил, связанных с конкретной информационной областью. Контекст актива — это совокупность сведений, которые позволяют понять, что за актив находится перед вами, откуда он берётся, как поддерживается, кто отвечает за него, какие ограничения на использование применяются, и какую ценность он приносит бизнесу.
Метаданные и их уровни
Метаданные — это данные о данных. Их можно разделить на несколько уровней:
- технические метаданные: схема, типы данных, форматы, частота обновления, источники происхождения, место хранения, версии, зависимости;
- бизнес-метаданные: названия бизнес-потребностей, определение термина, контекст использования, целевые пользователи, применимые политики;
- операционные метаданные: владелец актива, стейкхолдеры, политика доступа, ответственность за качество данных, SLA, требования к хранению и архивированию;
- контекстные связи: линейность (lineage) между пайплайнами, источниками и потребителем, зависимости между активами, теги и глоссарий терминов.
Глоссарий и таксономия
Одно из важнейших условий успешного внедрения — единая терминология. Глоссарий задаёт определения бизнес-терминов и их связь с техническими активами. Таксономия позволяет классифицировать активы по доменам, уровням конфиденциальности, областям ответственности и другим критериям. Наличие глоссария и единой таксономии снижает риск различной интерпретации данных между подразделениями и ускоряет поиск нужной информации.
Объектная модель и жизненный цикл активов
Любой актив имеет жизненный цикл: создаётся, описывается, проходит процессы проверки качества, обновляется, архивируется или удаляется. В контексте Data Catalog мы обычно выделяем стадии: планирование, инициация, контроль качества, публикация, поддержка и устаревание. В рамках каталога активы связываются друг с другом: например, таблица в дата-центре имеет lineage к ETL-пайплайну, который формирует агрегат, который затем используется в дашборде или модели ML. Управление контекстом предполагает наличие ответственных лиц: владелец данных, стейкхолдеры бизнес-подразделения, администраторы безопасности и инженеры по качеству данных.
Роли и процессы управления активами
- Владелец актива: ответственность за точность описания, актуальность и доступность актива, утверждение политики использования.
- Стейкхолдеры: представители бизнес-подразделения, которые формируют требования к данным и принимают решения, касающиеся контекста и информирования пользователей.
- Страж данных (data steward): обеспечивает качество, согласованность и соблюдение политики доступа; активизирует процессы исправления ошибок и обновления метаданных.
- Администратор каталога: отвечает за настройку среды, интеграцию источников, безопасность, мониторинг и управление версиями.
- Пользователь: получатель данных, который ищет активы, оценивает их качество и применяет их в аналитике.
Методологии и подходы
DCAM/DAMADMBOK и ISO/IEC 11179 как ориентиры
DCAM (Data Criteria and Metadata) и DAMA-DMBOK дают общие принципы управления данными, которые можно адаптировать к вашему контексту. ISO/IEC 11179 задаёт принципы описания метаданных и именования элементов, что помогает в гармонизации моделей данных и метаданных между различными системами.
Data governance и data stewardship
Организация должна определить рамки ответственности за данные и обеспечить поддержку процессов качества, доступа и соответствия требованиям. В рамках каталога активы описываются с учётом правил доступа, политики обработки персональных данных, противодействия утечкам и периодов хранения.
Data lineage как средство понимания контекста
Линейность (lineage) позволяет увидеть, как данные проходят через пайплайны: источники данных — преобразования — выходные активы. Это критически важно для воспроизводимости анализа и для аудита.
Инкрементальная загрузка метаданных и актуализация контекста
Метаданные следует обновлять по расписанию или по событиям. Важно поддерживать синхронизацию между источниками, каталогом и внешними системами рисков и соответствия. Инкрементальные обновления снижают нагрузку на сеть и базы данных, ускоряют доступ к актуальной информации.
Техника поиска и семантика
Эффективный поиск в каталоге строится на полнотекстовом индексе, тегах, описаниях и связях между активами. Релевантность поиска повышается за счёт использования бизнес-терминов, альтернативных названий, синонимов и контекстуальных подсказок.
Ключевые термины
- Актив данных (data asset): любой ресурс, который содержит данные или метаданные о данных.
- Метаданные (metadata): данные о данных, описывающие источник, структуру, контекст и использование активов.
- Линейность (lineage): связь между источниками данных, преобразованиями и потребителями, показывающая путь данных.
- Владелец (owner) и стейкхолдеры: лица или группы, ответственные за актив и его использование.
- Глоссарий и таксономия: единая терминология и классификация активов.
- Конфиденциальность и безопасность: классификация активов по уровню чувствительности и правилам доступа.
- Lifecycle (жизненный цикл): стадии создания, модификации, проверки и утилизации актива.
- Governance (управление данными): совокупность процессов, ролей и политик по управлению активами.
Практические примеры
Пример 1: Open-source Amundsen
Архитектура и роль в описании активов
Amundsen — открытая платформа каталогизации данных, ориентированная на поиск и управление активами. Основные сущности: Dataset (или таблица), Column, Tag, Owner, 등. Для линейки активов Amundsen использует механизмы набора данных и пользователей, чтобы создать контекст вокруг активов.
Как начать работу
Разверните Amundsen через Docker и Docker-Compose или в Kubernetes. В базовом варианте у вас будут сервисы: frontend, catalog-api, metadata-service, workers, и database (например, Neo4j для графовой части и Elasticsearch для поиска).
Интегрируйте источники данных. Обычно подключают Hive, Presto, Postgres, MySQL, Snowflake, а также инструменты ELT-пайплайнов (Airflow, Prefect) для обнаружения и описания активов.
Интеграция метаданных. С помощью Python-библиотеки databuilder можно описать источники, таблицы и колонки, задать владельцев и бизнес-термины.
Пример наполнения метаданных
Dataset: sales.orders
  description: таблица фактов заказов за месяц
  source: postgres_oltp.sales
  owner: data-eng@company.com
  tags: [sales, orders, PII]
  columns: order_id (integer, PK, order identifier), customer_id (integer, PII), order_date (date), amount (decimal)
Lineage:
  etl_job_sales_daily -> sales.orders
  raw_sales_raw -> etl_job_sales_daily -> sales.orders
Практические нюансы
- Регулярная синхронизация. Выберите частоту синхронизации описаний и линейности в зависимости от скорости изменений в пайплайнах.
- Управление доступом. Включите SSO (например, через SAML2/OIDC) и настройте роли в каталоге: администратор, стейкхолдер, пользователь.
- Контекст через глоссарий. Добавляйте термины, определяйте синонимы и связи между бизнес-терминами и активами.
Пример 2: OpenMetadata
OpenMetadata — современная платформа для управления метаданными с поддержкой множества коннекторов и активов. Для начала:
- Разверните OpenMetadata через Docker-Compose или Kubernetes.
- Подключите источники данных (Postgres, BigQuery, Snowflake и др.) через коннекторы.
- Настройте ingestion из Airflow или прямую загрузку метаданных из дата-литей (ETL-пайплайны).
- Опишите Dataset и Columns с помощью REST API OpenMetadata или через UI.
- Свяжите бизнес-термины и владельцев, создайте линейность между источниками, пайплайнами и потребителями.
Пример 3: Apache Atlas и DataHub (для разных стеков)
- Atlas хорошо работает в экосистеме Hadoop и позволяет описывать активы через типы и энтити, поддерживает линейность и политики безопасности.
- DataHub основан на GrafQL и имеет модульный подход к метаданным, что позволяет строить гибкие коннекторы и расширять модель активов.
Пример 4: Российские решения и подходы
В отечественном контексте крупные компании часто применяют локальные решения по управлению активами вместе с корпоративной SSO и интеграцией с внутренними каталогами, системами BI и системами безопасности. Пример реализации может быть следующим:
- Архитектура: корпоративный каталог активов, связанный с LDAP/AD для идентификации пользователей, интеграция с системой управления доступом и с внутренними репозиториями метаданных. Источниками становятся базы данных предприятия, файлы и документы, API сервисов.
- Интеграционные коннекторы: коннекторы к PostgreSQL, Oracle, MS SQL Server, системам бизнес-аналитики и пайплайнам на основе внутреннего ETL-агента.
- Контент: описания активов, глоссарий терминов, линейность между источниками и потребителями, политики доступа и требования соответствия.
- Безопасность: интеграция с внутренними системами управления идентификацией и ролями, аудит изменений метаданных, шифрование данных в каталоге.
- Практический режим: пилот в одном бизнес-доделе с участием data steward, аналитиков и ИТ-администраторов; постепенное расширение на другие домены.
Важно: выбор отечественного решения должен основываться на поддержке локальных стандартов, совместимости с гражданскими и отраслевыми регламентами, возможности установки на внутреннем оборудовании и интеграции с существующими системами безопасности и хранения данных. В рамках курса мы обсуждаем принципы, которые применимы к любому решению, включая отечественные варианты, даже если конкретные названия решений могут варьироваться между компаниями.
Модель данных и сущности
- Dataset: представляет собой набор данных. Основные поля: name, description, source, owner, confidentiality, data_domain, tags, lifecycle_stage.
- Table/Column: таблицы и колонки внутри набора данных. В колонке указываются name, data_type, description, nullable, constraints, semantic_tags.
- Pipeline/Job: пайплайн или задача, который создаёт продуктыData (например, ETL-процесс, который наполняет набор данных). Связан с lineage.
- GlossaryTerm: бизнес-термин, определение и связи с активами через relationships.
- Tag/Label: классификационные ярлыки, которые помогают найти активы по тематикам (например, PII, Sensitive, Compliance, Marketing).
- Owner/Steward: роли, соответствующие пользователи и группы.
Метаданные и схема
- Технические данные: источник (база данных), схема, версия, формат (parquet, avro, delta), частота обновления, дата последнего изменения.
- Бизнес-данные: определение термина, контекст использования, примеры сценариев.
- Безопасность и доступ: уровень конфиденциальности (PII, конфиденциальный, общедоступный), политики доступа, требования к хранению.
- Качество: шаги контроля качества, допустимые значения и правила валидации.
- Линейность: источники данных, промежуточные шаги и потребители.
Пример информационной модели (упрощённый JSON-образец)
{
  "asset_id": "ds_sales_orders",
  "name": "sales.orders",
  "type": "Dataset",
  "description": "Таблица фактов заказов",
  "source": "postgresql://db.company.com:5432/sales",
  "owner": "data-eng@company.com",
  "confidentiality": "PII",
  "data_domain": "Sales",
  "tags": ["sales","orders","PII"],
  "columns": [
    {"name": "order_id", "type": "integer", "description": "уникальный идентификатор заказа", "nullable": false},
    {"name": "customer_id", "type": "integer", "description": "идентификатор клиента", "nullable": false},
    {"name": "order_date", "type": "date", "description": "дата заказа", "nullable": false},
    {"name": "amount", "type": "decimal(10,2)", "description": "сумма заказа", "nullable": false}
  ],
  "lineage": ["etl_orders_daily"],
  "glossary_terms": ["Order", "Customer"],
  "last_modified": "2025-07-10T12:34:56Z"
}
Интеграция с пайплайнами и источниками
- Ингесторы: используйте коннекторы к источникам данных, к системам ETL и BI, чтобы автоматически подтягивать базовую информацию об активах.
- Локальные коннекторы: для российского рынка часто важна адаптация под локальные СУБД, форматы журналирования и правила аудита.
- Встроенная линейность: храните линейность в виде графа, чтобы можно было визуализировать путь данных от источника к потребителю.
- API и экспорты: каталоги должны поддерживать REST API и экспорт в форматы JSON/XML для интеграции с другими системами и бизнес-подразделениями.
Архитектурные принципы внедрения
- Центр данных как источник правды: каталог должен стать единой точкой доступа к метаданным, но при этом он не должен пытаться хранить сами данные в полном объёме — метаданные и линейность даны в каталоге, сами данные остаются в источниках.
- Безопасность и соответствие: встраивайте политики доступа, аудит изменений и хранение журналов доступа; поддерживайте соблюдение местного законодательства, включая требования к персональным данным.
- Масштабируемость: архитектура должна поддерживать рост числа активов, пользователей и источников без снижения производительности поиска.
- Поддержка изменений: изменения в источниках автоматически приводят к обновлениям в метаданных, чтобы контекст оставался актуальным.
- Взаимодействие с BI и аналитикой: каталоги должны быть удобным источником контекстной информации для аналитиков и data scientists.
Риски и ограничения
- Риск дезинформации и устаревших данных: если метаданные не обновляются вовремя, пользователи могут полагаться на ложный контекст. Меры: автоматизированные обновления, контроль изменений, уведомления об устаревших записях.
- Риск нарушения приватности и безопасности: чрезмерные или некорректные политики доступа могут привести к утечке данных или слишком ограниченному доступу. Меры: строгие политики доступа, аудит, минимизация доступа по необходимости.
- Риск узкой интеграции и vendor lock-in: зависимость от одного поставщика может ограничить гибкость. Меры: выбор платформы с открытыми API и поддержкой стандартов, возможность перехода между коннекторами.
- Риск несоответствия регламентам: персональные данные и конфиденциальный контент регулируются законами. Меры: классификация конфиденциальности, управление данными по правилам организации, аудит.
- Риск перегрузки и производительности: слишком широкой моделью метаданных можно перегрузить систему. Меры: разумная гранулярность, выборочные метаданные, кэширование и эффективные поисковые индексы.
- Ограничение по качеству данных: наличие чистых, понятных и корректно описанных активов — не всегда автоматизировано. Меры: внедрение процессов проверки качества описаний, обзор со стороны data steward, обучение пользователей.
- Ограничения в российском контексте: правила локализации, хранение и обработка данных, требования к аудиту, соответствие локальным регламентам. Меры: проектирование архитектуры с учётом локальных требований, профильные консультации и участие представителей юрлица.
Описание активов и контекст — это не просто набор полей и словарей. Это системная база знаний вашей компании, которая позволяет аналитикам быстрее находить нужные данные, понимать их контекст, оценивать применимость и безопасность, а также восстанавливать путь данных от источника до потребителя. Успешное внедрение требует ясной роли ответственных лиц, единых стандартов описания, регулярной актуализации метаданных и тесной интеграции с пайплайнами и системами безопасности. В конечном счёте качественный контекст активов ускоряет анализ, повышает доверие к данным и снижает риски ошибок в принятии решений.
FAQ — Вопрос–Ответ
1) Что такое актив данных и зачем нужен контекст в каталоге?
Ответ: Актив данных — любой ресурс, содержащий данные или метаданные. Контекст включает описание, источник, ответственность, политику доступа и линейность. Цель каталога — дать поиску и анализу возможность быстро находить активы, понимать их происхождение, применимость и ответственность за них.
2) Какие основные типы активов стоит описывать в каталоге?
Ответ: Основные типы: Dataset (таблица или набор данных), Table/Column (таблица и её колонки), Pipeline/Job (пайплайн или задача), Model (модель ML), Dashboard/Report (дашборд или отчёт), GlossaryTerm (термин в глоссарии). Также могут быть документы и API, описывающие процессы и бизнес-правила.
3) Какой набор метаданных полезно заполнять по каждому активу?
Ответ: Полезно заполнять: имя и описание, источник данных, владелец/стейкхолдеры, уровень конфиденциальности, домен данных, теги, линейность и зависимости, формат и версия, дату последнего обновления, политики доступа, качество данных, glossary terms и примеры использования.
4) Какие существуют подходы к внедрению и какие инструменты можно использовать?
Ответ: Подходы включают развертывание централизованного каталога с поддержкой OpenAPI и REST API, сбор метаданных через коннекторы и ingestors, установление ролей и политик доступа, внедрение глоссария и таксономии. В практику входят open-source инструменты Amundsen, Apache Atlas, DataHub, OpenMetadata. В отечественном рынке возможно использование локальных решений, интегрированных с корпоративной инфраструктурой и требованиями локального регулирования.
5) Какие преимущества дают открытые решения как Amundsen и DataHub?
Ответ: Они позволяют быстро развернуть каталог, поддерживают множество источников, дают механизмы линейности и контексту, обладают активными сообществами, регулярными обновлениями, хорошей интеграцией с BI и данными, а также программируемыми API и возможностью расширения под нужды компании.
6) Что важно учитывать при выборе российского решения?
Ответ: Важно учитывать соответствие требованиям локального законодательства, возможность локального развёртывания (on-prem или частный облачный режим), интеграцию с существующими системами безопасности и аутентификации, поддержку стандартов и открытых API, наличие поддержки и подготовки кадров в российском рынке.
7) Какие риски чаще всего встречаются в начале внедрения и как их минимизировать?
Ответ: Частые риски — устаревшие или неполные метаданные, сложности с доступами и политиками, ограниченная совместимость источников, производительность каталога. Минимизация: определить ответственных за метаданные, наладить регулярную синхронизацию, начать с пилота на одном домене, внедрить политики доступа и аудит, использовать разумную гранулярность описания активов.
8) Как связать контекст активов с качеством данных?
Ответ: Контекст активов должен включать данные о качестве: правила валидации, частота проверки, результаты тестов и вовлечение data steward. Это позволяет аналитикам учитывать качество при использовании активов.
9) Какую роль играет линейность в каталоге и как её реализовать?
Ответ: Линейность позволяет видеть путь данных: от источника до потребителя через пайплайны. Реализация — моделирование графа зависимостей между источниками, пайплайнами и потребителями, хранение ссылок в метаданных и визуализация графа в интерфейсе каталога.
10) Какие шаги можно предпринять для быстрого начала внедрения в компании?
Ответ: Выберите пилотный домен (например, продажи), определите набор активов и стейкхолдеров, подключите несколько основных источников, заполните базовые метаданные и глоссарий, настройте роли и доступ, запустите линейность и базовую проверку качества. Постепенно расширяйте охват по другим доменам, увеличивайте число коннекторов и углубляйте контекст.
Описание активов и контекст — ключ к эффективной работе аналитиков, BIи ML-команд. Правильно организованный каталог с качественным контекстом ускоряет поиск, повышает точность анализа и улучшает контроль над данными. В процессе внедрения важно поддерживать баланс между полнотой описания и эффективностью работы каталога, а также активно вовлекать бизнес-стейкхолдеров и data stewards в поддержание контекста.


