

Подготовка признаков в Lakehouse: принципы и паттерны
Добро пожаловать к главе о подготовке признаков в Lakehouse-предприятии. Здесь мы разберем, как превратить формальные данные в качественные признаки для машинного обучения и продвинутой аналитики, какие паттерны применяются на практике, какие технические решения помогут хранить и повторно использовать признаки, и как организовать сотрудничество аналитиков и data scientists в рамках единой lakehouse-архитектуры. Мы рассмотрим теорию, познакомимся с открытыми инструментами и примерами российских решений, обсудим риски и ограничения внедрения, а затем приведем практические примеры и тесты.
- Что такое признак (feature) и почему его качество критично.
- Lakehouse как архитектура хранения данных: объединение темпорально-верифицированных данных, единое место для обучения и инференса, поддержка схемы, enforceable data contracts.
- Зачем нужен feature store: единая, управляемая и версионируемая коллекция признаков, поддержка offline/online слоёв, ускорение экспериментов и повторного использования признаков.
Ключевые понятия:
- Признак (Feature): измеряемая или вычисляемая характеристика объекта (пользователь, продукт, транзакция и т.д.), используемая для обучения моделей.
- Feature Store: централизованное хранилище признаков с инструкциями по их извлечению, хранением версий и качеством данных.
- Offline vs Online: пакетная (batch) подача признаков для обучения и пакетных прогонов против онлайн-сервиса с низкой задержкой (например, Redis, ClickHouse, RocksDB).
- Time-to-Feature: актуальность признаков во времени, consistency constraints (point-in-time correctness).
В этой главе мы будем держаться следующих принципов:
- Повторяемость и воспроизводимость: признаки должны быть полностью повторяемыми для обучения и инференса.
- Контракты данных: формальные спецификации признаков, их типы, валидности, граничные значения и допустимые диапазоны.
- Безопасность и соответствие требованиям: контроль доступа, аудит, соответствие регулированиям.
- Эволюция признаков: версии признаков, управление схемами и миграциями.
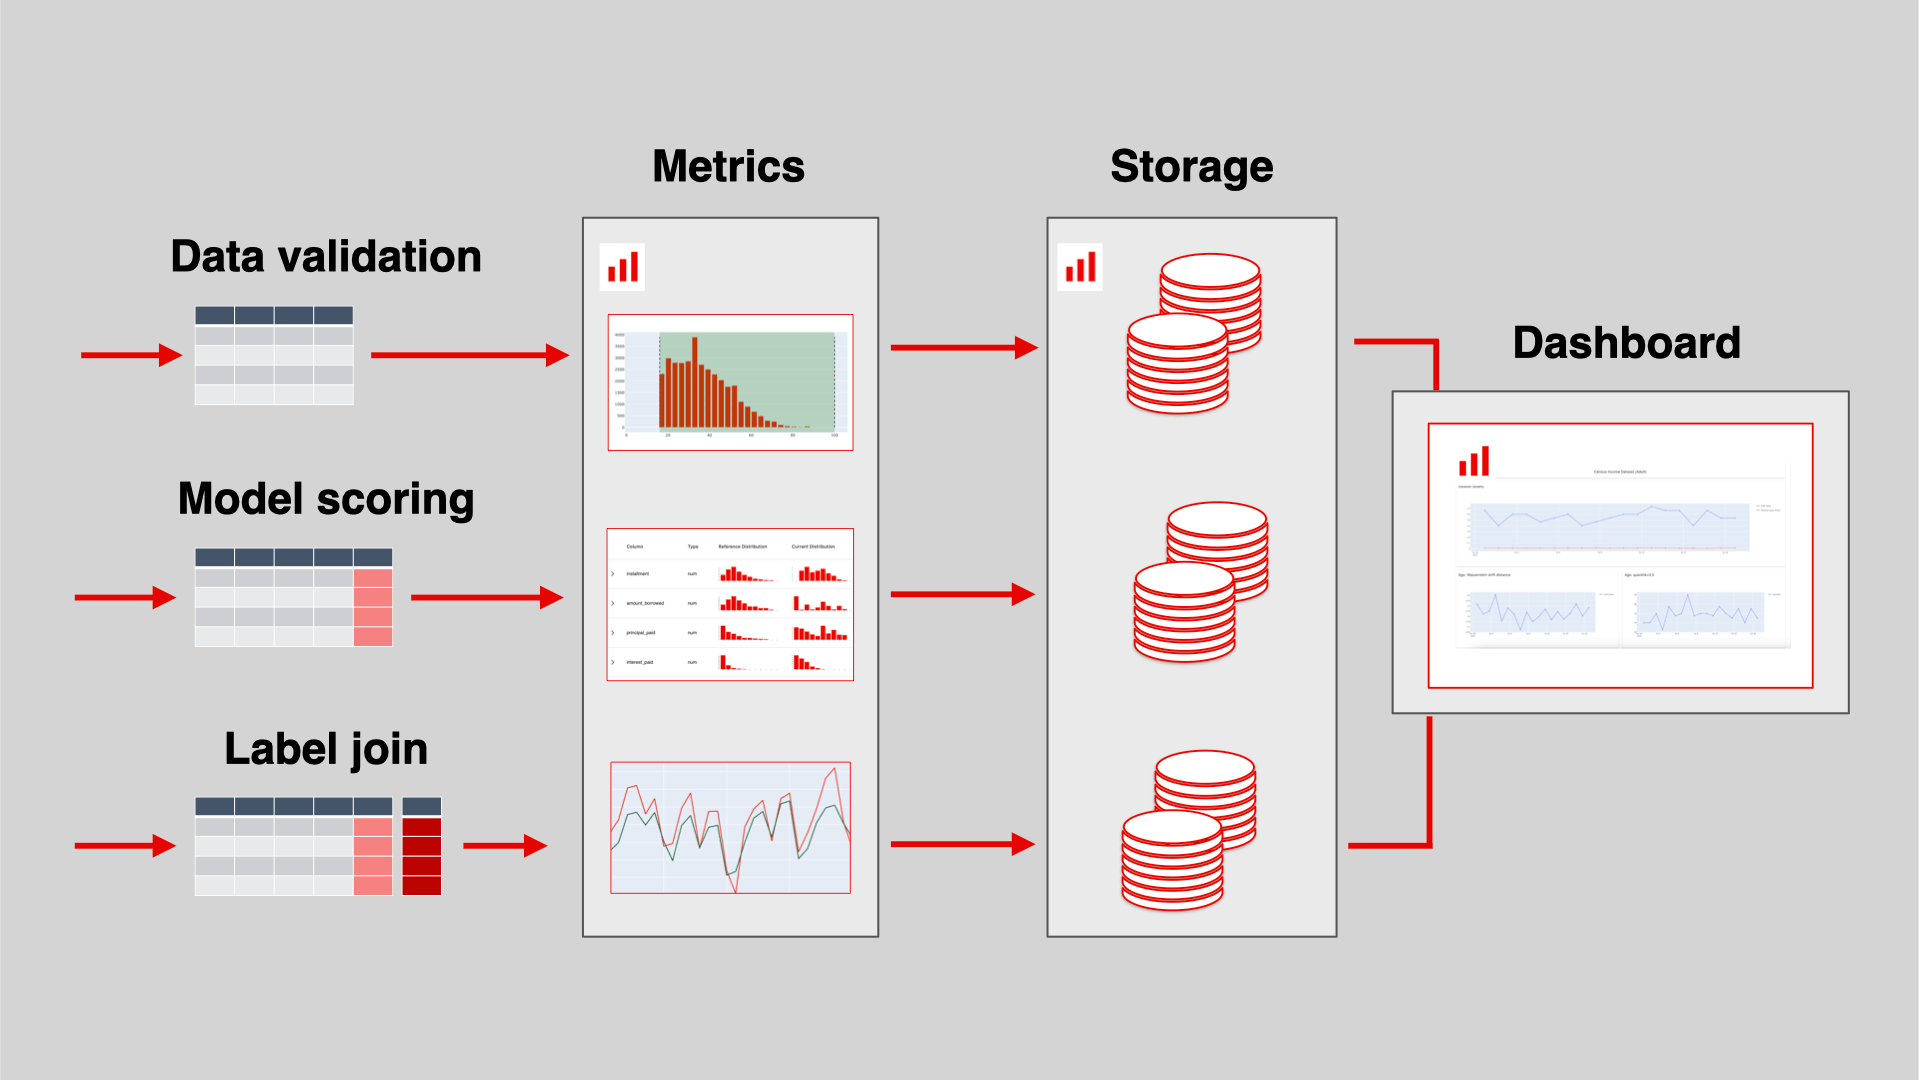
Теоретика признаков и паттерны подготовки
- Признаки делятся на статические и временные (time-varying). Для обучения чаще нужны исторические значения признаков с привязкой к моменту времени (timestamp). Для инференса – актуальные значения или значения на момент запроса.
- В Lakehouse признаки обычно хранятся в двух слоях: offline (пакетные таблицы, parquet/ORC в lake) и online (быстрый доступ, например Redis, ClickHouse, Kudu, HBase). Это обеспечивает баланс между скоростью обучения и скоростью инференса.
- Версионирование признаков: чтобы избежать дрейфа и утечек, вводят версии признаков, а также контракт на набор признаков (feature schema). Версии должны быть видимыми как пользователям, так и пайплайнам.
- Контракты и схемы: Data Contracts — это формальные декларации того, какие признаки нужны моделям, какие типы, какие метаданные (unit, range, allowed missing, timestamp). Контракты помогают предотвратить неожиданные дыры на стадии обучения и продакшена.
- Data lineage: прослеживаемость источников признаков, их пути трансформаций, зависимости и кадров временных меток. Это критично для устранения ошибок, аудита и регуляторных требований.
- Верификация качества признаков: тестирование признаков (unit tests на трансформации), sanity checks (например, отсутствие нулей в критических признаках), мониторинг качества данных (плотность пропусков, дрейф распределения).
- Безопасность и доступ: разграничение доступа к offline/online признакам, аудит доступа, соответствие требованиям к данным (PII, конфиденциальные данные).
Паттерны подготовки признаков
Паттерн "Feature in, feature out" (передача признаков как части пайплайна)
- Данные собираются, проходят через ETL/ELT-процессы, формируются признаки и сохраняются в offline-хранилище Lakehouse.
- Онлайн-слой извлекает признаки по запросу и подает в инференс-модели.
Паттерн "Single source of truth" (SSOT) для признаков
- Все признаки живут в одном Feature Store, который отвечает за версионирование, lineage и доступ к offline/online данным.
- Упрощает повторное использование признаков между проектами.
Паттерн "Feature governance" (управление качеством и безопасностью)
- Данные контрактируются, признаковая модель возвращается с явными требованиями к данным.
- Вводится процесс утверждения изменений признаков, фазовые релизы и тестирование на песочнице.
Паттерн "Time travel / Point-in-time join"
- В обучении важно избегать утечки времени: обучение должно использовать признаки по времени, который был доступен на момент обучения.
- При инференсе признаки должны соответствовать времени запроса, иначе возникает leakage.
Паттерн "Offline обучающие датасеты; Online-сервис признаков"
- Offline-даты строятся на полноценных исторических данных, Online-признаки — минимальное необходимое время отклика для продакшн-инференса.
Паттерн "Feature versioning and deprecation"
- Вводится новая версия признаков, старые версии постепенно выводятся из употребления, но остаются доступными для обратной совместимости.
Архитектура Lakehouse и роль Feature Store
Lakehouse объединяет удобство data lake (масштабируемость, хранение форматов колонн-ориентированных файлов) и надежность data warehouse (схемы, транзакции, безопасность).
Feature Store выступает как «посредник» между источниками данных и моделями: он хранит признаки, их версии, линейку источников и обеспечивает единый API для обучения и инференса.
Ключевые компоненты Feature Store:
- Data sources (источники данных): Raw данные в lake, event streams.
- Feature definitions (описания признаков): сущности, наборы признаков, зависимости, таймстемпы.
- Offline store (пакетные таблицы): хранят исторические данные признаков для обучения и аудита.
- Online store (онлайн-сервис): обеспечивает низкую задержку доступа к признакам для инференса.
- Ingestion & transformation pipelines: ETL/ELT-процессы, которые создают признаки на основе сырья.
- Serving API: интерфейс для моделей (SDKs, REST/ gRPC).
- Governance: версии, контракты, аудит, безопасность.
Важно помнить: признаки не должны зависеть от конкретного проекта. Их повторное использование — ключ к экономии времени и качеству.
Ключевые термины и сравнение
- Feature View / Feature Group: группы признаков, которые идут вместе и обслуживают конкретное использование (например, «пользовательская активность за 7 дней»).
- Entity: объект, к которому привязаны признаки (пользователь, изделие, устройство).
- Online Store vs Offline Store: онлайн-слой — низкая задержка, онлайн-обслуживание; оффлайн-слой — аналитическая обработка, обучение.
- Time-windowing: ограничение временных окон при агрегациях.
- Data Drift: изменение распределения признаков во времени.
- Feature Leakage: утечка информации о целевой переменной через признаки.
- MVP vs Production-grade: минимально жизнеспособный продукт (для старта) против готового к эксплуатации в проде.
Практические примеры
Ниже представлены реальные и понятные примеры, как можно организовать подготовку признаков в Lakehouse с использованием открытых инструментов и с учётом российского контекста.
Пример 1. Open-source: Feast как центральный Feature Store
Задача: собрать признаки по пользователю и транзакциям, использовать их для обучения модели рекомендации.
Архитектура:
- Источник данных: Lakehouse-хранилище (например, Delta Lake или Parquet на S3/облачном экране).
- Offline store: Parquet/Delta таблицы в Lakehouse.
- Online store: Redis или ClickHouse для низкой задержки.
- Feast как слой управления признаками.
- Модели читают признаки через Feast API.
Пример конфигурации Feast (Python/YAML):
# requirements: feast==0.22+, pyspark, sqlalchemy
from feast import Feature, FeatureService, Entity, ValueType
from feast import FeatureStore
from datetime import datetime

# Определение сущности
user = Entity(name="customer_id", value_type=ValueType.INT64, description="Уникальный идентификатор пользователя")

# Определение признаков
feature_view_user = FeatureView(
    name="user_features",
    entities=["customer_id"],
    ttl=None,
    schema=[
        Feature(name="days_since_last_login", dtype=ValueType.INT64),
        Feature(name="total_spent_last_30d", dtype=ValueType.FLOAT),
        Feature(name="avg_session_duration", dtype=ValueType.FLOAT),
    ],
    batch_source=...
)

# Пример использования клиента Feast
fs = FeatureStore(repo_path="path/to/feast_repo")

# Чтение признаков для запроса
entity_rows = [{"customer_id": 123}, {"customer_id": 456}]
feature_ref = ["user_features:days_since_last_login",
               "user_features:total_spent_last_30d",
               "user_features:avg_session_duration"]

features = fs.get_online_features(
  feature_refs=feature_ref,
  entity_rows=entity_rows
).to_dict()
Команды развёртывания:
- feast apply: применить конфигурацию к хранилищу.
- feast materialize: заполнение offline-таблиц.
- feast serve: запуск онлайн-слоя (опционально — через Feast SDK).
Преимущества:
- Единый API для обучения и инференса.
- Версионирование и аудит признаков.
- Простая интеграция с PyTorch/TensorFlow/Scikit-Learn.
Российский контекст и практическая адаптация:
- Часто локальные провайдеры предлагают интеграцию Feast с локальным хранилищем (HDFS/YC/ClickHouse), Kerberos-авторизацией и локальной сетевой политикой.
- Онлайн-слой может быть реализован через ClickHouse или Redis с защитой через TLS и Kerberos, а также с ограничениями по доступу (ACL) на уровне сервиса.
Пример 2. Паттерны и примеры на базе Delta Lake + Spark
Задача: подготовить признаки на большом объёме событий продаж за год для обучения recommender-системы.
Архитектура:
- Источник данных: события продаж в Lakehouse (Delta Lake).
- Промежуточные агрегации: Spark SQL для окрестных окон (признаки за 7/30/90 дней).
- Offline store: Delta-представления признаков.
- Online store: Redis/ClickHouse для сервиса рекомендаций.
Пример Spark-скрипта (PySpark):
from pyspark.sql import SparkSession
from pyspark.sql.functions import sum, avg, max, min, col, to_date, window

spark = SparkSession.builder \
    .appName("FeatureEngineeringSales") \
    .getOrCreate()

# Источник:Lakehouse таблица transactions
df = spark.read.format("delta").load("/lakehouse/transactions")

# Пример признаков: агрегации по пользователю за последние 30 дней
df_with_features = df \
    .withColumn("date", to_date(col("timestamp"))) \
    .groupBy("customer_id") \
    .agg(
        sum("amount").alias("total_spent_30d"),
        avg("amount").alias("avg_order_value_30d"),
        count("*").alias("orders_30d")
    )

df_with_features.write.format("delta").mode("overwrite").save("/lakehouse/features/user_features_30d")
Применение в обучении:
- Обучационная выборка извлекается через offline-store (Delta таблицы) совместно с данными целевой переменной и временем.
- В качестве онлайн-слоя можно использовать сервис запросов к признакам в реальном времени.
Важно:
- Включение временных окон и временных меток так, чтобы совпадать с точкой обучения и временем запроса.
- Контроль версии признаков и совместимости с моделями.
Пример 3. Российские решения и локальные внедрения
Российские организации часто реализуют собственные решения по хранению и обработке признаков на базе популярной экосистемы, адаптированной под требования локальной инфраструктуры: Kerberos/LDAP, локальные сегменты сети, локальные хранилища (Hadoop/HDFS, ClickHouse, YDB), и интеграции в существующие конвейеры.
Архитектура типичного российского проекта:
- Offline признаков: Parquet/ORC в локальном Lakehouse либо в частном облаке (Яндекс.Облако, собственные дата-центры).
- Online признаков: ClickHouse или Redis на внутреннем кластере.
- Контроль доступа: Kerberos, TLS, ACL на уровне таблиц и API.
- Инструменты мониторинга: Prometheus + Grafana, алерты на качество данных.
- Интеграция: REST/gRPC API для обучения и инференса, с использованием сервисов аутентификации (OIDC/LDAP).
Пример реализации онлайн-слоя на российской инфраструктуре:
- Онлайн-слой: Redis cluster + безопасные соединения; кэш признаков с TTL и защитой.
- Data pipelines: Spark/Spark Structured Streaming на локальном кластере, интеграция с YDB/ClickHouse.
Пример кода: чтение признаков из оффлайн-таблиц и публикация в онлайн-слой (упрощённый пиратский пример):
# Псевдокод для локального размещения признаков
# Offline features: /lake/local/features/user_features_30d.delta
# Online store: Redis (secured)

import redis
import pyarrow as pa
import pyarrow.dataset as ds

# Подключение к онлайн-слою (Redis)
r = redis.StrictRedis(host='redis.local', port=6379, db=0, password='s3cr3t', decode_responses=True)

# Загружаем признаки из оффлайна - упрощённый пайплайн
dataset = ds.dataset("/lake/local/features/user_features_30d.delta", format="parquet")
table = dataset.to_table()
# Пропустим сложные преобразования и публикуем в Redis
for row in table.to_pylist():
    cust_id = row['customer_id']
    value = {
        'total_spent_30d': row['total_spent_30d'],
        'avg_order_value_30d': row['avg_order_value_30d'],
        'orders_30d': row['orders_30d']
    }
    r.set(f"feat:{cust_id}", str(value), ex=3600)  # TTL 1 час
Преимущества такого подхода:
- Соответствие локальным требованиям и регулятивным нормам.
- Контроль доступа и аудит на уровне инфраструктуры.
- Возможность перехода к более открытым решениям в будущем.
Важные заметки:
- В реальных проектах стоит уделить внимание консистентности между offline и online данными: event-time alignment, time travel и point-in-time correctness.
- Регулярное параллельное верифицирование признаков и контракты с дата-участниками.
Версионирование признаков и контракты
Каждому признаку нужна версия и бизнес-описание. Примеры контрактов:
- Название признака, тип данных (INT, FLOAT, STRING, TIMESTAMP).
- Единицы измерения и валидности (min/max, allowed_nulls).
- Период актуальности (time-to-live, обновление каждые n часов).
- Источник данных и путь к преобразованию.
В Repo Feature Store следует хранить:
- Метаданные признаков и версий (к примеру, в YAML/JSON).
- Ссылки на источники данных и SQL-запросы/Spark-выражения.
- Транзакционные логи об изменениях признаков.
Управление качеством и тестирование
- Unit-тесты для трансформаций признаков: проверка корректности аггрегаций, корректности работы функций.
- sanity checks: отсутствие нежелательных нулевых значений, корректные диапазоны, согласованность типов.
- Мониторинг качества признаков: распределение значений, Drift detection, alerting на падение качества признаков.
- Тесты на point-in-time correctness: проверка, что обучающие датасеты не используют признаки, завязанные на будущее.
Обеспечение безопасности и соответствия
- Аудит: журналирование доступа к признакам, изменениям в контракте признаков.
- Разграничение прав: прав доступа к offline/online хранилищам, а также к конкретным признакам.
- Защита конфиденциальной информации: маскирование или обфускация чувствительных признаков, например PII, PD(Protected Data).
Инструментарий и интеграции
Открытые решения (open-source):
- Feast (Feature Store) — управление признаками, лимит онлайн-по запросам, поддержка разных Online stores.
- Feathr — ещё одно open-source решение для feature store и управления признаками.
- Apache Spark + Delta Lake — базовые инструменты для оффлайн-хранилища признаков и динамических трансформаций.
Российские решения и адаптации:
- Локальные развёртывания Feast/Feathr в рамках частных облаков или локальных ЦОД, с интеграцией в Kerberos/LDAP и локальные хранилища (HDFS, ClickHouse, YDB).
- Интеграции с российскими системами мониторинга и безопасности, ограничение доступа, контроль версий и контрактов.
Резерв оборудования и стоимость: сбалансируйте затраты на хранение признаков, вычислительные ресурсы и сетевые задержки между offline и online слоями.
Риски и ограничения внедрения
- Дрейф признаков (Feature Drift): распределение признаков меняется во времени, что может повлечь ухудшение качества моделей. Регулярная переобучение и обновление признаков помогают снизить риск.
- Утечка данных (Feature Leakage): признаки могут случайно содержать информацию о целевой переменной, если в момент создания признаков уже видны будущие значения. Необходимо строгое управление временем и контрактами признаков.
- Неполная версия данных: несогласованность между offline и online данными может привести к неконсистентности поведения модели в обучении и инференсе.
- Масштаб и стоимость: lakehouse и feature store требуют инфраструктурной поддержки (хранение, вычисления, сеть). Неправильная архитектура может привести к перерасходу бюджета.
- Управление изменениями: без четкой процедуры выпуска изменений признаки легко попадают в продакшн несовместимыми. Вводится процесс «feature freeze», ревью и тесты.
- Безопасность и комплаенс: обработка персональных данных требует соблюдения локальных законов и регуляций, соответствие требованиям к защите данных, журналирование и аудит.
- Временные ограничения и latency: онлайн-слой с низкой задержкой может потребовать сложной архитектуры и дорогостоящих решений. Баланс между точностью и латентностью должен быть учтен на этапе проектирования.
- Совместная работа: различия в подходах аналитиков и data scientists, различная терминология и ожидания от интерпретации признаков. Важно внедрять общие процессы и документацию.
Выводы
- Подготовка признаков в Lakehouse — это не только создание исторических таблиц, но и системное управление качеством, версиями, контракты, lineage и безопасность.
- Эффективная архитектура признаков способствует ускорению экспериментов, повторному использованию признаков и снижению риск-ошибок в проде.
- Выбор паттернов (offline/online, time travel, versioning, governance) влияет на скорость разработки, точность модели и стоимость инфраструктуры.
- Практические примеры на Feast и Delta Lake показывают, как реализовать принципы на реальных данных: от определения признаков до их обслуживания в онлайн-сервисе.
- Российские решения в контексте локальных условий требуют адаптации: интеграция с локальными хранилищами, безопасность и соответствие требованиям, а иногда и локальные форк-реализации open-source инструментов.
FAQ (Вопросы и ответы)
1) Что такое "point-in-time correctness" и зачем он нужен в подготовке признаков?
- Это принцип согласования времени между признаками и целевой переменной на момент обучения. Без него модель может «учиться» на данных, которые уже содержат будущую информацию, что приводит к утечке и переобучению. Правильная реализация требует использования временных меток и корректной агрегации признаков по моменту времени.
2) Что такое feature store и какие задачи он решает?
- Feature store — централизованный репозиторий признаков с управлением версиями, контрактами и линейкой источников. Он решает задачи повторного использования признаков между проектами, ускорения обучения и инференса, обеспечения качества данных и аудита.
3) Какие преимущества использования онлайн–offline разделения признаков?
- Offline признаки подходят для обучения и аудита; онлайн признаки — для инференса в реальном времени. Разделение позволяет достичь баланса между точностью и задержкой, уменьшает риск ошибок в обучении и инференсе.
4) Какие риски связаны с утечкой признаков и как их избегать?
- Утечка может произойти, если признаки содержат информацию о целевой переменной, которая ещё не должна быть известна на момент предсказания. Чтобы избежать этого, нужно обеспечить строгую привязку признаков к точке времени, использовать point-in-time join и держать контракты знаков отдельно.
5) Какие примеры инструментов можно использовать в качестве open-source решений?
- Feast — один из ведущих open-source инструментов для feature store; Feathr — ещё одно решение. Они позволяют описывать признаки, интегрировать offline/online слои и обеспечивать повторяемость пайплайнов.
6) Какие российские особенности важно учесть при внедрении?
- Необходимо учитывать локальные требования к безопасности, регуляциям, использование локальных хранилищ (HDFS, ClickHouse, YDB), интеграцию с локальными системами аутентификации (Kerberos/LDAP) и мониторингом. Внедрение часто требует адаптации на уровне инфраструктуры и сетевой политики.
7) Каковы лучшие практики для управления версиями признаков?
- Введите явные версии признаков и контрактов, храните логи изменений, используйте фичи-флоу и фазы релиза (feature freeze, incremental rollout). Обязательно тестируйте обратную совместимость и регламентируйте миграции признаков.
8) Какие методы мониторинга качества признаков стоит использовать?
- Мониторинг распределения значений, пропусков, дрейф признаков, частоту обновления, задержку обновлений. Настройка алертов на резкие изменения распределения или падение полноты данных.
9) Какова роль тестирования в подготовке признаков?
- Тестирование на уровне трансформаций, валидация контрактов признаков, регрессионное тестирование пайплайнов и проверка точки времени. Тесты помогают предотвратить регрессии и ошибки, связанные с изменениями в источниках.
10) Какие шаги стоит предпринять для начала внедрения feature store в вашей компании?
- Определите бизнес-цели и набор целей по признакам; выберите базовый паттерн (offline/online, версия признаков); создайте MVP-пайплайн для нескольких проектов; внедрите контракты признаков и линейку данных; начните мониторинг качества и настройку алертов; постепенно масштабируйте с учётом требований к безопасности и регуляций.
Если вы рассматриваете переход к архитектуре Lakehouse, мы поможем оценить текущую data-инфраструктуру, спроектировать целевую архитектуру и подготовить поэтапный план внедрения. Узнайте больше о Lakehouse.


