

Поговорим об операторах JOIN
Работа с данными была бы намного проще, если бы мы имели дело только с одним набором данных. Но реальная жизнь такова, что нам приходится работать сразу с несколькими наборами данных, собранными из самых разных источников, при этом желательно, чтобы эти данные были между собой связаны. Однако прежде чем объединять данные, очень важно определиться с наиболее оптимальным типом объединения. В этой статье мы поговорим о самых распространенных операторах JOIN.
Типы операторов JOIN
По сути, существует только два способа объединения данных: горизонтальный и вертикальный. При горизонтальном объединении данных мы сопоставляем строки по одной или нескольким переменным (т. е. ключам), создавая более широкий набор данных (добавляя столбцы). При вертикальном соединении сопоставляются имена столбцов, а наборы данных наслаиваются друг на друга, в результате чего набор данных становится длиннее (добавляются строки). Объединения можно выполнять на разных языках программирования (например, SQL, R, Stata, SAS). Большая часть примеров, приведенных в этой статье, будет основана на языке R.
Горизонтальное объединение
Горизонтальное объединение данных или слияние данных может использоваться в самых разных случаях:
- Объединение данных, относящихся к разным объектам (опрос учащихся + оценка учащихся);
- Взаимосвязь данных во времени (опрос студентов осенью + опрос студентов весной);
- Объединение данных участников (оценка ученика + опрос учителя);
- Объединение данных с целью идентификации объектов (опрос студентов с указанием имени и фамилии + реестр студентов с указанием ID)
Существует несколько типов горизонтальных объединений. В этой статье мы обсудим объединения данных, которые увеличивают размер Вашего набора данных (более подробная информация доступна по ссылкe).

Итак, четыре основных типов горизонтального объединения данных:
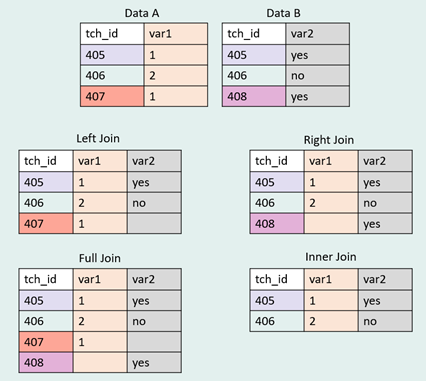
Left join
- В этом случае сохраняются все данные, хранящиеся в наборе данных слева. Все данные из набора данных слева объединяются с любыми совпадающими данными, которые существуют в наборе данных справа. Если в правом наборе данных имеются не совпадающие данные, тогда они не будут перенесены.
- Как правило, объединенный набор данных будет иметь такое же количество строк, как и наш исходный набор данных с левой стороны.
Right join
- В этом случае сохраняются все данные, хранящиеся в наборе данных справа. Все данные из набора данных справа объединяются с любыми совпадающими данными, которые существуют в наборе данных слева. Если в левом наборе данных имеются не совпадающие данные тогда, они не будут перенесены.
- Как правило, объединенный набор данных будет иметь такое же количество строк, как и наш исходный набор данных с правой стороны.
Full join
- В этом случае сохраняются данные из обоих наборов данных. Все данные, которые есть в одном наборе данных, но отсутствуют в другом, будут сохранены в конечном объединенном наборе данных.
Inner join
В этом случае сохраняются только те данные, которые присутствуют в обоих наборах данных. Если какие-либо данные есть в одном, но отсутствуют в другом наборе данных, то они не будут добавлены в объединенный набор данных.
При выполнении горизонтального объединения данных важно следовать главным правилам:
- Имена переменных не могут повторяться.
Это означает, что если в наборе данных опроса учащихся переменная называется gender, а в наборе демографических данных переменная также называется gender, то эти имена нужно будет скорректировать (например, district gender можно переименовать в d_gender). Более подробная информация доступна по ссылкe.
Это правило не распространяется на ключи с привязкой (например, ID исследования), которые часто в разных наборах обозначены одинаково.
- Каждый набор данных должен содержать ключ
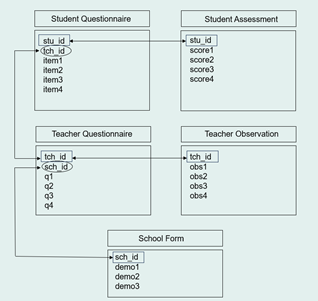
Существует два типа ключей, которые позволяют объединять файлы данных: первичные и внешние ключи. Каждый набор данных должен содержать первичный ключ, который однозначно идентифицирует строки в наборе данных. Наборы данных могут также включать и внешние ключи, которые содержат значения, связанные с первичным ключом в другой таблице. В то время как первичные ключи не могут содержать отсутствующие или дублирующиеся значения, для внешних ключей это допустимо.
Ключи обычно представляют собой одну переменную (например, ID исследования), но они могут включать и несколько переменных (например, имя + фамилия) - в этом случае они называются композитными ключами. На рисунке 2 первичные ключи обозначены прямоугольниками, а внешние ключи - овалами. Стрелки показывают, что данные могут быть объединены как через первичные, так и через внешние ключи.
Left Join
Пожалуй, это один из наиболее распространенных типов соединений. Данный тип соединения вполне может быть применен в самых различных случаях, но лучше всего он проявляет себя в случае деидентификации данных. Допустим, у нас есть набор данных анкеты учителя + набор данных реестра примеров.
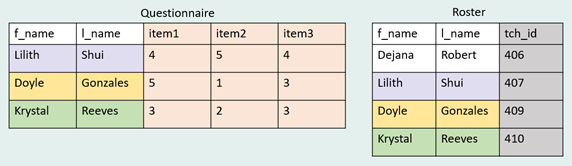
Мы хотим добавить идентификатор исследования (tch_id) в нашу анкету. Чтобы сделать это, мы можем соединить файл анкеты с файлом реестра, используя комбинированный первичный ключ (f_name и l_name). Это сработает на все 100%, если имена в файлах будут написаны одинаково.
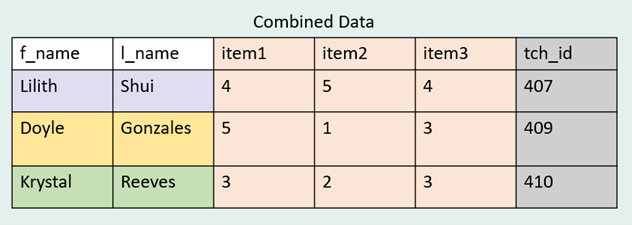
Мы видим, что в нашем объединенном наборе данных есть всего три строки, что как раз соответствует ожиданиям при использовании левого соединения. Дополнительная строка в нашем правом наборе данных не может быть перенесена.
Давайте попробуем выполнить это соединение с помощью языка R. Я предпочитаю объединять ключи сначала по фамилии, а затем по имени. В данном случае я также полностью деидентифицирую файл, удалив f_name и l_name после завершения процесса объединения. Кроме того, я е изменил порядок переменных, переместив tch_id на передний план.
library(dplyr)tch_svy |>left_join(tch_roster, by =c("l_name","f_name")) |>select(tch_id, item1, item2, item3)# A tibble: 3 x 4tch_id item1 item2 item3<dbl> <dbl> <dbl> <dbl>1 407 4 5 42 409 5 1 33 410 3 2 3
NB: Хотя, как правило, лучше всего, чтобы ключи в разных файлах имели одинаковые имена, в случае использования R Вы можете объединять данные, даже если ключи названы по-разному. Обратите внимание на пример, приведенный ниже, где имена переменных в опросе - f_name и l_name, а в реестре - first_name и last_name.
library(dplyr)tch_svy |>left_join(tch_roster, by =c("l_name"="last_name","f_name"="first_name")) |>select(tch_id, item1, item2, item3)# A tibble: 3 x 4tch_id item1 item2 item3<dbl> <dbl> <dbl> <dbl>1 407 4 5 42 409 5 1 33 410 3 2 3
Right Join
А что, если нам нужен набор данных с полной выборкой исследования, и нас не волнует, есть ли в нем пропущенные данные или нет? В этом случае мы можем использовать тот же сценарий, что и на рисунке 2, но вместо этого выполнить правое объединение (обратите внимание на то, что мы также можем просто изменить порядок наборов данных и снова использовать левое соединение). Теперь, когда мы объединим наборы данных по композитному ключу, мы получим следующее:
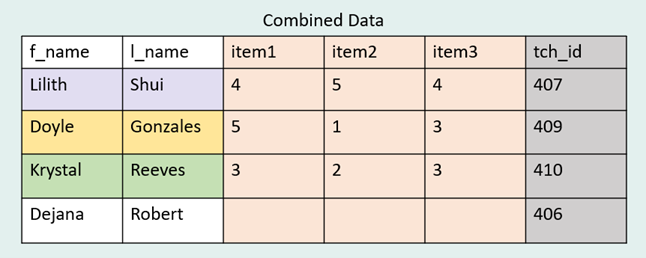
Опять же попробуем выполнить эту операцию, используя R:
library(dplyr)tch_svy |>right_join(tch_roster, by =c("l_name","f_name")) |>select(tch_id, item1, item2, item3)# A tibble: 4 x 4tch_id item1 item2 item3<dbl> <dbl> <dbl> <dbl>1 407 4 5 42 409 5 1 33 410 3 2 34 406 NA NA NA
Full Join
Данный тип объединения очень часто встречается в исследованиях. Представьте себе ситуацию, в которой Вы собираете несколько инструментов для нескольких участников или. У Вас могут отсутствовать данные по некоторым участникам (например, участник отсутствовал во время формирования одного из наборов данных), но Вы все равно хотите, чтобы все данные, которые Вы смогли собрать, появились в Вашем объединенном наборе данных.
Допустим, у Вас есть анкета студента + оценка студента и мы хотим, чтобы все данные из обеих форм присутствовали в нашем объединенном наборе данных.
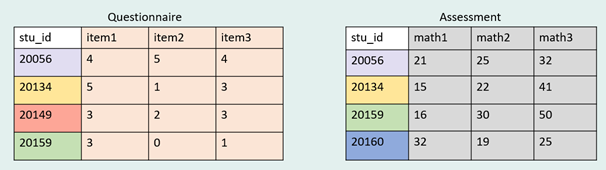
Если бы мы выполнили полное объединение этих двух наборов данных, используя в качестве ключа stu_id, мы бы увидели, что наш конечный набор данных будет содержать 5 строк. В каждом наборе данных есть одна строка, которой нет в другом наборе данных.
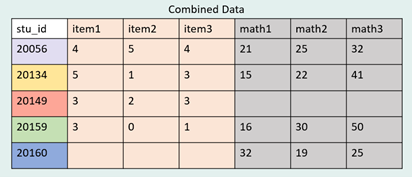
Как же будет выглядеть операция Join, написанная на R.
library(dplyr)stu_svy |>full_join(stu_assess, by ="stu_id")# A tibble: 5 x 7stu_id item1 item2 item3 math1 math2 math3<dbl> <dbl> <dbl> <dbl> <dbl> <dbl> <dbl>1 20056 4 5 4 21 25 322 20134 5 1 3 15 22 413 20149 3 2 3 NA NA NA4 20159 3 0 1 16 30 505 20160 NA NA NA 32 19 25
Inner join
Последний тип горизонтального объединения я лично использую не часто, но во многих случаях он просто незаменим. Например, необходимо объединить данные опроса «до» какого-либо события и «после».
Давайте рассмотрим пример использования данных предварительной анкеты + данных последующей анкеты.
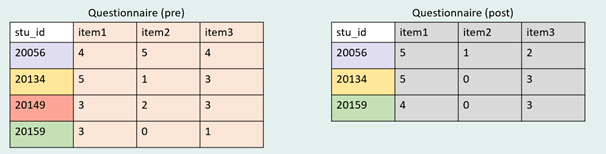
С помощью inner join мы можем объединить данные, снова используя ключ stu_id. Однако в этом случае наши переменные имеют одинаковые названия, что нарушает одно из 2 правил горизонтального соединения. Поэтому для того, чтобы создать уникальные имена переменных и связать каждую переменную с временной точкой сбора данных, мы должны сначала присоединить временной период к каждой повторяющейся переменной. Как именно назначить время, полностью зависит от исследователя (более подробная информация доступна по ссылкe). В данном случае я добавил слова "pre" и "post" в качестве префиксов.
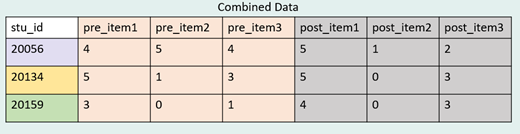
Мы видим, что наш объединенный набор данных показывает только три строки, потому что это единственные строки, для которых доступны данные как до, так и после проведения опроса.
Как inner join выглядит в случае использования языка R.
library(dplyr)# First rename variables with pre and post suffixstu_svy_pre <- stu_svy_pre |>rename_with(~paste0("pre_", .), .cols = -stu_id)stu_svy_post <- stu_svy_post |>rename_with(~paste0("post_", .), .cols = -stu_id)# Then join datastu_svy_pre |>inner_join(stu_svy_post, by ="stu_id")# A tibble: 3 x 7stu_id pre_item1 pre_item2 pre_item3 post_item1 post_item2 post_item3<dbl> <dbl> <dbl> <dbl> <dbl> <dbl> <dbl>1 20056 4 5 4 5 1 22 20134 5 1 3 5 0 33 20159 3 0 1 4 0 3
NB: inner join может быть использовано не только для продольных данных, его вполне можно использовать и в других случаях, о которых мы говорили выше. Аналогично, продольные данные можно объединить и с помощью любого типа операторов join, о которых мы говорили ранее.
Множество отношений
До сих пор мы обсуждали сценарии, при которых происходит слияние "один к одному".
Однако есть и другие сценарии. Например, нам нужно мы объединить информацию по группам участников (например, объединяем данные учеников с данными учителей или объединяем данные учителей с данными школ). В таких случаях один учитель часто связан с несколькими учениками, а одна школа - с несколькими учителями. Когда мы объединяем данные подобным образом, мы работаем с объединением "один ко многим" или "многие к одному", в зависимости от того, какой набор данных является первичным, а какой - вторичным. В этом случае мы должны увидеть повторяющиеся данные в нашем объединенном наборе данных.
Допустим, у нас есть анкета ученика + анкета учителя.
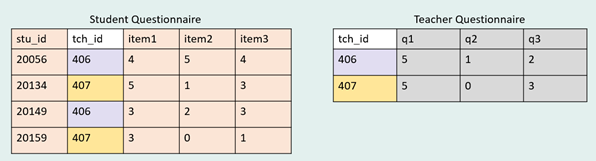
Мы можем объединить эти данные с помощью переменной tch_id, которая присутствует в обоих наборах данных. Однако при объединении это будет соединение "один ко многим" или "многие к одному" в зависимости от порядка расположения наборов данных и типа используемого соединения.
Допустим, мы используем left join, в котором слева находится набор данных анкет учеников, а справа - набор данных анкет учителей. В данном случае мы используем соединение "многие к одному", где каждый студент связан с несколькими преподавателями - два студента будут связаны с tch_id = 406 и два студента будут связаны с tch_id = 407.
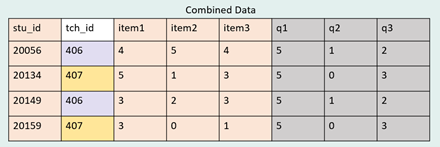
После объединения данных мы видим, что в наших данных есть четыре строки, как и ожидалось при использовании левого объединения, но информация об учителях, которую мы объединили, повторяется дважды для каждого tch_id.
NB: При выполнении объединения "один ко многим" правила объединения "слева" или "справа" не применяются. Например, если мы переместили наш набор данных учителей влево и выполнили left join, то теперь это будет объединение "один ко многим", при котором один учитель связан со многими учениками. В этом случае итоговый номер строки в объединенном наборе данных не будет соответствовать количеству строк в исходном наборе данных слева. Вместо этого он будет соответствовать количеству строк во многих наборах данных (т. е. набор данных на уровне учителя превратится в набор данных на уровне ученика). Таким образом, итоговое количество строк будет равно 4.
Выполним объединение слева от «многих к одному», используя язык R:
library(dplyr)stu_svy |>left_join(tch_svy, by ="tch_id")# A tibble: 4 x 8stu_id tch_id item1 item2 item3 q1 q2 q3<dbl> <dbl> <dbl> <dbl> <dbl> <dbl> <dbl> <dbl>1 20056 406 4 5 4 5 1 22 20134 407 5 1 3 5 0 33 20149 406 3 2 3 5 1 24 20159 407 3 0 1 5 0 3
NB: В dplyr версии 1.1.0 и выше был добавлен дополнительный аргумент relationship. Добавив этот аргумент в Ваше соединение и указав правильный тип (например, "один-ко-многим", "многие-к-одному", "один-к-одному"), Вы увидете ошибку, если выполненное соединение нарушает ограничения отношений. Более подробную информацию Вы найдете по ссылке.
Вертикальное объединение
NB: прежде всего я хотел бы поблагодарить нескольких специалистов, которые указали мне на то, что термин "вертикальное соединение" не является стандартным и может ввести читателей в заблуждение. Я признаю, что вертикальное расположение данных технически не считается объединением (определяемым как сопоставление строк набора данных по общему полю/ключу). Поэтому, если Вы читаете эту статью впервые, пожалуйста, имейте в виду, что в этом разделе я использую термин "объединение" для того, чтобы сформировать общее понимание различных способов объединения данных. Хотя, конечно, при выполнении "вертикальных соединений" более подходящими по смыслу терминами являются "добавление" или "суммирование" данных.
Итак, по аналогии с горизонтальными типами объединений существует множество типов вертикального объединения данных, которое также называется добавлением данных (или объединением в SQL):
- Объединение схожих данных в разных группах;
- Объединение схожих данных, собранных с разных сайтов или по различным ссылкам;
- Объединение схожих данных, собранных за определенный период времени.
Однако между горизонтальным и вертикальным объединением существует ряд принципиальных различий:
- Вместо того чтобы объединять данные по ключам, столбцы сопоставляются по наименованиям переменных;
- В этом случае уникальные имена переменных Вам не нужны. Необходимо, чтобы переменные были названы и отформатированы одинаково для всех наборов данных.
NB: не все формулировки совпадают по именам столбцов, некоторые из них совпадают по их порядку. Перед добавлением данных убедитесь, что Вы хорошо владеете языком, с которым собираетесь работать. Независимо от того, какую формулировку Вы используете, самым правильным решением является сохранение типов наборов данных, которые Вы планируете добавлять.
Рассмотрим пример, когда у нас есть анкета, собранная по двум группам учителей. Мы можем объединить эти данные, создав тем самым более длинный набор данных. Включение переменной группы позволит пользователям узнать, какие данные связаны с той или иной группой в рамках объединенных данных.
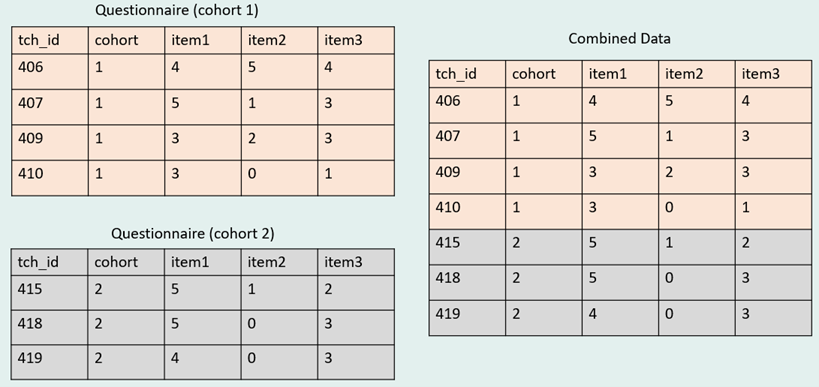
Давайте посмотрим, как этот тип соединения будет выглядеть на языке R.
Для начала убедимся в том, что имена и типы переменных в разных наборах данных одинаковы.
library(janitor)compare_df_cols(svy_c1, svy_c2)column_name svy_c1 svy_c21 cohort numeric numeric2 item1 numeric numeric3 item2 numeric numeric4 item3 numeric numeric5tch_idnumericnumeric
Имена и типы наших столбцов идентичны, так что все получилось, работаем дальше.
library(dplyr)bind_rows(svy_c1, svy_c2)# A tibble: 7 x 5tch_id cohort item1 item2 item3<dbl> <dbl> <dbl> <dbl> <dbl>1 406 1 4 5 42 407 1 5 1 33 406 1 3 2 34 407 1 3 0 15 415 2 5 1 26 418 2 5 0 37 419 2 4 0 3
NB: Если какие-либо переменные названы отформатированы в разных наборах данных по разному, при использовании функции bind_rows() Вы получите ошибку.
Можно также добавлять продольные данные. Например, если при анализе повторяющихся измерений данные должны быть представлены в длинном, а не в широком формате (как в случае с горизонтальными соединениями), продольные данные можно соединить по вертикали. В этом случае вместо того, чтобы присоединять временной компонент к переменным, изменяющимся с течением времени, к данным добавляется временная переменная для того, чтобы определить, какие строки относятся к тому или иному периоду времени. Как назначить временной компонент, зависит только от Вас. В данном случае я добавил переменную с именем wave и присвоил временным точкам числовые значения (более подробную информацию Вы найдете по ссылкe).
NB: даже если один набор данных содержит переменные, которых нет в другом наборе данных (например, переменная была добавлена в анкету позднее), добавление все равно будет работать при использовании bind_rows().
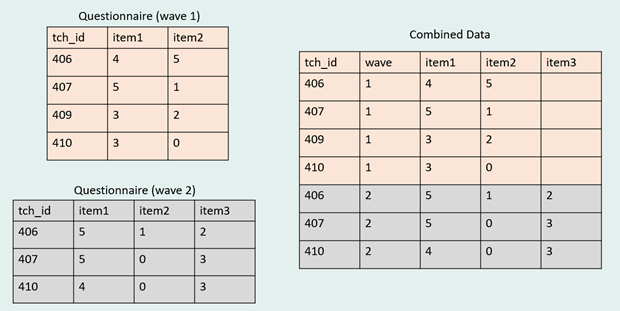
Как это выглядит на языке R:
library(dplyr)# First add a wave variablesvy_w1 <- svy_w1 |>mutate(wave =1)svy_w2 <- svy_w2 |>mutate(wave =2)# Then append databind_rows(svy_w1, svy_w2) |>relocate(wave, .after = tch_id)# A tibble: 7 x 5tch_id wave item1 item2 item3<dbl> <dbl> <dbl> <dbl> <dbl>1 406 1 4 5NA2 407 1 5 1NA3 409 1 3 2NA4 410 1 3 0NA5 406 2 5 1 26 407 2 5 0 37 410 2 4 0 3
NB: Обратите внимание на то, что tch_id больше не является уникальным идентификатором строк в нашем объединенном наборе данных. При добавлении продольных данных у нас есть композитный первичный ключ, который однозначно определяет строки (tch_id + wave)
Combining Join
В крупных исследованиях часто сочетаются горизонтальные и вертикальные объединения данных. Например, исследование, в котором объединяются два опроса для учителей для двух групп.
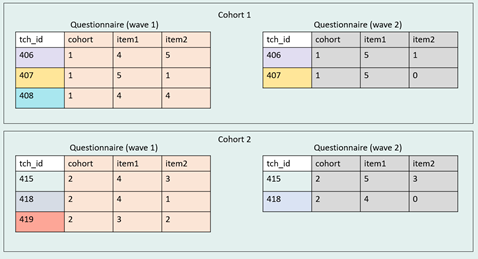
Эти данные можно комбинировать различными способами в зависимости от того, что именно Вы хотите. Как вариант, это могут быть следующие способы:
- Сначала выполните горизонтальное объединение внутри группы. В данном случае я решил выполнить Full join;
- Затем добавьте группы.
NB: Поскольку группа присутствует в обоих наборах данных и мы объединяем их по горизонтали, нам нужно принять решение о том, какую переменную группы оставить в full join. Мы не хотим оставлять обе группы не только потому, что это вызовет путаницу, но еще и потому, что они одинаково названы, а это нарушает одно из основных правил горизонтального соединения. В обоих случаях я исключил переменную cohort из правого набора данных, потому что левый набор данных содержит наиболее полную информацию. Но так будет далеко не всегда - в некоторых случаях Вам может понадобиться использовать правую часть или объединить информацию по обеим переменным в одну полную переменную.
1. Для начала присоединим группу 1.
library(dplyr)# First rename variables with wave 1 (w1) and wave 2 (w2) suffix# Also, drop cohort from the wave 2 datasettch_svy_w1_c1 <- tch_svy_w1_c1 |>rename_with(~paste0("w1_", .), .cols = -c(tch_id, cohort))tch_svy_w2_c1 <- tch_svy_w2_c1 |>rename_with(~paste0("w2_", .), .cols = -c(tch_id, cohort)) |>select(-cohort)# Then horizontally join across wavestch_svy_w1w2_c1 <- tch_svy_w1_c1 |>full_join(tch_svy_w2_c1, by ="tch_id")tch_svy_w1w2_c1# A tibble: 3 x 6tch_id cohort w1_item1 w1_item2 w2_item1 w2_item2<dbl> <dbl> <dbl> <dbl> <dbl> <dbl>1 406 1 4 5 5 12 407 1 5 1 5 03 408 1 4 4NANA
2. Затем присоединим группу 2.
# First rename variables with wave 1 (w1) and wave 2 (w2) suffix# Also, drop cohort from the wave 2 datasettch_svy_w1_c2 <- tch_svy_w1_c2 |>rename_with(~paste0("w1_", .), .cols = -c(tch_id, cohort))tch_svy_w2_c2 <- tch_svy_w2_c2 |>rename_with(~paste0("w2_", .), .cols = -c(tch_id, cohort)) |>select(-cohort)# Then horizontally join across wavestch_svy_w1w2_c2 <- tch_svy_w1_c2 |>full_join(tch_svy_w2_c2, by ="tch_id")tch_svy_w1w2_c2# A tibble: 3 x 6tch_id cohort w1_item1 w1_item2 w2_item1 w2_item2<dbl> <dbl> <dbl> <dbl> <dbl> <dbl>1 415 2 4 3 5 32 418 2 4 1 4 03 419 2 3 2 NA NA
3. Объединяем группы.
bind_rows(tch_svy_w1w2_c1, tch_svy_w1w2_c2)# A tibble: 6 x 6tch_id cohort w1_item1 w1_item2 w2_item1 w2_item2<dbl> <dbl> <dbl> <dbl> <dbl> <dbl>1 406 1 4 5 5 12 407 1 5 1 5 03 408 1 4 4NANA4 415 2 4 3 5 35 418 2 4 1 4 06 419 2 3 2NANA
NB: нам не обязательно объединять данные именно таким образом. Мы можем изменить порядок объединения данных или полностью изменить их структуру.
Давайте рассмотрим еще один пример объединения данных. У нас есть анкета учителя, собранная в два приема, и демографические данные на уровне школы, также собранные в два приема.
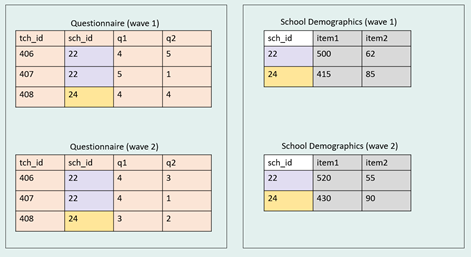
Опять же, мы можем объединить эти данные различными способами, но в данном случае мы сделаем следующее:
- Сначала объединим данные в длинный формат.
- Затем горизонтально объединим данные о школах с помощью left join.
1. Объединяем данные из набора данных, относящихся к учителю.
# First add a wave variabletch_svy_w1 <- tch_svy_w1 |>mutate(wave =1)tch_svy_w2 <- tch_svy_w2 |>mutate(wave =2)# Then appendtch_svy <-bind_rows(tch_svy_w1, tch_svy_w2) |>relocate(wave, .after = tch_id)tch_svy# A tibble: 6 x 5tch_id wave sch_id q1 q2<dbl> <dbl> <dbl> <dbl> <dbl>1 406 1 22 4 52 407 1 22 5 13 408 1 24 4 44 406 2 22 4 35 407 2 22 4 16 408 2 24 3 2
2. Объединяем данные из набора данных, относящегося к школе.
# First add a wave variablesch_w1 <- sch_w1 |>mutate(wave =1)sch_w2 <- sch_w2 |>mutate(wave =2)# Then appendsch_svy <-bind_rows(sch_w1, sch_w2) |>relocate(wave, .after = sch_id)sch_svy# A tibble: 4 x 4sch_id wave item1 item2<dbl> <dbl> <dbl> <dbl>1 22 1 500 622 24 1 415 853 22 2 520 55
<>4,"wave"))# A tibble: 6 x 7tch_id wave sch_id q1 q2 item1 item2<dbl> <dbl> <dbl> <dbl> <dbl> <dbl> <dbl>1 406 1 22 4 5 500 622 407 1 22 5 1 500 623 408 1 24 4 4 415 854 406 2 22 4 3 520 555 407 2 22 4 1 520 556 408 2 24 3 2 430 90
Дополнительные полезные материалы
Эта статья дает Вам лишь общее представление об операторах JOIN, это всего лишь отправная точка для тех, кто хочет погрузиться в эту тему глубже. Существует множество других типов Join, а также их комбинаций. В любом случае выбор того или иного типа полностью зависит от Ваших целей и требований (более подробная информация доступна здесь). Кроме того, если Вы уже умеете объединять данные, подумайте как следует, а нужно ли Вам это, не торопитесь! Наборы данных в формате плоского файла, часто используемые в исследованиях (например, CSV-файлы), можно легко хранить по отдельности. Я считаю, что это наиболее оптимальный вариант, поскольку он позволяет легче обновлять отдельные файлы и позволяет избежать потенциального объединения данных, которое в конечном итоге окажется бесполезным (более подробную информацию можно найти здесь).
Для более глубокого изучения данной темы рекомендую ознакомиться со следующими весьма полезными материалами:
- R для Data Science (2 издание)
- Data Carpentry: Объединяем таблицы
- R для HR
- Часто используемые глаголы


