Понимание модели согласованности Apache Iceberg, часть 1
Apache Iceberg - это последний формат таблиц, который я рассматриваю в этой серии сатей, и, пожалуй, самый широко распространенный и известный из всех форматов таблиц. Изначально я не собирался писать эту статью, так как считал, что книга «Apache Iceberg: Руководство» достаточно подробно раскрывает эту тему. Теперь же, изучив другие форматы, я вижу, что книга слишком продвинутая по сравнению с тем, о чем я рассказываю в этой серии. Поэтому мы немедленно приступаем к изучению внутреннего устройства Apache Iceberg, чтобы понять его базовую механику и модель согласованности.
Если Вам нужно более продвинутое понимание Iceberg, я настоятельно рекомендую книгу « Apache Iceberg: Руководство». Если же Вы просто хотите узнать о внутреннем устройстве путей чтения и записи, то добро пожаловать сюда.

Механика Apache Iceberg
Как и все форматы таблиц, Iceberg представляет собой одновременно спецификацию и набор вспомогательных библиотек. Спецификация стандартизирует способ представления таблицы в виде набора метаданных и файлов данных. Iceberg также определяет протокол для работы с этими файлами, обеспечивая при этом согласованность данных - этот протокол не полностью документирован в спецификации, но существует в самом коде Iceberg.
Файлы таблицы Iceberg делятся на слой метаданных и слой данных, которые хранятся в объектном хранилище, таком как S3. Разница с Iceberg заключается в том, что коммиты выполняются по отношению к компоненту каталога.
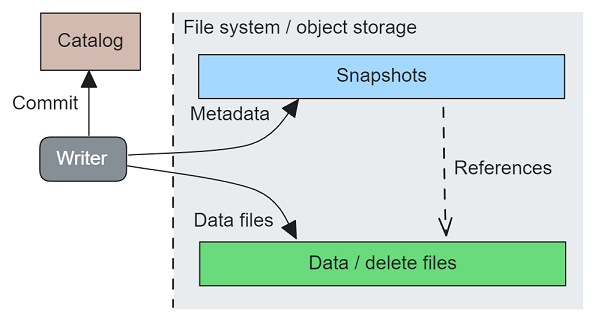
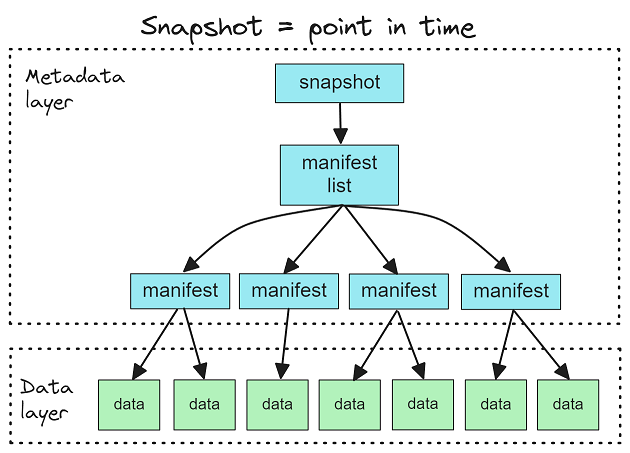
При каждой записи создается новый моментальный снимок, который представляет собой версию таблицы на данный момент времени. Снимок образует дерево файлов, которое вычислительная машина может прочитать для того, чтобы подробнее узнать обо всех файлах, составляющих таблицу. К файлам моментального снимка относятся:
- Файл manifest-list, который содержит одну запись для каждого файла манифеста, указывающую путь к его файлу и некоторые другие метаданные.
- Один или несколько файлов манифеста. Каждый файл манифеста содержит одну или несколько записей, ссылающихся на набор файлов данных - одна запись для одного файла данных.
- Один или несколько файлов данных (Parquet/ORC/Avro).
Сами по себе моментальные снимки не являются файлами, они хранятся в журнале снимков в корневом файле метаданных таблицы, на который, в свою очередь, ссылается каталог. При каждой записи создается новый файл метаданных, который включает новый снимок, связанный с этой записью.
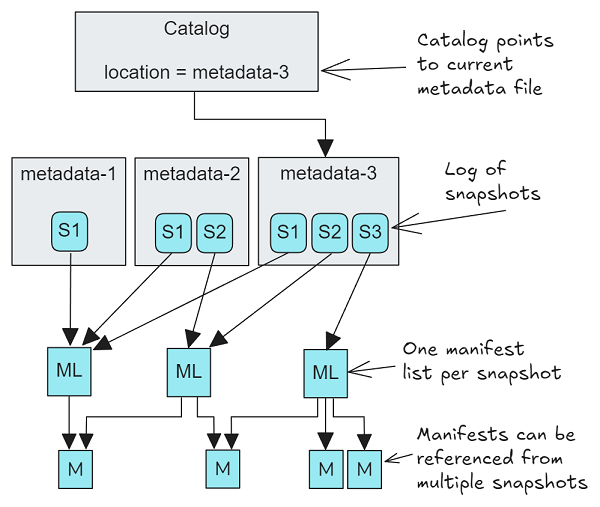
Операция записи фиксируется путем выполнения коммита каталога, представляющего собой атомарное сравнение и замену (CAS), когда записывающее устройство предоставляет текущее местоположение файла метаданных и новое, которое оно только что записало.
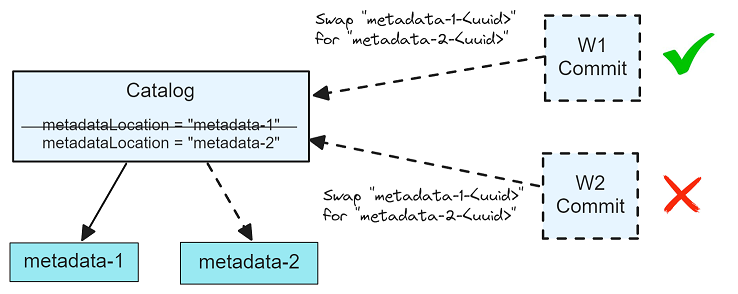
Эта операция CAS является частью основ согласованности в Apache Iceberg, но ни в коем случае не единственным компонентом.
Простой пример записи моментальных снимков
Рассмотрим простой пример, в котором три операции вставки приводят к трем снимкам. В таблице есть один столбец «fruit».
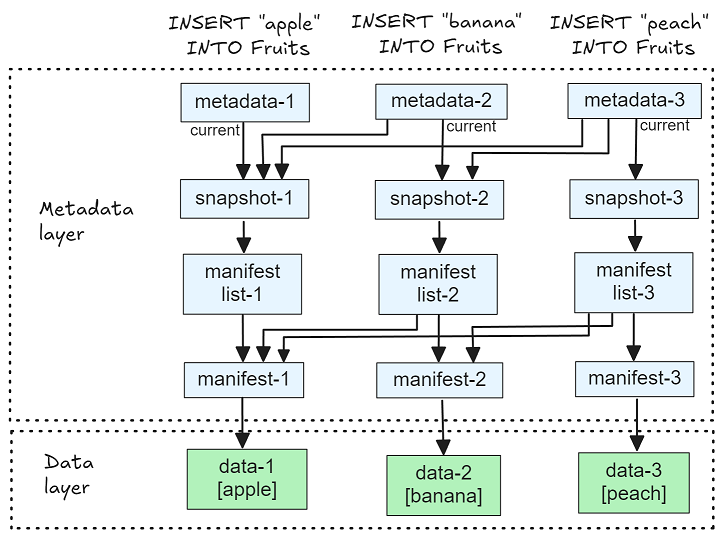
Обратите внимание на то, что финальный файл метаданных - metadata-3, который содержит все три снимка, список манифестов третьего снимка также содержит все три файла манифестов. Файлы метаданных имеют целочисленный суффикс (представляющий версию таблицы), но файлы манифеста и списка манифестов не имеют целочисленных суффиксов (как показано здесь). Это простое логическое представление (целые числа легче читать, чем длинные произвольные имена файлов).
Однако в Iceberg мы не только добавляем файлы с данными, но также и удаляем их. Iceberg отслеживает добавление и удаление файлов через свои файлы манифеста.
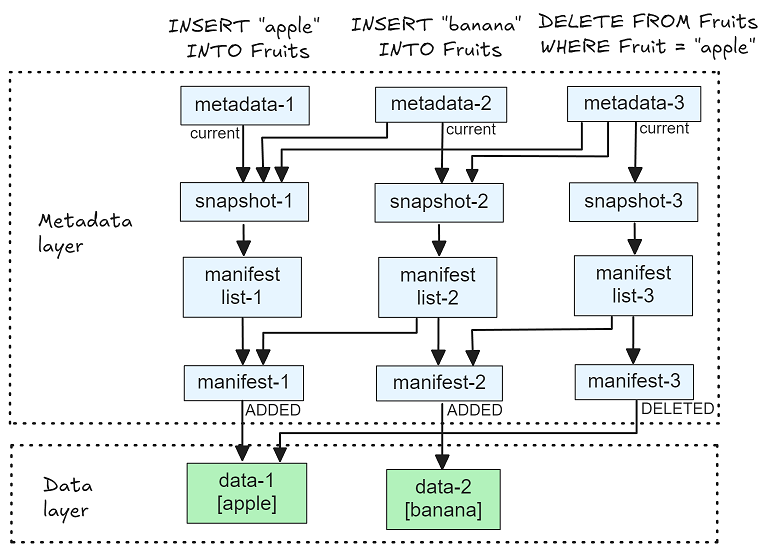
Однако в Iceberg мы не только добавляем файлы с данными, мы также можем удалять файлы. Iceberg отслеживает добавление и удаление файлов через свои файлы манифеста
Стоит разобраться в статусах ADDED и DELETED более подробно. Это нужно для того, чтобы мы могли представить себе, как именно вычислительные машины отслеживают добавление и удаление файлов.
Отслеживание добавлений и удалений файлов (подробнее некуда)
Все форматы таблиц предоставляют вычислительным машинам возможность узнать, какие именно файлы данных были добавлены и удалены в различных моментальных снимках. Iceberg делает это через свои файлы манифеста. При первом прочтении это может быть непонятно, но, надеюсь, с помощью диаграмм все станет ясно.
Каждый файл манифеста содержит (среди прочего):
- поле added_in_snapshot, определяющее, в какой моментальный снимок был добавлен манифест.
- список записей манифеста (одна запись для одного файла данных). Каждая запись имеет статус ADDED, EXISTING или DELETED, который применяется в контексте моментального снимка, указанного в поле added_in_snapshot.
Программа чтения манифестов в библиотеке Iceberg возвращает логическую версию каждого физического манифеста, которая может содержать изменения статуса записей манифеста (некоторые записи манифеста могут быть полностью отфильтрованы).
Например:
- Все записи со статусом =ADDED, добавленного в предыдущем снимке, преобразуются в EXISTING.
- Любые записи со статусом=DELETED, добавленного на предыдущем снимке, полностью отфильтровываются.
Если операция записи удаляет какие-либо записи из логического манифеста, он переписывается в новый файл манифеста как часть операции записи. Файлы манифеста неизменяемы, поэтому изменения приводят к записи нового файла для новой версии таблицы. Оригинальный манифест останется неизменным для предыдущих версий таблицы, на которые можно ссылаться.
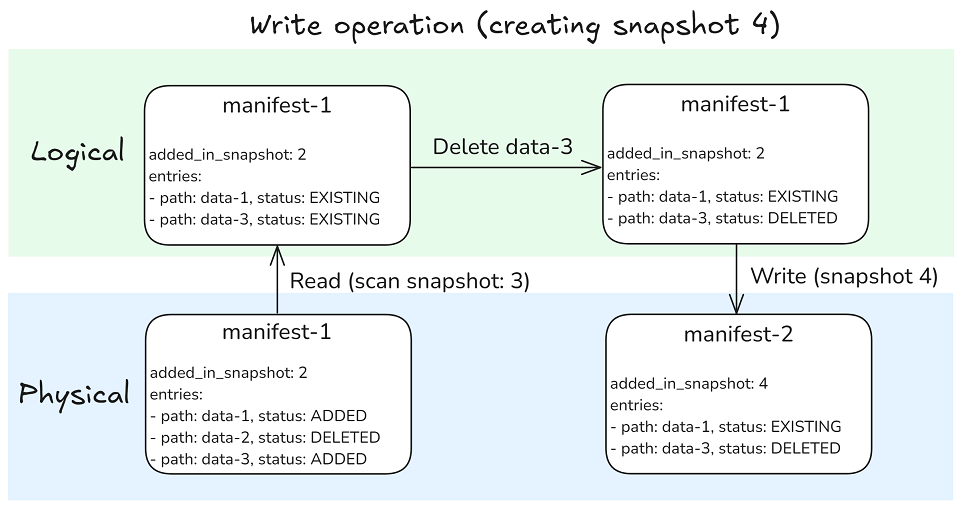
Рассмотрим пример с несколькими моментальными снапшотами:
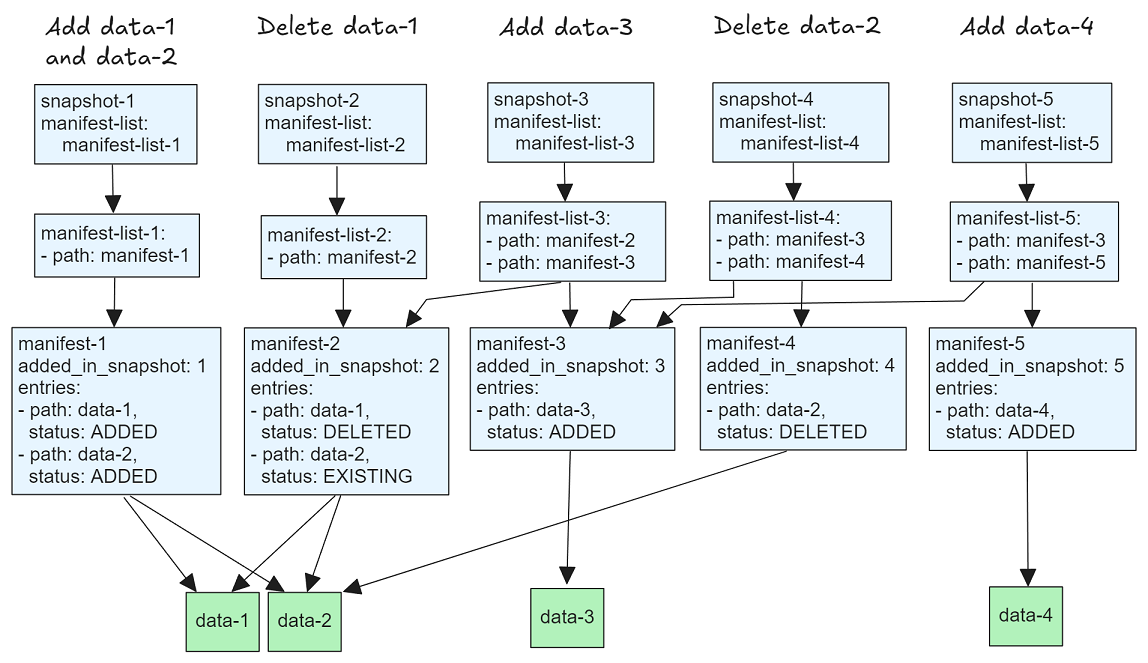
1.Снапшот-1 добавляет данные-1 и данные-2.
- Манифест-1 записыаается с учетом данных-1 и данных-2 как ADDED.
- Новый manifest-list - [manifest-1].
2. Снапшот - 2 удаляет данные-1.
- Манифест-1 затронут удалением данных-1. Манифест записан как новый файл, manifest-2, статус данных-1 изменен на DELETED, статус данных-2 – на EXISTING, и added_in_snapshot=2.
- Новый manifest-list - [manifest-2].
3. Снапшот-3 добавляет данные-3.
- Манифест-3 создан с помощью данных-3 как ADDED.
- В манифесте-2 не было никаких изменений файлов, поэтому он остается таким же.
- Новый manifest-list - [manifest-2, manifest-3].
4. Снапшот-4 удаляет данные-2.
- Манифест-2 затронут этим удалением, поэтому он записан как новый файл, манифест-4, содержащий данные-2 как DELETED, данные-1 не добавляются (поскольку они были удалены в снапшоте 2).
- Манифест-3 не затронут никакими изменениями, он остается прежним.
- Новый manifest-list - [manifest-3, manifest-4].
5. Снапшот-5 добавляет данные-4.
- Манифест-3 не затронут, он остается без изменений.
- Манифест-4 содержит только одну запись DELETED и поэтому не включен в этот новый снапшот.
- Манифест-5 записывается с данными-4 в качестве ADDED.
- Новый manifest – list - [manifest-3, manifest-5].
Возможно, это более подробная информация, чем Вы ожидали, но в какой-то момент я понял, что мне нужно разобраться во всем этом для того, чтобы понять, как вычислительные машины могут отслеживать, какие именно файлы были добавлены и удалены в каждом моментальном снимке.
Copy-on-write и merge-on-read
У Iceberg есть два режима для работы с обновлениями на уровне строк, такими как команды DELETE, MERGE и UPDATE в SQL:
- Copy-on-write: изменения на уровне строк приводят к перезаписи файлов данных.
- Merge-on-read: изменения на уровне строк приводят к записи новых файлов, которые должны быть объединены при чтении.
Обратите внимание на то, что Вы можете настроить операции UPDATE, DELETE и MERGE на использование COW или MOR по отдельности. Например, Вы можете использовать MOR для обновлений и удалений, а COW - для слияния. Это означает то, что таблица не является ни COW, ни MOR, но может представлять собой комбинацию этих двух типов.
Copy-on-write (COW)
В режиме copy-on-write любые операции, которые обновляют или удаляют строку в файле данных, приводят к перезаписи всего файла данных.
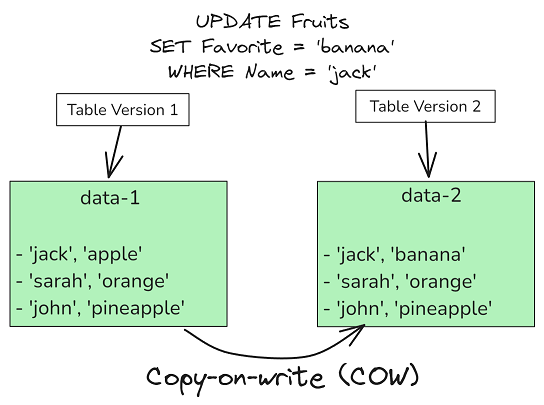
В результате мы получаем следующие метаданные:
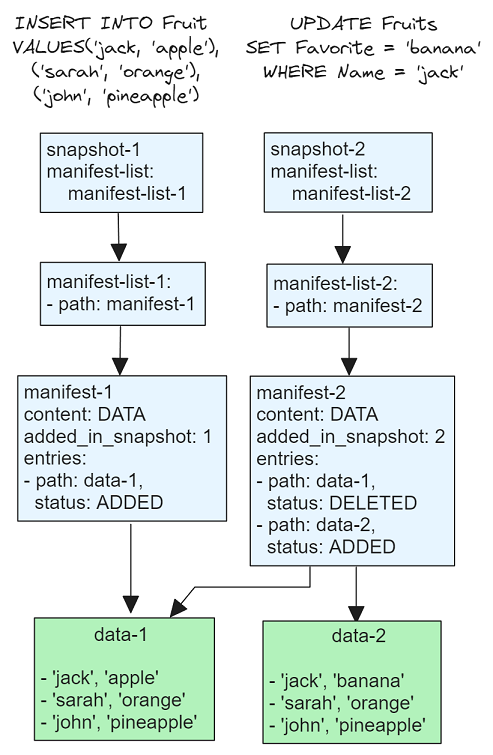
Copy-on-write отлично подходит для повышения эффективности чтения, но может быть проблематичным для нагрузок с большим количеством обновлений из-за большого усиления записи, которое возникает при переписывании целых файлов данных, когда необходимо изменить подмножество строк.
Merge-on-read – удаление по позиции
В Iceberg v2 появилось merge-on-read (MOR) с двумя вариантами: удаление по позиции и удаление по равенству. Идея MOR заключается в том, чтобы обновления и удаления на уровне строк только добавляли файлы новостей и ничего не переписывали.
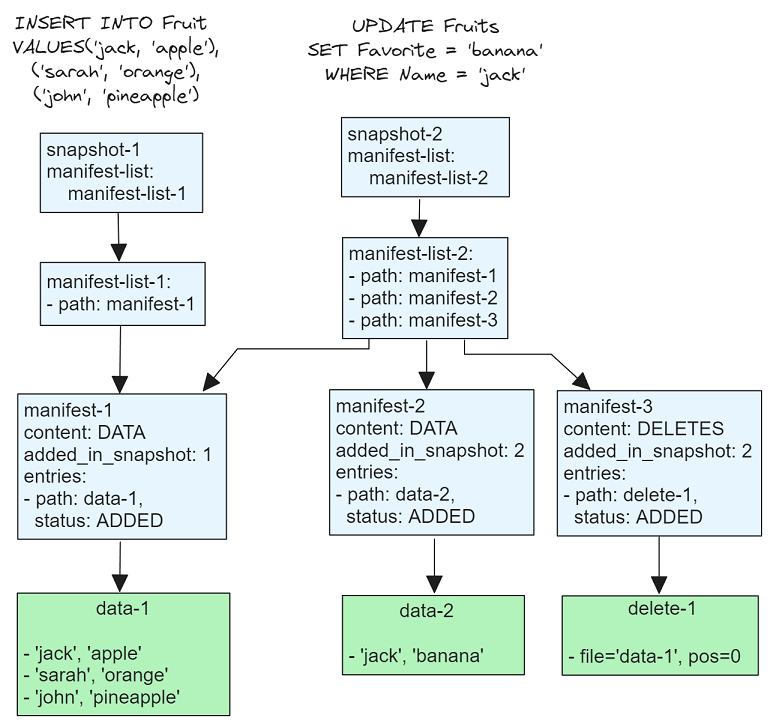
Удаление по позиции работает путем логического удаления строк, которые были признаны недействительными в результате операции удаления или обновления, путем добавления файлов удаления, которые ссылаются на файл данных и порядковую позицию недействительной строки. Используя предыдущий пример, UPDATE приводит к следующему:
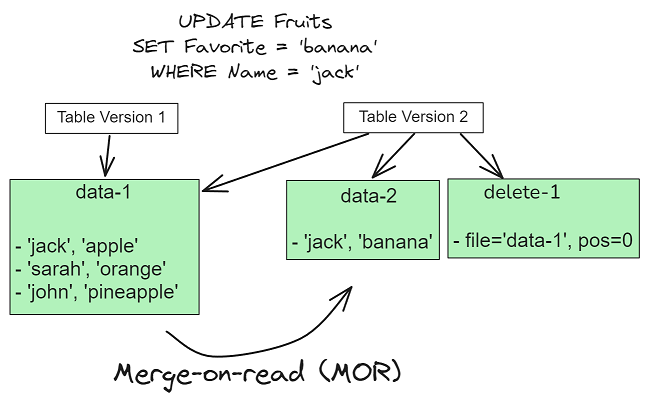
Читатель сначала загружает файлы удаления, а затем файлы данных. Устройство чтения данных пропускает все строки, на которые были ссылки в файле удаления.
С добавлением файлов удаления я должен внести некоторые изменения в метаданные:
- Файлы манифеста содержат либо файлы данных, либо файлы удаления. Каждый файл манифеста содержит поле «содержимое», которое имеет значение 0 (DATA) или 1 (DELETES).
- Файл списка манифестов указывает на то, является ли каждый файл манифеста в его списке файлом данных или файлом удаления.
Файлы данных и удаления разделены в специальных файлах манифеста для того, чтобы вычислительные машины могли сначала загрузить файлы удаления, а затем просканировать файлы данных.
MOR с удалением по позициям решает проблему усиления записи в таблицах COW и при этом обеспечивает относительно эффективное чтение. Пропуск строк на пути к файлу и порядковой позиции является дешевым способом обработки данных, а количество удаляемых файлов нужно обязательно контролировать с помощью уплотнения (подробнее об этом мы поговорим позже).
Merge-on-read – удаление по равенству
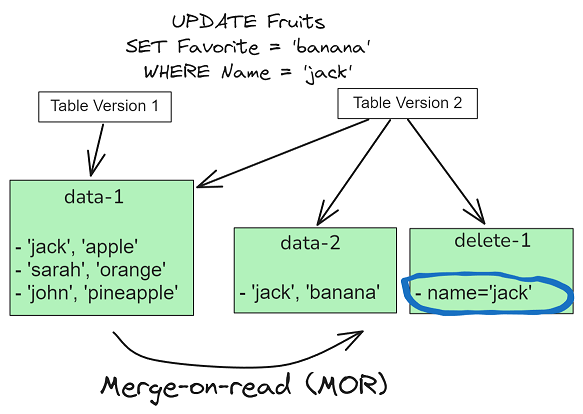
Одна из проблем с удалением по позициям заключается в том, что вычислительный движок должен знать файлы данных и позиции удаляемых строк. Другой вариант - указать предикат равенства и позволить читателям фильтровать строки на его основе. Это может значительно удешевить запись, поскольку больше нет необходимости в предварительном чтении или управлении своего рода локальным кэшем с информацией о соответствии данных путям к файлам и позициям строк. Основным недостатком этого способа является то, что чтение становится гораздо дороже, поскольку читатели должны оценивать каждую строку на соответствие всем допустимым удалений по равенству. Для снижения количества таких удалений рекомендуется агрессивное уплотнение (подробнее об уплотнении мы поговорим чуть позже).
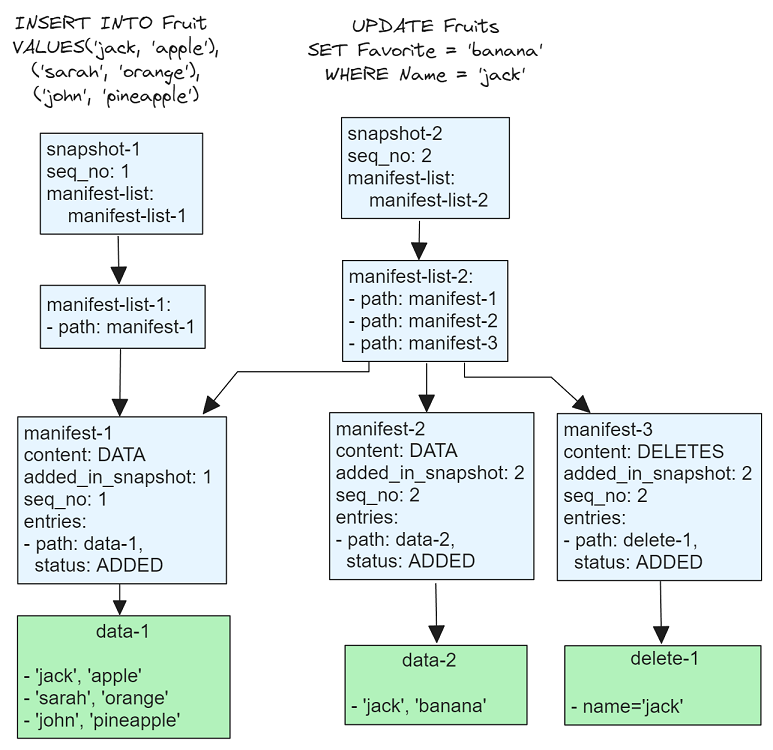
Используя пример UPDATE еще раз, мы получим следующее:
Более подробно о номерах последовательностей я расскажу во второй части, когда буду рассматривать саму модель согласованности. Пока же просто запомните, что порядковые номера определяют область действия файлов данных, к которым применяется удаление по принципу равенства. Любая строка файла данных с более высоким порядковым номером, чем номер равенства, не будет отфильтрована.
Уплотнение данных
Уплотнение - это переписывание множества маленьких файлов в меньшее количество больших файлов. Существует два типа уплотнения: уплотнение данных и уплотнение манифеста.
Целями уплотнения файлов данных являются:
- Сокращение количества файлов:
- Сокращение количества файлов данных, которые должны быть загружены во время чтения.
- Сокращение количества файлов удаления, которые должны применяться во время чтения.
- Улучшение локализации данных:
- Применение кластеризации данных для повышения эффективности чтения.
Обычно уплотнение не выполняется над всей таблицей за один раз, поскольку, как правило, таблица слишком велика для этого. Поэтому задания уплотнения выполняются несколько раз через определенные промежутки времени и охватывают определенный временной отрезок, например последний час.
Сокращение количества файлов
Если не очищать удаленные файлы на регулярной основе, будет расти стоимость чтения (по мере увеличения количества удаленных файлов).
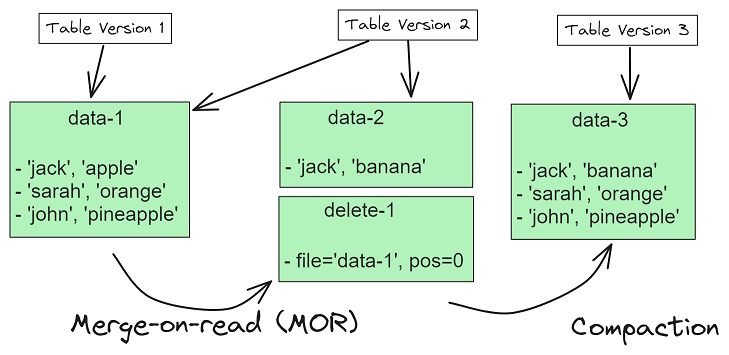
При уплотнении входные данные и удаленные файлы переписываются в новые файлы данных.
Локализация данных с помощью сортировки/кластеризации
Вычислительные движки выполняют планирование запросов на основе статистики файлов, например, минимальных/максимальных значений столбцов в файле. Эта файловая статистика хранится в файлах манифеста, что позволяет планировщикам запросов основывать план исключительно на файлах метаданных. Когда данные записываются без учета сортировки по файлам данных, статистика файлов может оказаться не очень полезной - важны физическое расположение и распределение данных. Однако, когда данные сортируются по набору файлов, файловая статистика может быть использована вычислительными машинами для более агрессивной обрезки файлов данных. Обрезка - это концепция исключения подмножества файлов из плана запроса путем определения того, какие файлы данных не могут содержать данные, относящиеся к запросу (и, следовательно, их вообще не нужно читать).
В качестве примера представьте два набора файлов, содержащих столбцы Name и FavoriteColor; один набор не упорядочен по файлам, а другой отсортирован по столбцу Name.
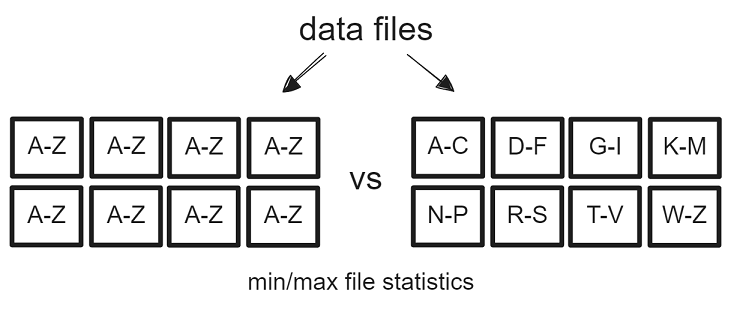
Отсортированные файлы имеют значения min/max, которые полезны для планировщика запросов. Если в запросе используется предикат WHERE Name = 'jack', планировщик будет знать, что только один файл данных из набора справа может содержать совпадающую строку. Однако планировщик определит, что любой из файлов слева может содержать совпадающие строки, и все они должны быть загружены и просканированы.
Стратегии уплотнения Iceberg
Учитывая все вышесказанное, Apache Iceberg использует три стратегии уплотнения:
- Двумерная упаковка:
- Эффективное уплотнение.
- Кластеризация никоим образом не влияет на чтение.
- Сортировка:
- Более дорогостоящее уплотнение.
- Кластеризация положительно влияет на чтение.
- Z-упорядочивание:
- Более дорогостоящее уплотнение.
- Более эффективная кластеризация оказывает положительное влияние на чтение.
У меня был соблазн написать о стратегиях уплотнения более подробно, но поскольку эта статья посвящена модели согласованности Iceberg, мы не будем углубляться в эту тему.
Партиционирование
Стратегии уплотнения позволяют пользователям группировать данные для повышения производительности чтения, но это не единственный способ сделать это. Таблица может быть разбита на разделы по одному или нескольким столбцам (и преобразованиям) - так называемая спецификация раздела. Вычислительный движок должен записывать строки в файлы данных в соответствии со спецификацией раздела. Это еще один шаг за пределы кластеризации через уплотнение, поскольку данные из разных разделов никогда не смешиваются.
Iceberg делает большой акцент на своем разделении на основе преобразований, которое он называет скрытым разделением. Идея заключается в том, что вместо того, чтобы заставлять пользователей создавать столбец-разделитель, например, столбец для хранения дня в столбце временной метки, можно использовать преобразование day(col). Существуют и другие преобразования, основанные на времени: час, месяц, год. Пользователям, которые пишут запросы и фильтруют по столбцу временной метки, не нужно знать или заботиться о том, что таблица разбита на разделы на основе часа/дня/месяца/года этой временной метки. Разбиение можно изменить с часового на дневное, не переписывая никаких файлов данных и не изменяя никаких запросов. Другие преобразования - truncate(col, length), которое, по сути, является подстрочной операцией, и bucket(n, col), которое использует хэш-функцию для распределения данных по n бакетам.
Эволюция разделов - интересная тема. Поскольку партиционирование может быть основано на преобразованиях, можно эволюционировать спецификацию раздела, переходя от более подробной схемы к более грубой, не переписывая файлы данных. Например, изменение спецификации раздела с hour(col) на day(col) требует только переписывания метаданных, но не файлов данных.
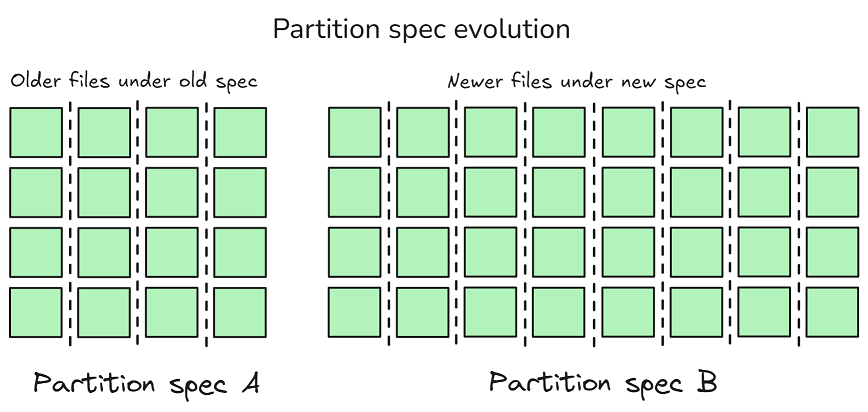
Но в случаях, когда нужно переписывать файлы, Вы можете оставить текущие данные в соответствии со старой спецификацией и применить новую спецификацию разделения к новым данным. Вычислительным движкам нужно будет просто запросить один набор файлов, основанный на спецификации 1-го раздела, и один набор файлов, основанный на спецификации 2-го раздела. Это позволит избежать необходимости переписывать большие объемы данных.
Простая логическая модель пути записи с контролем параллелизма
Apache Iceberg поддерживает сразу несколько одновременных писателей с настраиваемыми уровнями изоляции Serializable или Snapshot. Мы подробно рассмотрим контроль параллелизмаи обнаружение конфликтов во второй части (выйдет в самое ближайшее время), поэтому в этой части мы просто рассмотрим путь записи и контроль параллелизма на высоком уровне.
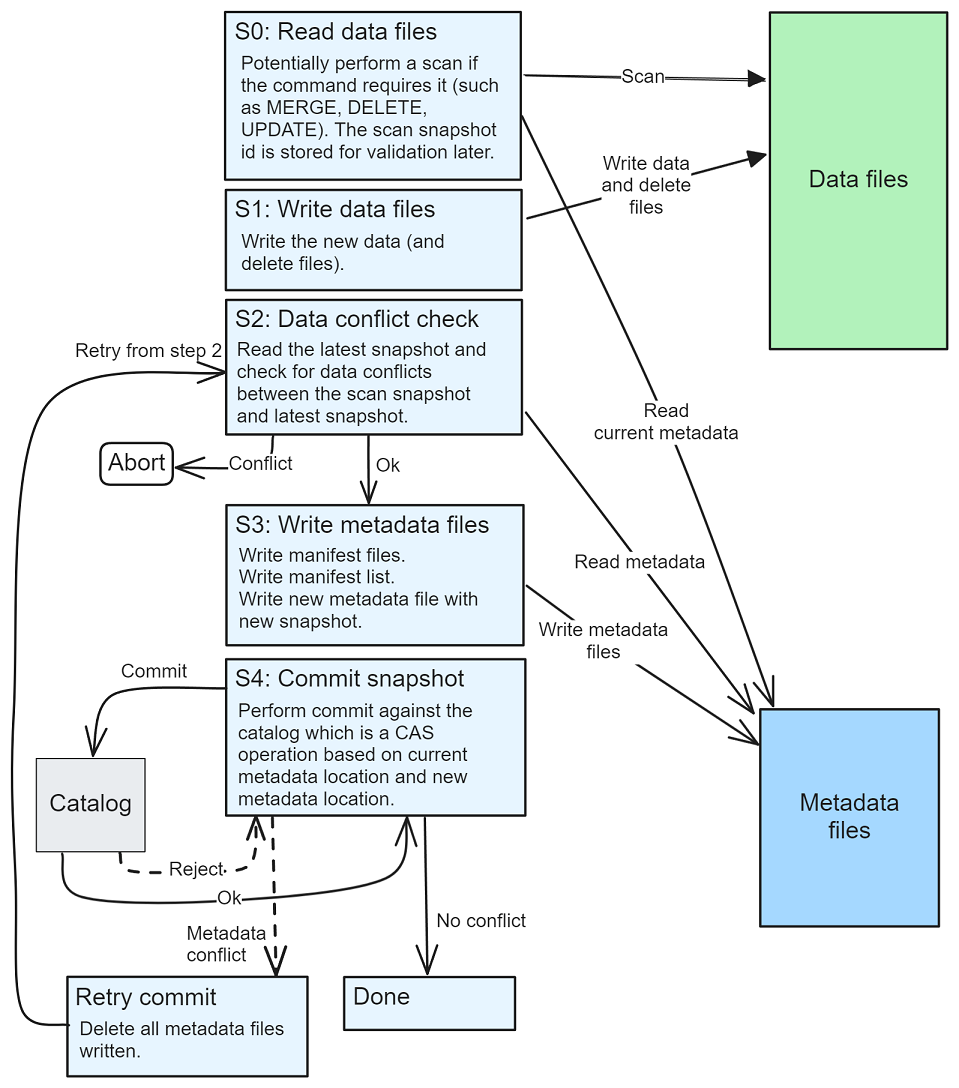
Если Вы уже читали посты Apache Hudi и Delta Lake, то согласитесь, что в общих чертах эти шаги очень похожи. Сначала записываются файлы данных, а затем происходит процесс записи и попытки коммитов файлов метаданных. Запись будет успешной, если нет ни конфликта данных, ни конфликта коммита метаданных.
Iceberg отличается от Hudi и Delta Lake спецификой, которую мы подробно рассмотрим во второй части. Пока же я отмечу следующее:
- Проверки конфликтов данных выполняются перед попыткой коммита, а в случае Delta Lake и Hudi - только после конфликта снапшотов.
- Iceberg не зависит от наличия (или отсутствия) PutIfAbsent в хранилище объектов. Delta Lake и Hudi выполняют коммит путем записи файла снапшота в журнал (Delta Log / Timeline). Несколько писателей могут перезаписывать друг друга без PutIfAbsent или блокировки. Iceberg записывает файл метаданных с UUID в имени (в дополнение к версии таблицы), что предотвращает перезапись файла метаданных. Писатели также фиксируют новый файл метаданных, выполняя коммит по отношению к каталогу, который должен выполнить атомарное сравнение и замену местоположений файлов метаданных.
Основное отличие Iceberg от других форматов таблиц с точки зрения модели согласованности заключается в характере проверок на конфликт данных. Если библиотеки Delta Lake и Hudi берут на себя ответственность за выполнение необходимых проверок на конфликт данных, то основная библиотека Iceberg просто предоставляет ряд проверок, которые вычислительные движки могут использовать или нет. Правильное применение этих проверок зависит от конкретного вычислительного движка. Возможно, я обнаружил проблему с Apache Spark, который, похоже, не задействует все необходимые проверки в одном типе операций. Этот вопрос остается открытым, так что мы еще посмотрим, прав я или нет. Как бы то ни было, разработчикам вычислительных движков нужно будет особенно внимательно относиться к проверкам данных, которые они включают для того, чтобы избежать аномалий согласованности данных.
Сопоставление операций COW и MOR с кодом Iceberg
Для тех, кто заинтересован в чтении кода Apache Iceberg, хорошим вариантом будет интерфейс Table в модуле API, который предлагает сразу несколько различных операций записи в таблицу, которые может использовать вычислительный движок:
- AppendFiles (модуль API)
- Для добавления новых файлов.
- Поставляется с двумя реализациями: FastAppend и MergeAppend. FastAppend просто добавляет новые файлы манифеста к снапшоту. Недостатком такого поведения является то, что без уплотнения файлов манифеста их количество будет расти. MergeAppend добавляет новые файлы манифеста и дополнительно выполняет слияние существующих файлов манифеста для того, чтобы держать количество файлов манифеста под контролем. Spark использует FastAppends для потоковой записи и MergeAppend для пакетной записи. Flink использует MergeAppend для потоковой записи.
- OverwriteFiles (модуль API)
- Для операций копирования при записи, выполняющих изменения на уровне строк (UPDATE, DELETE, MERGE).
- Реализация:BaseOverwriteFiles (основной модуль).
- RowDelta (модуль API)
- Для операций слияния при чтении, которые выполняют изменения на уровне строк (UPDATE, DELETE, MERGE).
- Реализация:BaseRowDelta (основной модуль).
- RewriteFiles (модуль API)
- Для уплотнения
- Реализация: BaseRewriteFiles (основной модуль).
Главные части процесса коммита находятся в методе commit класса SnapshotProducer.
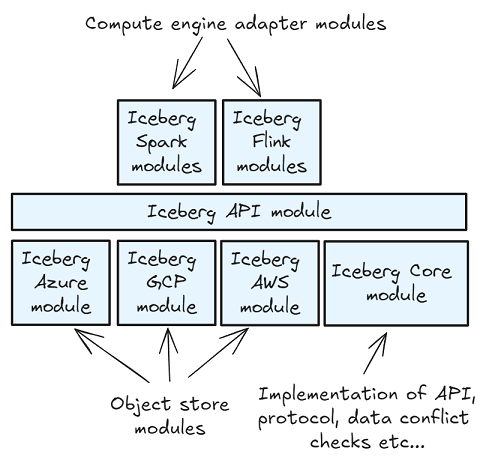
Проект Iceberg содержит множество модулей, но наиболее интересными для Вас будут следующие: