

Потоковые платформы: Kafka и экосистемы
Потоковые платформы стали основой современного хранилища данных по архитектуре EDA (Event Driven Architecture). В рамках курса по построению хранилища данных с учетом принципов Event-Driven мы уделяем особое внимание Kafka и экосистеме распознавания и обработки потоков данных. Эта глава предназначена для новичков: здесь подробно объясняется что такое потоковые данные, зачем нужна потоковая платформа, какие термины и методологии лежат в основе Kafka, какие решения существуют в открытом мире и на российском рынке, как устроены типовые архитектуры и какие риски сопровождают внедрение. Мы рассмотрим теорию и практику — от базовых концепций до конкретных примеров развёртывания и эксплуатации, включая открытые решения и российские сервисы, а также разберем ограничения и способы их минимизации. В завершении — блок вопросов и ответов, помогающий закрепить материал и быстро ориентироваться в типичных сценариях.
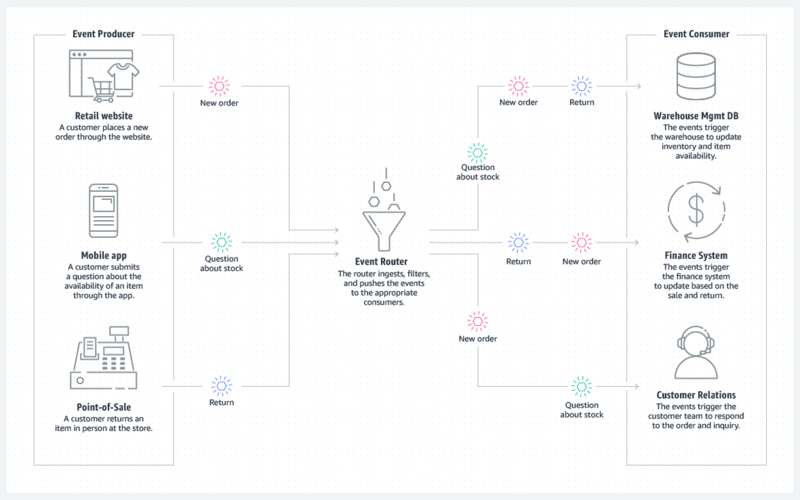
Потоковые данные и концепции
Потоковые данные — это данные, которые создаются и передаются непрерывно во времени в виде событий. У каждого события есть временная метка, идентификатор источника и полезная нагрузка (payload). Основная идея EDA состоит в том, что эти события служат триггерами для реактивных действий: обновления в аналитике, синхронизация данных между системами, инициирование процессов.
Главные понятия потоковой платформы:
- Потоки и события: поток — непрерывная последовательность событий; событие — единичный факт, например «покупка совершена» или «изменение статуса заказа».
- Продюсер и консюмер: продюсер публикует события в тему (topic); консюмер читает события из темы.
- Топик: логическая очередность, разбитая на разделы (partition). Каждый раздел хранится как последовательность записей и обеспечивает параллелизм обработки.
- Разделы (partitions) и фактор репликации (replication factor): разделы позволяют масштабировать обработку; репликация обеспечивает отказоустойчивость.
- Смещение (offset): номер позиции в разделе, который потребитель прочитал последним. Группа потребителей позволяет параллельную обработку и совместное распределение смещений.
- Гарантии обработки: какова семантика доставки — хотя бы один раз (at-least-once), ровно один раз (exactly-once) и др. В реальности многие решения допускают хотя бы раз, но за счет транзакций и Idempotence можно приблизиться к exactly-once в рамках одного раздела.
- Времена обработки: event time (время события) и processing time (время обработки). В некоторых случаях важна точность по времени события (для оконной аналитики) и корректная обработка задержек.
- Архитектурные паттерны: событийный источник (source of truth) через потоковую платформу, лог изменений (change data capture, CDC), CQRS (command-query responsibility segregation), eventual consistency и материализованные представления.
- Гарантии порядка и консистентности: порядок сохраняется в рамках одного раздела топика, но между разделами порядок не гарантируется.
- Жизненный цикл топиков: создание, настройка ретенции (retention), очистка, компактирование (log compaction) и хранение в кластере.
Kafka как де-факто стандарт
Apache Kafka — это распределённая потоковая платформа с высокой пропускной способностью, устойчивостью к сбоям и богатой экосистемой инструментов. Основной архитектурный паттерн: кластер из брокеров (brokers), тем (topics), разделов (partitions) и реплик. Kafka обеспечивает последовательность сообщений внутри раздела и позволяет горизонтально масштабировать обработку за счёт нескольких разделов одного топика. Включённые в экосистему компоненты (Confluent, Debezium, ksqlDB, Kafka Connect и пр.) расширяют функционал: вопрос интеграции, преобразования, мониторинга и взаимодействия с базами данных и хранилищами.
Важно понимать, что в реальных системах часто применяются дополнительные слои безопасности и управления: аутентификация и авторизация (SASL/SSL и ACL), шифрование в движении и на диске, мониторинг метрик, управление конфигурациями и обновлениями, резервное копирование и восстановление, контроль качества данных и согласованность схем.
Ключевые термины и принципы работы
- Exactly-once vs at-least-once: временная и операционная гарантия доставки. Чаще достигается с помощью транзакций в продюсерах и поддержкой transactional writes в консюмерах, но настройка сложна и может повлечь задержки.
- Schema evolution: изменения форматов сообщений (Avro, Protobuf, JSON) и совместимость между продюсерами и консюмерами. Часто используется Schema Registry, который хранит схемы и обеспечивает совместимость.
- Kafka Connect: фреймворк для интеграции источников и приемников через коннекторы без написания кода. Примеры: Debezium (CDC для баз данных), коннекторы для S3, Elasticsearch, Hadoop, JDBC и др.
- Kafka Streams, Flink, Spark: различные движки обработки потоков. Kafka Streams — встроенная библиотека на Java, работающая внутри приложения и использующая тот же кросс-топиковый механизм; Flink и Spark позволяют сложные операции, watermarking, оконные вычисления и более продвинутые сценарии.
- Topic design и партиционирование: выбор числа разделов и ключей записи (partition key) влияет на параллелизм и равномерность нагрузки.
- Retention и compaction: retention хранит данные заданный период времени или до заполнения диска; log compaction обеспечивает сохранение последнего значения для каждой ключевой записи, что полезно для CDC и восстановления состояния.
- Безопасность и управление доступом: TLS для защиты данных в пути, SASL для аутентификации, ACL для ограничения доступа к топикам и операциям с ними.
Практические примеры и архитектура потоковых решений
Описывая практику, важно рассмотреть реальный кейс: например, обработку событий электронной торговли (заказы, платежи,배송, статус заказов). Архитектура может выглядеть так:
- Продюсеры: микросервисы заказов публикуют события в топики orders, payments, shipments. Ключ сообщения может быть order_id или user_id, чтобы обеспечить параллельную обработку по конкретному ключу.
- CDC через Debezium: изменения в таблицах базы данных транслируются в соответствующие топики. Например, изменения orders table попадают в orders topic, а изменения users — в users topic.
- Kafka Connect: интеграция с внешними источниками данных — базы данных, файловые хранилища, очереди сообщений, внешние API.
- Обработчики потоков: Kafka Streams или интеграционная платформа (Flink, Spark) обрабатывают данные в реальном времени: формируют текущий статус заказа, создают реестры пользовательской активности, строят агрегаты и вычисляют KPI.
- Материализованные представления: через ksqlDB или аналогичный механизм создаются представления, которые затем потребляются аналитическими системами (ClickHouse, Snowflake, Databricks) или пишутся в тематические топики для последующей загрузки в хранилище данных.
- Н sinks: данные уходят в Data Lake, базы данных аналитики, индексы search-системы или альтернативные топики для повторной обработки.
Практический пример 1: открытые решения на Apache Kafka
Сценарий: сбор и обработка кликов веб-сайта в режиме реального времени.
- Архитектура: приложение продюсирует события page_view в топик page_views, ключом выбран user_id для обеспечения параллелизма по пользователю.
- Debezium здесь не требуется, но можно использовать для CDC из базы заказов, чтобы поддерживать синхронность данных.
- В топике page_views включаем 6 разделов и репликацию 3. Ретеншн установлен на 7 дней, чтобы иметь окно для ретроспективной аналитики.
- Обработчик: ksqlDB создает поток, который считает количество визитов за сессию, строит временные окна и допускает вычисление конверсии, а затем публикует результаты в топик analytics, который потребляют аналитические сервисы Snowflake или ClickHouse.
- Мониторинг и безопасность: Prometheus + Grafana; TLS и SASL, ACL на чтение/запись топиков, аудит действий.
- Применяемые технологии: Apache Kafka, Debezium (для CDC из БД), ksqlDB для потоковых запросов, Spark или Flink для сложной трансформации, внешние хранилища для долговременного хранения.
Практический пример 2: российские решения и интеграция в РФ
Российский рынок потоковых решений развивался и развивается в связке с локальными облаками и интеграторами. В_open-source контексте_ Kafka остаётся базовым стеком, а на локальном рынке встречаются следующие варианты:
- Управляемый сервис Apache Kafka в Яндекс.Облаке: управление кластером, мониторинг, обновления, безопасность и сетевые политики. Типичный сценарий: создаются кластеры, топики под проекты, настраиваются политики ретенции и ACL, подключаются коннекторы Debezium для CDC и облегчается внедрение в локальные инфраструктуры.
- СберКлауд Data Streaming / Managed Kafka: сервис, предлагающий управляемые кластеры Kafka с преднастроенной безопасностью и мониторингом, интегрированный с другими сервисами Сбера. В таких решениях упрощается настройка TLS, SASL, роли и политики доступа, а также предоставляются инструменты для мониторинга, резервного копирования и восстановления.
- Интеграционные площадки и локальные решения: российские системные интеграторы часто предлагают развёртывание кластера Kafka на кластерах заказчика с настройками на производственные нагрузки, в том числе с учетом специфики российского трафика, регуляторных требований и требований по локализации данных. Они могут сопровождать проект на этапе проектирования, внедрения и эксплуатации, включая миграцию из монолитных систем в потоковую архитектуру и настройку центров обработки событий.
Практический пример 3: сценарий CDC и интеграции на базе открытого стека и локального сервиса
- Источник данных: PostgreSQL база данных заказов.
- Коннект Debezium для PostgreSQL: конфигурация коннектора для отслеживания изменений таблиц orders, order_items и customer. Эти изменения публикуются в топики orders, order_items, customers.
- Чистовая обработка: Kafka Streams/Flin обрабатывают поток изменений, создают агрегаты и агрегированные представления, которые затем уходят в аналитическую систему (например, Snowflake) и в топик для повторной обработки.
- Российский сервис: управляемый Kafka в Яндекс.Облаке или СберКлауд упрощает инфраструктуру и обеспечивает соответствие требованиям локализации.
Архитектурные принципы и конфигурации
- Разделы и масштабирование: горизонтальное масштабирование достигается за счёт увеличения числа разделов в топиках и/или добавления брокеров в кластер. Важно продумать распределение ключей (partition keys) для равномерного распределения нагрузки.
- Репликация и отказоустойчивость: фактор репликации обычно выбирается равным 3 в производственных окружениях. В случае сбоя лидера раздела, другой брокер становится лидером, и обработка продолжается без потери данных.
- Транзакции и exactly-once: для обеспечения exactly-once semantics в рамках нескольких топиков можно использовать транзакции продюсеров и корреляционные механизмы консюмеров. Однако такие настройки требуют детального тестирования производительности и вручную продуманного мониторинга поведения.
- Schema management: для обеспечения совместимости форматов сообщений применяют схему Avro или Protobuf, храня схемы в Schema Registry. Это допускает эволюцию схем без разрушения потребителей.
- Безопасность: TLS для шифрования данных в движении, SASL для аутентификации пользователей/сервисов, ACL для доступа к топикам и операциям. Рекомендовано разделять роли по окружениям (разделение dev/stage/prod) и по проектам.
- Мониторинг и операционная безопасность: JMX-метрики, Prometheus-экспортеры, Grafana dashboards, Burrow или Kafka Lag Monitoring для слежения за задержками и отставанием потребителей. Логи находятся в системе хранения журналов и доступны через управляющий инструмент.
Ресурсы и топологии кластера
- Производственный кластер: 3–5 брокеров, 3–4–6 разделов на топик, репликация 3, ретеншн 7–14 дней для событий, компрессия (gzip, lz4) для экономии места.
- Тонкая настройка параметров: batch.size, linger.ms, acks, enable.idempotence, compression.type, fetch.min.bytes и другие параметры, влияющие на задержку и пропускную способность. Важно не перегружать сеть и диск, соблюдая баланс между задержкой и пропускной способностью.
- Обеспечение согласованности между микросервисами: продюсеры публикуют с нужной конфигурацией, консюмеры обрабатывают с нужными стратегиями повторной обработки в случае ошибок.
Практические детали: примеры конфигураций и рабочих паттернов
Пример конфигурации продюсера (общие принципы):
  bootstrap.servers: список адресов брокеров
  acks: all
  enable.idempotence: true
  max.in.flight.requests.per.connection: 5 или меньше
  compression.type: gzip или lz4
  retries: бесконечные или ограниченные в зависимости от требований
  transactional.id: если планируется использовать транзакции
Пример конфигурации консьюмера:
  group.id: имя группы
  enable.auto.commit: false
  auto.offset.reset: earliest (для новой группы)
  isolation.level: read_committed (для transactional reads)
Пример использования Debezium (CDC):
  Connector class: io.debezium.connector.postgresql.PostgresConnector
  database.hostname/port, database.user и database.password
  database.dbname: имя базы данных
  table.include.list: список таблиц, которые нужно мониторить
  database.server.name: префикс топиков, связанных с сервером БД
  topic.prefix: для формирования названий топиков
Пример использования ksqlDB:
  Создание потока из топика
  Определение оконных агрегаций
  Вывод результатов в новый топик или таблицу в ksqlDB
Пример использования Kafka Connect Debezium:
  Установка коннектора и настройка коннектора в JSON
  Мониторинг статуса коннекторов через REST API
Инструменты и интеграции:
- Kafka Streams: простые приложения на Java/Scala, которые читают и пишут в топики, реализуя бизнес-логику
- Flink/Spark Structured Streaming: сложные обработки, окна и временные характеристики
- Нормализация схем и управление версиями через Schema Registry
- Мониторинг и операционная безопасность: Prometheus, Grafana, Jaeger/OpenTelemetry для трассировки, ELK-стек или Loki для логирования
Пример российского сценария внедрения:
- Организация управляемого сервиса Kafka в Яндекс.Облаке или СберКлауд
- Создание кластеров, топиков и политик доступа, настройка интеграций с локальными источниками данных
- Разработка CDC-потока через Debezium, публикация изменений в топики и последующая обработка в Spark/Flink
- Реализация мониторинга и обеспечение соответствия регулятивным требованиям по локализации и аудиту
Риски и ограничения
- Операционная сложность: потоки требуют грамотного проектирования топиков, partitioning и схем, чтобы обеспечить предсказуемую задержку и пропускную способность.
- Задержка и пропускная способность: неправильная настройка параметров может привести к высокой задержке, перегрузке сети или дисков, что негативно скажется на SLA.
- Управление схемами: эволюция схем, несовместимости между продюсерами и консюмерами могут привести к ошибкам и падениям сетевых цепочек.
- Миграции и совместимость: миграции между версиями Kafka и движками обработки требуют тестирования на совместимость и корректной миграции топиков и коннекторов.
- Риск потери данных: при отсутствии репликации или вследствие сбоев в консюмерских группах возможно частичное утеря данных. Чтобы минимизировать риск, обязательно используйте репликацию, ретеншн и контрольные копии.
- Безопасность и соответствие требованиям: управление доступом, локализация данных, шифрование и аудит должны быть встроены на стадии проектирования. Неправильная настройка ACL или неподходящие политики могут привести к утечкам или несанкционированному доступу.
- Зависимость от платформы: в случае перехода между провайдерами облака или в режиме гибридной архитектуры возникают сложности миграции топиков и коннекторов.
- Экономика владения: затраты на инфраструктуру, лицензии (если применимо) и экспертизу требуют грамотного расчета TCO и ROI. В некоторых случаях переход на управляемые сервисы выгоднее с точки зрения операционных затрат и скорости вывода на рынок.
- Масштабирование и локализация данных: в РФ существуют особенности регуляторной среды. Внедрение управляемых сервисов в РФ может потребовать строгого соответствия локализации данных и контрактной архитектуры.
Потоковые платформы, в частности Apache Kafka и связанная экосистема, являются мощным инструментом для реализации архитектуры Event-Driven и построения современного хранилища данных. Они позволяют не просто собирать данные, но и превращать поток событий в готовые к аналитике источники, реальное время — в оперативные бизнес-решения, а также создавать устойчивые и масштабируемые конвейеры данных. Важным является не только выбор базовой технологии, но и дизайн архитектуры, правильная настройка топиков, схема обработки и политики безопасности. В рамках курса мы рассмотрели основные теоретические принципы, обсудили практические сценарии и привели примеры как открытых решений, так и российских сервисов, а также разобрали риски и ограничения. Надеемся, что материал поможет вам уверенно спланировать, внедрить и эксплуатировать потоковую инфраструктуру в рамках вашего проекта по построению хранилища данных с учетом EDA.
Вопрос–Ответ (FAQ)
1) Что такое Kafka и чем она отличается от обычной очереди сообщений?
Kafka — это распределённая потоковая платформа, которая хранит данные как журналы (логи) в топиках, разбитых на разделы, с репликацией и масштабируемостью. В отличие от традиционных очередей сообщений, Kafka обеспечивает масштабируемый высокий пропуск и долговременное хранение данных, поддержку многократной подписки и возможности повторной обработки потоков. Она позволяет строить референсные потоки и кэшированные представления данных, а также интегрировать с системами аналитики и хранения данных.
2) Что такое потоковая обработка и зачем она нужна в нашем хранилище данных?
Потоковая обработка позволяет обрабатывать события по мере их появления, а не по расписанию. Это полезно для аналитики в реальном времени, мониторинга операций, обновления состояния систем и поддержки решений на основе последних данных. В контексте хранилища данных EDA это означает более быструю загрузку данных, эффективную консолидацию и актуальные бизнес-операции, которые можно использовать для принятия решений в реальном времени.
3) Какие основные компоненты Kafka и как они взаимодействуют?
Ключевые компоненты: брокеры (кластеры Kafka), топики (topics), разделы (partitions), реплики (replication), продюсеры (producers) и консюмеры (consumers). Консюмерские группы обеспечивают параллельную обработку. Дополнительные элементы: Kafka Connect (коннекторы для источников и приемников), Debezium (CDC для баз данных), ksqlDB (прямой SQL для потоков), Kafka Streams (встроенная обработка на Java), а также инструменты мониторинга и управления, такие как Prometheus, Grafana и др. Эти части работают вместе: продюсеры публикуют события, Kafka хранит их, консюмеры читают, а дополнительные инструменты помогают в интеграции и обработке.
4) Какие есть практические сценарии внедрения и какие топики проектировать?
Практические сценарии включают обработку кликов и заказов в онлайн-магазине, CDC из баз данных для синхронизации ведомостей, реальное-time-аналитику и создание материалов для дашбордов. Топики следует проектировать по бизнес-доменам, с ключами, которые обеспечивают параллелизм, и с учётом регуляторных требований к хранению данных. Рекомендуется использовать несколько топиков, раздельно для разных субъектов (orders, payments, shipments, customers) и применить правила ретенции и компакции для оптимизации хранения.
5) Что такое Debezium и как он помогает в потоковой архитектуре?
Debezium — набор коннекторов для Kafka Connect, позволяющий захватывать изменения данных (CDC) из баз данных (PostgreSQL, MySQL, MongoDB и др.) и публиковать их в топики Kafka. Это позволяет поддерживать синхронность хранилища аналитических систем и источников данных без необходимости разработки сложных механизмов чтения журналов транзакций и ручной конвертации изменений.
6) Какие российские решения существуют для потоковых данных и что они дают?
На рынке РФ существуют управляемые сервисы Kafka в крупных облаках (Яндекс.Облако, СберКлауд) и локальные интеграторы, которые помогают разворачивать и сопровождать кластеры Kafka под требования локализации данных, регуляторных норм и SLA. Эти сервисы упрощают операции: настройку безопасности, обновления, мониторинг и интеграции с локальными источниками. В то же время открытые решения позволяют гибко строить архитектуру, тестировать сценарии и управлять затратами, что является важной частью зрелости процесса.
7) Какие риски следует учитывать при внедрении потоковых платформ?
Ключевые риски включают операционную сложность, задержку и пропускную способность, сложность схем данных и их эволюцию, миграцию между версиями и провайдерами, безопасность и соответствие требованиям, а также экономическую стоимость владения. Чтобы снизить риски, необходимо тщательно проектировать топики и ключи, использовать репликацию и управление схемами, внедрять мониторинг и политики доступа, проводить тестирование на нагрузку, планировать резервное копирование и стратегии восстановления, а также учитывать планы миграции и обновления версий.
8) Какие типичные способы мониторинга и обеспечения качества данных в Kafka?
Мониторинг включает метрики производительности брокеров (задержка, пропускная способность, нагрузка на CPU/память), задержки консюмеров (lag), состояние коннекторов Debezium, статус топиков и ретеншн. Инструменты: Prometheus, Grafana, JMX-митки, Burrow для lag мониторинга, Kafka Exporter, и внешние системы журналирования. Для обеспечения качества данных применяют схемы совместимости (Schema Registry), а также тестовые сценарии на продакшн-каналах и ретрансляцию ошибок.
9) Как выбрать между открытым стеком и российскими управляемыми сервисами?
Открытый стек обеспечивает гибкость, контроль и независимость от конкретного поставщика, но требует большего объема операционных работ и экспертизы. Управляемые сервисы в РФ упрощают развёртывание, управление и соответствие регуляторным требованиям, сокращая время вывода на рынок и снижая операционные риски. Выбор зависит от целей проекта: скорость внедрения и регуляторные требования — в пользу управляемых сервисов; гибкость, контроль и стоимость владения — в пользу открытого стека и локальных интеграторов.
10) Какие шаги можно сделать в первые 30–60 дней проекта по внедрению?
- Определить предметную область и кейсы EDA: какие события будут публиковаться, какие аналитические задачи будут решаться в реальном времени.
- Спроектировать топики и определить ключи partition, а также выбрать ретеншн и политики компакции.
- Выбрать стек и архитектуру (Self-managed Kafka vs управляемый сервис, выбор движков обработки).
- Настроить базовую безопасность и мониторинг.
- Развернуть простой пример прототипа: продюсер, консюмер, базовый коннектор Debezium и простой поток обработки.
- Пройти тесты на нагрузку и устойчивость, определить требования к SLA и план резервного копирования.
- Выполнить пилотный запуск на реальном потоке данных и оценить ROI.
Потоковые платформы, особенно Apache Kafka и сопутствующая экосистема, становятся ключевыми инструментами для реализации архитектуры Event Driven и построения современного хранилища данных. Они позволяют не только собирать данные, но и быстро превращать события в жизненно важные бизнес-решения, осуществлять мониторинг процессов и обеспечивать устойчивое масштабирование. Важно учитывать особенности проектирования архитектуры, безопасность данных и требования регуляторов, чтобы обеспечить надёжность, соответствие и экономическую эффективность. В рамках этой главы мы прошли путь от теории к практике, предложили примеры реализации на открытом стекe и в российском контексте, а также разобрали риски и ограничения. Надеемся, что полученные знания будут полезными для ваших проектов и помогут успешно внедрять потоки в хранилище данных по EDA.
FAQ ч.2
1) Какой смысл иметь именно потоковую архитектуру в хранилище данных?
Потоковая архитектура позволяет принимать данные по мере их появления, избегать задержек, поддерживать актуальные оперативные данные и мгновенно реагировать на события. Это особенно важно для динамичных бизнес-объектов, таких как заказы, клики, платежи и прочие изменения состояния, а также для обновления аналитических моделей и материалов в реальном времени.
2) В чем преимущества Kafka по сравнению с другими системами очередей?
Kafka обеспечивает длительное хранение событий, масштабируемость и высокую пропускную способность, поддержку множества подписчиков и повторной обработки, а также широкую экосистему инструментов. Это делает ее удобной основой для построения организаций данных и конвейеров, где важны скорость и надежность.
3) Что такое CDC и зачем он нужен в наших потоках?
CDC (Change Data Capture) позволяет регистрировать изменения в базах данных и публиковать их в потоковую систему в реальном времени. Это позволяет поддерживать синхронность между источниками и целевыми хранилищами, ускорять обновления аналитических представлений и минимизировать задержку между изменением в источнике и отображением изменений в аналитике.
4) Какие рабочие паттерны применяются для обеспечения согласованности и эффективности?
Типичные паттерны: проектирование топиков по бизнес-доменам, использование партиционирования и ключей для параллельной обработки, применение Schema Registry для совместимости схем, использование Debezium для CDC, применение транзакций продюсеров для обеспечения exactly-once в рамках нескольких топиков, а также применение оконной аналитики (time windows) и материализованных представлений через ksqlDB, Spark или Flink.
5) Какие российские сервисы полезны для начинающего проекта?
В РФ крупные облачные провайдеры предлагают управляемые сервисы Kafka: Яндекс.Облако и СберКлауд. Они упрощают развертывание, управление, безопасность и мониторинг, что особенно полезно на старте проекта. При этом открытые решения позволяют глубже настраивать архитектуру, проводить оптимизацию и демонстрировать особенности реализации.
6) Какие техники безопасности наиболее важны в Kafka?
Важно настроить TLS для шифрования в пути, SASL для аутентификации, ACL для доступа к топикам и операциям, обеспечить изоляцию окружений и управление версиями. Также рекомендуется мониторинг и аудит операций, регулярные обновления и тестирования на соответствие регулятивным требованиям.
7) Какие риски наиболее критичны на старте внедрения?
Ключевые риски — операционная сложность, неподходящие параметры настройки (задержка и пропускная способность), плохая архитектура топиков и ключей, непредсказуемая эволюция схем, недостаточное тестирование и миграция версий, а также регуляторные требования и локализация. Планирование архитектуры, мониторинг, тестирование и использование управляемых сервисов в РФ помогают снизить эти риски.
8) Как начать пилотный проект по внедрению Kafka?
Определите бизнес-кейсы и составьте карту потоков событий, спроектируйте топики и ключи, выберите стек (self-managed или управляемый сервис), разверните минимальную конфигурацию кластера, настройте безопасность и мониторинг, реализуйте простой прототип продюсера/консюмера и тестовый коннектор Debezium, затем проведите нагрузочные тесты и оценку ROI.
9) Какие шаги по миграции с монолитной системы к потоковой архитектуре стоит предпринять?
Начните с пилотного кейса в зоне с минимальным риском, перенесите часть данных и операций в потоковую конвейер, используйте Debezium для CDC, протестируйте консистентность и повторную обработку, постепенно расширяйте конвейеры и коннекторы, применяйте мониторинг и аудит, и затем масштабируйте решение по проекту.
10) Какие критично важные критерии отбора инструментов для нашего проекта?
Критерии: совместимость с существующими системами и регламентами, поддержка нужных языков и обработчиков, пропускная способность и задержка, возможности управления схемами и версионности, наличие готовых коннекторов (CDC и источники/приемники), уровень поддержки на российском рынке, безопасность и соответствие требованиям по локализации, стоимость владения и удобство эксплуатации. Выбор должен быть обоснован на требованиях проекта, а не только на моде рынка.


