

Типы каталогов Iceberg: HiveCatalog
HiveCatalog — один из ключевых вариантов организации каталогов в рамках Iceberg Lakehouse. В условиях реального внедрения это тот механизм, который позволяет централизованно регистрировать таблицы Iceberg в существующей инфраструктуре управления метаданными Hive Metastore (HMS). HiveCatalog основывается на идее использования HMS в качестве центрального реестра таблиц Iceberg, что упрощает совместное использование таблиц между командами и инструментами, обеспечивает единый контроль доступа и упрощает миграцию существующих данных в Iceberg. Эта глава ориентирована на новичков: с чего начинается выбор каталога, какие концептуальные плюсы и минусы несет HiveCatalog, как он вписывается в архитектуру Lakehouse, и какие шаги нужны на практике, чтобы запустить его в связке с популярными open-source и отечественными решениями. Мы обсудим теорию, примеры конфигураций, практические сценарии использования и риски внедрения, чтобы вы могли планировать свой проект без лишних сюрпризов.
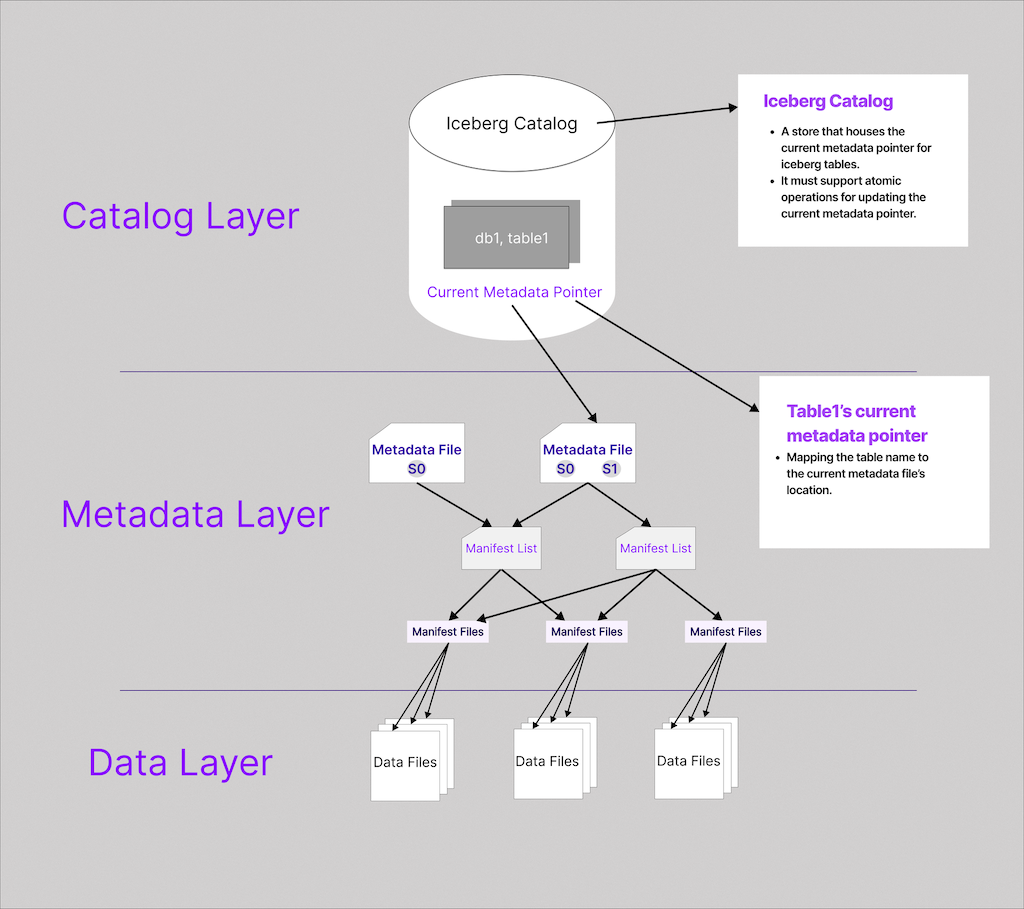
Что такое каталог Iceberg и чем он полезен
Каталог в Iceberg — это абстракция, через которую клиентские приложения (Spark, Flink, Trino и т. д.) получают доступ к наборам таблиц Iceberg. Каталог хранит информацию о местоположении таблиц, их схемах, партиционировании и других свойствах. Разные реализации каталога позволяют по-разному хранить и синхронизировать метаданные: локально на файловой системе, в централизованном реестре и т. д. HiveCatalog относится к реализации, которая использует Hive Metastore (HMS) как центральный реестр метаданных таблиц Iceberg.
HiveCatalog и Hive Metastore: базовая идея
Hive Metastore — это отдельный сервис (или набор сервисов), который хранит метаданные таблиц Hive, включая имена баз данных и таблиц, схемы, расположения данных и ряд свойств таблиц. HiveCatalog Iceberg использует HMS для регистрации таблиц Iceberg и извлечения необходимой информации о таблицах, чтобы прочитать файлы или записывать новые данные. Главная идея: HMS служит единым каталогом, а Iceberg — это формат для хранения самих данных и их метаданных внутри объекта хранилища (HDFS, S3, GCS и т. д.). Это позволяет легко интегрировать Iceberg в экосистему, где уже присутствуют Hive, Spark, Presto/Trino, Flink и другие потребители метаданных.
Преимущества HiveCatalog
- Совместимость с существующей инфраструктурой HMS: если в вашей организации уже есть Hive Metastore для управления таблицами Hive, вы можете переиспользовать его для Iceberg без внедрения нового реестра.
- Централизованный доступ к таблицам: HMS обеспечивает единый реестр таблиц, что упрощает совместное использование таблиц между командами и проектами.
- Упрощенная миграция: можно мигрировать существующие Hive-таблицы в Iceberg и продолжать доступ к ним через HiveCatalog без явной переработки клиентского кода.
- Совместимость с инструментами: Spark, Flink, Trino и другие движки умеют работать с HiveCatalog и инфраструктурой HMS, что снижает порог входа для команд.
- Безопасность и управление доступом: если в HMS настроены Kerberos, Ranger/ACLS и аутентификация, то доступ к Iceberg-таблицам через HiveCatalog может наследовать те же политики.
Сравнение с другими типами каталогов Iceberg
- HadoopCatalog: хранит все metadata локально в файловой системе и не требует HMS. Преимущества — простота и автономность; ограничения — сложность управления несколькими кластерами и отсутствие централизованного реестра для совместного использования таблиц.
- IcebergCatalog (Self-Describing Catalog): автономный каталог Iceberg, который хранит метаданные в файловой системе или в совместимом хранилище, без HMS. Преимущества — полная автономия, меньше внешних зависимостей; ограничения — меньше совместимости с существующими HMS-инструментами и потребность в дополнительных настройках для совместного доступа.
- HiveCatalog vs GlueCatalog: GlueCatalog — альтернативная реализация, которая использует AWS Glue Data Catalog как HMS. HiveMetastore хорошо известен в on-prem и в гибридных условиях, но GlueCatalog ориентирован на AWS-среду. Выбор зависит от вашей архитектуры и требований к совместимости.
Архитектурная карта HiveCatalog
- Клиентское приложение (Spark/Flink/Trino и др.) обращается к HiveCatalog.
- HiveCatalog конфигурируется на основе HMS: URI метastore, протокол Thrift, учетные данные и политика безопасности.
- HMS содержит записи о базах данных и таблицах Iceberg, включая имя базы данных, имя таблицы, расположение таблицы на объектном хранилище и свойства.
- Файлы Iceberg (манефесты, снимки секций, данные) хранятся в объектном хранилище вне HMS; HMS хранит только связанные с таблицей параметры и location.
- Механизм безопасности: Kerberos/SSL, интеграция с LDAP, Ranger и др., если так настроено в HMS.
- Клиентские API Iceberg читают и пишут данные через эти метаданные и манипулируют файлами Iceberg как обычно, но регистрация и каталогизация ведутся через HMS.
Практические примеры
Open-source сценарий: внедрение HiveCatalog с использованием Hive Metastore и Spark
Предпосылки:
- Развернутый Hive Metastore (HMS) с доступом через Thrift-URI, например thrift://hive-metastore.host:9083.
- Объектное хранилище, например S3 или HDFS, куда будут класться данные Iceberg.
- Кластер Apache Spark, совместимый с Iceberg и поддерживающий SparkCatalog.
- Установленные Kerberos/LDAP для аутентификации по требованию безопасности.
Конфигурация клиента (примерно, в контексте Spark):
- Определяем каталог Hive в Spark:
    spark.sql.catalog.myhive = org.apache.iceberg.spark.SparkCatalog
    spark.sql.catalog.myhive.type = hive
    spark.sql.catalog.myhive.uri = thrift://hive-metastore.host:9083
Пример использования:
- CREATE TABLE myhive.default.orders (order_id BIGINT, customer_id BIGINT, amount DOUBLE, order_ts TIMESTAMP) USING ICEBERG;
- INSERT INTO myhive.default.orders VALUES (1, 1001, 250.0, TIMESTAMP '2024-11-01 12:00:00');
- SELECT * FROM myhive.default.orders WHERE amount > 100;
Преимущества такого подхода: можно создавать Iceberg-таблицы в рамках существующей базы данных HMS; таблицы регистрируются и доступны через HMS, что упрощает их поиск и контроль доступа.
Важные моменты реализации:
- Убедитесь, что для Hive Metastore настроены соответствующие параметры безопасности и сетевого доступа (Kerberos, TLS, firewall).
- Укажите корректный URI HMS в конфигурации клиента; если HMS находится в среде с несколькими кластерами, обучитесь правильной маршрутизации запросов.
- Настройка кэширования HMS и клиентской части может повысить производительность при большом числе таблиц.
Реальные сценарии использования:
- Команды аналитических команд используют HiveCatalog для чтения Iceberg-таблиц через Spark и Trino, обеспечивая единый доступ к данным и совместный контроль версий и схем.
- Архитекторы данных могут внедрять HiveCatalog как мост между существующими Hive-таблицами и новыми Iceberg-таблицами, минимизируя риск миграции.
Практические примеры: отечественные решения и реальный контекст
Образовательные и пилотные проекты в российской среде часто строятся на открытых технологиях с локализацией метаданных и хранения в рамках локальных дата-центров. В таких сценариях HiveCatalog с HMS может служить связующим звеном между существующими данными в HDFS или локальном объектном хранилище и новыми Iceberg-таблицами.
На практике российские организации, которые реализуют Data Lake и Lakehouse-подходы, нередко разворачивают HMS в рамках частной инфраструктуры, используют Kerberos и Ranger для управления доступом, а также применяют Spark/Flink/Trino в связке с Iceberg через HiveCatalog. Это позволяет:
- сохранить единый реестр таблиц и политик доступа.
- мигрировать данные в Iceberg без изменения существующих бизнес-процессов.
- обеспечить совместимость с существующими инструментами BI и аналитики, которые уже умеют работать с HMS.
Примеры реальных сценариев внедрения в отечественных условиях:
- Крупный банк или телеком-провайдер имеет on-prem Hadoop/HMS и переходит к Lakehouse. HiveCatalog упрощает миграцию и обеспечивает минимальные изменения в существующих пайплайнах.
- Компании, которым нужна строгая локализация данных, используют HMS в локальном дата-центре и ограничивают доступ к данным через локальные политики безопасности, сохраняя совместимость с Spark и Flink для обработки Iceberg-таблиц.
- Образовательные площадки и консорциумы, которые демонстрируют архитектуры Lakehouse в рамках локальных кластеров, применяют HiveCatalog для демонстрации преимуществ централизованного реестра и возможности совместной работы команд.
Метаданные Iceberg и роль HMS
- Iceberg хранит данные и независимые файлы метаданных (манефесты, снимки и данные) в объектном хранилище. HMS хранит только таблицы и их параметры: имена баз данных и таблиц, схемы, расположение таблиц на хранилище, свойства таблиц, а также политики безопасности и версии.
- В HiveCatalog Iceberg таблица регистрируется как объект в HMS, а сами данные Iceberg остаются в файловой системе или объектном хранилище под управлением Iceberg. Это разделение позволяет использовать сильную инфраструктуру HMS для учёта и контроля доступа, в то время как Iceberg обеспечивает современную схему управления данными, партиционированием и эффективными операциями над большими наборами данных.
Ключевые конфигурационные элементы
Конфигурация клиента Iceberg для использования HiveCatalog через HMS:
- Указать SparkCatalog (или соответствующий клиент Flink/Trino) как SparkCatalog для вашего каталога.
- Указать тип каталога как hive, чтобы Iceberg использовал Hive Metastore.
- Указать URI HMS (Thrift URI), например thrift://hive-metastore.host:9083.
Пример общих свойств:
  spark.sql.catalog.myhive = org.apache.iceberg.spark.SparkCatalog
  spark.sql.catalog.myhive.type = hive
  spark.sql.catalog.myhive.uri = thrift://hive-metastore.host:9083
Важные детали HMS:
- Учетные данные и аутентификация: Kerberos или другие механизмы, поддерживаемые HMS.
- Сетевые настройки: устойчивые соединения к HMS, тайм-ауты и повторные попытки.
- Масштабируемость HMS: при большом количестве таблиц и запросов нужно продумать параметры кэширования, HA-режимы, репликацию метаданных.
Как создаются и читаются Iceberg-таблицы через HMS
- Создание новой Iceberg-таблицы через HiveCatalog: вы используете клиент Spark/Flink/Trino и указываете в качестве каталога HiveCatalog, зарегистрируете новую таблицу в HMS и Iceberg создаёт файлы данных и метаданные в объектном хранилище.
- Чтение таблиц: клиент Iceberg читает схемы и параметры из HMS, получает путь к данным и выполняет запросы, обращаясь к данным в хранилище.
- Обновления схемы и несовпадения версий: Iceberg поддерживает эволюцию схем и совместимость между версиями метаданных, но изменения должны корректно отражаться в HMS и в самой таблице Iceberg через версионность манефестов.
Безопасность и интеграция
- Kerberos и TLS: HMS может использовать Kerberos для аутентификации и TLS для защиты трафика между HMS и клиентами. Iceberg-приложения должны соблюдать эти политики и правильно настраивать разрешения.
- Роль и политики: Ranger или аналогичные средства могут применяться к HMS и контролировать доступ к таблицам Iceberg на уровне баз данных и таблиц.
- Аудит и мониторинг: HMS поддерживает запись лога операций, что важно для аудита изменений метаданных Iceberg. Мониторинг производительности HMS и Iceberg-операций помогает избегать узких мест.
Риски и ограничения
- Центральный узел HMS: Hive Metastore может стать единой точкой отказа. Рекомендуется обеспечить HA HMS, резервирование, резервное копирование схем HMS и репликацию по регионам, если есть требования к доступности.
- Совместимость версий: версии Iceberg и Hive Metastore должны быть совместимы. Обновления HMS или клиента Iceberg без проверки совместимости могут привести к несоответствиям схем, потере доступности таблиц или ошибок чтения/записи.
- Производительность HMS: при большом количестве таблиц и частых изменениях метаданных HMS может стать узким местом. В таких сценариях важно оптимизировать конфигурацию Metastore (кэширование, пул соединений, выделение ресурсов).
- Ограничения функционала: HiveCatalog в контексте HMS иногда может иметь ограничения по функциональности по сравнению с более автономными каталога-реализациями. Например, некоторые продвинутые функции Iceberg могут лучше работать в автономных каталогах, где отсутствует необходимость синхронизации с HMS.
- Безопасность и соответствие требованиям: если HMS развернут в среде с ограничениями по сетевому доступу или санкциями, нужно обеспечить корректную настройку сетей, аутентификации и политик. В некоторых случаях Hive Metastore может потребовать дополнительных слоев защиты и аудита.
- Миграционные риски: миграция существующих Hive-таблиц в Iceberg через HMS требует планирования: совместимость схем, обновление DDL, проверка целостности метаданных и сверка результатов.
- Географическая локализация и согласованность: в многореигиональных кластерах необходимо управлять задержками синхронности между HMS и данными Iceberg, чтобы исключать расхождения в версиях схем и метаданных.
HiveCatalog — мощный вариант для организаций, которые уже располагают Hive Metastore и хотят быстро перенести часть или все свои Iceberg-таблицы в Lakehouse-подход, минимизируя изменения в существующих пайплайнах и политике безопасности. Его основное преимущество — возможность централизованного управления метаданными через HMS и совместимость с широко используемыми инструментами анализa: Spark, Flink, Trino. Однако этот подход требует надежной инфраструктуры HMS, внимания к совместимости версий и учёта рисков, связанных с производительностью и доступностью центрального реестра. При детальном проектировании внедрения стоит заранее продумать HA-конфигурацию HMS, план миграции таблиц в Iceberg, настройку безопасности и мониторинга. В итоге HiveCatalog может стать надежной основой для предприятия, которое хочет сохранить существующую экосистему Hive и в то же время двигаться к архитектуре Lakehouse, основанной на Iceberg.
Вопрос–Ответ (FAQ)
1) Что такое HiveCatalog в Iceberg и чем он отличается от других Catalog-реализаций?
HiveCatalog — это реализация каталога Iceberg, которая использует Hive Metastore в качестве центрального реестра метаданных для таблиц Iceberg. Он отличается от автономных каталогов (например, IcebergCatalog или HadoopCatalog) тем, что часть метаданных хранится в HMS, что упрощает интеграцию с существующей инфраструктурой Hive и совместное использование таблиц между различными инструментами. В автономных каталогах метаданные чаще хранятся непосредственно в файловой системе или в самом Iceberg-реестре, без зависимости от HMS.
2) Какие преимущества HiveMetastore даёт для Iceberg?
HMS уже внедрён в инфраструктуру многих компаний, обеспечивает единый реестр таблиц, политики безопасности и аудит. Используя HiveCatalog, Iceberg может упростить миграцию существующих Hive-таблиц в Iceberg и обеспечить совместимость с инструментами, которые уже работают с HMS, например Spark, Flink и Trino. Это минимизирует изменения в бизнес-процессах и данных.
3) Какие сложности и риски возникают при внедрении HiveCatalog?
Основной риск — зависимость от Hive Metastore как единого реестра. Необходимо обеспечить HA HMS, репликацию и резервирование, чтобы избежать простоев. Также важно проверить совместимость версий Iceberg и HMS, планировать миграцию схем и ограничений функциональности в зависимости от версии. Дополнительные риски включают настройку безопасности (Kerberos, Ranger), производительность HMS при большом числе таблиц и изменений и необходимость мониторинга.
4) Какие требования к инфраструктуре для HiveCatalog?
Необходимо развернуть Hive Metastore (с поддержкой Thrift), обеспечить сетевое соединение между HMS, клиентскими сервисами (Spark/Flink/Trino) и хранилищем данных. Часто требуется Kerberos/SSL для защиты и поддержка политик безопасности. Также полезна среда для резервного копирования HMS и возможности горизонтального масштабирования.
5) Какой тип хранилища используется для метаданных Iceberg в HiveCatalog?
Данные и метаданные Iceberg хранятся в объектном хранилище или файловой системе (S3, GCS, HDFS, локальный FS). Hive Metastore хранит только связанные с таблицами данные: база данных, таблица, схема и местоположение таблицы. Таким образом, HMS играет роль реестра, а Iceberg — роли физического хранения файлов и манефестов.
6) Какие инструменты чаще всего используются совместно с HiveCatalog в Open Source среде?
Обычно это Apache Spark, Apache Flink и Trino (Presto). Все они поддерживают Iceberg через HiveCatalog и HMS. Это позволяет работать с Iceberg-таблицами единообразно через различные движки, сохраняя совместимость и ускоряя внедрение Lakehouse.
7) Как выглядит базовый сценарий миграции Hive-таблицы в Iceberg через HiveCatalog?
Базовый сценарий: 1) Развернуть HMS и проверить доступность Thrift-URI. 2) Настроить клиентский движок (Spark/Flink) на использование HiveCatalog (указать URI HMS). 3) Создать новую Iceberg-таблицу через HMS или преобразовать существующую Hive-таблицу в Iceberg через DDL/производные команды. 4) Привязать данные к новой Iceberg-таблице, проверить совместимость схем и партиционирования. 5) Переключить потребителей на новую Iceberg-таблицу и мониторить производительность. 6) При необходимости выполнить миграцию данных и ретроспективную совместимость.
8) Какие сценарии внедрения подходят для локальных дата-центров в России?
В локальных дата-центрах HiveCatalog через HMS хорошо подходит для предприятий, которым важна локализация данных, соблюдение регуляторных требований и прозрачность аудита. Такой подход позволяет сохранить существующий механизм управления доступом, повторно использовать Hive Metastore, чтобы минимизировать затраты на миграцию. Также он упрощает интеграцию с отечественными системами, которые уже работают с HMS и Kerberos, и обеспечивает совместимость с российскими решениями для мониторинга и управления данными.
9) Какие ограничения следует учитывать при выборе HiveCatalog на старте проекта?
Учитывайте зависимость от HMS как узкого места, необходимость надежного HA-решения HMS, совместимость версий и поддержку нужных функций Iceberg в вашей версии HMS. Также подумайте о требованиях к задержке доступа и производительности: HMS может стать точкой задержки при очень большом числе мелких изменений метаданных. Наконец, потребуется план по резервному копированию и аварийному восстановлению HMS.
10) Как понять, подходит ли HiveCatalog для вашего дата-пайплайна?
Если у вас уже есть Hive Metastore, если ваши аналитики и BI-слои привыкли работать с HMS и если вы ожидаете гибкость миграции в Iceberg без многочисленных изменений в инфраструктуре, HiveCatalog — разумный выбор. Он обеспечивает совместимость, простоту внедрения и хорошую поддержку в рамках открытого стека. Если же ваша среда не имеет HMS или требует автономности каталога, можно рассмотреть альтернативы вроде IcebergCatalog или GlueCatalog (для облачных AWS-решений), но при этом нужно будет решать дополнительные вопросы интеграции.
Для компаний, у которых уже есть Hive Metastore и необходимость минимальной перестройки инфраструктуры, HiveCatalog — разумный стартовый вариант для перехода к Iceberg Lakehouse. Он обеспечивает централизованный реестр таблиц, совместимость с существующими инструментами и возможность плавной миграции. Однако не забывайте про планирование высокой доступности HMS, совместимости версий и мониторинга, чтобы сохранить надежность вашей аналитической среды.
Если вы хотите дополнительно углубиться в конкретные кейсы, можно рассмотреть примеры конфигураций под разные среды — локальные кластеры с HDFS, гибридные окружения с S3-совместимым хранилищем и отечественные решения мониторинга и аудита для HMS. В любом случае HiveCatalog в Iceberg остаётся мощным инструментом для централизации регистрации таблиц и объединения Iceberg с экосистемой Hive и открытым стеком аналитики.


