

Учебное пособие по DBT (инструмент построения данных)
1. Введение
Если вы – студент, аналитик, инженер или специалист в области данных и вам интересно, что такое dbt и как его использовать. Тогда эта статья для вас.
2. DBT, T в ELT
В конвейере ELT необработанные данные загружаются (EL) в хранилище данных. Затем необработанные данные преобразуются в пригодные для использования таблицы с помощью SQL-запросов, выполняемых в хранилище данных.
dbt предоставляет простой способ создания, преобразования и проверки данных в хранилище данных. dbt выполняет T в процессах ELT (Extract, Load, Transform).
В dbt мы работаем с моделями, которые представляют собой файл sql с оператором выбора. Эти модели могут зависеть от других моделей, на них могут быть определены тесты, и их можно создавать в виде таблиц или представлений. Имена моделей, созданных dbt, являются именами их файлов.
Например. Файл dim_customers.sql представляет модель с именем dim_customers. Эта модель зависит от моделей stg_eltool__customers и stg_eltool__state.Затем на модель dim_customers можно ссылаться в других определениях модели.
with customers as (
    select *
    from {{ ref('stg_eltool__customers') }}
),
state as (
    select *
    from {{ ref('stg_eltool__state') }}
)
select c.customer_id,
    c.zipcode,
    c.city,
    c.state_code,
    s.state_name,
    c.datetime_created,
    c.datetime_updated,
    c.dbt_valid_from::TIMESTAMP as valid_from,
    CASE
        WHEN c.dbt_valid_to IS NULL THEN '9999-12-31'::TIMESTAMP
        ELSE c.dbt_valid_to::TIMESTAMP
    END as valid_to
from customers c
    join state s on c.state_code = s.state_code
Мы можем определить тесты, которые будут запускаться на обработанных данных, используя dbt. dbt позволяет нам создавать 2 типа тестов, это
- Generic tests: уникальные тесты, тесты not_null, accept_values и отношения для каждого столбца, определенного в файлах YAML. Например. см. core.yml
- Bespoke (aka one-off) tests: сценарии Sql, созданные в папке с тестами. Это могут быть любые запросы. Они успешны, если сценарии SQL не возвращают никаких строк, в противном случае они неуспешны.
Например. Файл core.yml содержит тесты для моделей dim_customers и fct_orders.
version: 2
models:
  - name: dim_customers
    columns:
      - name: customer_id
        tests:
          - not_null # checks if customer_id column in dim_customers is not null
  - name: fct_orders
3. Проект
Маркетинговая команда попросила нас создать денормализованную таблицу customer_orders с информацией о каждом заказе, сделанном клиентами. Предположим, что данные о клиентах и заказах (customers and orders) загружаются в хранилище процессом.
Процесс, используемый для переноса этих данных в наше хранилище данных, является частью EL.
Давайте посмотрим, как наши данные преобразуются в окончательную денормализованную таблицу.

Мы будем следовать передовым методам работы с хранилищами данных, такими как таблицы подготовки данных, тестирование, использование медленно меняющихся измерений типа 2 и соглашения об именах.
3.1. Предпосылки
Для написания кода вам понадобится
Клонируйте репозиторий git и запустите док-контейнер хранилища данных.
git clone https://github.com/josephmachado/simple_dbt_project.git
export DBT_PROFILES_DIR=$(pwd)
docker compose up -d
cd simple_dbt_project
По умолчанию dbt будет искать подключения к хранилищу в файле ~/.dbt/profiles.yml. Переменная среды DBT_PROFILES_DIR указывает dbt искать файл profiles.yml в текущем рабочем каталоге.
Вы также можете создать проект dbt, используя dbt init. Это предоставит вам пример проекта, который вы можете изменить.
В папке simple_dbt_project вы увидите следующие папки.
.
├── analysis
├── data
├── macros
├── models
│   ├── marts
│   │   ├── core
│   │   └── marketing
│   └── staging
├── snapshots
└── tests
- analysis: любые файлы .sql найденные в этой папке, будут скомпилированы в необработанный sql при запуске dbt compile. Они не будут запускаться dbt, но могут быть скопированы в любой инструмент по выбору.
- data: мы можем хранить необработанные данные, которые мы хотим загрузить в наше хранилище данных. Обычно это используется для хранения небольших картографических данных.
- macros: Dbt позволяет пользователям создавать макросы, которые являются функциями на основе sql. Эти макросы можно повторно использовать в нашем проекте.
Мы рассмотрим папки models, snapshots, и tests в следующих разделах.
3.2. Конфигурации и подключения
Зададим подключения к складу и настройки проекта.
3.2.1. profiles.yml
Dbt требует, чтобы файл profiles.yml содержал сведения о подключении к хранилищу данных. Мы определили детали подключения к хранилищу в файле /simple_dbt_project/profiles.yml.
Переменная target определяет среду. По умолчанию это разработчик. У нас может быть несколько target , которые можно указать при запуске команд dbt.
Профиль sde_dbt_tutorial. Файл profiles.yml может содержать несколько профилей, если у вас более одного проекта dbt.
3.2.2. dbt_project.yml
В этом файле вы можете определить используемый профиль и пути для различных типов файлов (см. *-paths).
Материализация — это переменная, которая управляет тем, как dbt создает модель. По умолчанию каждая модель будет представлением. Это можно переопределить в dbt_profiles.yml.Мы настроили модели в разделе models/marts/core/, чтобы они материализовались в виде таблиц.
# Configuring models
models:
    sde_dbt_tutorial:
        # Applies to all files under models/marts/core/
        marts:
            core:
                materialized: table
3.3 Поток данных
Мы увидим, как создается таблица customer_orders из исходных таблиц. Эти преобразования соответствуют лучшим практикам складирования и баз данных.
3.3.1. Источник
Исходные таблицы относятся к таблицам, загруженным в хранилище процессом EL. Поскольку dbt их не создавал, мы должны их определить. Это определение позволяет обращаться к исходным таблицам с помощью исходной функции. Например, {{ source('warehouse', 'orders') }} ссылается на таблицу inventory.orders. Мы также можем определить тесты, чтобы убедиться, что исходные данные чистые.
- Определение источника: sde_dbt_tutorial/models/staging/src_eltool.yml
- Определения тестов: sde_dbt_tutorial/models/staging/src_eltool.yml
3.3.2. Снимки
Атрибуты бизнес-объекта со временем меняются. Эти изменения должны быть зафиксированы в нашем хранилище данных. Например, пользователь может перейти на новый адрес. В моделировании хранилища данных это называется медленно меняющимися измерениями.
Dbt позволяет нам легко создавать эти медленно изменяющиеся таблицы измерений (тип 2) с помощью функции моментальных снимков. При создании моментального снимка нам необходимо определить базу данных, схему, стратегию и столбцы для идентификации обновлений строк.
dbt snapshot
Dbt создает таблицу моментальных снимков при первом запуске, а при последующих запусках проверяет измененные значения и обновляет старые строки. Мы моделируем это, как показано ниже
pgcli -h localhost -U dbt -p 5432 -d dbt
# password1234
COPY warehouse.customers(customer_id, zipcode, city, state_code, datetime_created, datetime_updated)
FROM '/input_data/customer_new.csv' DELIMITER ',' CSV HEADER;
Запустите команду моментального снимка еще раз
dbt snapshot
Необработанные данные
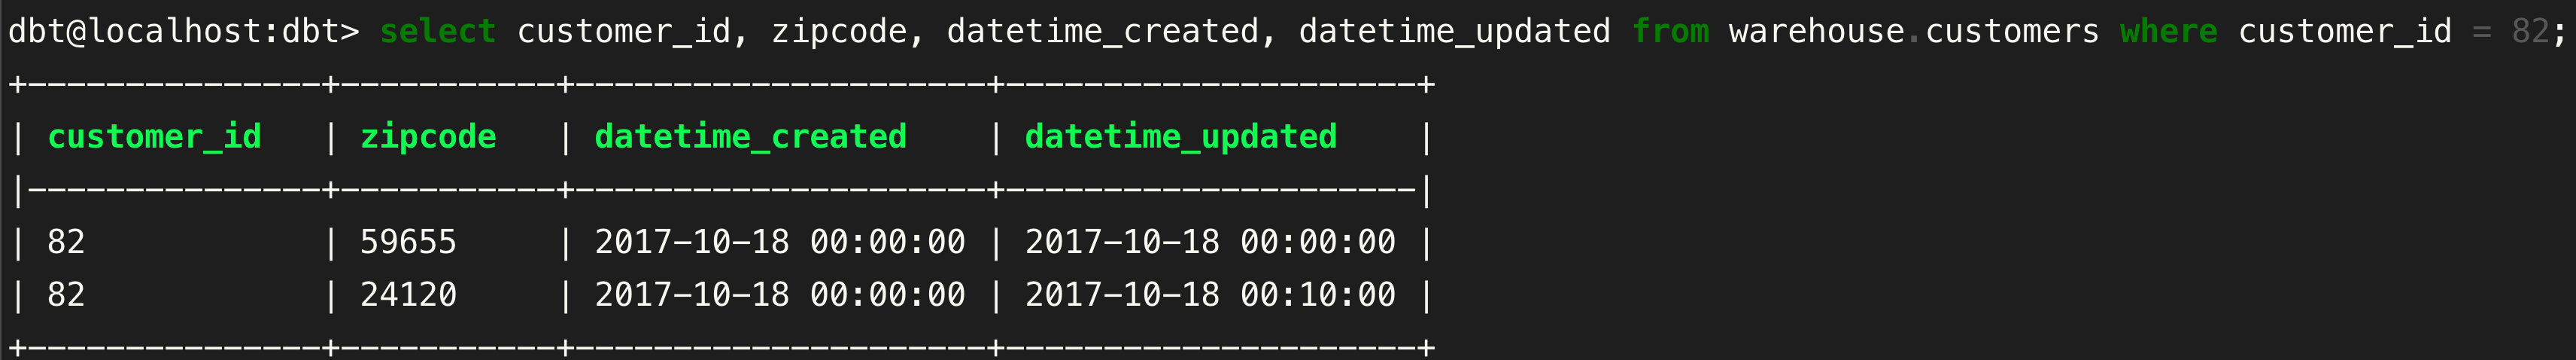
Снимок таблицы
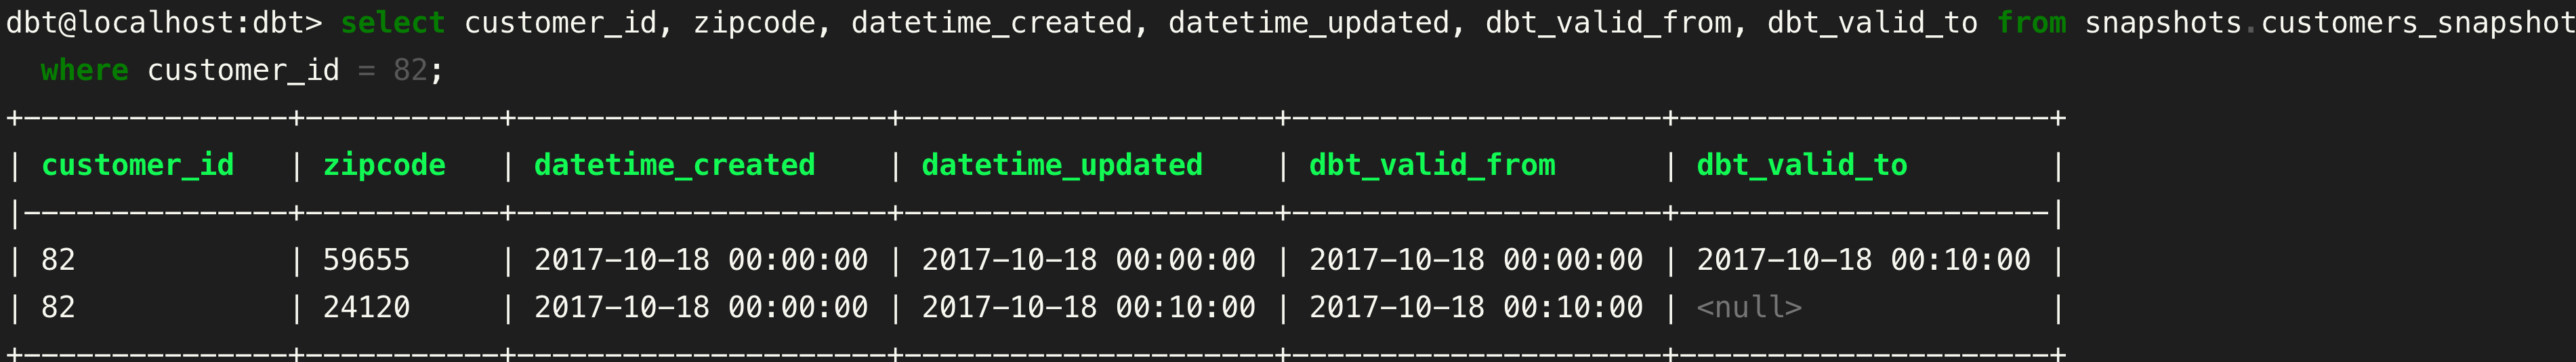
В строке с почтовым индексом 59655 был обновлен столбец dbt_valid_to. Столбцы dbt from и to представляют временной диапазон, когда данные в этой строке представляют клиента 82.
- Определение модели: sde_dbt_tutorial/snapshots/customers.sql
3.3.3. Область подготовки данных
Область подготовки данных – это промежуточная область, где необработанные данные преобразуются в правильные типы данных, присваиваются согласованные имена столбцов и готовятся к преобразованию в модели, используемые конечными пользователями.
Вы могли заметить eltool в названиях промежуточных моделей. Если мы используем данные Fivetran для EL, наши модели будут называться stg_fivetran__orders , а файл YAML будет называться stg_fivetran.yml.
В stg_eltool__customers.sql мы используем функцию ref вместо функции source , поскольку эта модель получена из модели моментального snapshot . В dbt мы можем использовать функцию ref для ссылки на любые модели, созданные dbt.
- Определения тестов: sde_dbt_tutorial/models/staging/stg_eltool.yml
- Определения моделей: sde_dbt_tutorial/models/staging/stg_eltool__customers.sql, stg_eltool__orders.sql, stg_eltool__state.sql
3.3.4. Витрины
Витрины состоят из основных таблиц для конечных пользователей и таблиц, специфичных для данного бизнеса. В нашем примере у нас есть папка для отдела маркетинга, в которой определяется модель, запрошенная отделом маркетинга.
3.3.4.1. Ядро
Ядро определяет модели фактов и измерений, которые будут использоваться конечными пользователями. Модели фактов и измерений материализованы в виде таблиц для повышения производительности при частом использовании. Модели фактов и измерений основаны на модели Кимбелла.
- Определения тестов: sde_dbt_tutorial/models/marts/core/core.yml
- Определения моделей: sde_dbt_tutorial/models/staging/dim_customers, fct_orders.sql
dbt предлагает четыре общих теста: уникальный, not_null, accept_values и отношения. Мы можем создавать одноразовые (также известные как заказные) тесты в папке Tests. Давайте создадим тестовый скрипт sql, который проверяет, не дублируются ли какие-либо строки клиентов или не пропущены ли они. Если запрос возвращает одну или несколько записей, тесты не пройдут. Разбор этого сценария оставлен читателю в качестве самостоятельного упражнения.
3.3.4.2. Маркетинг
В этом разделе мы определяем модели marketing для конечных пользователей. У проекта может быть несколько бизнес-вертикалей. Наличие одной папки для каждой вертикали бизнеса обеспечивает простой способ организации моделей.
- Определения тестов: sde_dbt_tutorial/models/marts/marketing/marketing.yml
- Определения моделей: sde_dbt_tutorial/models/marts/marketing/customer_orders.sql
3.4. Запуск dbt
У нас есть необходимые определения модели. Давайте создадим модели.
dbt snapshot
dbt run
...
Finished running 4 view models, 2 table models ...
Для модели stg_eltool__customers требуется модель snapshots.customers_snapshot Но моментальные снимки не создаются при запуске dbt, поэтому сначала мы запускаем dbt snapshot .
Наши промежуточная и маркетинговая модели представлены в виде материализованных представлений, а две основные модели материализованы в виде таблиц.
Команду моментального снимка следует выполнять независимо от команды запуска, чтобы поддерживать актуальность таблиц моментальных снимков. Если таблицы моментальных снимков устарели, модели будут неверными. В пользовательском интерфейсе dbt cloud UI есть мониторинг свежести снимков.
3.5. Тест dbt
Определив модели, мы можем запустить на них тесты. Обратите внимание, что, в отличие от стандартного тестирования, эти тесты запускаются после обработки данных. Вы можете запускать тесты, как показано ниже.
dbt test
...
Приведенная выше команда запускает все тесты, определенные в проекте. Вы можете войти в хранилище данных, чтобы увидеть модели.
pgcli -h localhost -U dbt -p 5432 -d dbt
# password is password1234
select * from warehouse.customer_orders limit 3;
\q
3.6. Документы dbt
Одной из мощных функций dbt является его документация. Чтобы сгенерировать документацию и обслуживать ее, выполните следующие команды:
dbt docs generate
dbt docs serve
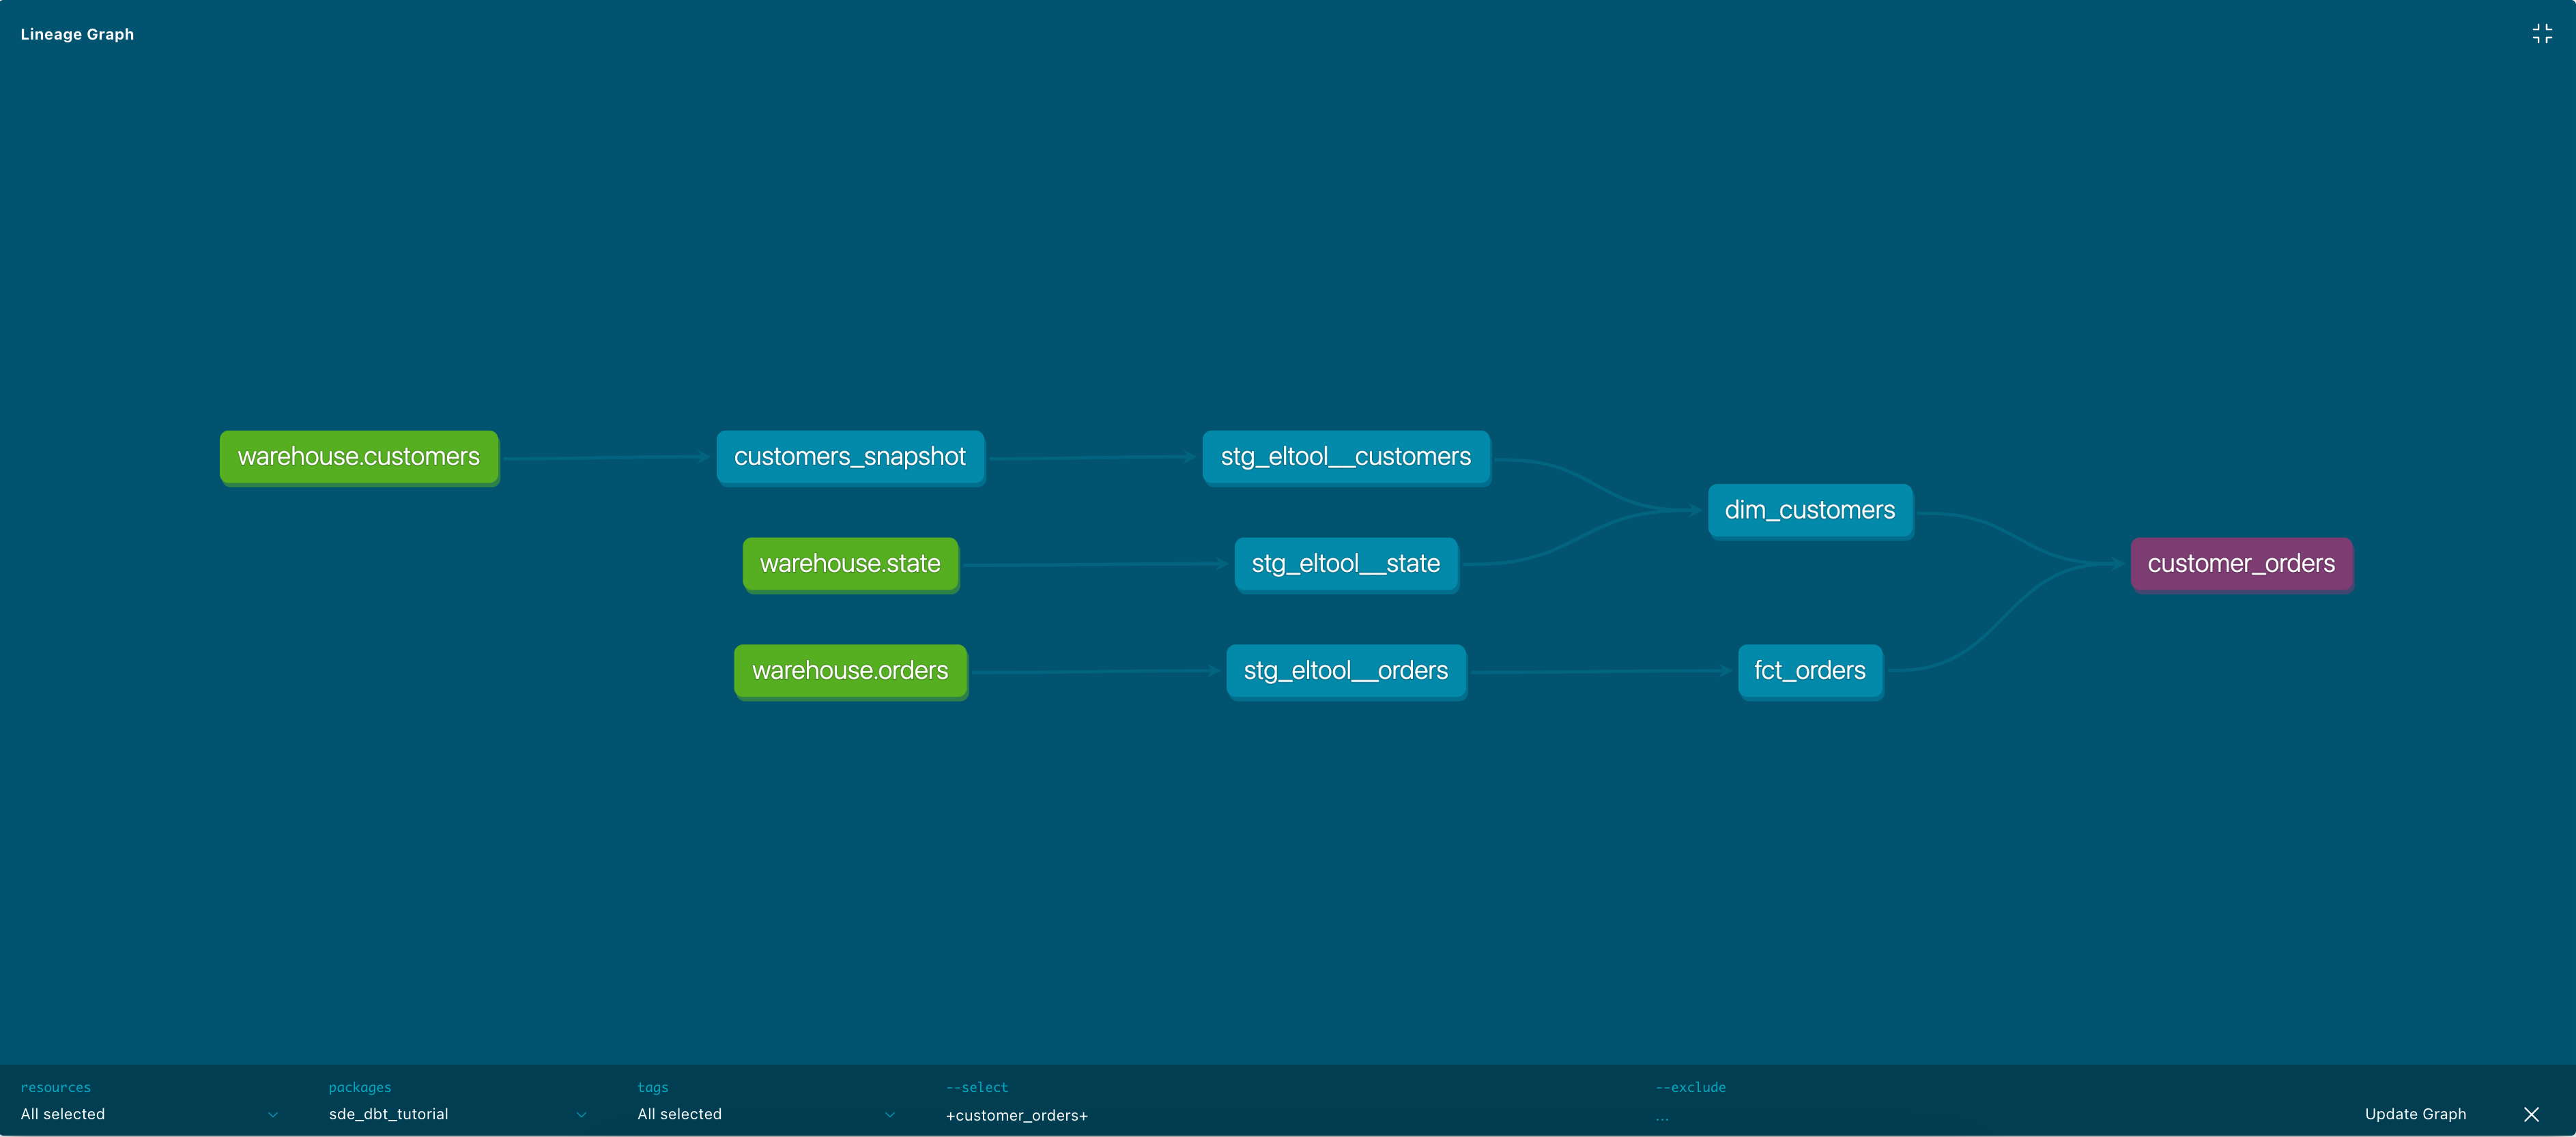
Вы можете посетить http://localhost:8080 чтобы увидеть документацию. Перейдите к customer_orders в проекте sde_dbt_tutorial на левой панели. Нажмите на значок графика родословной в правом нижнем углу. График происхождения показывает зависимости модели. Вы также можете увидеть определенные тесты, описания (установленные в соответствующем файле YAML) и скомпилированные операторы sql.
3.7. Планирование
Мы увидели, как создавать снимки, модели, запускать тесты и генерировать документацию. Все эти команды выполняются через cli. dbt компилирует модели в SQL-запросы в целевой папке (не является частью репозитория git) и выполняет их в хранилище данных.
Чтобы запланировать прогоны, снимки и тесты dbt, нам нужно использовать планировщик. Облако dbt — отличный вариант для удобного планирования. Команды dbt могут запускаться другими популярными планировщиками, такими как cron, Airflow, Dagster и т. д.
4. Выводы
dbt — отличный выбор для создания конвейеров ELT. Сочетая передовой опыт работы с хранилищами данных, тестирование, документацию, простоту использования, CI/CD данных, поддержку сообщества, и отличное облачное предложение, dbt зарекомендовал себя как важный инструмент для инженеров данных.
Итак, мы прошли следующие темы:
- Структура проекта dbt
- Настройка соединений
- Генерация SCD2 (также называемых моментальными снимками) с помощью dbt
- Создание моделей в соответствии с лучшими практиками
- Тестирование моделей
- Создание и просмотр документации
dbt может помочь вам сделать ваши конвейеры ELT стабильными и увлекательными.


