

Дедупликация данных в хранилищах и витринах: архитектура, механизмы и практика на стеке ClickHouse
Аннотация и цели исследования
Дедупликация данных представляет собой системную задачу обеспечения уникальности записей в контексте многократно загружаемых источников, асинхронной вставки и развилок архитектуры дата‑инженерии. В условиях централизованных хранилищ данных и витрин, основанных на колоночной архитектуре ClickHouse, дубликаты приводят к искусственному росту объёма данных, перерасходу вычислительных ресурсов и, что наиболее критично, к рассогласованию бизнес‑метрик и аналитических выводов. В данной работе исследуется целостный подход к проектированию архитектуры дата‑аналитики, где дедупликация выступает не только техническим трюком, но и частью методологии управления качеством данных. В центре анализа - встроенные механизмы ClickHouse: табличный движок MergeTree и его вариации, особенно ReplacingMergeTree, а также синтаксис и принципы применения OPTIMIZE с опциями BY, EXCEPT и FINAL. По мере разворачивания концепций будет приведено практическое руководство по проектированию ETL/ELT процессов, выбору стратегий сортировки и версий, а также моделям интеграции with внешними системами, такими как CDC‑потоки, PeerDB и очереди загрузки данных. Основная цель исследования - сформулировать целостный паттерн дедупликации, который обеспечивает целостность бизнес‑данных, минимизирует задержки и не создаёт узких мест в эксплуатации DWH и витрин на стеке ClickHouse.
Контекст проблемы дублирования данных в хранилищах и витринах
Дубли возникают по разным причинам: повторная загрузка источников, отсутствие единых правил идентификации записей, расхождение в правилах очистки и стандартизации, а также сбои сети или систем, приводящие к повторной отправке данных. В контексте витрин и хранилищ данные нередко попадают в несколько слоёв через ETL или ELT конвейеры, что создает параллельные копии одних и тех же фактов. В результате аналитики видят разные значения по одной и той же бизнес‑сущности в разных витринах - например, различия между агрегатами продаж в витрине продаж по дням и в витрине по клиентам с другим уровнем детализации. Этим сопровождается не только рост хранения, но и риск рассогласования между источниками, где маркетинговые и финансовые модели используют идентичные события, но с разной детализацией и точностью. В реальной практике дедупликация становится незаменимым этапом подготовки данных к загрузке в DWH и витрины: она поддерживает единое «словарное» представление данных и обеспечивает консистентность при объединении данных из разных источников.
С точки зрения архитектуры ClickHouse дубли могут появляться из‑за асинхронной вставки и репликации между узлами, а также из-за отсутствия явных ограничений уникальности в базах данных. Эти особенности требуют специально спроектированных механизмов дедупликации на уровне движков и запросов, чтобы не полагаться исключительно на внешние ETL‑процессы. По сути, дедупликация должна быть встроенной частью конвейера подготовки данных: от источников до витрины, с учётом особенностей архитектуры ClickHouse и бизнес‑потребностей в немедленной доступности корректной информации.

Теоретическая база: целостность данных, уникальные ключи и уровни детализации
Целостность данных - фундаментальная характеристика любого аналитического стека. Она достигается через согласование правил идентификации записей, единых форматов и непротиворечивых понятий о детализации. В контексте реляционных и колоночных систем целостность охватывает как физическую сторону хранения (доступность уникальных записей в каждом ключе и партиции), так и семантику бизнес‑логики (одинаковые события не должны трактоваться по‑разному в разных витринах).
Ключевые понятия:
- Уникальный ключ и первичный ключ (PK) - концепты, которые в ClickHouse не являются жесткими ограничениями для большинства движков. В реалиях MergeTree‑семейства они реализуются через ORDER BY и PARTITION BY, а также через дополнительные параметры.
- Виртуальные ключи сортировки - набор столбцов, по которым выполняется физическая сортировка внутри частей данных. Именно этот порядок задаёт детальностную «гранулярность» в рамках конкретной таблицы.
- Уровни детализации - от фактов (микроуровень, запись о продаже за минуту) до агрегатов (день, недельные кумуляты) и долей переходных уровней (окна, витрины с разной степенью агрегации). В контексте дубликатов важно обеспечить согласование по агрегируемым уровням, иначе дубликаты могут «протекать» через витрины с разной степенью детализации, создавая несовместимые метрики.
- Уровни конформности и lineage - концепции консолидированной семантики данных, где ключевые сущности (клиент, товар, период) приводятся в единый набор идентификаторов и правил очистки. Это снижает риск дублирования при интеграции источников и поддерживает единое ядро интеграции.
Теоретически дубликаты можно рассматривать как нарушение целостности данных на уровне идентификационных правил и детализированных условий уникальности. Архитектура дедупликации должна опираться на:
- корректное определение и согласование уникальных ключей на источниках;
- проектирование ORDER BY и PARTITION BY так, чтобы они соответствовали бизнес‑логике и требуемой консистентности;
- наличие механизмов версии записей (версионности) для выбора актуальной записи при наличии дубликатов;
- средства контроля качества на входе (правила очистки данных, стандартизации, нормализации).
Архитектура дата‑аналитики: источники, DWH, витрины и ETL/ELT процессы
Современная архитектура дата‑аналитики строится как многоуровневая конвейерная система, где данные проходят через источники, стейджинг/лупку, DWH и витрины. В контексте дедупликации важны следующие уровни и принципы:
-
Источники данных: операционные системы, ERP/CRM, сторонние сервисы и CDC‑потоки. Источники должны предоставлять понятные идентификаторы и правила идентификации.
-
Landing/Stage‑слой: здесь данные временно принимаются, выполняются первичные проверки качества, нормализация форматов и привязка к общим справочникам. Здесь же можно реализовать первые этапы дедупликации на уровне источников, чтобы к концу ETL/ELT конвейера попадали «чистые» данные.
-
Интеграционный слой: консолидирует данные из разных источников, реализуя соглашения об идентификации, единые справочники и сопоставления. Этот слой особенно критичен для избежания дублей при интеграции источников с разными правилами идентификации.
-
DWH (Data Warehouse) на стеке ClickHouse: хранение фактов, размерных таблиц и полисов консолидации. Kлючевые вопросы: как обеспечить эффективную загрузку с минимальными дублями; как выбрать параметры ORDER BY и PARTITION BY; как организовать хранение версий и как применить дедупликацию в процессе хранения.
-
Витрины данных: тематические представления данных для бизнес‑пользователей и аналитиков. Часто витрины имеют разные уровни детализации, что требует аккуратной синхронизации и согласования по конформности. Витрины должны опираться на единый источник правды и использовать единые правила идентификации для снижения риска дубликатов.
-
ETL/ELT процессы: современные подходы - это сочетание вытягивания данных из источников (Extract), преобразования (Transform) и загрузки (Load). В ELT подходе преобразование происходит в SQL внутри хранилища, что делает дедупликацию неотъемлемой частью конвейера и позволяет реализовать её с использованием возможностей движков ClickHouse.
-
Контракты данных и мониторинг: важна документированная спецификация структур данных, контрактов на обновления и контроля изменений. Мониторинг задержек загрузки, количества дублей и метрик качества данных - критический элемент производственного цикла.
Суммарно архитектура должна обеспечивать единый путь потока данных от источников к витринам, при этом встроенные механизмы дедупликации в ClickHouse должны поддерживать целостность на уровне хранения и ускорять конвергенцию данных с минимальными издержками.
Декомпозиция технических компонентов и их взаимодействие в системах дедупликации
Дедупликация не сводится к единственному движку или одному запросу. Это системный набор взаимосвязанных компонентов:
-
Движки таблиц и их режимы: MergeTree, его модификации и особенности. В частности, ReplacingMergeTree позволяет удалять дубли по ключу сортировки во время фоновых операций слияния частей данных.
-
Ключи сортировки и партиционирования: ORDER BY задаёт сортировку и определяет, как данные распределяются по частям; PARTITION BY задаёт границы партиций. Эти параметры напрямую влияют на эффективность слияний и на вероятность столкновения дублей в рамках одной партиции.
-
Механизмы фоновых процессов: слияния частей данных выполняются внутри системы, но не управляются пользователем напрямую (кроме команды OPTIMIZE). Этот фоновой характер требует планирования времени слияний, чтобы минимизировать задержку консистентности.
-
Контроль версий: параметр ver в ReplacingMergeTree позволяет сохранить последнюю запись по ключу сортировки в зависимости от версии. Это даёт механизм выбора актуального состояния при наличии дубликатов.
-
Веб‑ориентированные или CQRS‑паттерны: взаимодействие между микро‑сервисами, которые вставляют данные, и аналитику, которая читает их в витринах. В этом контексте важно обеспечить idempotence и контроль задержек через логику конвейера.
-
CDC и интеграционные слои: Change Data Capture (CDC) обеспечивает захват изменений в источниках и передачу их в ClickHouse без повторной загрузки. PeerDB - пример инструмента, который обеспечивает перенос данных между PostgreSQL и ClickHouse, часто с учетом дубликатов и консистентности. Очереди загрузки (Kafka, RabbitMQ и т. п.) помогают упорядочить поток изменений и могут служить точками контроля повторной отправки.
-
Мониторинг и качество данных: системы мониторинга дублей, частоты повторной загрузки, задержек и корректности интеграции. Метрики качества должны быть встроены в конвейеры и позволять оперативно выявлять причины повторной загрузки.
Эти элементы взаимодействуют следующим образом: CDC и очереди создают корректный поток изменений; движки ClickHouse обрабатывают вставки и выполняют дедупликацию на уровне хранения; ETL/ELT процессы обеспечивают согласование правил очистки и стандартов; витрины синхронизируют данные с единым базовым набором идентификаторов. Данный подход позволяет минимизировать дубли на входе и на выходе витрин, сохранив в целостной форме бизнес‑правила и метрическую согласованность.
Дедупликация в ClickHouse: MergeTree и ReplacingMergeTree
ClickHouse как колоночная база данных ориентирована на быстрый анализ больших объемов данных. В рамках этого стека дедупликация реализуется через два основных механизма: характерный для целого семейства MergeTree и его конкретной реализации ReplacingMergeTree. В исходном материале отмечалось следующее: дубли в ClickHouse могут возникать из‑за асинхронной вставки и при репликации между узлами. В контексте дедупликации ключевым становится факт, что ClickHouse не поддерживает явные ограничения уникальности на уровне базы по умолчанию. Именно поэтому надёжная дедупликация реализуется через механизмы движков и запросов.
Движок MergeTree - это базовая структура, обеспечивающая хранение и поиск в таблице, но он не удаляет дубли автоматически. Важной особенностью ReplacingMergeTree является удаление дублей по значению ключа сортировки, который задаётся через ORDER BY в DDL‑запросе CREATE TABLE. Это не первичный ключ, а именно сортировочный ключ, который определяет уникальность в рамках слияния частей данных. Важно понимать, что удаление дублей происходит во время фоновых процессов слияния частей, а не мгновенно при вставке. Это означает, что дубликаты могут временно находиться в таблице, пока фоновые задачи не приведут к объединению и устранению повторов.
Тема слияний и фоновых процессов требует внимания к детальным особенностям:
- Слияние частей - это процесс перераспределения данных внутри движка, который оптимизирует хранение и поиск. Оно запускается автоматически, но может быть инициировано явно с помощью команды OPTIMIZE. Однако оптимизация не устраняет причину появления дублей и действует как механизм консолидации, а не как превентивная мера.
- Этапы удаление дублей: процесс удаления дублей в ReplacingMergeTree осуществляется посредством слияния данных и отбора последней записи в рамках уникального ключа сортировки. Фактически, после слияния остаётся только одна запись для каждого набора значений по ключу сортировки в рамках каждой партиции.
- Версионность: наличие дополнительного столбца версии (ver) в качестве параметра движка позволяет более гибко управлять тем, какая запись остаётся в таблице после слияний: если задан ver и она меняется во вставках, последняя по времени вставка может стать финальной записью для конкретного ключа сортировки. Вариант без ver оставляет последнюю запись в рамках последнего состояния слияния.
Таким образом, дубли в ClickHouse можно устранять с помощью встроенных механизмов: ReplacingMergeTree и OPTIMIZE, но их применение требует осознанного проектирования схем и конвейеров, чтобы дубликаты не попадали в хранилище на этапе загрузки и не задерживали аналитическую обработку.
Механизмы удаления дублей: принципы слияния частей и роль фоновых процессов
Основа механизма удаления дублей в ClickHouse лежит в принципах слияния частей. В рамках движка ReplacingMergeTree часть данных хранится в отдельных фрагментах (частях). В ходе фонового слияния части объединяются, и для каждого уникального набора значений ключа сортировки выбирается одну запись. Важные моменты:
- Фоновое слияние управляется внутренними механизмами СУБД и может происходить в неопределённое время. Это позволяет системе оставаться эффективной, но требует понимания задержек между вставкой данных и их консолидацией.
- Команда OPTIMIZE может запускать принудочное слияние и, соответственно, принудительно корректировать наличие дублей. Однако это место не идеальное для регулярной эксплуатации, поскольку OPTIMIZE вовлекает значительный объём чтения и записи и может повлечь крупные нагрузочные пики.
- Наличие параметра ver в ReplacingMergeTree позволяет детализировать поведение: если ver задан, то после слияния остаётся запись с максимальной версией, что соответствует идее «последней версии» для уникального ключа сортировки. Без ver система выбирает последнюю запись в рамках самой последней вставки, что обеспечивает простую линеарную логику обновления данных.
Эти принципы определяют стратегию дедупликации: сочетание фоновых слияний и периодических принудительных вызовов OPTIMIZE позволяет достигнуть требуемого баланса между задержкой консистентности и экономией ресурсов. В случае задач с критической задержкой консистентности, рекомендуется применять дополнительные методы контроля качества данных на этапе источников и в процессе ETL/ELT, чтобы минимизировать необходимость частой дедупликации во внешних слоях.
Роль параметров сортировки и версий: ORDER BY, ключи, ver
ORDER BY в DDL ClickHouse создаёт набор столбцов, по которым таблица физически сортируется внутри частей. Этот выбор определяет:
- как данные будут упорядочены внутри каждой части;
- каковы будут условия для детерминированного удаления дублей при слиянии;
- какие запросы будут наиболее эффективны для выборок и агрегатных операций.
Ключевые принципы:
- Сортировка должна отражать бизнес‑логическую уникальность по сочетанию колонок, которые используются как часть уникальности дубля. В идеале она должна совпадать или дополнять набор ключей, которые вы используете для идентификации дубликатов.
- Части данных с одинаковыми ключами сортировки будут объединяться в процессе слияния, что позволяет эффективно удалять дубли. Однако если ключи сортировки не охватывают все колонки, в которых дубликаты могут быть обнаружены, то дубликаты в других столбах могут сохраняться до следующего слияния.
- PARTITION BY - разбиение на партиции. Это влияет на параллелизм и скорость слияний между частями. Разделение по дате часто соответствует регулярному графику активности и позволяет параллельно обрабатывать дублевые записи в разных периодах.
Версионность (параметр ver) добавляет дополнительную информацию о временной последовательности изменений. Если ver указан, движок сохраняет только запись с максимальной версией в рамках уникального ключа сортировки после слияний. Это даёт возможность реализовать поведение «последняя запись по времени» при конфликте между дубликатами с разными версиями. При этом, если несколько записей имеют одинаковую версию, выбирается последняя вставка, что обеспечивает консистентность в режиме строгой версионности.
Выбор конфигурации ORDER BY и опций ver должен основываться на бизнес‑правилах и анализе паттернов дубликатов. Хорошо спроектированная конфигурация позволяет минимизировать количество дублей ещё на этапе вставки и существенно снизить нагрузку на последующие операции дедупликации.
OPTIMIZE для дедупликации: синтаксис, BY, EXCEPT и FINAL
OPTIMIZE - ключевая команда для управления фоновыми процессами в ClickHouse. В контексте дедупликации она играет роль активатора, который может воздействовать на избранные части и таблицы семейства MergeTree, а также на MaterializedView и Buffer. В рамках дедупликации применимы следующие принципы:
- Базовый синтаксис:
OPTIMIZE TABLE table_name- инициирует верификацию и попытку выполнить слияние частей. - Дедупликация по ключам:
OPTIMIZE TABLE table_name DEDUPLICATE BY <columns>, где список столбцов должен включать столбцы, указанные в условиях сортировки ORDER BY и в условиях партиционирования. ВариантBY *означает дедупликацию по всем столбцам таблицы, что применяется редко из‑за высокой вычислительной нагрузки. - EXCEPT:
OPTIMIZE TABLE table_name DEDUPLICATE BY * EXCEPT (colX, colY)- позволяет исключить некоторые псевдонимы, копии и вещественные выражения, не являющиеся частью ключа уникальности. - FINAL:
OPTIMIZE TABLE table_name FINAL- выполняет полное объединение всех частей во всей таблице (не только видимой части), что обеспечивает глобальную консолидацию, но может потребовать существенных ресурсов.
Важно понимать ограничения:
- OPTIMIZE работает только для таблиц семейства MergeTree, а также для MaterializedView и Buffer.
- Он не устраняет причины дубли и может вызвать значительно большую загрузку I/O и вычислительной мощности.
- Версионная дедупликация посредством параметра ver может повлиять на поведение и выбор текущей записи, особенно если версии генерируются источниками или вставляются параллельно.
Практический подход к использованию OPTIMIZE состоит в сочетании периодических задач «Keep‑alive» и эволюционной стратегии, где основная дедупликация проводится на уровне движка, а OPTIMIZE применяется для периодических «сжатий» и координации слияний в рамках заданного интервала времени. Такой подход позволяет балансировать задержку консистентности, нагрузку на кластер и требования к точности бизнес‑метрик.
Практические кейсы дедупликации: данные о продажах
Развёртывание дедупликации на примере данных о продажах демонстрирует, как архитектурные решения превращаются в рабочие паттерны:
-
Пример таблицы:
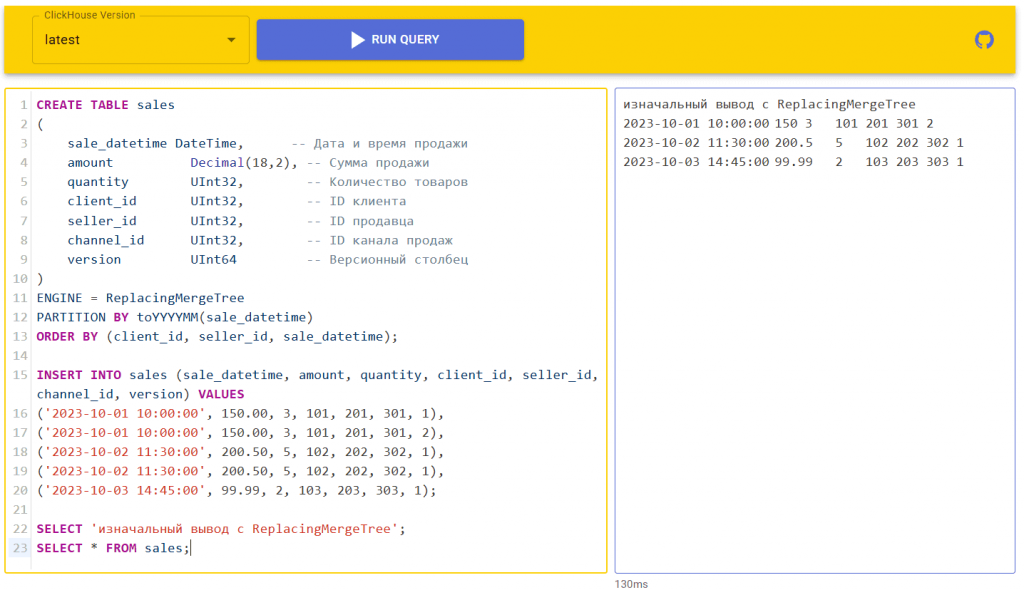
CREATE TABLE sales ( sale_datetime DateTime, amount Decimal(18,2), quantity UInt32, client_id UInt32, seller_id UInt32, channel_id UInt32, version UInt64 ) ENGINE = MergeTree PARTITION BY toYYYYMM(sale_datetime) ORDER BY (client_id, seller_id, sale_datetime); -
Вставка дубликатов:
В наборе могут повторяться строки продажи за одну и ту же дату и время, но с разными значениями version, или одинаковые значения по всем столбцам, что требует идентификации уникальности. -
Дедупликация через ReplacingMergeTree:
Выполнение дублирующих вставок и последующая смена движка наReplacingMergeTree(с версионностью, если применимо) ведёт к тому, что после слияния остаётся одна запись на каждый уникальный ключ сортировки. Это наглядно демонстрирует роль версии и фазы слияния. -
Примеры с ver:
В случае, когда версии увеличиваются (например, от 1 к 2), запись с максимальной версией для конкретной комбинации ключей сортировки останется после слияния. Это обеспечивает «последнюю» запись по времени изменений в рамках уникального набора ключей. -
Визуализация этапов:
Исходные данные, затем запуск OPTIMIZE с параметрами DEDUPLICATE BY и FINAL позволяет увидеть, как дубли отталкиваются и как остаются только уникальные комбинации. Важно помнить, что полное объединение всех частей может быть ресурсозатратным, поэтому планирование операций и мониторинг должны быть неотъемлемой частью производственной практики.
Таким образом, кейсы с данными о продажах демонстрируют практическую применимость паттернов дедупликации: от задумки в DDL‑уровне до применения OPTIMIZE и параметров версий, что обеспечивает надежную консистентность и корректную бизнес‑аналитику.
Эффекты дублей на целостность данных и бизнес‑метрики
Дубликаты приводят к ряду критических эффектов:
-
Заём ресурсов. Хранилище заполняется неэффективно, что увеличивает требования к хранилищу, сетевым ресурсам и времени вычислений. В большой среде это может привести к задержкам в цепочке конвейера и ухудшению доступности данных.
-
Расхождение в бизнес‑метриках. Дубликаты дают искаженные значения - например, пересчёт продаж или клиентов может вырасти многократно, если дубликаты появятся в витринах с высокой детализацией. Разная детализация витрин усиливает риск рассогласования между витринами.
-
Проблемы с качеством данных. В случае дубликатов данные теряют консистентность, аEt примеры согласования между маркетинговыми и финансовыми моделями могут стать неустойчивыми. Это снижает доверие к data‑driven управлению и усложняет принятие решений на уровне руководства.
-
Риски в управлении данными. Недостаточная интеграция источников и отсутствующие единые правила идентификации приводят к повторяемым ситуациям с дублями и требуют дополнительных операций дедупликации, что увеличивает временные задержки и риск ошибок.
-
Эффективность аналитики. С добавлением дублей в витрины, запросы становятся медленнее, что требует больше ресурсов на агрегацию и фильтрацию. В результате время до получения инсайтов увеличивается, что может повлиять на скорость бизнес‑решений.
Стратегическое значение дедупликации состоит в обеспечении единой правды и минимизации «разболтанности» между источниками и витринами. Это улучшает точность, полноту и своевременность бизнес‑метрик, что напрямую связано с качеством стратегических решений.
Интеграция технологий: CDC, PeerDB, очереди загрузки и миграции данных
Эффективная дедупликация требует взаимного согласования технологий и конвейеров. В контексте ClickHouse и современных архитектур дата‑инженерии применяются следующие подходы:
-
CDC (Change Data Capture) - механизм захвата изменений в источниках и передачи их в хранилище. CDC упрощает поддержку инкрементальных обновлений и позволяет избегать повторной загрузки тех же данных. В сочетании с дедупликацией CDC позволяет устанавливать более точный контроль за идентификацией изменений и слиянием версий.
-
PeerDB - пример интеграционного инструмента, обеспечивающего потоковую передачу данных между системами, например PostgreSQL и ClickHouse. PeerDB может сохранять логи изменений и помогать в управлении дублями, если поддерживает корректное сопоставление ключей и версий.
-
Очереди загрузки - Kafka, RabbitMQ и подобные технологии служат для буферизации событий и децентрализированного распределения изменений. Очереди помогают обеспечить идемпотентность процессов загрузки, поскольку повторная отправка одного и того же события может быть идентифицирована и отфильтрована.
-
Миграция данных - перенос данных между стеками требует сохранения согласованности и минимизации дубликатов на этапе миграции. В этом контексте дедупликация должна быть учтена в проектировании конвейеров миграции и в настройках стабилизации на выходе витрин.
Интеграция этих технологий наряду с движком ClickHouse образует устойчивый контур, где дубликаты снижаются до минимума ещё на входе, а на выходе витрины обеспечивают единый набор достоверных данных. Важно помнить, что CDC и очереди должны быть правильно конфигурированы, чтобы не повторно отправлять уже обработанные события и не создавать дополнительных дублей транзакционных данных.
Интеграция стеков и синергия между ClickHouse и внешними системами
Согласованность между ClickHouse и внешними системами достигается через:
-
Определение контрактов данных - это документированные форматы, схемы и правила идентификации. Контракты позволяют обеспечить единый язык обмена данными между источниками и витринами, что снижает риск дублирования на границе конвейера.
-
Согласование стратегий обновления - какие данные обновляются, как отображаются версии, и как обрабатываются конфликты. Это снижает вероятность несогласованных изменений.
-
Управление версиями и идентификаторами - наличие единого наборa идентификаторов для ключевых сущностей. Это позволяет корректно сопоставлять записи между системами и предотвращать дубликаты при интеграции.
-
Механизмы мониторинга и оповещения - интегрированные метрики для дублей, задержек и времени консолидации частей. Быстрая реакция на рост дублей позволяет оперативно корректировать HPD (high‑priority data) и улучшать качество обработки.
-
Инструменты ETL/ELT и orchestration - задача состоит не только в применении движка, но и в эффективной координации надстроек, задач и зависимостей. Хорошие оркестраторы способны минимизировать риск повторной загрузки и контролировать время выполнения.
Синергия таких подходов обеспечивает устойчивые процессы и позволяет аналитикам и ИТ‑директорам не только достигать требуемой точности, но и поддерживать высокий темп изменений в бизнес‑моделях и источниках данных. В рамках практики предполагается поддержка единых конвейеров, которые интегрируют ClickHouse с внешними системами, способствуя консолидации данных и минимизации дублей.
Возможности применения дедупликации в различных экономических секторах
Дедупликация данных в контексте кластера ClickHouse и витрин имеет универсальную применимость:
-
Розничная торговля - единое ядро данных для продаж, клиентов и товаров, согласование витрин по дням, неделям и по различным уровням детализации. Дедупликация обеспечивает точность reklam и сегментирования, улучшая качество аналитики по продажам и клиентской активности.
-
Финансовый сектор - требование строгой консистентности для регуляторной отчетности и риск‑менеджмента. Версионированная дедупликация помогает сохранять актуальные транзакции и обеспечивает точное соответствие между разными витринами.
-
Телематика и телекоммуникации - обработка больших потоков событий и метрик. Устойчивые паттерны дедупликации позволяют управлять миллионами событий, сохраняя качество метрик и поддерживая своевременную аналитику.
-
Производство и цепочки поставок - интеграция данных по запасам, производственным мощностям и логистике. Дедупликация помогает предотвращать расхождения между источниками и витринами, особенно при обновлениях параллельными поставщиками.
-
Медицина и здравоохранение - работа с клиническими данными и административной статистикой. Единая версия и консолидация по пациентам, процедурам и результатам лечения обеспечивает корректность анализа отраслевой эффективности и качества услуг.
Каждый сектор предъявляет свои специфические требования к детальности, задержке и уровням консолидации. В рамках дедупликации следует учитывать эти требования и настраивать параметры сортировки, версий и слияний под конкретные бизнес‑потребности.
Анализ рисков, уязвимостей и ограничений с метриками эффективности
Риск‑модель дедупликации включает в себя несколько аспектов:
-
Ошибки в правилах идентификации. Несоответствие между правилами уникальности и фактическими данными может привести к пропуску дублей или, наоборот, к удалению уникальных записей.
-
Ресурсные ограничения. Фоновые слияния и OPTIMIZE потребуют времени и вычислительных ресурсов. В базах с большими объёмами данных это может привести к задержкам и временному росту нагрузки.
-
Риск рассогласования между витринами. Неправильно спроектированная дедупликация может приводить к рассогласованию между витринами, особенно если витрины используют разные уровни детализации или разные правила идентификации.
-
Ограничения ClickHouse. Отсутствие строгих ограничений уникальности на уровне таблиц по умолчанию требует проектирования дедупликации на уровне движков и конвейеров. Это означает, что корректность дедупликации зависит от дизайна архитектуры и качества данных.
-
Риск задержки консистентности. В зависимости от частоты фоновых слияний, на некоторое время дубль может присутствовать в таблице, что может влиять на бизнес‑аналитику и отчёты.
Метрики эффективности дедупликации помогают количественно оценить влияние:
- Точность (precision) - доля удалённых дублей, которые действительно были дубликатами; показывает, насколько дедупликация не удаляет уникальные записи.
- Полнота (recall) - доля всех дублей, фактически существовавших в данных, которые были удалены; показывает полноту процесса.
- Задержка консолидации - время от вставки до того момента, когда дубль удалён средствами дедупликации.
- Ресурсоёмкость - объём вычислительных и дисковых ресурсов, затрачиваемых на дедупликацию (чтение/запись, операции слияния).
- Влияние на точность бизнес‑метрик - анализ целей: каким образом дедупликация повлияла на итоговые показатели.
Эти метрики должны использоваться как часть SLA по данным и как основа для улучшения конфигураций и политики загрузки.
Метрики эффективности дедупликации: точность, полнота, задержка, ресурсоемкость
Чтобы управлять качеством дедупликации, следует внедрить набор метрик:
-
Точность (precision) дедупликации - доля удалённых дублей, которые действительно были дубликатами.
Как измерять: сравнить набор удалённых записей с валидируемым набором дублей в исходных данных. -
Полнота (recall) дедупликации - доля обнаруженных дублей по отношению к общему числу дублей в данных.
Как измерять: после применения дедупликации сравнить суммарное число дублей с оценочным реестр дублей. -
Задержка консолидации - временной интервал от момента вставки дубля до момента его удаления средствами дедупликации.
Как измерять: регистрировать таймстемпы вставок и последующих удалений. -
Ресурсоёмкость - совокупные затраты на CPU, IO и дисковое пространство, связанные с дедупликацией.
Как измерять: собирать метрики узлов кластера и вычислить среднюю/пиковую нагрузку. -
Эффект на бизнес‑метрики - изменение точности ключевых показателей после внедрения дедупликации.
Как измерять: сравнить метрики до и после внедрения, с учётом ожидаемого влияния дедупликации на данные. -
Время отклика конвейера - задержка между поступлением записи и её полной обработкой в режиме дедупликации.
Как измерять: мониторинг времени обработки от входной точки до витрины.
Метрики должны быть частью контракта на качество данных и интегрированы в мониторинг кластера. Они позволяют принимать обоснованные решения о частоте выполнения OPTIMIZE, выборе ключевых столбцов для DEDUPLICATE BY и параметров FINAL, а также об уровне параллелизма и пространства для партиционирования.
Конкурентный анализ решений и их дифференциация
С точки зрения дедупликации и управления уникальностью данных, ряд решений и движков конкурируют на рынке. В контексте ClickHouse главным дифференциатором остаётся гибкость движков семейства MergeTree и возможность использования ReplacingMergeTree с версионной архитектурой. По отношению к альтернативам:
-
ClickHouse vs другие колоночные базы данных: ClickHouse обеспечивает быструю аналитическую обработку и эффективную дедупликацию в рамках движков, однако некоторые другие СУБД могут предлагать более жесткие ограничения уникальности на уровне схемы, что простимулирует иной подход к данным. В частности, системы с функциональностью первичных ключей (PK) и уникальных ограничений могут меньше полагаться на архитектуру дедупликации на стороне хранения, но могут потребовать более строгой подготовки данных на входе.
-
Дедупликация в DWH‑платформах: в некоторых системах (например, в рамках других коммерческих DWH решений) существует встроенная поддержка уникальных ограничений и процессов дефрагментации, что упрощает управление дублями. Однако эти системы могут иметь меньшую гибкость в аспектах настройки сортировки и версии по сравнению с ClickHouse.
-
Интеграционные решения и CDC: инструменты CDC, такие как Debezium, Maxwell или собственные инструменты интеграции, часто могут работать в тандеме с ClickHouse для обеспечения аккуратной интеграции изменений. В этом случае дедупликация в ClickHouse выступает финальным этапом, который приводит к консолидации данных для витрин.
-
Альтернативные архитектурные подходы: такие как детерминированная загрузка с помощью «идемпотентных» вставок, применение строгих контрактов и конвейеров с минимизацией повторной отправки. Это может снизить необходимость частых операций дедупликации, но требует более детального проектирования на уровне источников.
Ключевой вывод: дифференциация решений достигается через сочетание стратегий проектирования схем и конфигураций движков (ORDER BY, PARTITION BY, ver), грамотной интеграции CDC/PeerDB/очередей и постоянного мониторинга эффективности дедупликации. В рамках этого паттерна ClickHouse остаётся очень эффективной платформой для дедупликации, если архитектура и конвейеры спроектированы с учётом специфики дублей и бизнес‑потребностей.
Практические рекомендации по проектированию ETL/DWH для дедупликации
-
Определение контрактов данных: заранее документируйте уникальные ключи, политики версий и правила очистки. Это препятствует появлению дублей на входе.
-
Архитектура на уровне источников: старайтесь минимизировать повторную загрузку и организуйте idempotent‑инсерты. Это снизит необходимость в больших операциях дедупликации.
-
Выбор ключей сортировки и версий: проектируйте ORDER BY так, чтобы он отражал уникальность данных и поддерживал версионность, если она нужна для бизнес‑логики.
-
Встраивание версионности: используйте версионный параметр ver там, где это уместно, чтобы обеспечивать «последнюю» запись по уникальному ключу сортировки.
-
Планирование слияний: учитывайте фоновые механизмы слияния и ориентируйтесь на минимизацию задержек консистентности. Используйте FINAL в случаях, когда необходима полная консолидация.
-
Оптимизация запросов: применяйте DEDUPLICATE BY к столбцам, которые являются частью ключей сортировки и партиционирования, избегая избыточной нагрузки на систему.
-
Мониторинг и тестирование: внедрите показатели для дублей, задержек и точности метрик. Регулярно тестируйте архитектуру на тестовых данных, включая контроль дублей.
-
Интеграция CDC/PeerDB/очередей: выстраивайте конвейеры так, чтобы повторная отправка данных была минимизирована и могла быть детектирована заранее. Контролируйте idempotence и консистентность потоков изменений.
-
Риск‑менеджмент: заведомо планируйте ресурсы для операций дедупликации и имейте резерв на пиковые сценарии, когда дублей возникает больше обычного.
-
Выбор подхода к витринам: учитывайте различия в детализации между витринами и выстраивайте единые правила идентификации, чтобы уменьшать риск рассогласований между витринами.
Заключение и направления будущих исследований
Дедупликация в хранилищах и витринах на стеке ClickHouse представляет собой системный подход к обеспечению целостности данных и качественной аналитики. Внутренние механизмы движков MergeTree и ReplacingMergeTree, в сочетании с OPTIMIZE и параметрами версий, дают мощный набор инструментов для устранения дублей, но требуют осознанного проектирования схем, правил и конвейеров. Архитектура дата‑аналитики должна быть выстроена таким образом, чтобы дедупликация стала не отдельной операцией, а встроенной частью процессов загрузки и интеграции данных. Эффективность дедупликации достигается через грамотную настройку ORDER BY и PARTITION BY, применение версий, а также через хорошо спроектированные ETL/ELT конвейеры и надёжные механизмы интеграции (CDC, PeerDB, очереди).
Перспективы будущих исследований лежат в нескольких направлениях:
- Разработка автоматизированных методик выбора оптимальной конфигурации ORDER BY и PARTITION BY на основе анализа исторических дублей и бизнес‑потребностей.
- Разработка расширенных паттернов интеграции по данным и новых механизмов версии и сравнения дублей для разных витрин.
- Исследование влияния дедупликации на задержку в реальном времени и телеметрии производительности конвейеров.
- Повышение устойчивости к ошибкам на уровне источников и для CDC, включая новые способы отслеживания изменений.
- Применение машинного обучения для прогнозирования возникновения дублей и автоматизации корректировок правил идентификации и очистки.
В целом, дедупликация в контексте архитектуры ClickHouse должна рассматриваться как системный элемент, объединяющий архитектуру данных, операционные процессы и бизнес‑метрики. Убедительная реализация требует тесной координации между инженерией данных, аналитиками и бизнесом, а также продуманного выбора инструментов и методов на разных этапах конвейера. Продолжение исследований в этой области обещает ещё более совершенные подходы к контролю качества данных и к устойчивой аналитике на уровне всей организации.
Вопрос-Ответ:
-
Вопрос: Что представляет собой ключевой механизм дедупликации в ClickHouse и как он работает в ReplacingMergeTree?
Ответ: Ключевым механизмом является удаление дублей во время фоновых слияний частей данных. В движке ReplacingMergeTree дубликаты определяются по значениям ключа сортировки (ORDER BY). При слиянии частей выбирается одна строка для каждого набора значений ключа, обычно последняя по времени вставки, а если задан параметр ver, остаётся строка с максимальной версией. OPTIMIZE может инициировать принудительное слияние, но не устраняет причину появления дублей и может потребовать значительных ресурсов. -
Вопрос: Какой эффект имеет использование параметров BY и EXCEPT в OPTIMIZE для дедупликации?
Ответ: Параметр BY задаёт набор столбцов, по которым выполняется дедупликация. EXCEPT позволяет исключить из дедупликации определённые столбцы (например, псевдо‑выражения или колонки, не участвующие в условиях уникальности). Это даёт гибкость в настройке, чтобы не затронуть части таблицы, не связанные с уникальными ключами. -
Вопрос: Как выбор ORDER BY влияет на скорость и точность дедупликации?
Ответ: ORDER BY определяет, как данные физически организованы внутри частей и какие наборы дублей будут рассматриваться в процессе слияния. Грамотно подобранный ORDER BY обеспечивает эффективное обнаружение дублей и минимизацию перерасхода ресурсов на фоновое слияние, в то время как неправильный выбор может увеличить число дублей и задержки консолидации. -
Вопрос: В чем отличие между FINAL и обычным OPTIMIZE в контексте дедупликации?
Ответ: FINAL заставляет ClickHouse прочистить все части в таблице, применяя полное объединение данных и устранение дублей во всей таблице, что обеспечивает глобальную консолидацию. Обычный OPTIMIZE выполняет слияния частично и может пропустить часть данных, что приводит к более быстрой операции, но не гарантирует устранение дублей во всей таблице. -
Вопрос: Какие меры рекомендуется принять для предотвращения дубликатов на входе в ETL/ELT конвейер?
Ответ: Рекомендовано внедрить единые контракты данных, использовать идемпотентные вставки, применить CDC на источниках и обеспечить согласование правил идентификации записей и справочников. Это снизит вероятность появления дублей и сократит нагрузку на дедупликацию в ClickHouse. -
Вопрос: Какие отраслевые последствия могут возникнуть из‑за дублей в витринах данных?
Ответ: Дубли в витринах могут привести к искажению бизнес‑метрик, рассогласованию между витринами и неверной интерпретации рыночной динамики. Это может повлечь ошибочные управленческие решения и снижение доверия к данным. Поэтому дедупликация должна быть частью архитектурной стратегии и сопровождаться мониторингом и тестированием. -
Вопрос: Какие практики следует применить для требований к качеству данных при дедупликации?
Ответ: Внедрите четкие правила уникальности, используйте версионные решения, применяйте отложенную верификацию данных и анализируйте кейсы дублей в реальном времени. Включайте KPI для точности, полноты и задержки, чтобы своевременно выявлять проблемы и корректировать конвейеры. -
Вопрос: Какие направления будущих исследований наиболее перспективны для дедупликации в ClickHouse?
Ответ: Разработка автоматических методик выбора оптимальной конфигурации ORDER BY и PARTITION BY, исследование более гибких параметров версии и расширение интеграции с CDC и очередями загрузки, изучение методов предиктивной дедупликации и автоматического тестирования консистентности витрин.


