Управление сложностью данных через метаданные в dbt
В современном мире Big Data объемы информации растут в геометрической прогрессии. Традиционные подходы к управлению данными уже не справляются: ручные ETL-процессы, непрозрачные зависимости и отсутствие стандартов приводят к ошибкам, задержкам и огромным затратам на вычисления. Команды инженеров данных тратят львиную долю времени не на извлечение ценной аналитики, а на борьбу с последствиями хаотичной архитектуры.
Мы предлагаем принципиально иной подход. Мы не просто внедряем инструменты — мы внедряем культуру управления данными, основанную на автоматизации, стандартизации и полной прозрачности. Наше ключевое решение — построение надежных, масштабируемых и управляемых хранилищ данных на основе современного фреймворка dbt (data build tool) с глубокой интеграцией метаданных.
Насколько легко мы можем адаптировать наши текущие модели обработки данных?
Остановимся на движке Trino, который позволяет запускать SQL-запросы поверх большого количества файлов, которые лежат в облачном хранилище. То есть это Data Lake, где расчетный движок SQL отделен от хранилища файлов.
Облачное хранилище позволяет дешево хранить огромное количество данных в облаке, а Trino автоматически масштабируется в зависимости от объема данных, который нужно обработать. Это позволит нам за сравнительно небольшое время обработать колоссальные объемы данных!
Рассмотрим модель events_clean, которая удаляет дубли из таблицы:
{% set date = var("date", none) %}
select distinct
    user_id,
    "timestamp",
    type_id,
    {{ updated_at() }}
from
    {{ source("scooters_raw", "events") }}
where
{% if is_incremental() %}
    {% if date %}
        date("timestamp") = date '{{ date }}'
    {% else %}
        "timestamp" > (select max("timestamp") from {{ this }})
    {% endif %}
{% else %}
    "timestamp" < timestamp '2023-08-01'
{% endif %}
Это инкрементальная модель, обрабатывающая данные пачками (это делается для того, чтобы не перегрузить базу).
На данный момент данные разделяются на батчи так:
- при 1 запуске обрабатываются все события до 1 августа 2023 года
- при 2 запуске обрабатываются все оставшиеся события
- при 3 и последующем запусках запрос будет обрабатывать только новые события, которых пока нет в таблице
За поиск новых событий отвечает timestamp (select max("timestamp") from {{ this }}), который находит их по временной метке.
На первый взгляд, логика рабочая. Но при переходе на большие объемы данных (сотни гигабайт и терабайты) в таких системах, как Trino, Presto или Amazon Athena, эта модель раскрывает свои фатальные недостатки:
- Неэффективность и высокие затраты: условие "timestamp" > (select max("timestamp") from {{ this }}) заставляет движок выполнять полное сканирование всех исходных файлов (сканирование 500 ГБ), чтобы найти нужные строки. Это буквально сжигает вычислительные ресурсы и деньги.
- Непредсказуемость - размер каждой новой порции данных (инкремента) может быть разным. Один день — 5 ГБ, другой — 50 ГБ. Это может привести к превышению лимитов памяти и падению всего пайплайна.
- Скрытая бизнес-логика - критически важные параметры, такие как начальная дата обработки '2023-08-01', "зашиты" глубоко в коде. Их невозможно найти, понять или изменить без глубокого погружения в логику, что делает систему непрозрачной и сложной в поддержке.
Наше решение состоит в интеллектуальном инкрементальном обновлении на основе метаданных
Мы предлагаем перенести логику управления пайплайном из кода SQL в декларативные метаданные. Это делает процесс предсказуемым, эффективным и прозрачным.
Шаг 1: Подготовка данных и имитация лучших практик Big Data
Первым делом мы добавляем в исходные данные техническое поле date, которое является производным от временной метки.
Создаем модель models/events_prep.sql, которая подготовит сырые события для последующего анализа. Добавим колонку с датой события:
selectuser_id,"timestamp",type_id,date("timestamp") as "date"from{{ source("scooters_raw", "events") }}
В models/properties.yml создаем запись с конфигурацией:
- name: "events_prep"description: "User events prepared for following processing"config:materialized: "view"columns:- name: "date"description: |Date of event derived from timestamp.Imitates Hive-styled partitioning of events by date.It is needed for efficient incremental processing by engineswith partitioning support (i.e. Trino).
Материализуем представление в базе:
dbt build -s events_prep
Вот так теперь может выглядеть код новой модели events_clean_v2:
{% set date = var("date", none) %}select distinctuser_id,"timestamp",type_id,{{ updated_at() }},"date"from{{ ref("events_prep") }}where{% if is_incremental() %}{% if date %}"date" = date '{{ date }}'{% else %}"date" > (select max("date") from {{ this }}){% endif %}{% else %}"date" < date '2023-08-01'{% endif %}
Фильтрация теперь происходит не по "timestamp", а по "date", что уже гораздо лучше, чем было раньше.
Шаг 2: Создание мощных макросов для автоматизации
Далее мы разрабатываем и внедряем набор макросов, которые становятся мозгом нашего пайплайна.
Первый макрос, который нам нужен - это select_first_value, который позволяет выполнять запросы к базе данных на этапе компиляции dbt-модели.
Создаем файл macros/select_first_value.sql с кодом:
{%- macro select_first_value(query) -%}{%- if execute -%}{{ return(run_query(query).columns[0].values()[0]) }}{%- endif -%}{%- endmacro -%}
Затем извлекаем первую колонку, а из нее — первое значение, и возвращаем его на выход макроса функцией return. Это позволит нам т вытащить из базы любое скалярное значение, например, максимум/минимум или true/false в качестве ответа на вопрос.
Важно, что код обернут в условие if execute. Это необходимо сделать, потому что dbt компилирует каждую модель в 2 этапа:
- предварительный парсинг и компиляция для составления Data Lineage.
- Полная компиляция проекта для запуском материализации.
Не забудьте создать в файле macros/properties.yml запись для каталога данных:
- name: "select_first_value"description: "Query database and get first value from first column of result"arguments:- name: "query"type: "string"description: "SQL query to get scalar value from database during compilation"
Готово! Теперь вы можете использовать макрос select_first_value в любой модели!
Запустим элементарный запрос, чтобы просто убедиться в том, что макрос действительно работает:
dbt show --inline "select {{ select_first_value('select 111') }} * 2 as result"
Как dbt обрабатывает этот код:
- В момент компиляции кода с помощью макроса обрабатывается предварительный запрос select 111, возвращающий значение 111.
- Это значение подставляется в основной запрос и скомпилированный код выглядит следующим образом: select 111 * 2 as result
- dbt выполняет запрос и возвращает в консоль результат вычисления:
12:34:45 Previewing inline node:| result || ------ || 222 |
Теперь мы можем перейти к чему-то более сложному.
Возьмем проект магазина бутеров jaffle-shop-classic. Вот так выглядит фрагмент из файла models/schema.yml, который частично описывает модель customers:
models:- name: customersdescription: This table has basic information about a customer...
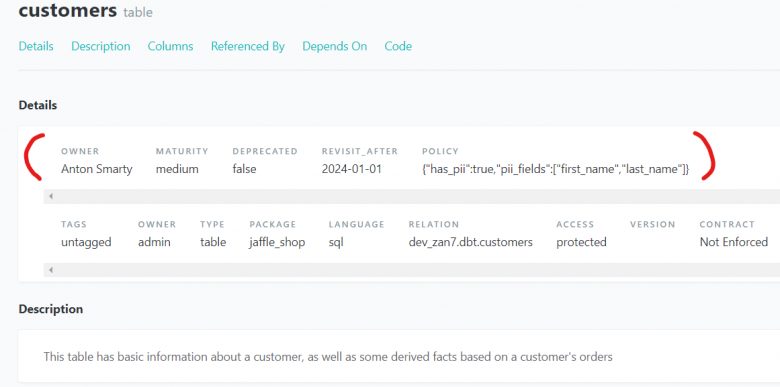
Добавим сюда поле config.meta для добавления к модели полезных метаданных:
models:- name: customersdescription: This table has basic information about a customer...config:meta:owner: "Anton Smarty"maturity: "medium"deprecated: falserevisit_after: "2024-01-01"pii_policy:has_pii: truepii_fields: [ "first_name", "last_name" ]
Все это автоматически представлено в каталоге данных:
Далее создаем макрос get_meta_value. Это ключевой компонент нашей архитектуры. Он позволяет любой модели или тесту считывать свою собственную конфигурацию из метаданных. Это устраняет необходимость "зашивать" параметры в код.
Создадим макрос macros/get_meta_value.sql с кодом Jinja:
{%- macro get_meta_value(model, meta_key, def_value="null") -%}{# Get meta value from model configuration #}{%- if execute -%}{# Graph object is available only during Run phase #}{% set model_node = (graph.nodes.values() |selectattr("resource_type", "equalto", "model") |selectattr("alias", "equalto", model.name) |first) %}{{ return(model_node.get("meta", {}).get(meta_key, def_value)) }}{%- else -%}{# During Parse phase, return default value #}{{ return(def_value) }}{%- endif -%}{%- endmacro -%}
Кроме того, опишем макрос в macros/properties.yml:
- name: "get_meta_value"description: "Get meta value from model configuration"arguments:- name: "model"type: "relation"description: "dbt model from which to retrieve the meta value"- name: "meta_key"type: "string"description: "Key from meta dictionary"- name: "def_value"type: "any"description: "Default value if key not found"
Теперь предлагаем создать макрос с инкрементальным фильтром и сохранить его в macros/incremental_date_condition.sql:
{%- macro incremental_date_condition(model,date=none,start_date=none,days_max=none,days_back_from_today=none) -%}{%- if date is not none -%}"date" = date '{{ date }}'{%- else -%}{%- set incrementality = get_meta_value(model, 'incrementality', {}) -%}{{ _incremental_date_condition_range(model=model,start_date=start_date,initial_start_date=incrementality.get('start_date', none),days_max=days_max or incrementality.get('days_max', 30),days_back_from_today=days_back_from_today or incrementality.get('days_back_from_today', 1)) }}{%- endif -%}{%- endmacro -%}
{%- macro _incremental_date_condition_range(model,start_date,initial_start_date,days_max,days_back_from_today) -%}{%- if start_date is none and execute -%}{%- if is_incremental() %}{%- set start_date_query -%}select max("date") + interval '1 day' from {{ model }}{%- endset -%}{%- set start_date = select_first_value(start_date_query) -%}{%- else -%}{%- if initial_start_date is none -%}{{ exceptions.raise_compiler_error("start_date or initial_start_date are required for initial non-incremental run") }}{%- endif -%}{%- set start_date = initial_start_date -%}{%- endif -%}{%- endif -%}"date" >= date '{{ start_date }}'and "date" < date '{{ start_date }}' + interval '{{ days_max }} day'and "date" <= current_date - interval '{{ days_back_from_today }} day'{%- endmacro -%}
По традиции добавим подробное описание макроса в файл macros/properties.yml:
- name: "incremental_date_condition"description: |Get incremental SQL condition by date column for incremental model.Macro uses parameters from 'incrementality' dictionary declared as meta of model.Arguments also can be specified as variables overriding meta configuration.arguments:- name: "model"type: "relation"description: "Incremental dbt model to fill with date condition"- name: "date"type: "string"description: |Particular date to compute.If specified it overrides other parameters and arguments.Format: 'YYYY-MM-DD'- name: "date_start"type: "string"description: |Start date for incremental run. First date of incremental batch.Format: 'YYYY-MM-DD'- name: "days_max"type: "integer"description: |Max size of incremental batch in days.Default: 30- name: "days_back_from_today"type: "integer"description: |Number of days to step back from current date for incremental batch.Allows to do not process incomplete data for current or recent dates.Default: 1
Далее создадим файл models/events_clean_v2.sql с кодом на основе нового макроса:
select distinctuser_id,"timestamp",type_id,{{ updated_at() }},"date"from{{ ref("events_prep") }}where{{ incremental_date_condition(model=this,date=var('date', none),start_date=var('start_date', none),days_max=var('days_max', none)) }}
По-прежнему крайне важно правильно сконфигурировать модель в файле models/properties.yml:
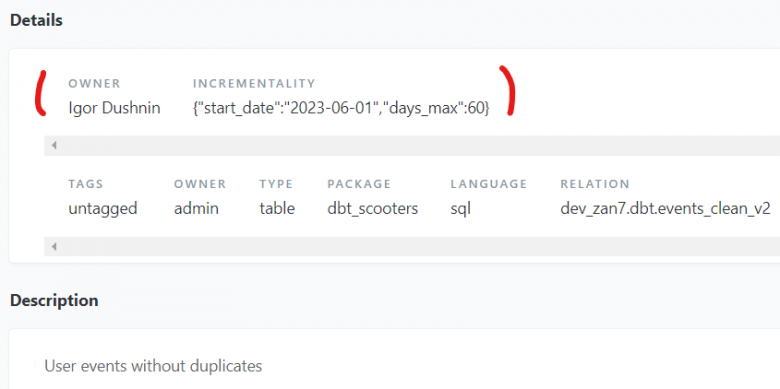
- name: "events_clean_v2"description: "User events without duplicates"config:materialized: "incremental"strategy: "merge"unique_key: [ "user_id", "timestamp", "type_id" ]meta:incrementality:start_date: "2023-06-01"days_max: 60
Теперь превратим модель в таблицу, анализируя ее скомпилированный код.
Поскольку изначально таблицы в базе не было, первый ее запуск автоматически создаст таблицу, содержащую первые 60 дней, начиная с 1 июня:
dbt build -s events_clean_v2
Скомпилированный код модели из папки target:
select distinctuser_id,"timestamp",type_id,now() as updated_at,"date"from"dev_zan7"."dbt"."events_prep"where"date" >= date '2023-06-01'and "date" < date '2023-06-01' + interval '60 day'and "date" <= current_date - interval '1 day'
Теперь добавим оставшийся месяц, запустив модель еще раз. Все параметры остаются прежними:
dbt build -s events_clean_v2
Код после компиляции изменится:
select distinctuser_id,"timestamp",type_id,now() as updated_at,"date"from"dev_zan7"."dbt"."events_prep"where"date" >= date '2023-07-31 00:00:00'and "date" < date '2023-07-31 00:00:00' + interval '60 day'and "date" <= current_date - interval '1 day'
Что насчет управления макросом через переменные?
Попробуем пересчитать весь июль, зададим начальную дату 1 июля и укажем диапазон 31 день:
dbt build -s events_clean_v2 --vars "{start_date: 2023-07-01, days_max: 31}"
updated_at таблицы покажет, что данные за весь июль были только что обновлены.
Если просят обновить события только за 30 августа, тогда передадим переменную date:
dbt build -s events_clean_v2 --vars "date: 2023-08-30"
dbt показывает, что были обновлены лишь 3768 записей:
1 of 1 START sql incremental model dbt.events_clean_v2........[RUN]1 of 1 OK created sql incremental model dbt.events_clean_v2...[INSERT 0 3768 in 4.64s]
Вот таким длинным путем мы пришли в сложному макросу, который автоматически определяет точку старта для нового запуска, используя select_first_value, берет параметры из метаданных модели, которые видны в документации, гарантирует предсказуемый размер пачки данных для обработки (например, не более 60 дней за один запуск), а также исключает "сырые" данные, например, отступая на 1 день от текущей даты, чтобы обрабатывать только полные, завершенные сутки.
Далее создадим дженерик-тест tests/generic/unique_key_meta.sql:
{% test unique_key_meta(model) %}{# Test combination of columns declared as 'unique_key' meta field for uniqueness. #}{# Optionally test supports 'testing' meta dictionary of models for parameters. #}{%- set unique_key = get_meta_value(model, 'unique_key', none) -%}{%- if execute -%}{%- if unique_key is none -%}{{ exceptions.raise_compiler_error("unique_key meta field is required for unique_key_meta test") }}{%- endif -%}{%- set unique_key_csv = unique_key | join(', ') -%}{%- endif -%}{# Extract 'testing' meta parameters. #}{%- set testing = get_meta_value(model, 'testing', {}) -%}{%- set days_max = testing.get('days_max', none) -%}{%- set date_column = testing.get('date_column', 'date') -%}with validation_errors as (select{{ unique_key_csv }}from {{ model }}{% if days_max -%}{%- set start_date_query -%}select max({{ date_column }}) - interval '{{ days_max }} day' from {{ model }}{%- endset -%}{%- set start_date = select_first_value(start_date_query) -%}where {{ date_column }} >= date '{{ start_date }}'{%- endif %}group by {{ unique_key_csv }}having count(*) > 1)select *from validation_errors{% endtest %}
Данный тест проверяет уникальность заданного набора колонок, что особенно важно для Data Lake.
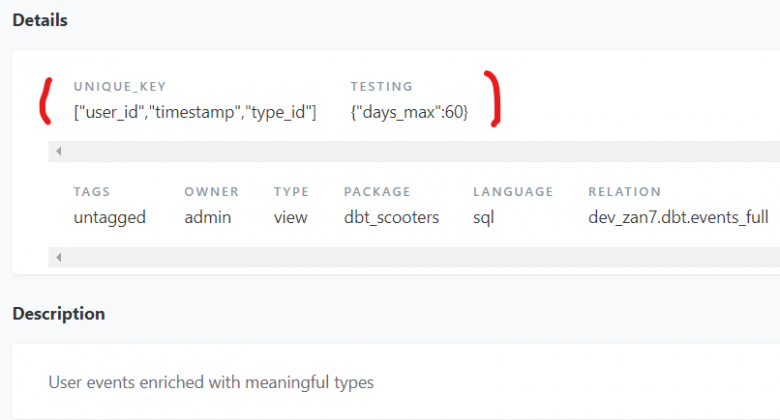
Привяжем его к модели events_full, которая является представлением и содержит JOIN двух таблиц (постоянная проверка ключа на всю глубину может стоить достаточно дорого).
Сконфигурируем модель в models/properties.yml, добавив все необходимые метаданные, включая уникальный ключ и глубину тестирования 60 дней:
- name: "events_full"description: "User events enriched with meaningful types"config:materialized: "view"meta:unique_key: [ "user_id", "timestamp", "type_id" ]testing:days_max: 60data_tests: [ "unique_key_meta" ]
Запускаем наш продвинутый тест:
dbt test -s events_full
Проверка отрабатывает запрос без ошибок и имеет лаконичное название:
1 of 2 START test events_full_is_complete ........ [RUN]2 of 2 START test unique_key_meta_events_full_ ... [RUN]1 of 2 PASS events_full_is_complete .............. [PASS in 4.94s]2 of 2 PASS unique_key_meta_events_full_ .........[PASS in 12.01s]
Вот как теперь выглядит наша модель events_clean_v2:
А вот метаданные обновленной events_full: