

Установка и разворачивание кластера Greenplum
Кластер Greenplum — это мощное хранилище данных на основе архитектуры параллельной обработки данных (MPP). В рамках данного раздела мы рассмотрим, как правильно спланировать, разворачивать и настраивать кластер Greenplum в реальной корпоративной среде. Мы опишем теоретические основы архитектуры, перечислим необходимый набор знаний и инструментов, предложим практические примеры установки как в чисто open-source сценариях, так и с учётом российских реалий и практик внедрения (интеграторы, инфраструктурные подходы и безопасность). В конце главы вы найдёте блок FAQ, который суммирует ответы на наиболее частые вопросы по теме.
Цель главы:
- дать понятное представление об архитектуре Greenplum и терминах;
- показать пошаговые подходы к развёртыванию кластера: от планирования до запуска;
- привести практические примеры установки и настройки;
- разобрать риски, ограничения и меры по их снижению;
- предложить подходы к эксплуатации и мониторингу.
В этой секции мы углубимся в архитектуру и концепции Greenplum, чтобы читатель понимал, какие элементы важны для корректной установки.
Архитектура Greenplum: высотный обзор
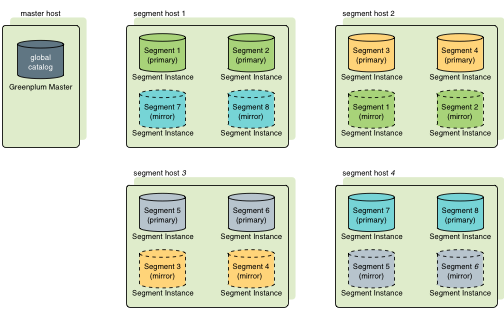
- Master-узел (QD, Query Dispatcher): отвечает за прием запросов клиентов, формирование планов выполнения и координацию выполнения среди сегментов.
- Узлы сегментов (Primary и Mirror): фактическая вычислительная часть. Каждый сегмент имеет копию данных на зеркале (mirror). Пояснение: Greenplum реализует архитектуру MPP — данные распределяются по сегментам, параллельно обрабатываются за счёт координации между QD и сегментами.
- Интерконнект: сеть между мастером и сегментами, а также между сегментами в рамках распределённой выполнения. Важен скоростной и надёжный канал (обычно 10GbE или выше).
- Логика данных: данные распределяются с помощью хеш-распределения по сегментам. Неправильная или неравномерная раскладка может привести к перегрузке отдельных сегментов и снижению производительности.
- Бэкап и восстановление: принципы резервного копирования и восстановления — через инструменты gpbackup/gprestore (современная пара для резервного копирования в Greenplum) и взаимодействие с репликацией на уровне сегментов.
- Мониторинг и производительность: gpperfmon — мониторы производительности, собирающие метрики и показывающие загрузку узлов, задержки, число активных запросов и т.д.
- Обеспечение доступности: зеркальные сегменты (mirroring) и возможность переноса ролей, планы на случай падения узла, автоматический failover, ручной/полуавтоматический режим восстановления.
Основная терминология
- GPDB/Greenplum: система управления базами данных, основанная на PostgreSQL-архитектуре, ориентированная на масштабируемость за счёт MPP.
- Master (QD): управляющий процесс, диспетчер запросов.
- Segment (Primary/Mirror): вычислительный узел, на котором физически хранятся данные и выполняются запросы. Primary — основной набор данных, Mirror — зеркало.
- Segment Host: физический или виртуальный сервер, на котором развёрнуты сегменты.
- Data Distribution: распределение данных по сегментам. В Greenplum используется хеш-распределение; неравномерность может вести к данным skew.
- Interconnect: сетевое соединение между QD и сегментами, а также между сегментами.
- gpstart/gpstop: команды для запуска и остановки кластера.
- gpconfig: настройка параметров конфигурации кластера.
- gpbackup/gprestore: современные инструменты резервного копирования и восстановления.
- gpperfmon: мониторинг производительности кластера.
- Mirrorless/Replicated: режим зеркалирования сегментов для обеспечения отказоустойчивости.
- Автономная/централизованная аутентификация: использование системной аутентификации и безопасных соединений.
Принципы развёртывания и зависимости
- Требуется согласованная версия операционной системы и совместимый набор библиотек на всех узлах.
- Важна синхронизация времени (NTP, времени на узлах) для корректности логов и транзакционных задержек.
- SSH без парольной авторизации между узлами (gpadmin) для автоматического выполнения задач управления.
- Надлежащие сетевые настройки: минимизация задержек, соответствие политикам firewall и настройка межсетевых правил.
- План по размеру данных: количество сегментов определяется исходя из объёма данных и ожидаемой нагрузки. Важно учесть планируемую ростовую динамику.
Технические требования к среде
- Операционная система: обычно дистрибутив Linux (RHEL/CentOS 7/8 или аналогичные, Debian/Ubuntu — в зависимости от поддержки версии Greenplum).
- Аппаратное обеспечение: CPU, RAM, диск, сеть — с учётом ожидаемой нагрузки и объёма данных. Таблица ниже даёт ориентиры.
- Файловая система и каталоги: согласованные пути к директориям данных сегментов и каталоги журналов.
- Мониторинг и резервное копирование: наличие инструментов gpperfmon и gpbackup/gprestore или их альтернатив.
Таблица: ориентировочные характеристики оборудования для небольшого кластера Greenplum (3 сегмента первичных + зеркала)
| Компонент | Рекомендации |
|---|---|
| Узлы мастер и сегментов | per-node CPU: 8–16 ядер, RAM: 32–128 GB, диск: 2–4 TB SSD/HDD в зависимости от нагрузки |
| Интерконнект | 10 GbE или выше, низкая задержка, равный доступ ко всем узлам |
| Память и система | настройка ядра Linux: shmmax, semmns, file descriptors; disable Transparent Huge Pages (THP) по рекомендациям Greenplum |
| Хранение данных | выделенные дисковые массивы под сегменты; резервирование для mirror-участков |
| Время и синхронизация | NTP/chrony синхронизировано на всех узлах |
| Безопасность | SSH-ключи без паролей, TLS там, где требуется, управление доступом через роли и политики |
Практические примеры
В этой секции мы разберём два типа примеров: (A) чисто open-source подход к развёртыванию кластера Greenplum вручную, и (B) практические кейсы на российском рынке с использованием доступных инструментов автоматизации и локальных практик.
Пример А: Чисто open-source сценарий (ручное развёртывание)
Ниже – упрощённый набор шагов, который можно выполнить на кластере из 4 узлов: один мастер (QD) и три сегментных узла (Primary + Mirror на каждом). Конкретные команды приведены как иллюстративные; при реальном развёртывании замените версии и пути на используемые в вашем окружении.
Подготовка узлов
- Создайте пользователя gpadmin на всех узлах и настройте парольless SSH между ними.
- Установите необходимые зависимости на всех узлах (libc, libstdc++, openssl и пр.).
Подготовка данных и путей
- На каждом сегментном узле создайте каталоги для данных сегментов:
  /data/primary
  /data/mirror
- Назначьте права принадлежности gpadmin.
Установка Greenplum
- Скачайте дистрибутив Greenplum соответствующей версии (например, 6.x или 7.x) и распакуйте его на всех узлах.
- Обновите переменные окружения на каждом узле:
export PATH=/usr/local/greenplum-db-/bin:$PATH export LD_LIBRARY_PATH=/usr/local/greenplum-db- /lib:$LD_LIBRARY_PATH
Развёртывание кластера
- Создайте файл hosts с перечнем целевых узлов:
  master-host
  seg1-host
  seg2-host
  seg3-host
- На мастер-узле запустите построение кластера:
gpinit -s master-host,seg1-host,seg2-host,seg3-host -D /data/primary -M /data/mirror
Примечание: точные параметры gpinit зависят от версии Greenplum; используйте документацию своей версии.
Запуск кластера и тестовый запрос
- Запустите кластер:
gpstart -a
- Подключитесь к БД:
psql "host=master-host dbname=postgres user=gpadmin"
- Выполните простой запрос:
SELECT gp_segment_id, count(*) FROM gp_dist_random('pg_tables') GROUP BY 1;
Мониторинг и обслуживание
- Включите gpperfmon и откройте графический интерфейс мониторинга. Убедитесь, что сбор метрик идёт без ошибок.
- Настройте резервное копирование через gpbackup/gprestore и планируйте периодические бэкапы.
Пример конфигурации для первых шагов (технические команды):
```bash
# на мастере
sudo useradd gpadmin
ssh-keygen -t rsa -b 2048 -N "" -f ~/.ssh/id_rsa
# скопируйте публичный ключ на все узлы
for host in master-host seg1-host seg2-host seg3-host; do
  ssh-copy-id gpadmin@$host
done

# установка Greenplum на всех узлах (пример для CentOS/RedHat)
wget http://example.org/greenplum-db-6.0.0-rhel7-x86_64.tar.gz
tar -xzf greenplum-db-6.0.0-rhel7-x86_64.tar.gz
export GPHOME=/usr/local/greenplum-db-6.0.0
export PATH=$GPHOME/bin:$PATH
export LD_LIBRARY_PATH=$GPHOME/lib:$LD_LIBRARY_PATH

# создание директорий данных
for host in master-host seg1-host seg2-host seg3-host; do
  ssh gpadmin@$host "mkdir -p /data/primary /data/mirror && chown -R gpadmin:gpadmin /data"
done

# инициализация кластера
gpinit -s master-host,seg1-host,seg2-host,seg3-host -D /data/primary -M /data/mirror
gpstart -a
```
Практический комментарий: в реальной работе чаще применяются централизованные подходы к развёртыванию через Ansible или Terraform. Это уменьшает вероятность ошибок и обеспечивает воспроизводимость окружения.
Пример B: Российские подходы и практики
В российских условиях часто применяется сочетание готовых инструментов автоматизации и локальных практик обеспечения устойчивости.
- Автоматизация развёртывания через Ansible/Terraform: разработка ролей Ansible, которые реализуют задачи настройки окружения, развёртывания Greenplum, настройки SSH и подготовки каталогов данных. В инфраструктурах крупных предприятий широко применяются пайплайны IaC и GitOps для управляемости конфигураций.
- Использование отечественных решений для мониторинга и логирования: Zabbix/Prometheus-Grafana стеки с локальными экспортёрами, чтобы обеспечить видимость производительности кластера.
- Соответствие требованиям регуляторов: обеспечение аудитируемости операций, хранение логов в соответствии с требованиями к безопасности данных.
- Безопасность и сертификация: настройка TLS/SSL для соединений, контроль доступа через роли, аудит действий.
Практический пример (Ansible-реализация) Ниже – минимальный фрагмент playbook, который демонстрирует концепцию, как можно управлять развёртыванием Greenplum через Ansible. Это не полноценный рабочий скрипт, а шаблон, который можно адаптировать под конкретную инфраструктуру.
```yaml
# inventory: gpdb_hosts
[GPD_CLUSTER]
master-host
seg1-host
seg2-host
seg3-host

[all:vars]
ansible_python_interpreter=/usr/bin/python3
gp_user: gpadmin
gp_home: /usr/local/greenplum-db-6.0.0
data_dirs: /data/primary,/data/mirror

---

- hosts: all
  become: yes
  tasks:
    - name: Install dependencies
      package:
        name:
          - wget
          - libxml2
          - libxslt1
          - openssl
        state: present

    - name: Create gpadmin user
      user:
        name: "{{ gp_user }}"
        create_home: yes
        shell: /bin/bash

    - name: Setup SSH keys
      become_user: "{{ gp_user }}"
      authorized_key:
        user: "{{ gp_user }}"
        key: "{{ lookup('file', '~/.ssh/id_rsa.pub') }}"

    - name: Download Greenplum
      get_url:
        url: http://example.org/greenplum-db-6.0.0-rhel7-x86_64.tar.gz
        dest: /tmp/greenplum.tar.gz

    - name: Extract Greenplum
      unarchive:
        src: /tmp/greenplum.tar.gz
        dest: /usr/local
        remote_src: yes

    - name: Create data directories
      file:
        path: "{{ item }}"
        state: directory
        owner: "{{ gp_user }}"
        group: "{{ gp_user }}"
        mode: '0700'
      with_items: "{{ data_dirs.split(',') }}"
```
Ключевые моменты:
- Инфраструктура как код обеспечивает воспроизводимость развёртывания.
- В российской практике важны согласование с локальными регуляторами, аудит и защита данных.
- Поддержка обновлений и миграций, протестированная на стенде перед переносом в продакшн.
В этой секции мы детализируем конкретные технологии и параметры, которые часто проявляются в реальных развёртываниях Greenplum.
Установка и конфигурация
- Версии Greenplum: на практике чаще всего применяют стабильные версии LTS, например Greenplum 6.x или 7.x. Обновления сопровождаются мажорными изменениями в конфигурации и в инструментах резервного копирования.
-
Путь установки: обычно это /usr/local/greenplum-db-
или аналогичный префикс. -
Переменные окружения:
- PATH: включает bin каталоги Greenplum.
- LD_LIBRARY_PATH: прописывает lib каталоги, чтобы внешние инструменты могли находить нативные библиотеки.
-
Настройки ядра Linux:
- shmmax, semmns, semmni и другие параметры, связанные с разделяемой памятью и семафорами.
- Отключение THP (Transparent Huge Pages) часто рекомендуется для производительности.
-
Конфигурация каталога данных:
- Для сегментов: /data/primary, /data/mirror на соответствующих узлах.
- Поведение зеркал должно быть согласовано на уровне конфигурации (mirror-hosts, segment_hosts).
Управление кластером
- gpssh/gpinit: базовая утилита для оркестрации между узлами. Она позволяет выполнять команды на нескольких узлах одновременно.
- gpstart/gpstop: запуск и остановка всего кластера.
- gpconfig: настройка параметров параметризации кластера (например, memory_limit_per_query, shared_buffers и т.д., если ваша версия поддерживает аналогичные параметры).
- gpbackup/gprestore: резервное копирование и восстановление баз данных. Это особенно важно в продакшн-средах — регулярно тестируемые бэкапы являются частью политики управления данными.
Мониторинг и производительность
- gpperfmon: мониторинг производительности. Инструмент позволяет видеть Hive-метрики, задержки, загрузку сегментов, доступность узлов, активность запросов.
- Инструменты визуализации: Grafana + Prometheus или аналогичные сборщики метрик, подключаемые к gpperfmon-агрегаторам.
- Журналы и трассировка: включение логирования на уровнях INFO/WARN/ERROR для диагностики.
Резервное копирование и восстановление
- gpbackup/gpbackup_agent: современные инструменты резервного копирования всех баз данных. Включают параллельность, параллельное восстановление и мониторинг прогресса.
- gprestore: восстановление данных на основе бэкапов в заданной точке времени.
- Частота бэкапов: настройка политик, соответствующих бизнес-целям и регуляторным требованиям.
Безопасность и соответствие
- Аутентификация: локальная роль/пользователь database-окружения (gpadmin и роли).
- Шифрование: TLS для соединений между клиентами и сервером, TLS для межузлового обмена.
- Контроль доступа: разграничение прав по ролям, аудит действий (логирование.
Масштабируемость и миграции
- Горизонтальное масштабирование: добавление новых сегментных узлов через gpaddmirrors или расширение сегментов.
- Планирование миграций: тестирование на стейджинг-окружении, затем перенос на продакшн.
- Концепции распределения данных: понимание того, как структура данных влияет на балансировку по сегментам.
Риски и ограничения внедрения
Развертывание кластера Greenplum имеет ряд рисков и ограничений, которые требуют внимания.
- Неправильная раскладка данных: skew может приводить к перегрузке некоторых сегментов и подрыву производительности. Решение: анализ распределения данных и настройка стратегии хеш-распределения, возможно, использования функции PARTITION BY или изменения ключей распределения.
- Сетевые задержки и узкая полоса: interconnect должен быть быстрым и надёжным; медленная сеть становится узким местом.
- Управление миграциями: обновления версий Greenplum могут требовать миграции данных и изменения в конфигурации. Резервное копирование перед обновлением обязательно.
- Безопасность и соответствие: регуляторные требования требуют сохранности данных, аудит и контроля доступа. Необходимо обеспечить TLS, аудит и управление доступом.
- Время отклика на сбои: Mirror-слой помогает, но сложность восстановления и зависимость от сетевых ресурсов требует тестирования планов аварийного переключения.
- Мониторинг: без надлежащего мониторинга трудно вовремя обнаружить проблемы, особенно в кластерах с большим объёмом данных.
- Совместимость инструментов: некоторые утилиты (gpbackup/gprestore, gpconfig) могут иметь ограничения по версиям и платформам. Важно сверяться с документацией версии Greenplum.
- Инфраструктурная зависимость: стабильная работа зависит от согласованного окружения (контроль версий, IaC, реальные политики безопасности).
- Внедрение в России: регуляторные требования, аудит и сертификация инструментов могут влиять на выбор инфраструктуры и методов развёртывания. Необходимо поддерживать соответствие требованиям локальных органов.
Меры снижения рисков:
- Создание тестового стенда, на котором повторяются рабочие сценарии развёртывания и аварийного восстановления.
- Регулярное резервное копирование и проверка восстановимости.
- Наличие плана катастрофических сценариев, включая failover и failback.
- Контроль версий конфигураций через системы управления конфигурациями (IaC, GitOps).
- Мониторинг в реальном времени и алерты по критическим порогам.
- Внедрение политики безопасности и регулярные аудиты.
Установка и разворачивание кластера Greenplum — ответственный процесс, который требует внимательного планирования, понимания архитектуры, аккуратности в настройке окружения и тестирования. Важно помнить о сбалансированной архитектуре: оптимальная раскладка данных, надёжный interconnect, надёжные зеркала и грамотная политика бэкапов. Инструменты автоматизации, такие как Ansible и Terraform (особенно в российских условиях, где IaC широко применяется в крупных компаниях), позволяют обеспечить воспроизводимость и ускорить развёртывание. Мониторинг через gpperfmon и современные практики резервного копирования (gpbackup/gprestore) делают эксплуатацию устойчивой и понятной. Наконец, учитывайте риски и ограничения внедрения: детальный план, тестирование на стенде, документацию и аудит — ваши главные инструменты для успешного проекта.
FAQ (Вопрос–Ответ)
1) В чем основное отличие архитектуры Greenplum от обычной РСУБД?
- Greenplum имеет параллельную архитектуру MPP: master (QD) отвечает за планирование и координацию, сегменты (Primary и Mirror) выполняют запросы и хранят данные. Это позволяет распределить нагрузку и обрабатывать большие массивы данных параллельно.
2) Какие основные шаги при развёртывании кластера?
- Подготовка окружения, создание gpadmin-пользователя, настройка SSH без пароля между узлами, установка дистрибутива Greenplum, подготовка каталогов данных, настройка конфигурации, инициализация кластера, запуск gpstart, базовые тесты и настройка мониторинга.
3) Какие инструменты чаще всего применяются для резервного копирования и восстановления?
- gpbackup и gprestore — современные инструменты Greenplum для параллельного резервного копирования и восстановления. Также можно использовать gpcrondump/gprestore в более старых версиях.
4) Какие риски чаще всего возникают при развёртывании кластера?
- Неправильная балансировка данных (data skew), сетевые задержки, проблемы совместимости версий инструментов, проблемы безопасности и аудита, а также сложности миграций и обновлений.
5) Какие практики применяются в российских реалиях для развёртывания Greenplum?
- Использование инфраструктуры как кода (Ansible/Terraform), автоматизация управления конфигурациями, мониторинг через локальные стек-решения (Prometheus/Grafana, Zabbix), соответствие требованиям регуляторов и аудит.
6) Как выбрать размер кластера и конфигурацию узлов?
- Основывается на объёме данных, ожидаемой нагрузке и частоте выполнения запросов. Важно оценить распределение данных (distribution key), количество сегментов и зеркал. Табличные данные помогают планировать, исходя из загрузки и доступного бюджета.
7) Что можно сделать для ускорения развёртывания в условиях больших инфраструктур?
- Применение IaC с использованием Ansible/Terraform, использование готовых ролей и модулей, централизованное управление версиями, мониторинг на стенде перед продакшеном, автоматические тесты на каждом этапе развёртывания.
8) Какие особенности консолидации на Kubernetes или других оркестраторах?
- Возможности развёртывания Greenplum на Kubernetes через соответствующий оператор, что упрощает масштабирование и управление ресурсами, но требует дополнительного тестирования совместимости и правильной настройки сетевых политик.
9) Как обеспечивается безопасность кластерa?
- Рolite, TLS/SSL для коммуникаций, аудит действий, роль-based access control (RBAC), настройка прав доступа и ограничение доступа к данным и административным инструментам.
10) Какие шаги по тестированию и переходу в прод?
- Развернуть стенд, прогнать нагрузочные тесты и реальные сценарии: загрузка данных, выполнение типовых запросов, проверка планов выполнения, тестирование резервного копирования и восстановления, верификация мониторинга, затем провести миграцию на продакшен окружение с минимизацией downtime.


