

Установка и разворачивание кластера Greenplum
Greenplum Database — мощная MPP-«массивная» база данных, специально спроектированная для анализа больших объемов данных. Архитектура Greenplum сочетает в себе мастер-узел (Master) и набор сегментных узлов (Segments), где хранение данных осуществляется по принципу разделения и параллельной обработки. Каждый сегмент состоит из основного (primary) и зеркального (mirror) дисковых томов, что обеспечивает отказоустойчивость. Разворачивание кластера — это не просто установка ПО, а создание управляемого контура узлов, настройки сетевого взаимодействия, дисковых массивов, конфигурации синхронизации и процедур старта/остановки кластера, а также внедрения базовых механизмов резервного копирования и мониторинга.
Цель этой главы — дать практическую методику разворачивания кластера Greenplum с нуля: от проектирования архитектуры и выбора аппаратной базы до разворачивания, первых запусков и проверки работоспособности, включая типичные сценарии IaC (Infrastructure as Code) и сценарии внедрения в открытом и локализованном (российском) контекстах. В тексте уделено внимание как теоретическим основам, так и конкретным командам, конфигурациям и сценариям развертывания.
Важное замечание: выбор версии GPDB и конкретного набора инструментов зависит от вашего датацентра (физическая инфраструктура, облако, требования к лицензиям) и от того, поддерживает ли ваша организация соответствующие версии операционной системы и ускорители оборудования. Ниже приведены общие подходы, примеры конфигураций и шаблоны, которые можно адаптировать под реальную среду.
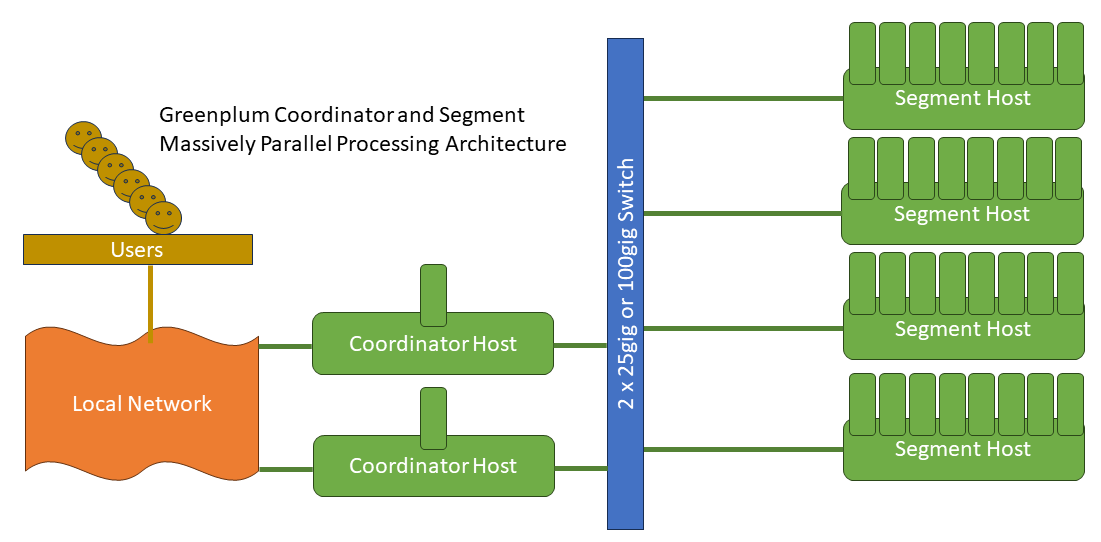
Теоретическая часть
Архитектура Greenplum: основные концепции
- Master (QD — Query Dispatcher): управляет планами выполнения запросов, распределяет работу между сегментами и агрегирует результаты.
- Segments (Primaries и Mirrors): реальные места хранения данных. Каждый сервер-узел может содержать несколько сегментов (пайплайн «shared-nothing»). Данные в Greenplum распределяются по сегментам по выбранному распределительному ключу (distribution key) или по случайному распределению.
- Функциональная связка: Master держит метаданные, диаграммы распределения данных и планы запросов; сегменты выполняют вычисления и хранят данные.
- Репликация: Mirror-узлы обеспечивают отказоустойчивость. В случае выхода из строя первичного сегмента зеркало может быть автоматически подключено, и процедура восстановления продолжится.
- Ввод/вывод: Greenplum оптимизирован под аналитические запросы с большой степенью параллелизма, распределение вычислений по нескольким узлам и эффективную агрегацию результатов.
Что обеспечивает установка кластера
- Надежность и отказоустойчивость: зеркалирование сегментов, мониторинг и автоматическое восстановление.
- Масштабируемость: добавление узлов-держателей сегментов по мере роста объема данных.
- Производительность аналитических запросов: параллелизм на уровне сегментов, эффективная агрегационная обработка и оптимизация плана выполнения запроса.
- Управляемость и мониторинг: централизованный контроль актуального состояния кластера, журналирование, метрики.
Типовая структура кластера
- Master host: один узел, на котором выполняются сервисы управления.
- Data hosts: N узлов, каждый с несколькими сегментами (чаще 2–4 сегмента на узел, зависит от конфигурации и дисковой подсистемы).
- Дисковая подсистема: отдельные диски под data, под WAL/логирование или зеркала, с учетом требований к пропускной способности и емкости.
- Сеть: высокоскоростное подключение между мастером и сегментами (1–10 Гбит/с или выше), минимизация задержек и потерь пакетов.
Жизненный цикл разворачивания: с IaC к готовому кластеру
- Проектирование архитектуры: размер кластера, расчёт емкости, требования к хранению, целевые показатели на год.
- Подготовка окружения: выбор ОС, настройка сетевых параметров, обеспечение SSH-доступа, отключение swap, подготовка дисков.
- Разворачивание ПО: установка бинарников Greenplum, настройка окружения, подготовка конфигурационных файлов.
- Инициализация кластера: создание Master и Segments с помощью gpinitsystem и конфигурационных файлов.
- Запуск и базовая верификация: gpstart, проверка статусов, создание тестовых объектов и простых запросов.
- Мониторинг и безопасность: настройка мониторинга, логирования, интеграция с LDAP/ Kerberos, настройка прав доступа.
- Резервное копирование и отказоустойчивость: процедуры резервного копирования, хранение WAL, план восстановления.
- Обновление и обслуживание: планы обновлений, патч-менеджмент, миграции.
Практические примеры
Пример 1. Миникластер на 4 узлах (open-source подход, локальная лаборатория)
Цель: понять принципы разворачивания на полубезопасной тестовой среде, без сложной инфраструктуры.
-
Топология:
- Master: 1 узел
- Segments: 4 узла (по 1–2 сегмента на узел в зависимости от аппаратной мощности)
- Технологии: Linux-серверы (например, CentOS/RHEL 7.x или Debian/Ubuntu в зависимости от поддержки), SSH без пароля, Ansible для автоматизации.
- Инструменты: Greenplum Community/Open Source-версия, gpinitsystem, gpstart/gpstop, psql.
Шаги:
- Подготовка виртуальных машин (упрощённо):
- Установить Linux на все узлы.
- Отключить swap, настроить ядро и сетевые параметры (noatime, vm.overcommit, fs.file-max, etc.).
- Создать пользователя gpadmin, настроить SSH-ключи между узлами.
- Подготовка окружения на каждом узле:
- Скачать бинарник Greenplum и распаковать на всех нодах (одинаковая версия и путь установки).
- Добавить в PATH: export PATH=/opt/greenplum-db/bin:$PATH
- Установить зависимости: python, perl, libreadline, zlib, etc.
- Конфигурация файлов и окружения:
-
Создать файл gp_init_config на Master-е для gpinitsystem:
- SEGMENT_COUNT=4
- SEGMENT_HOSTS=(host2,host3,host4,host5)
- MASTER_HOST=host1
- MASTER_PORT=5432
- PORT_BASE=40000
- DATA_DIRECTORY=/data/greenplum
- MIRROR_MODE=mirrorless (или включить mirrors по настройке)
- WORLD=очередной текстовый блок с параметрами.
- Инициализация кластера:
- На Master выполнить: gpinitsystem -c /path/gp_init_config
- Ждать завершения и проверять логи на предмет ошибок.
- Запуск и проверка:
- gpstart -a
- psql -h master_host -p 5432 -d postgres -c "SELECT version();"
- Создать тестовую таблицу, вставить данные и выполнить простой запрос.
Пример конфигурационного блока gpinitsystem (упрощённый):
SEGMENT_COUNT = 4 SEGMENT_HOSTS = host2,host3,host4,host5 MASTER_HOST = host1 MASTER_PORT = 5432 PORT_BASE = 40000 DATA_DIRECTORY = /data/greenplum ENCODING = UTF8 TRUSTED_SHELL = yes MIRROR_MIGRATION = off
Это демонстрирует схему: Master на одном узле, сегменты распределены по четырём узлам.
Пример команд:
- gpinit: отсутствует прямая команда; инициализация производится gpinitsystem.
- gpstart: gpstart -a
- psql: psql "host=host1 port=5432 dbname=postgres user=gpsuperuser"
Примечание: данный пример рассчитан на лабораторную среду. В реальной инфраструктуре нужно учесть специфику сетей, политики безопасности, порядок управления доступами и устойчивость к сбоям.
Пример 2. Разворачивание в облаке с использованием Ansible (open-source подход)
Цель: описать подход к развёртыванию кластера Greenplum в облаке (AWS/Azure/GovCloud) с использованием Ansible для автоматизации конфигурации узлов.
- Архитектура: мастер на одном узле, сегменты на нескольких виртуальных машинах.
- Инструменты: Ansible, Terraform (для создания инфраструктуры в облаке), Greenplum Binary.
Шаги:
- Установка инфраструктуры через Terraform:
- Создается VPC, подсети, данные вычисления, дисковая подсистема, балансировщики (при необходимости).
- Выделяются ВМ, соответствующие образу Linux.
- Конфигурация узлов через Ansible:
- Установка зависимостей и Greenplum бинарников на каждую машину.
- Создание пользователя gpadmin и настройка SSH между узлами.
- Настройка каталогов под данные (/data/greenplum) на каждой ноде.
- Инициализация кластера:
- Аналогично примеру 1: создание gp_init_config и запуск gpinitsystem.
- Верификация: gpstart -a, psql для проверки.
- Безопасность и мониторинг:
- Интеграция с LDAP/Kerberos для аутентификации.
- Мониторинг через Prometheus/Grafana, экспортёры для Greenplum, настройка алёртов.
Пример Ansible задачи (упрощённо):
-
name: Установка зависимостей apt: name: - postgresql-client - python3 - sshpass state: present when: ansible_os_family == "Debian"
-
name: Развернуть Greenplum unarchive: src: /tmp/greenplum-db.tar.gz dest: /opt/ remote_src: no
-
name: Настроить окружение lineinfile: path: /home/gpadmin/.bashrc line: 'export PATH=/opt/greenplum-db/bin:$PATH' become_user: gpadmin
Это примерный скелет. В реальной реализации нужно подробное разделение ролей, обработка ошибок, idempotency и т.д.
Примеры российских решений и локализации
- Российские заказчики часто используют Greenplum в рамках центра обработки данных (ЦОД) или на облачных площадках, ориентируясь на поддерживаемую документацию на русском языке и локальные поставки услуг поддержки.
-
Практика локализации включает:
- Использование русскоязычных документаций и инструкций по настройке безопасности, LDAP/AD-интеграции и мониторинга.
- Мониторинговые стеки на русском языке (например, Grafana-панели и алёрты на русском).
- Инструменты интеграции с локальными решениями для обеспечения соответствия требованиям регуляторов (политики по сохранности данных, аудит, хранение журналов).
-
Примеры инструментов и практик:
- Ansible-роля для разворачивания GPDB в российских дата-центрах.
- Инструменты мониторинга с локализацией в русском языке и поддержкой российского рынка.
- Локальные службы поддержки и консалтинг, предоставляющие помощь по настройке безопасности, миграций и оптимизации.
Важно: конкретные торговые или лицензионные детали и ссылки на поставщиков зависят от текущего года, региона и актуальных продуктов на рынке. В разделе практических работ можно адаптировать под доступные в данный момент open-source и лицензионные варианты, соблюдая требования к лицензированию и поддержки.
Технические детали
Аппаратная и сетевые требования
- Характеристики узла: память и CPU зависят от объема данных и ожидаемой нагрузки. В типичной конфигурации для анализа: на сегмент выделяют 16–32 ГБ оперативной памяти (или больше) и SSD/быстрые HDD-диски для data директории.
- Дисковая подсистема: данные в Greenplum распределяются между сегментами; рекомендуется использовать кодированные или зеркальные тома там, где это возможно, чтобы минимизировать риск потери данных.
- Сеть: быстрые сетевые соединения между Master и Segments, минимальные задержки. Желательно 10 Гbps или выше, с сетевым QoS и минимизацией коллизий.
Подготовка окружения и безопасность
- Операционная система: обычно это RHEL/CentOS или их аналоги; можно использовать Ubuntu в некоторых случаях, но стоит проверить совместимость с вашей версией GPDB.
- Отключение swap: важно для стабильности производительности.
- SSH между всеми узлами: настройка passwordless SSH, контроль доступа.
- Пользователь gpadmin: создается на Master и всех сегментных узлах; эта учетная запись управляет кластером.
- Установка временной синхронизации (NTP) между узлами для корректной координации задач.
Конфигурационные файлы и базовые команды
- gpinitsystem: основной инструмент для инициализации кластера.
- gp_init_config: файл конфигурации для gpinitsystem, в котором задаются Master, Segments, порты и директории.
- gpstart/gpstop: команды для запуска и остановки кластера.
- psql: интерфейс к базе данных для проверки состояния и выполнения SQL-запросов.
Пример конфигурации gp_init_config (упрощённый):
MASTER_HOST = host1
MASTER_PORT = 5432
SEGMENT_HOSTS = host2,host3,host4,host5
SEGMENT_PORTS = 40001,40002,40003,40004
DATA_DIRECTORY = /data/greenplum
SEGMENT_COUNT = 4
MIRROR_MODE = segment_mirror
Команды для запуска:
gpinitsystem -c /path/gp_init_config
gpstart -a
psql -h host1 -p 5432 -d postgres -c "SELECT version();"
Мониторинг и управление
- Логи и метрики: GPDB пишет логи в каталоги, доступ к которым имеет администратор. Рекомендуется централизовать логирование.
- Мониторинг: можно использовать Prometheus + Grafana + экспортёры для GPDB, чтобы получать визуализацию по нагрузке, задержкам, доступности сегментов.
- Безопасность: интеграция с LDAP/ Kerberos, настройка ролей и прав доступа на уровне Master и сегментов, аудит операций.
Резервное копирование и доступность
- Репликация сегментов через зеркала (mirrors) обеспечивает отказоустойчивость.
- Регулярное резервное копирование метаданных и пользовательских данных, хранение копий в удалённом месте.
- План восстановления: тестирование процедур восстановления, включая восстановление отдельных сегментов и полное восстановление кластера.
Риски и ограничения
- Лицензирование и поддержка: Greenplum в открытом виде существует как Open Source-подход, но полноценная поддержка и обновления чаще предоставляются коммерческими вендорами и облачными провайдерами. В РФ региональная поддержка может быть доступна через локальных поставщиков услуг, что следует учитывать в плане обслуживания.
- Совместимость ОС и версий: конкретные версии GPDB поддерживаются на ограниченном наборе ОС (часто — RHEL/CentOS по умолчанию). При выборе версии и образа ОС важно проверить совместимость с той версией Greenplum.
- Миграции и апгрейд: миграция между версиями GPDB может потребовать тщательного планирования, тестирования и планов по совместимости.
- Ограничения производительности: распределение данных требует разумного выбора distribution key и SQL-планирования. Неправильное распределение может привести к “узким местам” и снижению производительности.
- Управление дисковым пространством: избыточность данных и mirrors требуют планирования емкости; рост объема данных должен сопровождаться планом расширения хранилища.
- Безопасность: интеграция с корпоративными системами идентификации (LDAP/ Kerberos) и управление правами доступа требует надлежащего планирования и аудита.
- Обслуживание и обновления: процесс патчинга и обновления GPDB должен быть гармонизирован с существующими процессами обновления ОС и зависимостей.
- Мониторинг и реагирование на инциденты: необходимы сценарии оперативного реагирования на сбои узлов, сетевых ошибок и перегрузку; без этого кластера может оказаться уязвимым к простоям.
Выводы
Установка и разворачивание кластера Greenplum — это не только установка программного обеспечения, но и целый конструктор управления данными: продуманная архитектура, корректная настройка окружения, надёжная процедура инициализации, настройка эксплуатации, мониторинг и обеспечение отказоустойчивости. В рамках курса мы рассмотрели теоретические основы архитектуры Greenplum, типовые подходы к развёртыванию, практические примеры (как для открытого мира, так и с учётом российских реалий), а также ключевые риски и ограничения. В реальных проектах рекомендуется использовать подходы IaC (Ansible/Terraform) для повышения повторяемости и надёжности процесса разворачивания, а также внедрять полноценный мониторинг и план аварийного восстановления.
FAQ (Вопросы и ответы)
- В чем основная архитектурная разница между Greenplum и обычной PostgreSQL?
- Greenplum — это MPP-архитектура, включающая мастер-узел (QD) и множество сегментных узлов (Primaries и Mirrors), где данные распределяются по сегментам и выполняется параллельная обработка запросов. PostgreSQL — это монолитная СУБД без встроенного распределённого параллелизма. Greenplum строит аналитику над большими данными за счёт параллельной обработки на сегментах и агрегаций на уровне мастера.
- Какие шаги включают основную процедуру инициализации кластера?
- Подготовка окружения на всех узлах, создание пользователя gpadmin, настройка SSH между узлами, подготовка дисков. Затем создание конфигурационного файла gp_init_config и выполнение gpinitsystem -c /path/gp_init_config. После успешной инициализации — gpstart -a и проверка через psql.
- Что важно учесть при выборе аппаратной базы для сегментов?
- Зависит от объема данных и требуемой скорости аналитики. Рекомендуется достаточная оперативная память, быстрые диски (SSD/HDD с высокой производительностью), разумное распределение сегментов по узлам, и сеть с низкими задержками. Важно учесть нагрузку на сеть и возможность масштабирования в будущем.
- Какой инструмент лучше использовать для автоматизации разворачивания?
- Ansible и Terraform часто применяют вместе: Terraform — для создания инфраструктуры в облаке, Ansible — для настройки ОС, установки GPDB и инициализации кластера. Такой подход позволяет повторяемо развернуть кластер в разных окружениях.
- Какие существуют риски при развёртывании в РФ или локальных дата-центрах?
- Основные риски: соответствие лицензиям и поддержке, совместимость операционных систем и версий GPDB, локализация документации, требования к безопасности и аудитам, а также вопросы по поддержке и обновлениям на локальном рынке.
- Какие меры безопасности стоит применить в кластере Greenplum?
- Интеграция с LDAP/ Kerberos для аутентификации, ограничение прав доступа на уровне ролей, настройка аудита операций, шифрование передаваемых данных по сети, резервное копирование и контроль доступа к резервным копиям.
- Какие типичные проблемы можно встретить на первом запуске и как их решать?
- Проблемы с сетью между узлами, нестыковки версий бинарников, проблемы с доступом к дискам, нехватка памяти, ошибки в конфигурационных файлах. Решение требует проверки логов, повторной настройки SSH, проверки согласованности версий GPDB и корректной конфигурации gp_init_config, а также тестирования на минимальной задаче.
- Можно ли использовать Greenplum в облаке?
- Да. Greenplum поддерживает развёртывание в облачных средах, включая создание инфраструктуры через Terraform/Ansible и настройку GPDB поверх виртуальных машин. Облачные сценарии позволяют масштабировать кластер и управлять стоимостью.
- Какие шаги помогут минимизировать простои при модернизации или обновлениях?
- Применение IaC-подхода, тестирование обновлений на стенде, создание резервных копий перед изменениями, использование зеркал и нескольких сегментов на узлах, планирование downtime, а также создание документаций по процессам смены версий.
- Какие практики мониторинга рекомендуются для Greenplum?
- Внедрение Prometheus/Grafana с экспортёрами для GPDB, настройка алёртов по критическим метрикам (загрузка CPU, задержки, статус сегментов), ведение журналов активности и изменений конфигураций, а также регулярные проверки доступности узлов и репликации.


