

Восстановление базы данных в PostgreSQL
В PostgreSQL реализовано восстановление на основе журнала redo. Если сервер базы данных падает, PostgreSQL может восстановить кластер базы данных путем последовательного воспроизведения записей XLOG в файлах сегмента WAL из точки REDO.
Ранее мы уже несколько раз говорили о восстановлении баз данных. В данном разделе я предлагаю поговорить о двух вещах, связанных с восстановлением, которые еще не были объяснены.
Прежде всего, давайте поговирм о том, КАК PostgreSQL запускает процесс восстановления. Когда PostgreSQL запускает процесс восстановления, он сначала считывает файл pg_control.

(1) При запуске PostgreSQL считывает все элементы в файле pg_control. Если элемент состояния - 'in production', PostgreSQL переходит в режим восстановления, так как это означает, что база данных не была так, как надо. Если же состояние элемента 'shut down', PostgreSQL переходит в обычный режим запуска;
(2) PostgreSQL считывает последнюю запись контрольной точки, расположение которой записано в файле pg_control, из соответствующего файла сегмента WAL. Затем он получает точку REDO из этой записи. Если последняя запись контрольной точки недействительна, PostgreSQL считывает предыдущую. Если обе записи нечитаемы, он прекращает восстановление самостоятельно. (Обратите внимание, что предыдущая контрольная точка не хранится в PostgreSQL 11 и более поздних версиях);
(3) Соответствующие менеджеры ресурсов считывают и воспроизводят записи XLOG последовательно, начиная с точки REDO до конца последнего сегмента WAL. При воспроизведении записи XLOG, если она является резервным блоком, она перезаписывается на соответствующей странице таблицы независимо от ее LSN. В противном случае запись XLOG (нерезервный блок) воспроизводится только в том случае, если LSN записи больше, чем 'pd_lsn' соответствующей страницы.
Второй аспект касается сравнения LSN: почему следует сравнивать LSN нерезервного блока и pd_lsn соответствующей страницы. Смотрите рисунки 111 и 112.
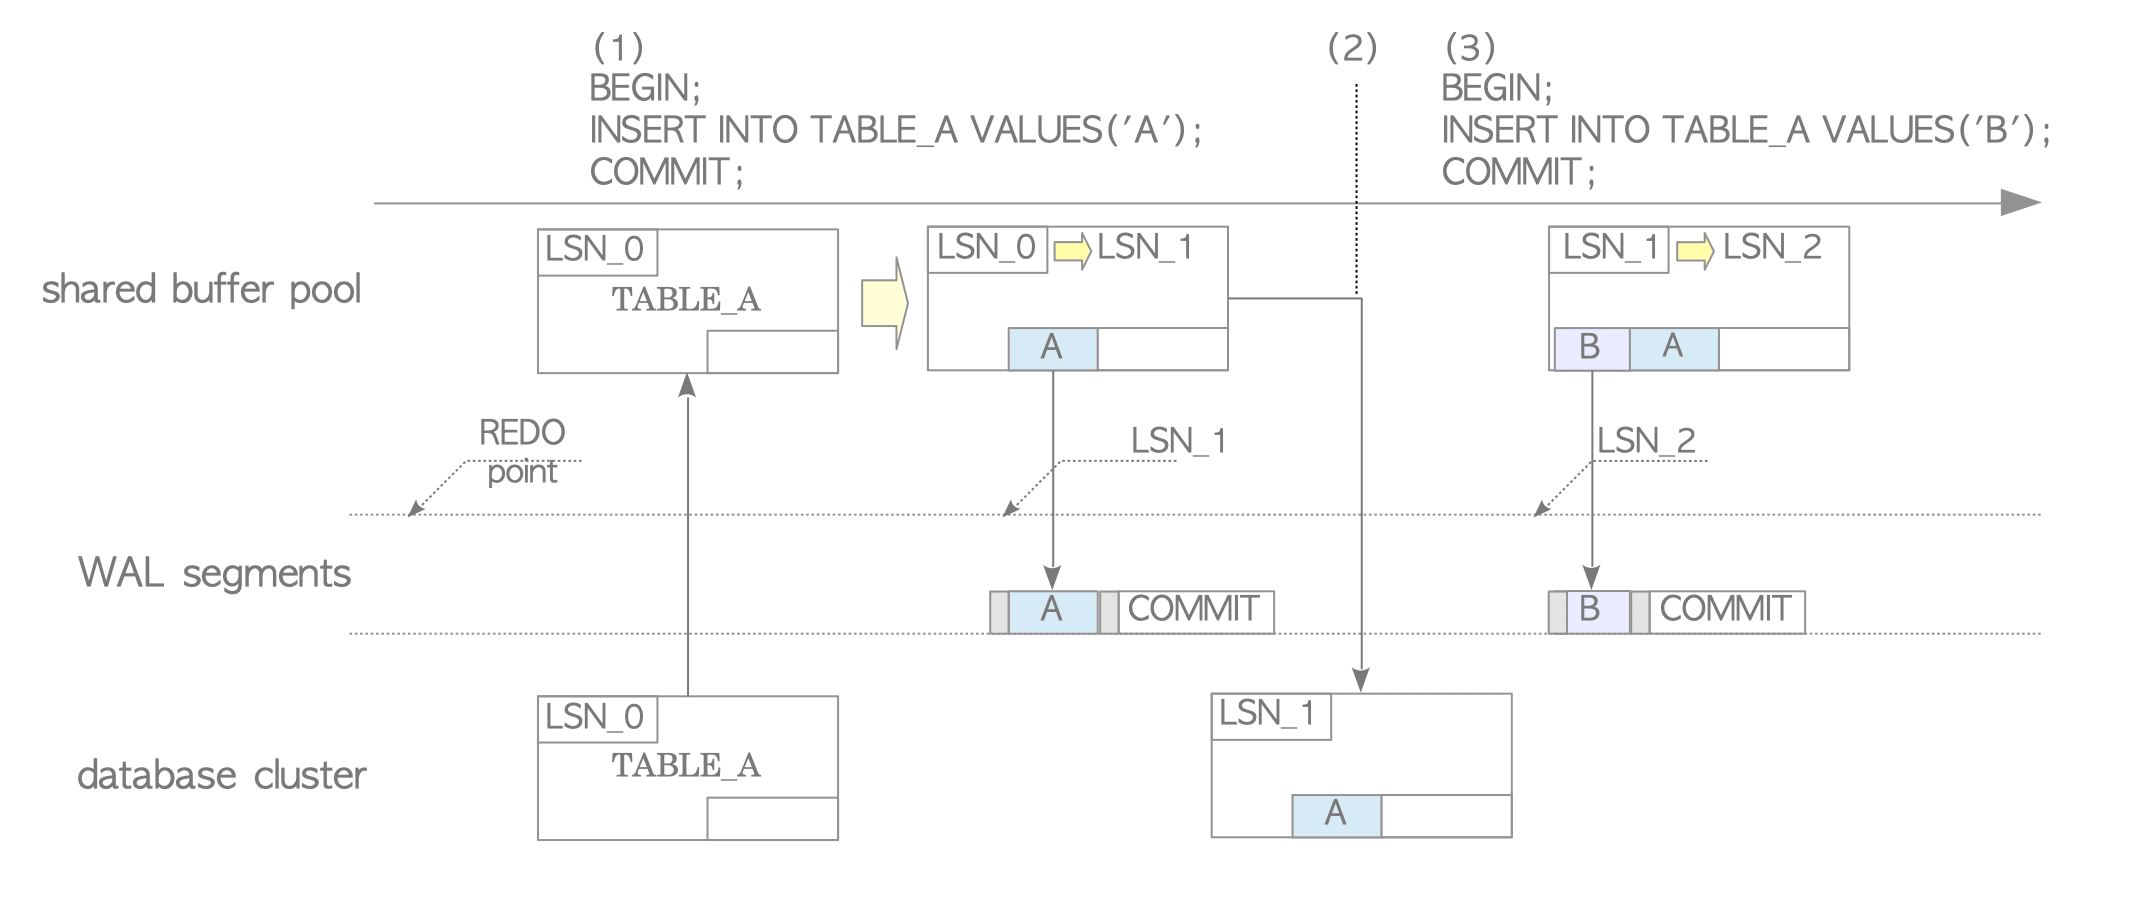
(1) PostgreSQL вставляет кортеж в TABLE_A и записывает XLOG-запись в LSN_1;.
(2) Процесс background-writer записывает страницу TABLE_A в хранилище. В этот момент pd_lsn этой страницы равен LSN_1.
(3) PostgreSQL вставляет новый кортеж в TABLE_A и записывает запись XLOG в LSN_2. Обратите внимание на то, что измененная страница пока еще не записана в хранилище.
Выполните выключение в режиме immediate, а затем запустите базу данных.
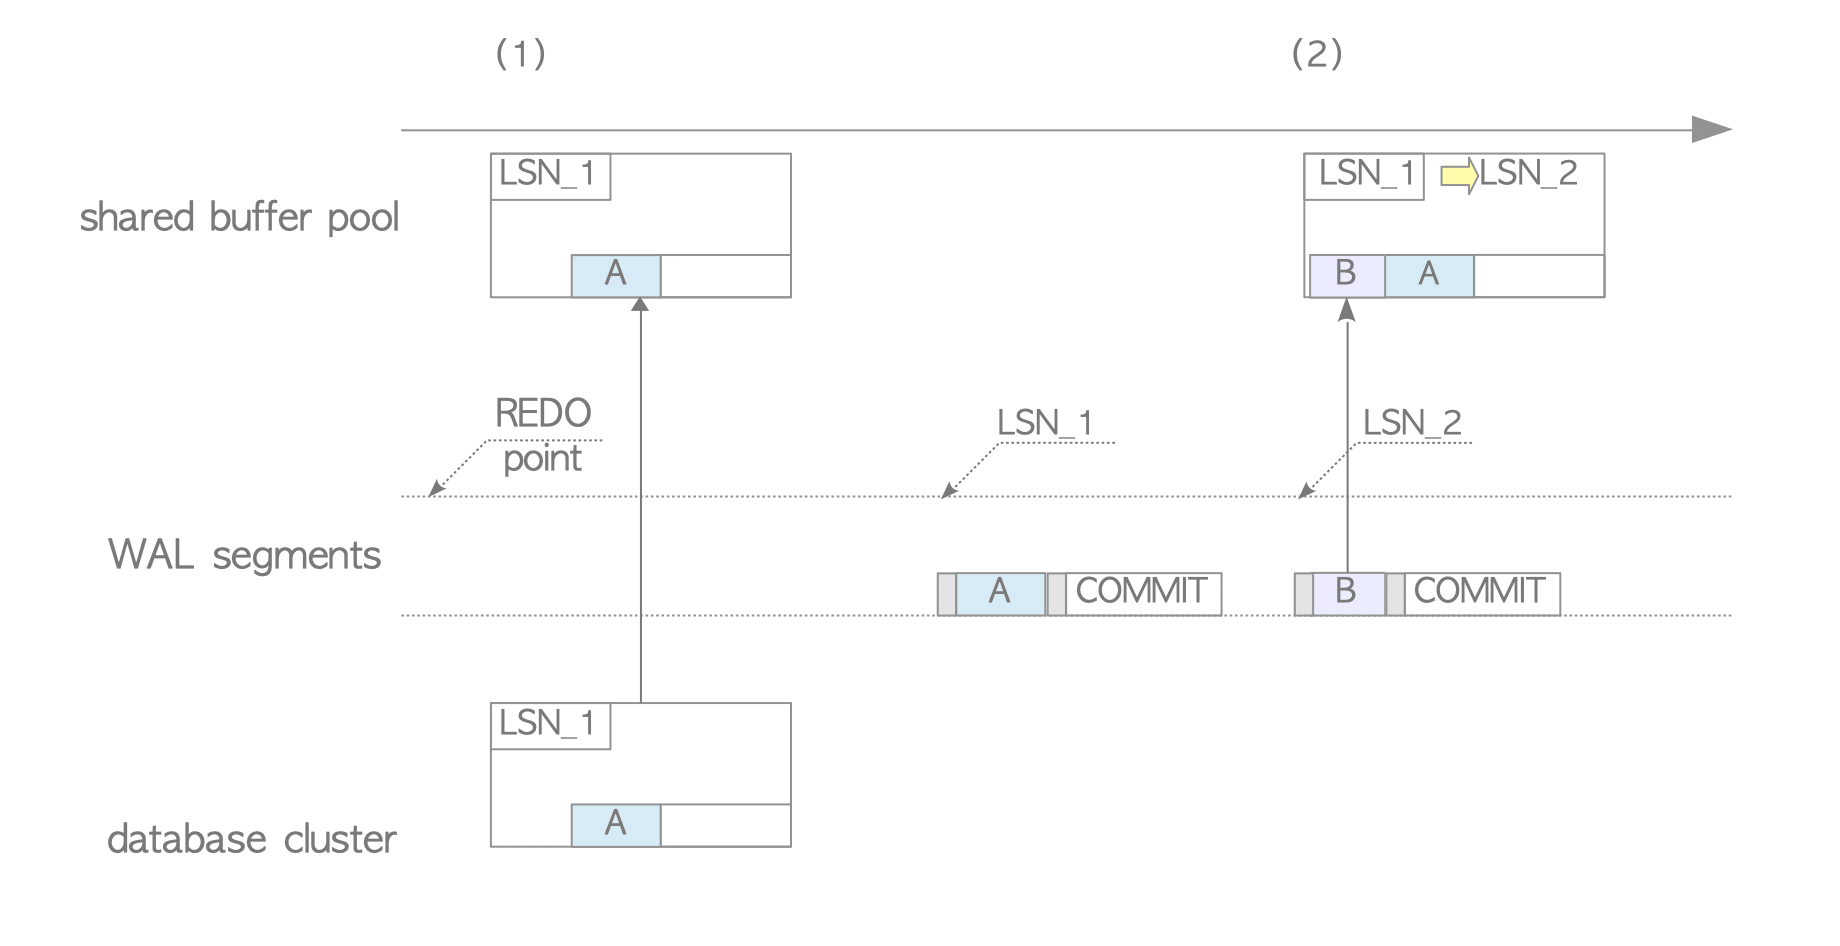
(1) PostgreSQL загружает первую запись XLOG и страницу TABLE_A, но не воспроизводит их, поскольку LSN записи (LSN_1) не больше LSN страницы (также LSN_1). На самом деле, очевидно, что в данном случае в воспроизведении нет никакой необходимости;
(2) Далее PostgreSQL воспроизводит вторую запись XLOG, поскольку LSN этой записи (LSN_2) больше, чем текущий LSN страницы TABLE_A (LSN_1).
Как видно из этого примера, если порядок воспроизведения нерезервных блоков неверен, или нерезервные блоки воспроизводятся более одного раза, кластер базы данных перестает быть согласованным. То есть операция REDO нерезервного блока не является идемпотентной. Поэтому, чтобы сохранить правильный порядок воспроизведения, записи нерезервных блоков должны воспроизводиться только в том случае, если их LSN больше, чем pd_lsn соответствующей страницы.
С другой стороны, поскольку операция повторного выполнения резервного блока является идемпотентной, резервные блоки могут быть воспроизведены склько угодно раз независимо от их LSN.


