

Введение в Apache Iceberg
Данные – это основной актив, из которого современные организации черпают интересующую их информацию и полезные сведения, необходимые для принятия ключевых бизнес-решений. Независимо от того, используются ли данные для анализа эффективности продаж какого-либо продукта или для прогнозирования будущих рыночных тенденций, они в любом случае определяют направление дальнейшего развития организаций, которое может привести их к успеху. Сегодня эффективная работа с данными не просто прихоть или следование модным тенденциям, это залог прибыльной деятельности компании и мощное конкурентное преимущество, способное привести ее к победе. Поскольку релевантная информация наконец-то стала восприниматься как ценный ресурс, современные компании предпринимают огромные усилия по накоплению проверенных данных, генерируемых различными системами. Ведь именно на их основе можно делать правильные выводы и принимать по-настоящему взвешенные решения…
Помимо всего прочего выросла и скорость генерации данных. С одной стороны это хорошо, поскольку, чем больше у организации данных, тем легче ей принимать обоснованные решения. С другой стороны, для того, чтобы справляться с этим бурным потоком информации, компании необходима платформа, которая будет хранить и анализировать все эти данные, которые затем будут использоваться для составления отчетов и обучения моделей машинного обучения (ML). Архитектура Lakehouse, о которой мы подробно расскажем в этой главе, позволяет отделить хранение данных от их обработки, что делает работу с информацией более гибкой и эффективной. Мы также поговорим об истории и эволюции платформ данных и рассмотрим основные преимущества архитектуры Lakehouse в случае использования таблиц Apache Iceberg.

Как мы пришли к тому, что имеем? Краткий обзор эволюции систем работы с данными
С точки зрения систем хранения и обработки данных общепринятым проверенным решением являются реляционные системы управления базами данных (РСУБД), особенно популярные среди организаций, которым необходимо обрабатывать свои транзакционные данные в режиме реального времени (OLTP). Примерами СУБД, оптимизированных для OLTP, являются PostgreSQL, MySQL и Microsoft SQL Server. Эти системы разработаны и оптимизированы для быстрого и единовременного взаимодействия с одним или несколькими рядами данных и являются оптимальным вариантом для организации повседневной деятельности предприятия. Представим, что Вы руководите транспортной компанией и Вам нужно оперативно обрабатывать всю информацию о новых заказах, сделанных Вашими клиентами. В этом случае каждое новое бронирование будет представлять собой новую строку в РСУБД.
Допустим, Вы хотите узнать средний размер заработка, полученного по всем новым заказам за предыдущий квартал. В этом случае использование данных, хранящихся в оптимизированной для OLTP СУБД, привело бы к замедлению производительности в виду необходимости обработки больших массивов данных. Причины таких нежелательных последствий заключаются в следующем:
- Транзакционные системы в большей степени ориентированы на операции вставки, обновления и чтения сравнительно небольшого количество строк таблицы, поэтому хранение данных в формате, основанном на строках, является идеальным решением. Однако большинство аналитических систем как правило ориентировано на агрегирование определенных столбцов или работу сразу со всеми строками таблицы, что делает столбцовую структуру более предпочтительной.
- Выполнение транзакционных и аналитических рабочих нагрузок на одной инфраструктуре может привести к нежелательной конкуренции за ресурсы.
- Транзакционные рабочие нагрузки «приветствуют» нормализацию данных в нескольких связанных таблицах, которые при необходимости можно объединить. Аналитические же рабочие нагрузки, наоборот» выполняются более эффективно при условии денормализации данных в одной таблице
Теперь представьте, что Ваша организация оперирует большим количеством ОС, которые генерируют огромное количество данных, и Ваша команда аналитиков хочет создать дашборды, основанные на агрегировании всех этих данных. В этом случае системы OLTP не совсем правильное решение, поскольку они не предназначены для работы со сложными агрегированными запросами, подразумевающими обработку большого количества исторических записей. В этом случае больше всего подойдут системы оперативной аналитической обработки данных (OLAP). Именно эти требования послужили толчком к разработке архитектуры Lakehouse.
Основополагающие компоненты системы, предназначенной для рабочих нагрузок OLAP
OLAP система состоит из определенного набора технологических компонентов, позволяющих поддерживать современные аналитические нагрузки.
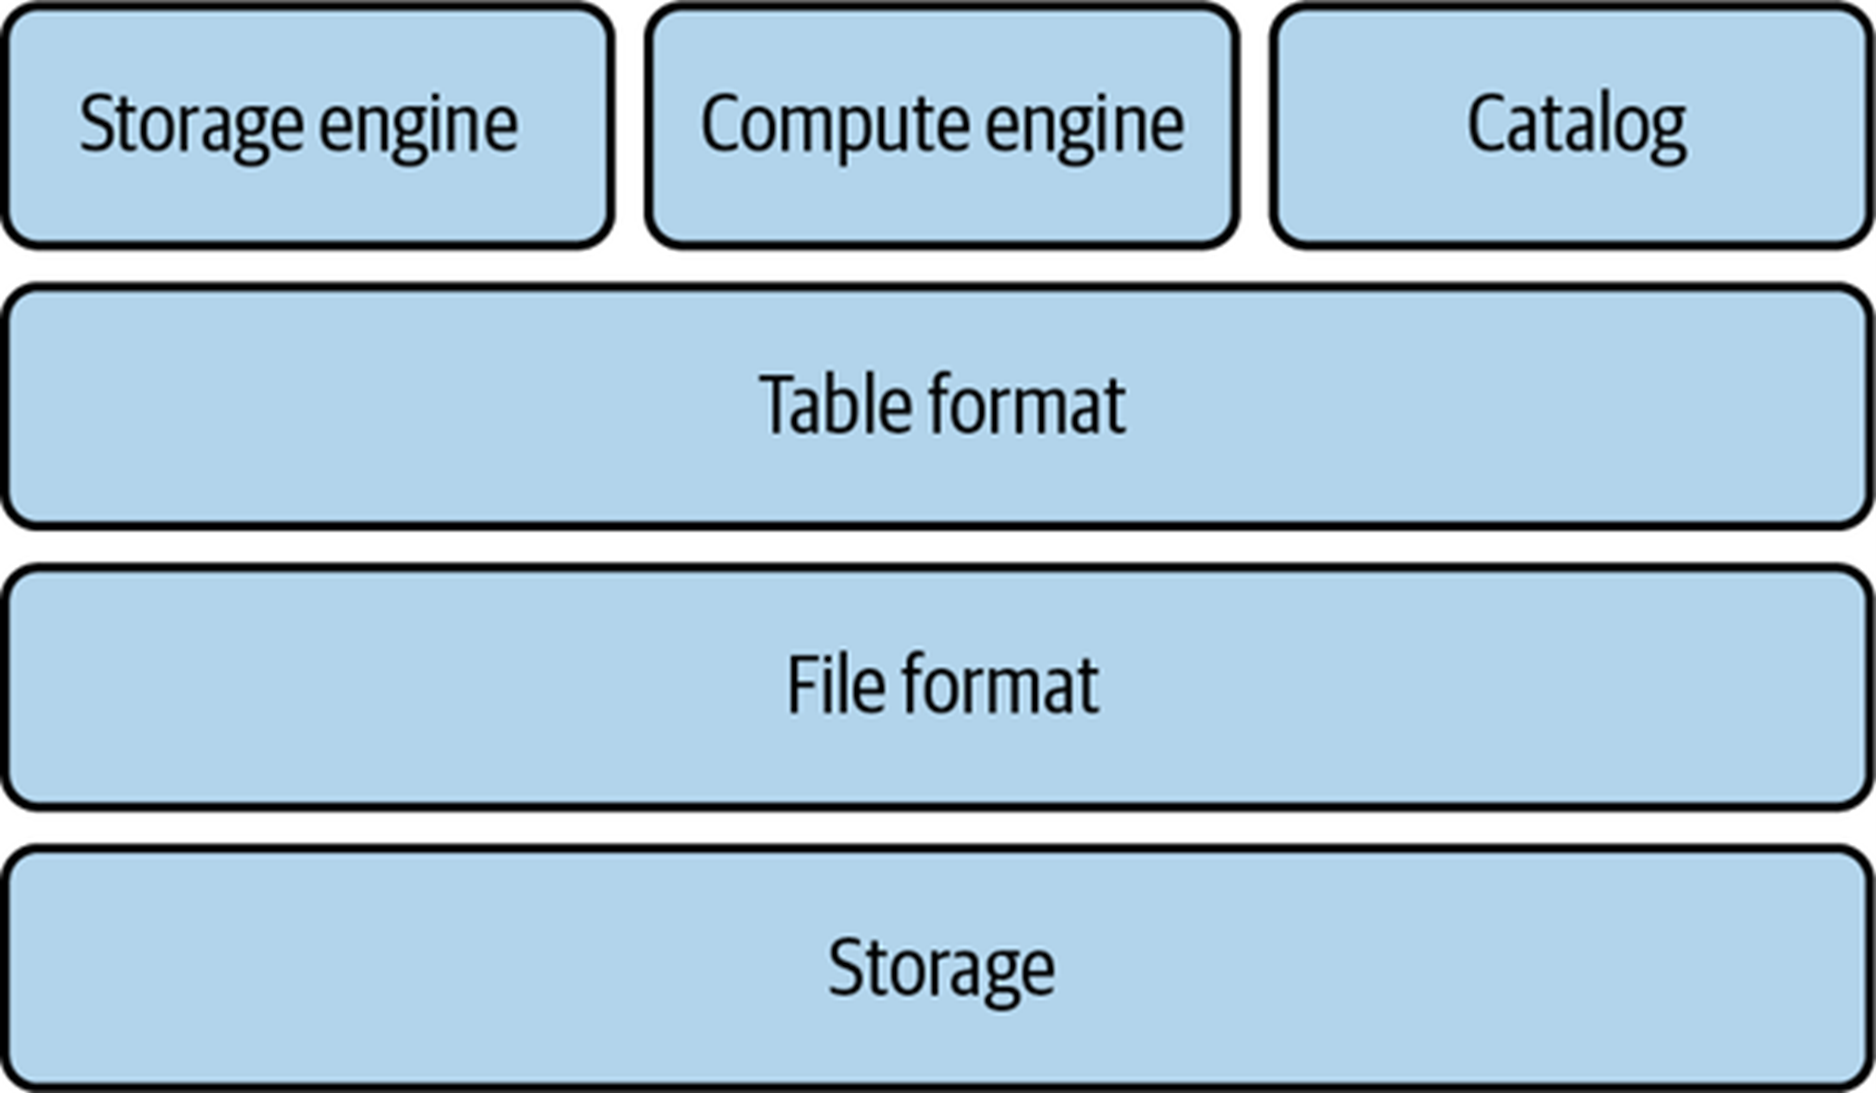
- Хранение (Storage)
Для анализа исторических данных, поступающих из различных источников, необходима система, позволяющая хранить большие объемы данных. Поэтому хранилище - это самый первый компонент, который необходим в системе, способной выполнять аналитические запросы к большим наборам данных. Существует множество вариантов хранения данных, включая DAS, распределенную файловую систему (например, HDFS) и объектное хранилище, предоставляемое в качестве услуги облачными провайдерами, например Amazon Simple Storage Service (Amazon S3).
Что касается форматов хранения, это могут быть базы данных, ориентированные на строки или на столбцы. В некоторых случаях полезно использовать гибридные решения. Однако стоит заметить, что в последние годы наиболее популярным решением являются колоночные БД, поскольку они более эффективны при работе с Big Data.
- Формат файлов (File format)
Для эффективного хранения исходные данные должны быть организованы в определенном формате. Выбор формата влияет на такие параметры, как сжатие файлов, структура данных и производительность конкретной рабочей нагрузки.
Форматы файлов обычно делятся на три категории: структурированные (CSV), полуструктурированные (JSON) и неструктурированные (текстовые файлы). В структурированных и полуструктурированных категориях форматы файлов могут быть ориентированы на строки или на столбцы. Форматы, ориентированные на строки, хранят все столбцы данной строки вместе, а форматы, ориентированные на столбцы, хранят все строки данного столбца вместе. Наиболее распространенными примерами форматов файлов, ориентированных на строки, являются CSV и Apache Avro. Наиболее распространенными фримерами форматов файлов, ориентированных на столбцы, являются Apache Parquet и Apache ORC.
Выбор того или иного формата файлов зависит от Ваших конкретных требований. Например, форматы файлов, ориентированные на строки, более эффективны в том случае, если Вы единовременно работаете с относительно небольшим количеством записей. И наоборот, форматы файлов, ориентированные на столбцы, больше всего подходят в случае, когда Вы единовременно обрабатываете достаточно большое количество записей.
- Формат таблиц (Table format)
Формат таблиц - еще один важный компонент системы, способной поддерживать аналитические нагрузки с агрегированными запросами к огромным массивам данных. Формат таблиц можно сравнить со слоем метаданных поверх формата файлов, который отвечает за то, КАК файлы должны быть размещены в хранилище.
В конечном счете, основная цель формата таблицы заключается в том, чтобы абстрагироваться от сложности физической структуры данных и облегчить такие возможности, как операции языка манипулирования данными (DML) и изменение схемы таблицы.
Современные форматы таблиц также гарантируют атомарность и согласованность данных, необходимые для безопасного выполнения операций DML.
- Движок хранения (Storage engine)
Механизм хранения - это система, отвечающая за то, чтобы данные выкладывались в виде, заданном форматом таблицы. Механизмы хранения решают некоторые важные задачи, такие как физическая оптимизация данных, поддержка индексов, избавление от старых данных и т.д.
- Каталог (Catalog)
При работе с данными из различных источников и в больших объемах важно быстро идентифицировать именно те данные, которые необходимы для анализа. Каталоги призваны решить эту задачу путем использования метаданных. По сути, каталог - это центральное место, где вычислительные машины и пользователи могут узнать о существовании интересующей их таблицы, а также найти дополнительную информацию, такую как имя таблицы, схема таблицы и место хранения данных в системе хранения. Некоторые каталоги являются внутренними, взаимодействовать с ними можно напрямую только через движок этой системы. Примерами таких каталогов являются Postgres и Snowflake. Другие каталоги, такие как Hive и Project Nessie, открыты для использования любой системой. Следует помнить, что эти каталоги метаданных - не то же самое, что каталоги Colibra, Atlan и внутренний каталог Dremio Software.
- Вычислительный движок (Compute engine)
Вычислительный движок - это последний компонент, необходимый для эффективной организации работы с огромным количеством данных, хранящихся в системе хранения. Роль вычислительного механизма заключается в запуске пользовательских рабочих нагрузок для обработки данных. В зависимости от объема данных, вычислительной нагрузки и типа рабочей нагрузки Вы можете использовать один или сразу несколько вычислительных движков. При работе с большим набором данных может потребоваться использование распределенного вычислительного механизма в парадигме MPP. Примерами вычислительных движков, работающих на базе MPP, являются Apache Spark, Snowflake и Dremio.
Собираем все вместе
Все эти технические компоненты объединены в единую систему, более известную как хранилище данных, которая позволяют организациям эффективно хранить информацию, поступающую из различных источников. В следующем разделе мы поговорим о возможностях хранилищ данных, способах интеграции технических компонентов, а также об основных плюсах и минусах такой системы хранения данных.
DWH
Хранилище данных или OLAP БД - это централизованное хранилище, способное хранить большие объемы данных, поступающие из различных источников (ОС, БД приложений и журналы). На рисунке ниже представлен обзор технических компонентов хранилища данных.
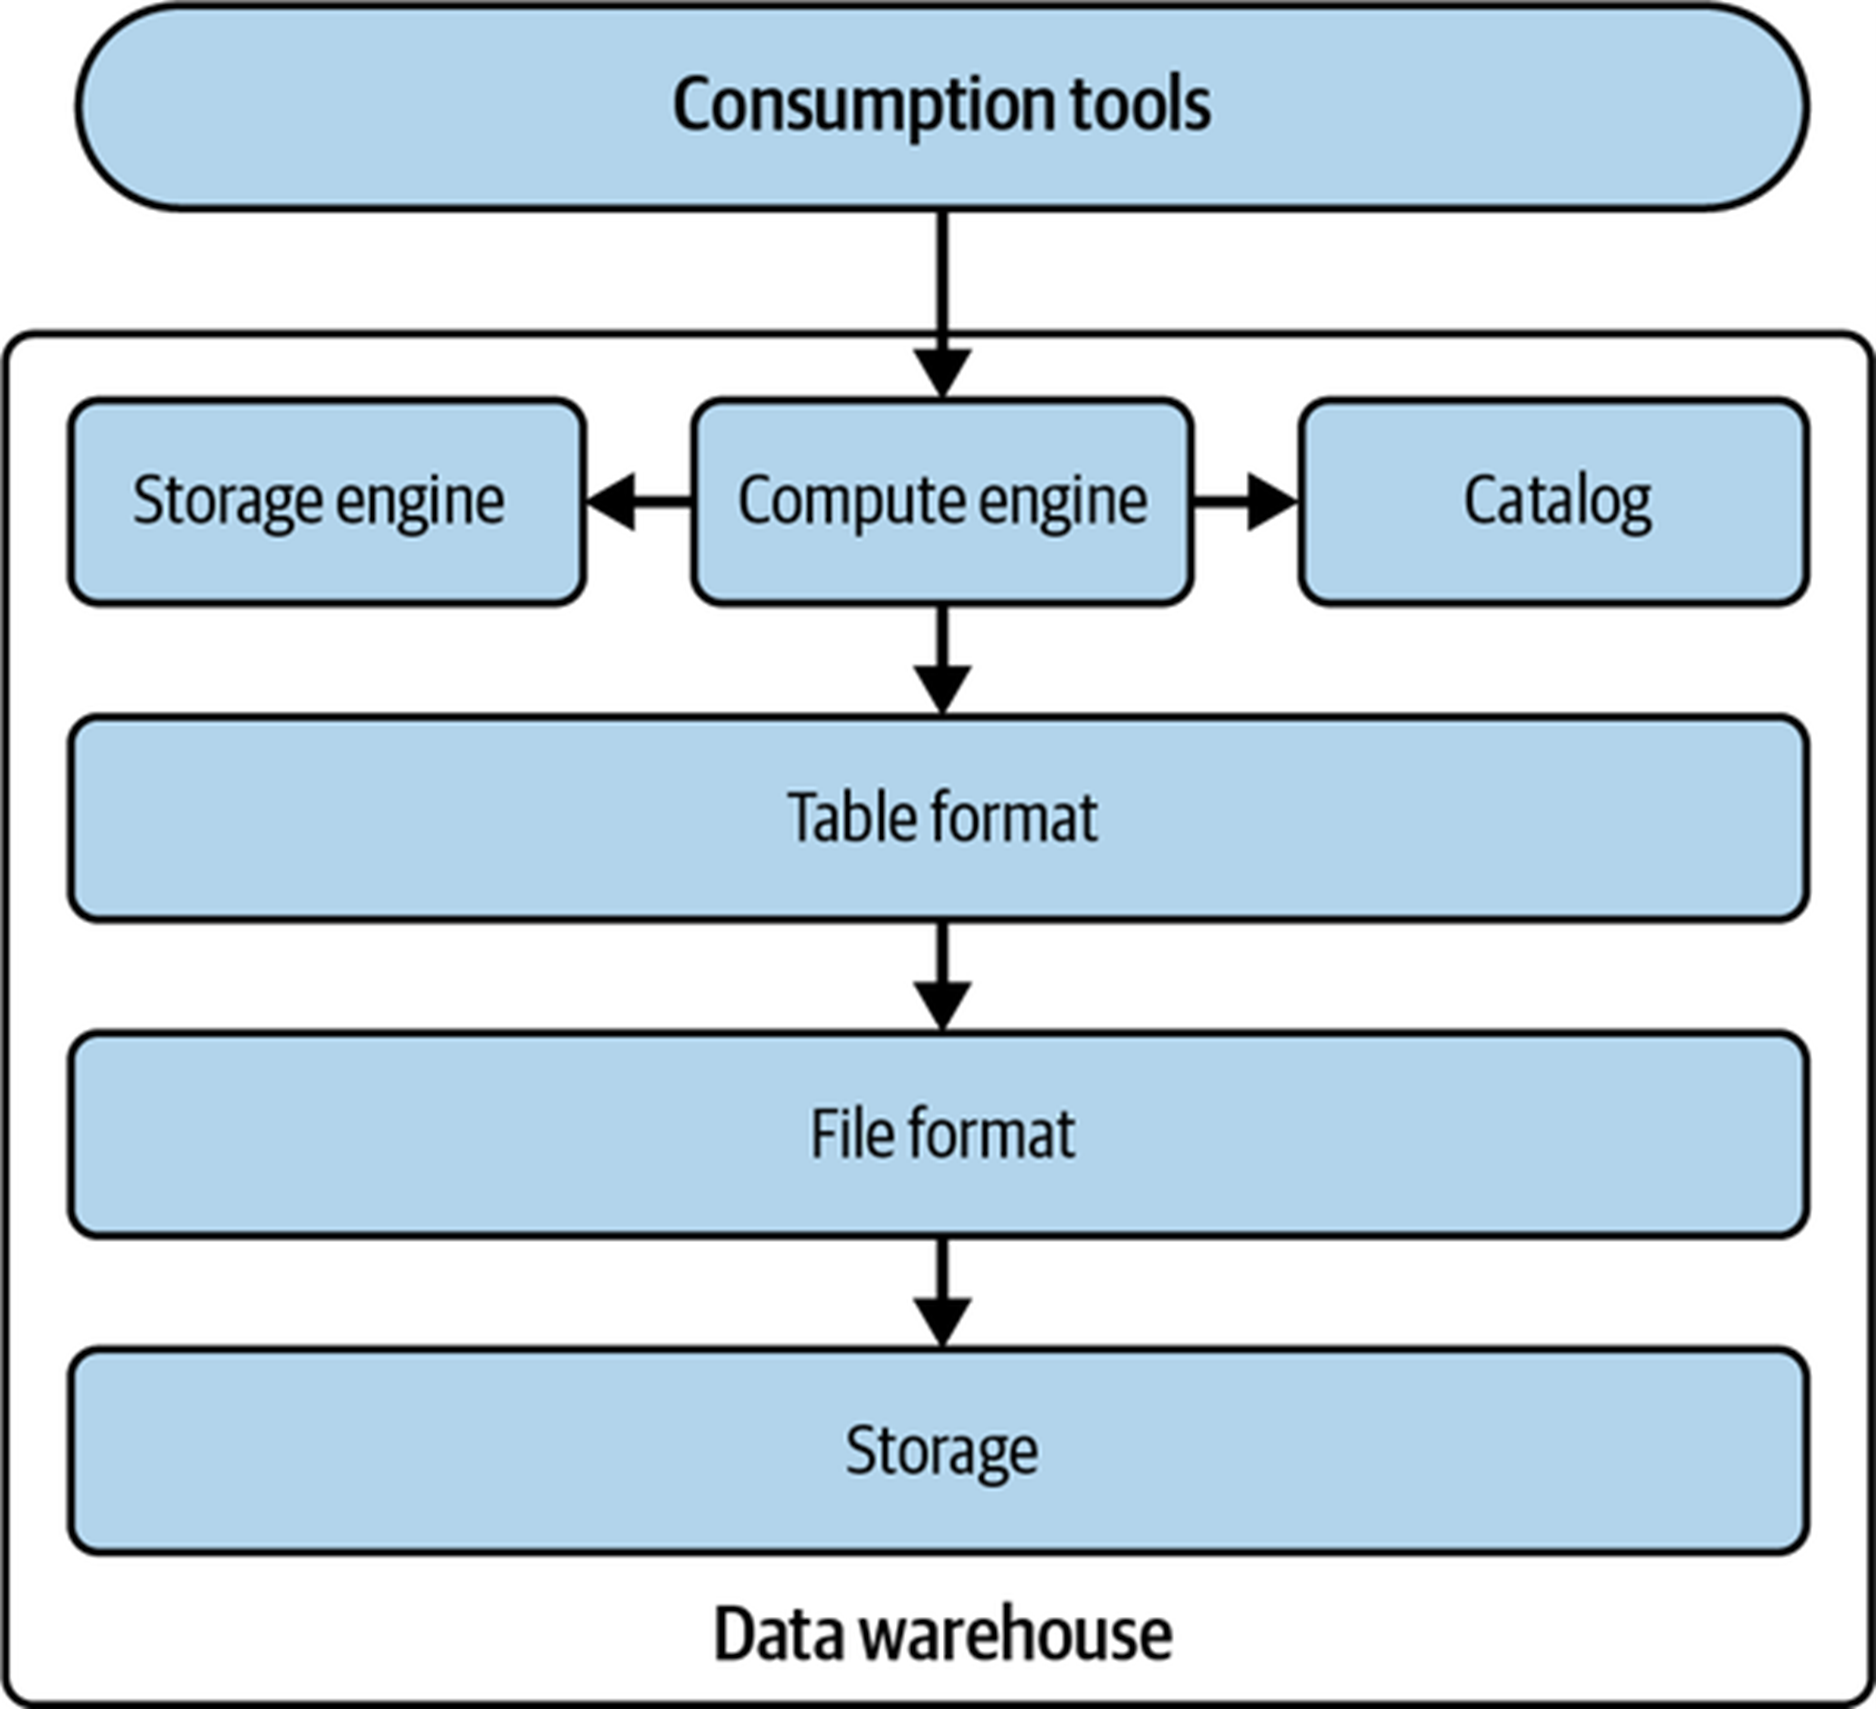
Хранилище данных объединяет все технические компоненты, указанные выше, в единую систему. Другими словами, все данные, поступающие в DWH, хранятся в собственных форматах файлов и таблиц в организованной системе хранения. Ими управляют механизмы хранения DWH, они обязательно регистрируются в его каталоге. Доступ к данным осуществляется через вычислительный механизм.
Краткий экскурс в прошлое
Примерно до 2015 года в большинстве хранилищ данных компоненты хранения и вычислений располагались на одних и тех же узлах, поскольку большинство из них проектировалось и использовалось в одних и тех же помещениях. Однако постепенно такое решение привело к возникновению множества проблем. В частности, возникли сложности с масштабированием отсутствовала возможность независимо увеличивать ресурсы вычислений и хранения в зависимости от задач. Кроме того, если потребности в хранении данных росли быстрее, чем потребности в вычислениях, это не имело никакого значения - Вы все равно должны были платить за дополнительные вычисления, даже если они Вам не требовались.
Это привело к тому, что при создании следующего поколения хранилищ данных разработчики стали ориентироваться на облачные технологии. Популярность таких решений выросла примерно в 2015 году, как раз в то время, когда появились нативные облачные технологии, позволяющие разделять компоненты вычислений и хранения, а также масштабировать эти ресурсы в зависимости от задач. Они позволяли отключать вычисления, когда в них не было необходимости, без ущерба хранению данных.
Плюсы и минусы DWH
Несмотря на то, что хранилища данных, как локальные, так и облачные, позволяют предприятиям быстро ориентироваться во всех своих исторических данных, у них до сих пор есть достаточно существенные минусы.
|
Плюсы |
Минусы |
|---|---|
|
Служит единым источником истины, позволяя хранить и запрашивать данные из различных источников |
Блокировка данных в системе конкретного производителя, которую может использовать только вычислительный механизм хранилища |
|
Дает возможность отправлять запросы к огромным объемам исторических данных, позволяя быстро выполнять аналитические задачи |
Дороговизна хранения данных и вычислений; при увеличении рабочей нагрузки расходы становятся трудноуправляемыми |
|
Обеспечивает эффективное data governance, гарантирует доступность и безопасность данных, создает условия для использования данных в строгом соответствии с политиками безопасности. |
В основном работает только со структурированными данными |
|
Организует данные |
Не позволяет организациям решать такие прогрессивные задачи, как ML |
|
Обеспечивает соответствие данных, записываемых в таблицу, принятой технической схеме |
|
DWH выступает в качестве централизованного хранилища, в котором организации хранят все свои данные, поступающие из разных источников, благодаря чему потребители данных, такие как аналитики и BI-инженеры, могут легко и быстро получить доступ к интересующей их информации. Безусловно, технологические компоненты хранилищ данных позволяют получить доступ к огромным объемам данных, но они не поддерживают запуск таких передовых аналитических нагрузок, как ML.
Хранилища данных сыграли важнейшую роль в развитии корпоративной культуры данных, но со временем стало очевидно, что они ограничены реляционными нагрузками. Вернемся к нашему примеру с транспортной компанией. Скажем, Вы хотите получить информацию о том, сколько примерно Вы заработаете в следующем квартале. В этом случае необходимо построить прогностическую модель на основе исторических данных. К сожалению, Вы не сможете это сделать, использовав лишь хранилище данных. Поэтому оптимальным решением будет перемещение или экспорт данных из DWH на другие платформы, поддерживающие рабочие нагрузки ML. Это означает, что данные будут храниться в нескольких копиях, а необходимость создавать конвейеры для каждого перемещения этих данных может привести к таким нежелательным последствиям, как дрейф данных или полное разрушение модели (ситуация, при которой конвейеры перемещают данные неправильно или непоследовательно).
Еще одним ограничением DWH является то, что оно ориентировано исключительно на структурированные данные. Для получения достоверных прогнозов и выводов этого недостаточно - необходимо анализировать и другие типы данных, такие как полуструктурированные и неструктурированные данные (JSON, изображения, текст и т. д. В нашем случае анализ большого объема данных различных типов поможет нам лучше понять тональность всех новых отзывов о бронированиях, сделанных в предыдущем квартале (положительные или отрицательные отзывы) и определить дальнейшие действия. В конечном итоге это повлияет на способность организации принимать стратегически важные решения, направленные на ее развитие.
При проектировании DWH важно учесть ряд особенностей. На рисунке 2, расположенном выше, можно заметить, что все шесть технических компонентов тесно связаны между собой. Реализация этого шаблона проектирования приводит к закрытой форме архитектуры данных. Это означает, что имеющиеся у Вас данные становятся доступными только с помощью вычислительного механизма хранилища данных, который специально разработан для взаимодействия с табличными и файловыми форматами DWH. К сожалению, основным недостатком подобной архитектуры данных является возможная блокировка данных. С ростом рабочих нагрузок и объемов данных, поступающих в хранилище с течением времени, Вы неизбежно привязываетесь к конкретной платформе. Это означает, что Ваши аналитические задачи, а также любые BI – инструменты, которые Вы планируете использовать в будущем, будут работать только на базе этой платформы. Если Вы захотите поменять ее на другую, более прогрессивную, Вы обязательно столкнетесь с рядом достаточно серьезных проблем и трудностей.
Кроме того, хранение данных в DWH связано со значительными затратами. Cо временем эти затраты только возрастают, что приводит к увеличению количества вычислительных ресурсов. Помимо денежных затрат существуют и другие расходы, такие как необходимость в управлении многочисленными конвейерами для перемещения данных из ОС и более длительное время передачи данных потребителям. Все эти сложности заставили организации искать более «бюджетные» альтернативные платформы данных, позволяющие хранить информацию в открытых форматах файлов, что дает возможность работать с такими приложениями, как BI и ML. Так появились озера данных.
Data Lake
Итак, DWH были разработаны для хранения структурированных данных. Помимо ряда преимуществ у них есть ряд недостатков/ ограничений:
- DWH может работать ТОЛЬКО со структурированными данными;
- Хранение данных в DWH обходится дороже, чем использование соответствующих облачных технологий или кластеров Hadoop;
- Как правило, cистемы хранения и вычислений в традиционных локальных хранилищах данных объединены и поэтому не могут масштабироваться по отдельности. Увеличение затрат на хранение данных неизбежно повлечет за собой увеличение затрат на вычисления независимо от того, нужны Вам дополнительные вычислительные мощности или нет.
Для решения всех этих задач требовалось альтернативное решение по хранению данных, которое было бы дешевле и позволяло хранить абсолютно все данные без необходимости строго соблюдения определенной схемы. Таким альтернативным решением и стало озеро данных.
Краткий экскурс в прошлое
Изначально для хранения больших объемов структурированных и неструктурированных данных использовался Hadoop, фреймворк распределенных вычислений с открытым исходным кодом, а также его главный компонент HDFS. Но одного только хранения недостаточно – данные необходимо обрабатывать и анализировать.
Экосистема Hadoop включала в себя MapReduce, аналитический фреймворк, с помощью которого можно было писать аналитические задания на Java и затем запускать их на кластере Hadoop. Написание заданий MapReduce было достаточно сложным процессом, кроме того, многим аналитикам было удобнее и привычнее писать запросы на SQL. В результате для преобразования SQL-запросов в задания MapReduce был создан Hive.
Со временем люди перешли от использования кластеров Hadoop к облачным хранилищам данных (например, Amazon S3, Minio, Azure Blob Storage. Они были гораздо проще в управлении и дешевле. Вместо MapReduce пользователи начали использовать другие подобные решения, такие как Apache Spark, Presto и Dremio. Появился формат таблиц Hive, который достаточно быстро стал стандартом и эталоном в области распознавания файлов в DWH как отдельных таблиц. Однако облачные хранилища требовали больших сетевых затрат на доступ к этим файлам, чего архитектура формата Hive не могла себе позволить.
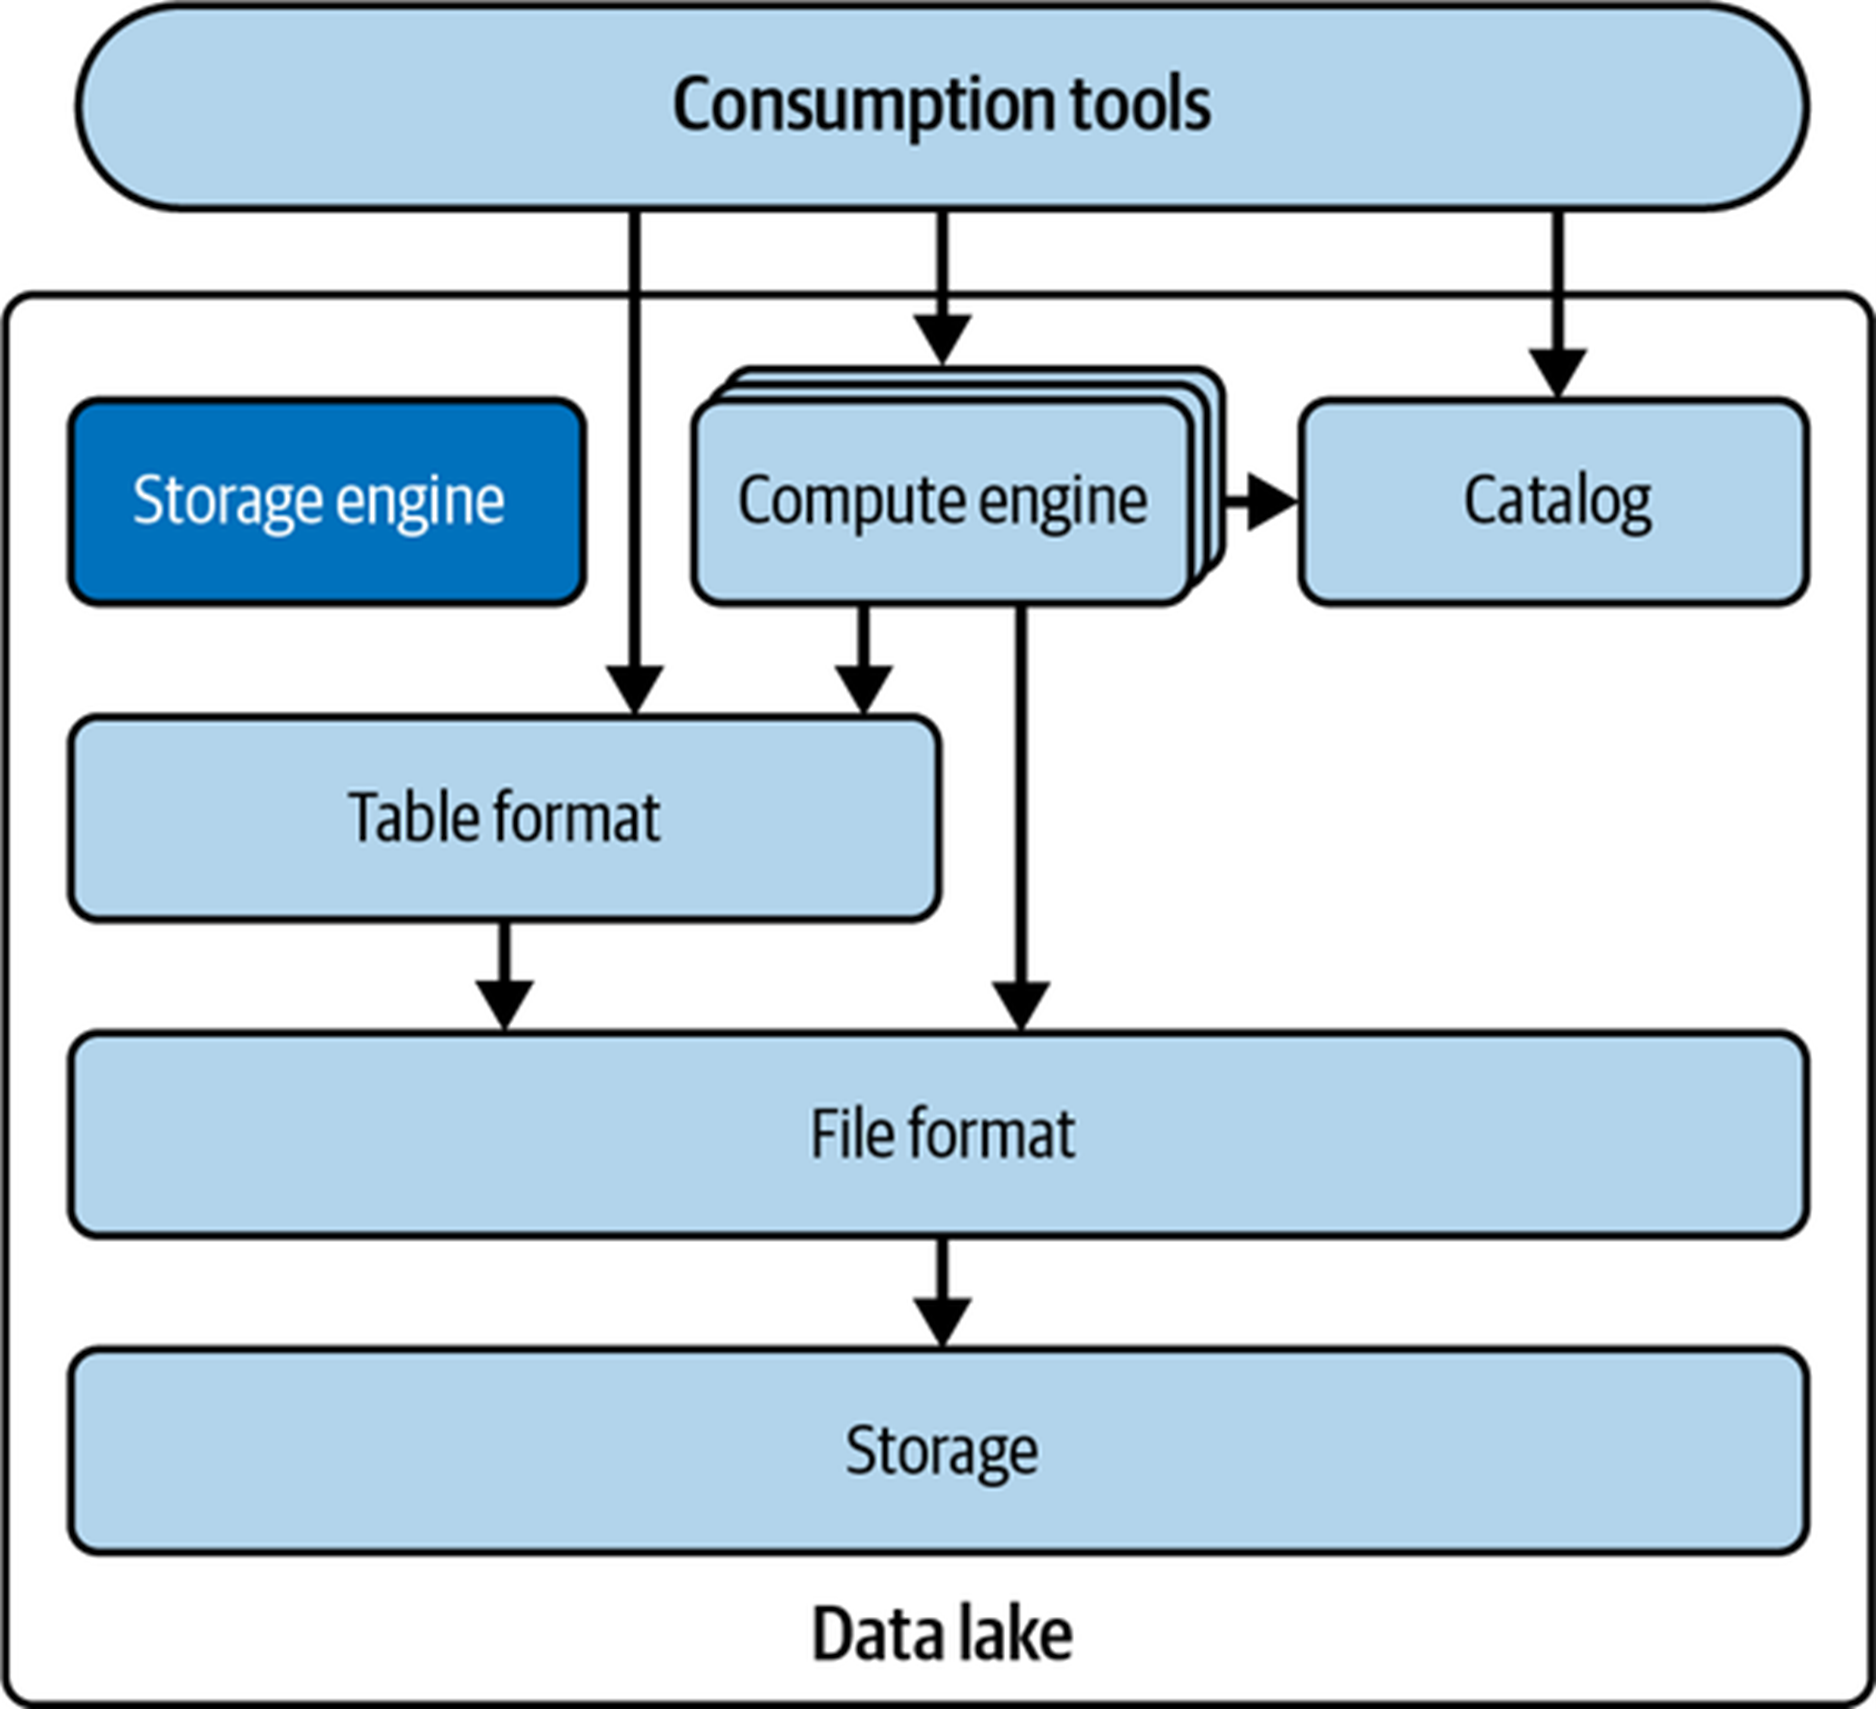
Отличительной чертой Data Lake от DWH является возможность использования различных вычислительных машин для разных рабочих нагрузок. Это важно, потому что универсального вычислительного движка, который подходил бы абсолютно для всех рабочих нагрузок и который мог бы масштабировать вычисления независимо от хранения, просто-напросто не существует.
Обратите внимание на то, что в Data Lake на самом деле нет ни одного сервиса, который бы выполнял функции механизма хранения. Как правило, вычислительный механизм определяет то, как записать данные. Как правило, по происшествии некоторого времени эти данные не пересматриваются и не оптимизируются, если только не переписываются целые таблицы или разделы. На рисунке 3 показано то, как компоненты Data Lake взаимодействуют друг с другом.
Плюсы и минусы DWH
Безусловно, идеального архитектурного решения не существует. То же самое касается и Data Lake. Наряду с очевидными преимуществами, у озер данных есть и свои недостатки.
Основные преимущества Data Lake:
- Сравнительно низкая стоимость хранения данных - затраты на хранение данных и выполнение запросов в Data Lake гораздо ниже по сравнению с DWH. Это делает озеро данных более привлекательным с точки зрения необходимости выполнения анализа хранящихся в нем данных.
- Хранение данных в открытом формате - В озере данных Вы можете хранить данные в любом удобном для Вас формате. Соответственно, Вы имеете доступ к более обширному набору данных разных форматов и можете использовать больше инструментом BI, чем в случае с DWH. Напомним, что в рамках хранилищ данных Вы можете работать только со структурированными данными, формат которых создан для каждого конкретного хранилища данных.
- Работа с неструктурированными данными - хранилища данных не предназначены для работы с неструктурированными данными, такими как данные датчиков, вложения электронной почты и файлы журналов. Соответственно, если Вы планируете анализировать неструктурированные данные, Вам понадобится озеро данных.
Основные недостатки Data Lake:
- Производительность – компоненты озера данных отделены друг от друга, вследствие чего невозможно осуществлять многие оптимизации, такие как индексирование данных и гарантии ACID (Atomicity, Consistency, Isolation, Durability). Если для Вас имеет значение производительность системы и скорость обработки запросов, имейте в виду то, что Data Lake не совсем то, что Вам нужно.
- Потребность в большом количестве дополнительных настроек и доработок - создание более тесной связи между компонентами Data Lake и достижение определенного уровня оптимизации потребует множества доработок, с чем могут справиться только опытные дата-инженеры, чьи услуги обходятся достаточно дорого;
- Отсутствие ACID- транзакций - в озерах данных данные поступают в виде схемы при чтении, что означает, что проверка схемы и согласованности происходит в процессе обработки данных, а не в момент их поступления. Это может создавать проблемы для приложений, требующих высокой транзакционной целостности, таких как финансовые системы или приложения, работающие с конфиденциальными данными. Достижение подобных транзакционных гарантий в озере данных обычно связано с реализацией сложных конвейеров обработки данных и механизмов координации, что увеличивает объем работы дата-инженеров. Хотя озера данных и отличаются высокой масштабируемостью и гибкостью, они все же не смогут соответствовать высоким требованиям строгого соответствия ACID.
Все за и против Data Lake представлены в таблице ниже.
|
За |
Против |
|---|---|
|
Сравнительно низкие затраты |
Производительность Нет гарантии соблюдения требований ACID |
Data Lake или DWH – что лучше в плане аналитики данных?
Хотя озера данных представляют собой практически идеальное место для хранения структурированных и неструктурированных данных, у них , как уже говорилось ранее, все же есть ряд достаточно весомых недостатков. В частности, это касается выполнения процессов ETL перед размещением данных в Data Lake.
Можно настроить дополнительный ETL-конвейер для создания копии курируемого подмножества данных, предназначенных для аналитики, и сохранить ее в хранилище для того, чтобы получить большую производительность и гибкость хранилища данных.
Однако подобное решение может привести к следующим нежелательным результатам:
- Дополнительные затраты на вычисления для выполнение ETL-процессов и на хранение копии данных, которые уже хранятся в хранилище данных;
- Дополнительные копии данных, которые могут потребоваться для наполнения витрин данных для различных направлений бизнеса, а также для создания информативных дашбордов. В итоге создается самая настоящая паутина копий данных, которые трудно контролировать, отслеживать и синхронизировать.
В качестве альтернативы для выполнения запросов к озеру данных можно использовать механизмы запросов, поддерживающие работу с озерами данных, такие как Dremio, Presto, Apache Spark, Trino и Apache Impala. Эти механизмы хорошо подходят для рабочих нагрузок, связанных только с чтением.
Итак, у озер данных, как и у хранилищ данных, есть свои преимущества и недостатки. В связи с этим возникла необходимость в разработке новой архитектуры, которая усиливала бы преимущества этих двух парадигм и минимизировала бы их недостатки. Такая архитектура была разработана – это Data Lakehouse.
Data Lakehouse
Если использование DWH обеспечивало нам производительность и простоту использования, то аналитика Data Lake давала нам более низкую стоимость хранения данных, высокую гибкость за счет использования открытых форматов данных, а также возможность использования неструктурированных данных. Стремление к совершенству привело нас к решению под названием «озеро данных» или Data Lakehouse.
Архитектура Data Lakehouse разделяет хранение и вычисления и привносит механизмы, позволяющие реализовать функциональность, подобную хранилищу данных (транзакции ACID, лучшая производительность, согласованность и т. д.). Такой функционал обеспечивается за счет форматов таблиц для озер данных, которые устраняют все предыдущие проблемы с форматом таблиц Hive. Что действительно важно в рамках Data Lakehouse, так это формат таблиц, обеспечивающий слой метаданных/абстракций между движком и хранилищем для их более интеллектуального взаимодействия (смотрите рис. 4).
Форматы таблиц создают слой абстракции поверх файлового хранилища, который обеспечивает лучшую согласованность, производительность и гарантии ACID при работе с данными непосредственно в хранилище озера данных, что позволяет сделать несколько ценных предложений:
- Меньше копий = меньше дрифта
Благодаря гарантированному соблюдению требований ACID и более высокой производительности Вы можете перенести рабочие нагрузки, обычно предназначенные для DWH (например, обновления и другие манипуляции с данными) в Data Lakehouse, что позволит сократить расходы и создать более рациональную архитектуру с меньшим количеством копий. Меньше копий = меньше трат на хранение данных, на вычисления при перемещении данных в DWH, меньше дрифта данных, а также более эффективное управление данными.
- Быстрая обработка запросов = быстрое получение ценных сведений
Конечная цель работы с данными – получение ценных и проверенных сведений. Все остальное - лишь шаги на пути к этой цели. Чем меньше времени Вы тратите на обработку данных, тем быстрее получаете интересующую Вас информацию. Data Lakehouse позволяет выполнять запросы быстрее, чем DWH или Data Lake за счет оптимизации механизма запросов (например, кэширование), формата таблиц (планирование запросов с использованием метаданных) и работы с форматами файлов (сортировка, сжатие и т.д.).
- Исторические моментальные снимки данных = незначительные ошибки
Таблицы Data Lakehouse сохраняют исторические снимки данных, что дает возможность запрашивать и восстанавливать таблицы по их предыдущим снимкам. Вы можете работать с данными и при этом спокойно спать по ночам, не переживая о том, что из –за какой-либо ошибки придется проводить многочасовые аудит, восстанавливать систему и проводить резервное копирование.
- Продуманная архитектура = выгода для бизнеса
Увеличить прибыль можно двумя способами: увеличить доход или снизить затраты. Data Lakehouse не только помогают получать ценную для бизнеса информацию, способствующую росту доходов, но и снижают затраты. Благодаря данной парадигме Вы можете значительно сократить расходы на хранение данных, избежав их дублирования, обойтись без дополнительных вычислительных затрат, а также оптимизировать расходы на используемые Вами системы хранения и вычисления.
- Открытая архитектура = душевное спокойствие
Data Lakehouse строятся на основе открытых форматов, таких как Apache Iceberg - формат таблиц и Apache Parquet - формат файлов. Многие инструменты могут читать и записывать данные в эти форматы, что позволяет избежать привязки к одному конкретному поставщику. Используя открытые форматы, Вы можете быть спокойны за то, что у Вас есть доступ к широкому спектру решений и инструментов по работе с данными.
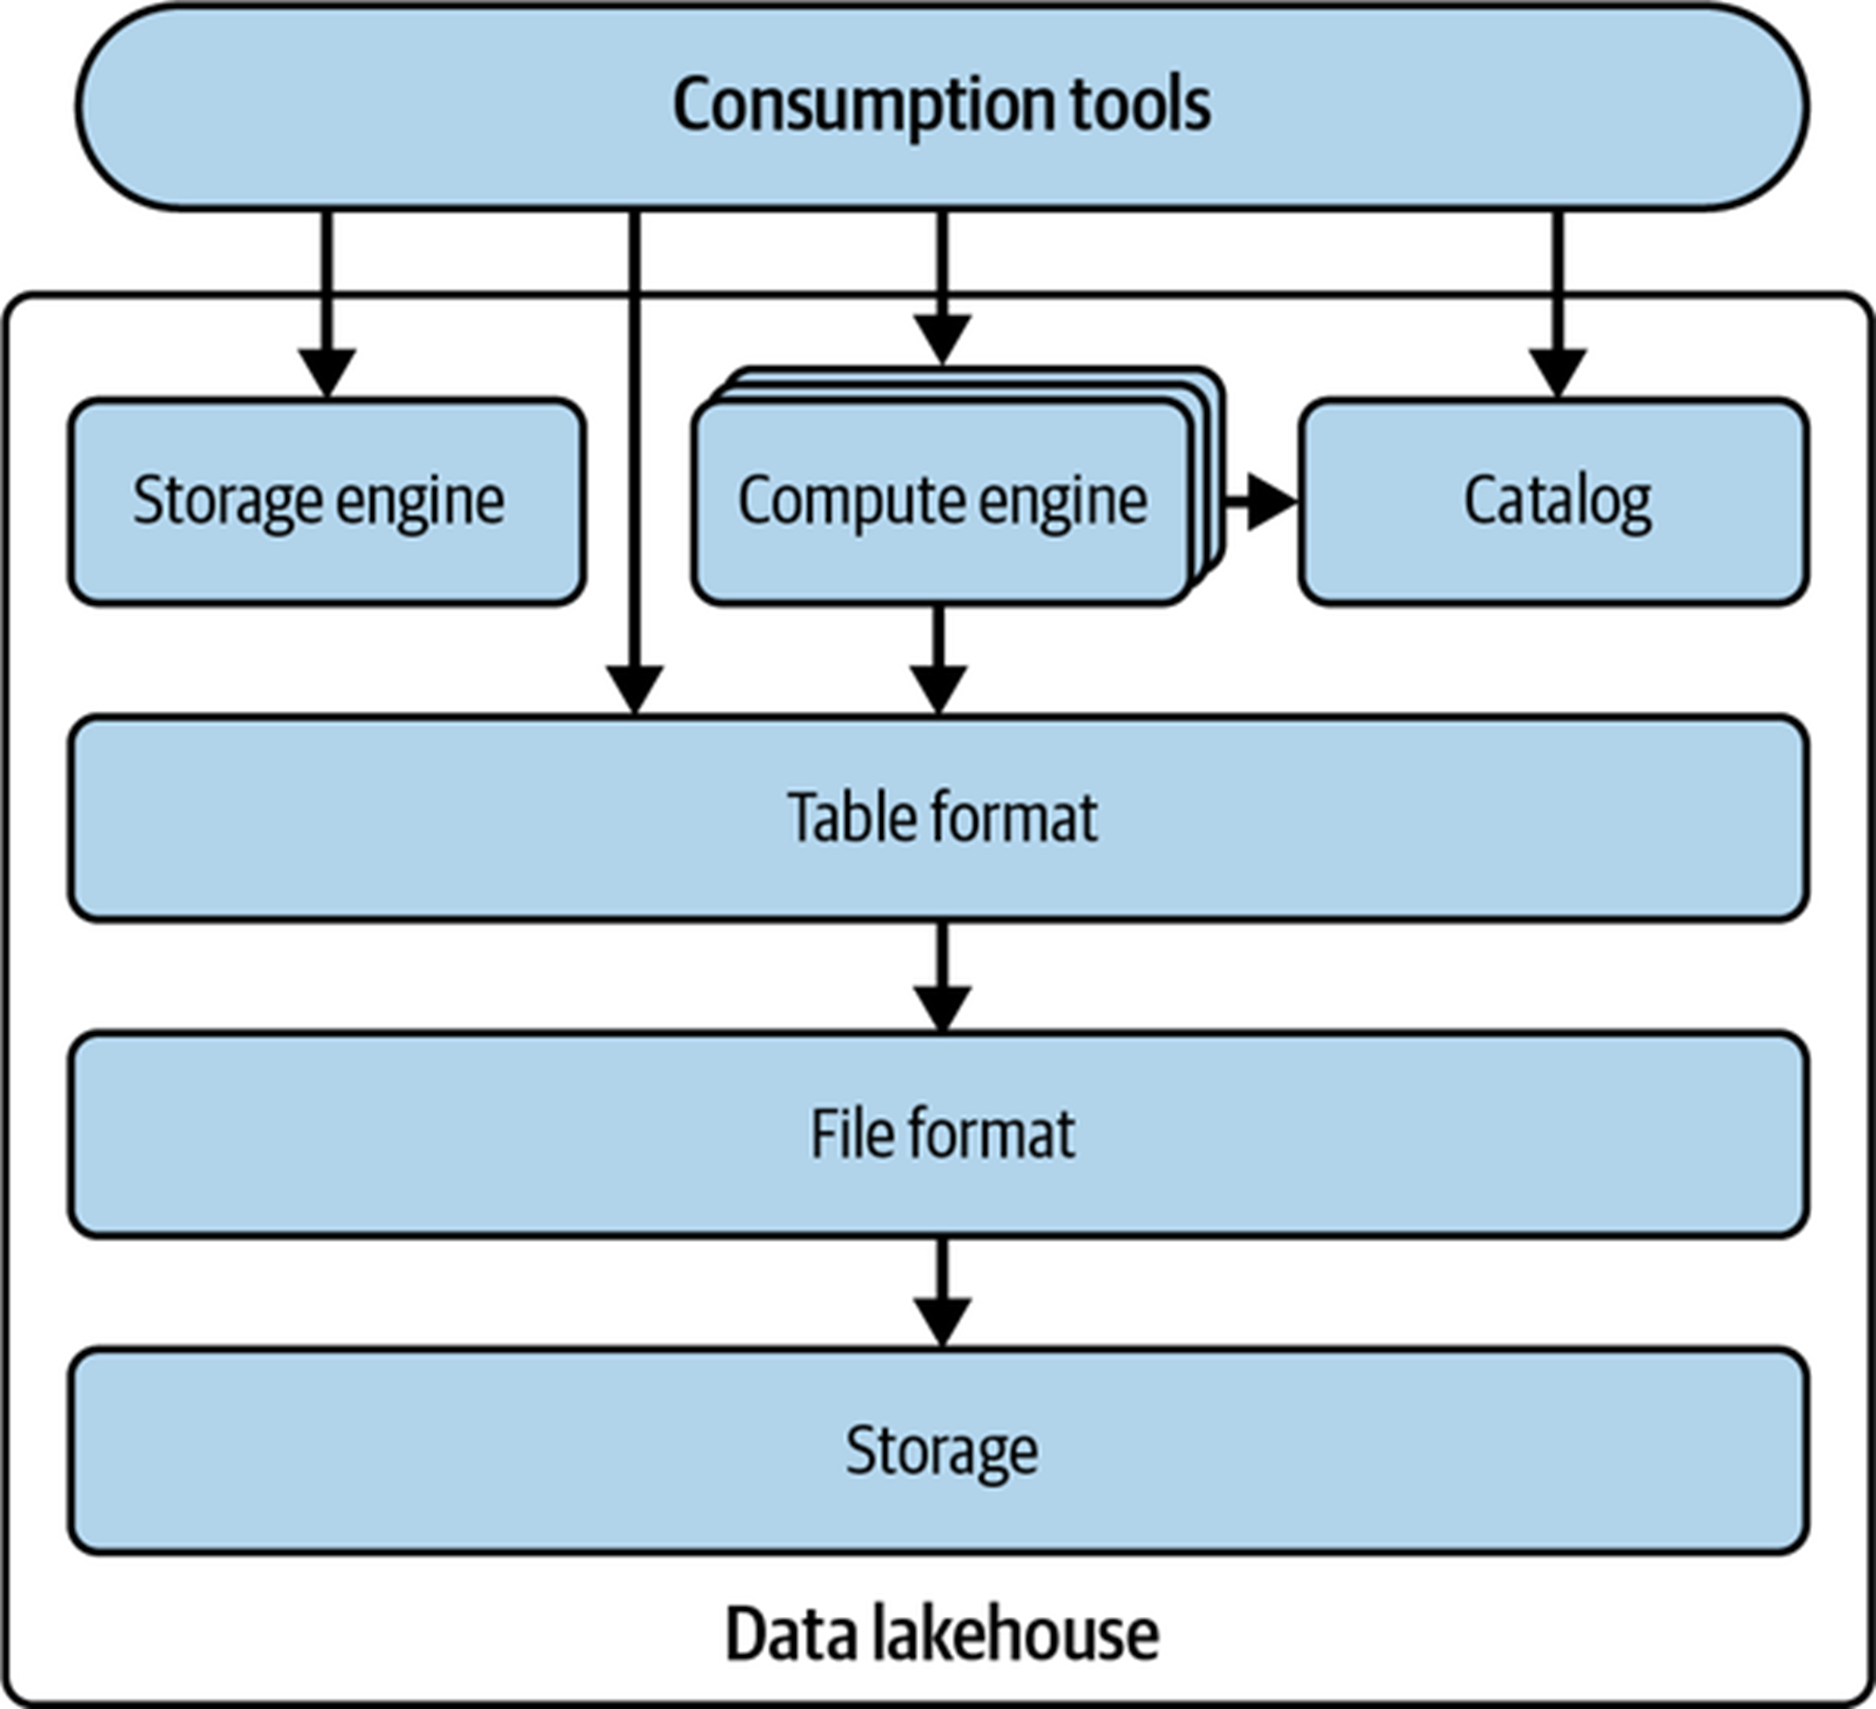
Подводя итог, можно сказать, что благодаря современным инновациям, связанным с открытыми стандартами работы с данными, о которых мы говорили ранее, можно создать почти что идеальное место для хранения данных - Data Lakehouse. Его самый главный компонент – это формат таблиц, позволяющий движкам БД достигать более высоких показателей производительности по сравнению с Data Lake и DWH. Теперь давайте обсудим формат таблиц под названием Apache Iceberg.
Что такое формат таблицы?
Формат таблицы - это метод структурирования файлов набора данных для представления их в виде единой «таблицы». С точки зрения пользователя, данное понятие можно определить как ответ на вопрос «какие данные находятся в этой таблице?».
Формат таблицы позволяет нескольким людям, командам и даже инструментам эффективно взаимодействовать с данными в таблице, будь то чтение или запись. Его основная цель заключается в предоставлении пользователям и инструментам абстракции таблицы, благодаря чему работа с данными становится более эффективной.
Понятие форматов таблиц существуют с момента появления таких СУБД, как System R, Multics и Oracle, которые впервые реализовали реляционную модель Эдгара Кодда. В этих системах пользователи могли называть набор данных таблицей, движок базы данных отвечал за управление расположением байтов набора данных на диске в виде файлов, а также за обработку таких сложных операций, как транзакции.
Все операции с данными в этих СУБД осуществляются движком хранения базы данных. Никакой другой механизм не может взаимодействовать с файлами напрямую, не повредив при этом системы. Детали хранения данных абстрагированы, и пользователи считают само собой разумеющимся, что платформа знает, где находятся искомые данные и как к ним следует обращаться.
Однако сегодня, в разгар эры Big Data, полагаться только лишь на одну закрытую вычислительную машину для управления всем доступом к базовым данным непозволительно. Ваши данные должны быть доступны для различных вычислительных машин, оптимизированны для различных сценариев использования, таких как BI или ML.
В озере данных все данные хранятся в виде файлов в каком-либо хранилище (например, Amazon S3, Azure Data Lake Storage [ADLS], Google Cloud Storage [GCS]), поэтому одна таблица может состоять из десятков, сотен, тысяч или даже миллионов отдельных файлов. При использовании SQL наряду с наиболее популярными аналитическими инструментами или написанием специальных запросов на таких языках, как Java, Scala, Python и Rust совершенно не хочется разбираться с тем, какие именно файлы находятся в таблице, а каких в ней нет. Мало того, что это слишком утомительно, так еще и чревато несогласованностью данных.
Поэтому оптимальным решением стало создание стандартного метода понимания того, «какие данные находятся в той или иной таблице».
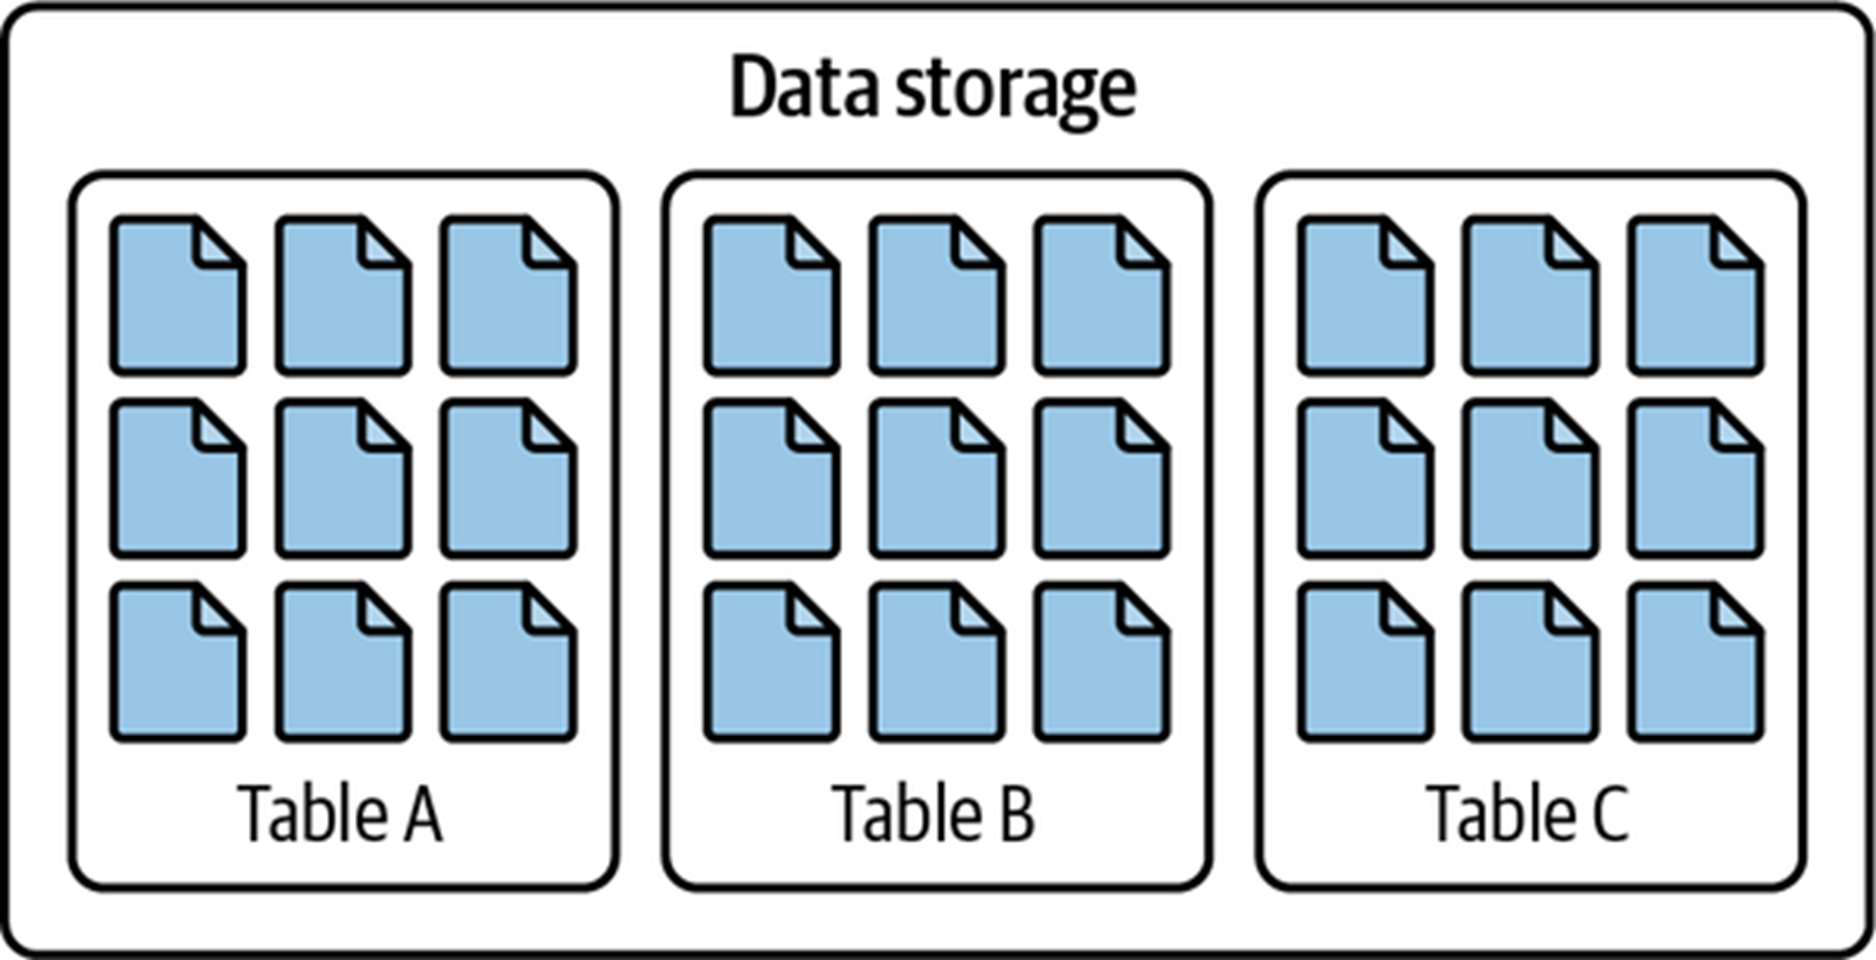 .
Hive: первоначальный формат таблицы
Когда понадобилась аналитика на Hadoop Data Lake, пользователи начали использовать MapReduce, основным минусом которого являлась необходимость написания сложных запросов на Java. В 2009 году Facebook, устав от таких утомительных и нудных рабочих процессов, разработал фреймворк под названием Hive, ключевым преимуществом котрого стало значительное упрощение аналитических процессов на Hadoop – наконец-то запросы можно было составлять на известном всем SQL.
Hive получал SQL-запросы и затем преобразовывал их в задания MapReduce. Для оптимального написания SQL-запросов нужен был надежный механизм, который позволял бы понять, какие данные в хранилище Hadoop представляют собой уникальную таблицу - так появились формат таблиц Hive и метахранилище Hive Metastore, необходимое для отслеживания этих таблиц.
Формат таблиц Hive предполагает определение таблицы как всех файлов, хранящихся в указанном каталоге. Партициями этих таблиц являются подкаталоги. Пути к каталогам, определяющим таблицу, отслеживаются службой под названием Hive Metastore, к которой могут обращаться все системы запросов.
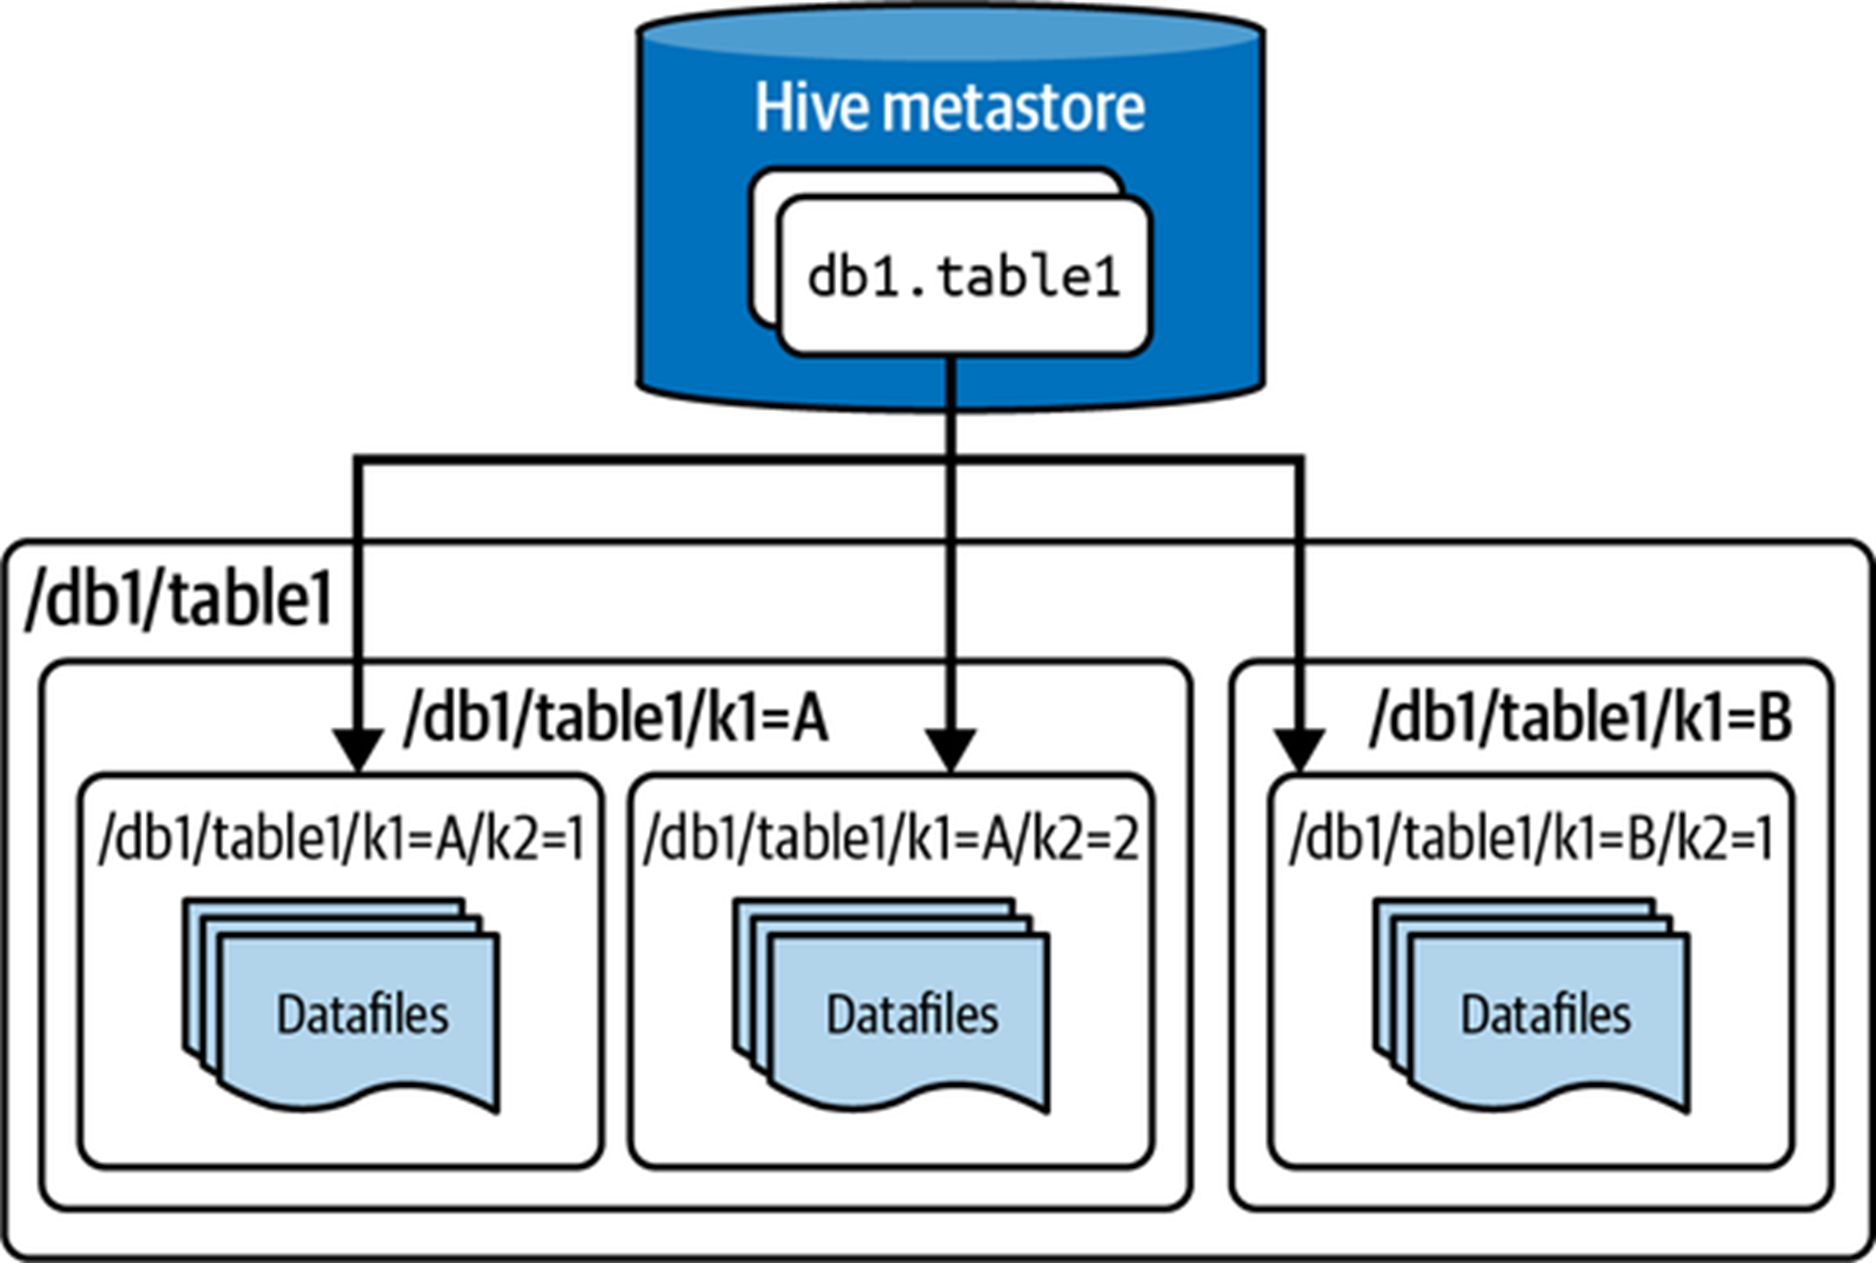
Основные преимущества формата Hive:
- Позволял выполнять более эффективные запросы - вместо полного сканирования таблиц применялись такие техники, как патеционирование и бакетирование.
- Не зависел от формата файлов, что позволило сообществу разработчиков со временем разработать более совершенные форматы файлов, такие как Apache Parquet. Кроме того, формат Hive не требовал преобразования данных перед тем, как сделать их доступными в таблице Hive (например, Avro, CSV/TSV).
- С помощью атомарной замены перечисленных каталогов в метахранилище Hive можно было вносить все изменения в отдельные разделы таблицы.
Со временем этот формат стал эталоном, совместимым с большинством популярных инструментов для работы с данными. Он позволял однозначно ответить на самый главный вопрос -«Какие данные содержатся в этой таблице?».
Однако по происшествию некоторого времени стало очевидно, что не так уж все и безоблачно:
- Изменения на уровне файлов неэффективны, поскольку механизма атомарной замены файла, подобно тому, как метахранилище Hive можно использовать для замены каталога раздела, не существует. По сути, для того, чтобы атомарно обновить один файл, можно только лишь выполнить подстановки на уровне разделов,
- Автомарно поменять разделы местами было возможно, но при этом не было механизма для атомарного обновления нескольких разделов в рамках одной транзакции.
- В любом случае, идеальных механизмов для обеспечения одновременного обновления данных не существует.
- Использование механизма, перечисляющего файлы и каталоги, занимало слишком много времени и замедляло выполнение запросов. Кроме того, чтение файлов и каталогов, которые, возможно, и не нужно сканировать в результирующем запросе, обходится достаточно дорого.
- Столбцы партиций часто выбирались из других столбцов, например, столбец месяца выводился из временной метки. Партиционирование помогало только в том случае, если Вы фильтровали по столбцу партиций.
- Статистика таблиц собиралась с помощью асинхронных заданий, в результате чего зачастую пользователи получали статистику состояния таблицы (если она вообще была доступна). Это значительно затрудняло дальнейшую оптимизацию запросов.
- Поскольку объектные хранилища часто ограничивают запросы по одному префиксу (считайте префикс объектного хранилища аналогом каталога файлов), запросы к таблицам с большим количеством файлов в одном разделе (так что все файлы будут в одном префиксе) могут иметь обрабатываться достаточно долго, что негативно сказывается на производительности в целом.
По мере роста объема данных и расширения спектра сценарий использования все эти проблемы становились все очевиднее и очевиднее, появилась необходимость в разработке решения, которое могло бы нивелировать все эти минусы.
Современные форматы файлов Data Lake
Пытаясь обойти все ограничения формата таблиц Hive, разработчики создали совершенно новое поколение форматов таблиц.
Создатели современных форматов таблиц поняли, что основным недостатком формата таблиц Hive являлось то, что определение таблицы было основано на содержимом каталогов, а не на отдельных файлах данных. Улучшенные форматы таблиц, такие как Apache Iceberg, Apache Hudi и Delta Lake, используют именно этот подход, определяя таблицы как список файлов и предоставляя метаданные для движков, информирующие о том, какие именно файлы (а не каталоги) составляют таблицу. Такой более детальный подход к определению «что такое таблица» открыл двери для таких возможностей, как транзакции ACID, «перемещение во времени» и многое другое.
Все современные форматы таблиц призваны обойти все основные ограничения формата таблиц Hive:
- Они позволяют выполнять ACID транзакции, которые являются более безопасными. Они либо полностью завершаются, либо полностью отменяются. В устаревших форматах, таких как формат таблиц Hive;
- Они обеспечивают более безопасные транзакции при наличии нескольких пользователей. Если два или более пользователя записывают данные в таблицу, специальный механизм следит за тем, чтобы пользователь, который завершает свою запись вторым, знает и учитывает то, что сделали пользователи – так достигается согласованность данных;
- Они предлагают более оптимальный способ сбора статистики таблицы и метаданных, что позволяет механизму запросов планировать сканирование более эффективно.
Давайте узнаем, что же такое Apache Iceberg и как именно он появился.
Что такое Apache Iceberg?
Apache Iceberg - это формат таблиц, созданный в 2017 году сотрудниками Netflix Райаном Блю и Дэниелом Уиксом. Он возник в результате поисков способов преодоления проблем с производительностью, согласованностью данных и т.д. В 2018 году проект получил статус open-source решения и был передан в Apache Software Foundation, где к его разработке подключились многие другие организации, включая Apple, Dremio, AWS, Tencent, LinkedIn и Stripe.
Как появился Apache Iceberg
В процессе создания формата Apache Iceberg компания Netflix пришла к выводу, что многие проблемы формата Hive связаны с одним достаточно простым, но основополагающим недостатком: каждая таблица отслеживалась в виде каталогов и подкаталогов, что ограничивает детализацию, необходимую для обеспечения гарантий согласованности, лучшего параллелизма и ряда функций, присущих DWH.
Учитывая все вышесказанное, компания Netflix решила создать принципиально новый формат таблиц, основными задачами которого были бы следующие:
- Согласованность
Если обновления таблицы происходят сразу в нескольких партитициях, конечные пользователи не должны страдать от несогласованности данных. Обновление таблицы в нескольких партитициях должно выполняться быстро и атомарно. Пользователи могут видеть данные либо до их обновления, либо после, но не в процессе изменения.
- Производительность
Перечисление файлов/каталогов, присущее формату Hive, замедляет процесс планирования выполнения запросов и, соответственно, тормозит их реализацию. Таблица должна оперировать метаданными, что позволяет не только ускорить процесс планирования запросов, но и сократить время, отведенное на реализацию этих планов.
- Простота в использовании
Пользователи не должны видеть «кухню» обработки таблиц, они не должны видеть ее структуру. Работа с таблицами должна быть интуитивно понятна, особенно это касается функций партиционирования и фильтрации по столбцам.
- Способность к видоизменению
Обновление схем таблиц Hive может негативно сказаться на безопасности транзакций, а обновление схемы партиционирования таблицы может повлечь за собой нудную перезапись всей таблицы целиком. Поэтому крайне важно иметь возможность безболезненно изменять схему таблиц, а также схему ее партиционирования.
- Масштабируемость
Все вышеперечисленные требования должны быть соблюдены при стремительном увеличении объемов данных, которыми оперирует Netflix (а это петабайты информации)
Учитывая все вышесказанное, команда разработчиков Netflix приступила к созданию формата Iceberg, который должен был сфокусироваться на определении таблицы как списка файлов, а не на отслеживании таблицы как списка каталогов и подкаталогов. Проект Apache Iceberg - это стандарт того, как необходимо записывать метаданные, определяющие особенности хранения данных в Data Lakehouse. Apache Iceberg оперирует сравнительно большим количеством вспомогательных библиотек, помогающих конечным пользователям освоить этот совершенно новый формат таблиц . Наряду с библиотеками проект поддерживает чтение и запись данных в Apache Spark и Apache Flink.
Apache Iceberg разработан таким образом, чтобы максимально раскрыть все преимущества существующих популярных решений в области организации хранения данных. Главная цель постоянного совершенствования данного продукта состоит в том, чтобы он стал неотъемлемой частью экосистемы, при этом конечным пользователям совершенно необязательно разбираться во всех тонкостях его функционирования. Пользователям достаточно знать только то, что они работают с более продвинутым форматом таблиц, используя как проверенные, так и продвинутые инструменты обработки данных. Отчасти стратегия становления Apache Iceberg как фундаментального решения уже в определенной мере реализована – работа с данным продуктом стала настолько простой, что конечным пользователям не нужно понимать основной формат Iceberg. Благодаря автоматизированной оптимизации таблиц и инструментам ввода данных даже таким техническим пользователям, как дата-инженерам , совершенно не обязательно разбираться с базовым форматом. Они могут работать с Data Lake так же, как они ранее работали с DWH, не постигая принципы устройства слоя хранения данных.
Архитектура Apache Iceberg
Apache Iceberg отслеживает процессы партиционирования таблиц, сортировку данных, изменения схем с течением времени и многое другое с помощью дерева метаданных, которое движок использует для планирования запросов.
На рисунке ниже показана структура дерева метаданных.
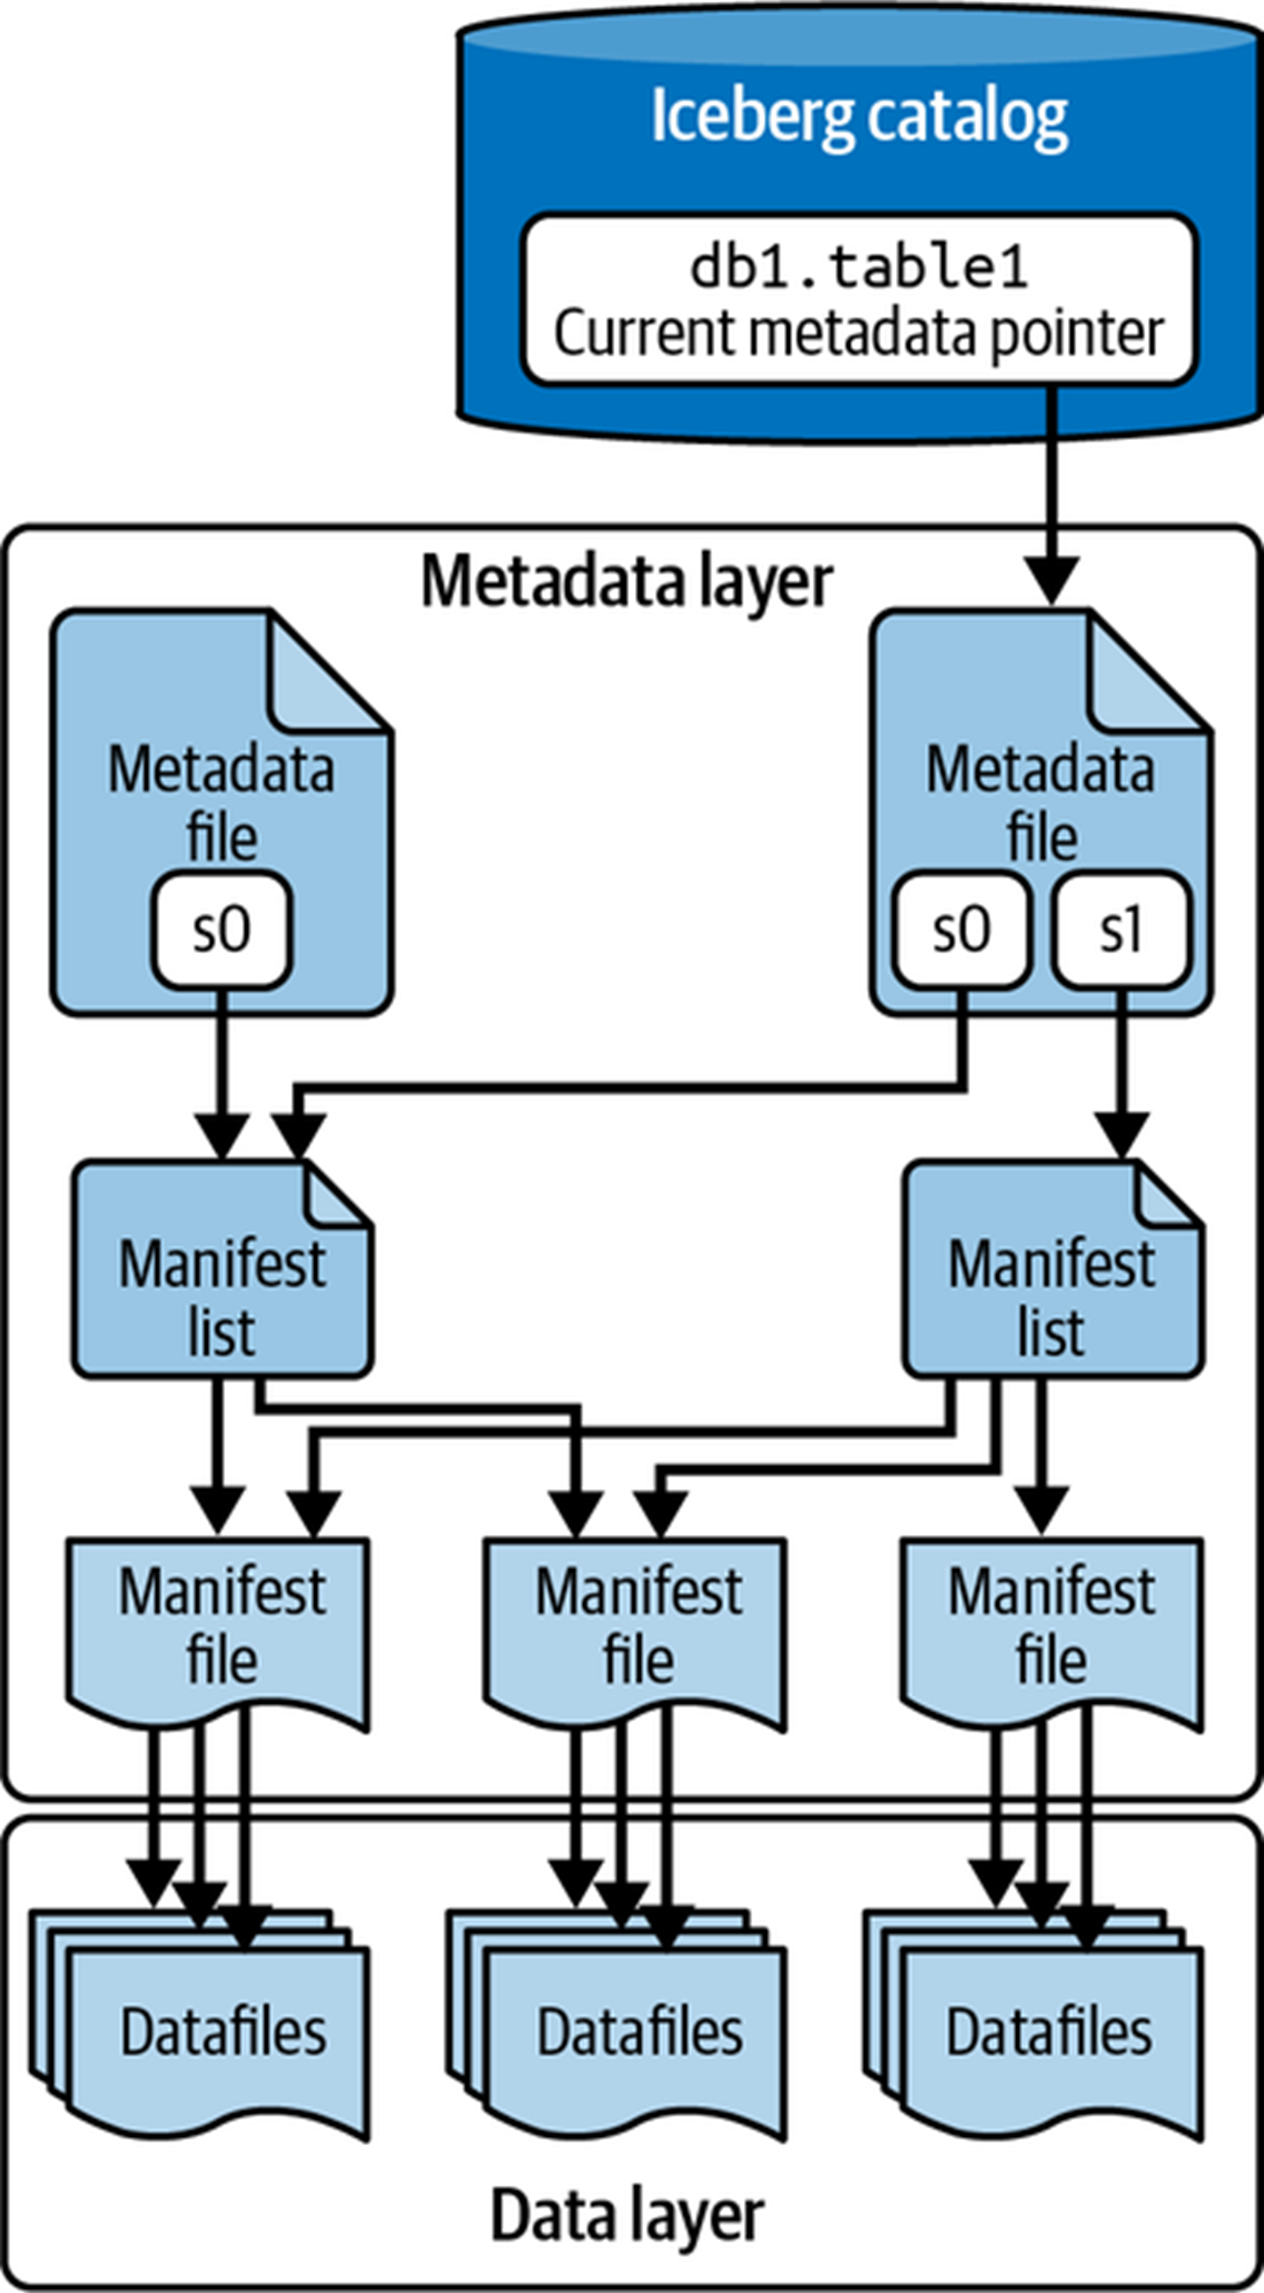
Дерево метаданных разбивает метаданные таблицы на 4 компонента:
- Файл манифеста - список файлов данных, содержащий местоположение/путь каждого файла данных и ключевые метаданные этих файлах, что позволяет создавать более эффективные планы выполнения.
- Список манифестов - файлы, определяющие один снимок таблицы в виде списка файлов манифестов, а также статистика по этим манифестам, позволяющая создавать более эффективные планы выполнения.
- Файл метаданных - файл, определяющую структуру таблицы, включая ее схему, схему партиционирования и список моментальных снимков.
- Каталог отслеживает местоположение таблицы (аналогично Hive Metastore), но вместо связки имя таблицы -> набор каталогов содержит связку имя таблицы -> местоположение последнего файла метаданных таблицы. В качестве каталога можно использовать несколько инструментов, включая Hive Metastore.
Ключевые характеристики Apache Iceberg
Уникальная архитектура Apache Iceberg позволяет постоянно расширять функционал, который не просто решает проблемы Hive, но и открывает совершенно новые возможности для использования Data Lakehouse. В этом разделе мы представим обзор ключевых возможностей Apache Iceberg.
- ACID транзакции
Apache Iceberg использует оптимистичный параллелизм для обеспечения ACID-гарантий, даже если транзакции обрабатываются несколькими пользователями (чтение и запись). Оптимистичный параллелизм предполагает, что транзакции не будут конфликтовать между собой, и проверяет их только при необходимости, стремясь минимизировать риски блокировки и повысить производительность в целом. Таким образом, Вы можете запускать в своем Data Lakehouse транзакции, которые либо фиксируются, либо отменяются, промежуточный результат не допускается. Пессимистичная модель параллелизма, которая использует блокировки для предотвращения конфликтов между транзакциями, предполагая, что конфликты могут возникнуть, на момент написания этой статьи была недоступна. Возможно, в самом ближайшем будущем эта функция будет добавлена.
Параллелизм обеспечивается каталогом, поскольку он, как правило, является механизмом, гарантирующим соблюдение требований ACID. Именно эта особенность позволяет транзакциям в таблицах Iceberg быть атомарными. Если бы этого не было, две разные системы могли бы конфликтовать между собой в процессе обновления, что привело бы к неминуемой потере данных.
- Изменение механизмов партиционирования
До появления Apache Iceberg самой настоящей головной болью при работе с Data Lake была необходимость изменения физической оптимизации таблицы. Зачастую, как только возникала необходимость в изменении разметки, единственно верным решением являлось переписать всю таблицу (а это достаточно дорого). Альтернатива заключалась в том, чтобы продолжать жить с существующей схемой разметки, принеся в жертву все планы по повышению производительности.
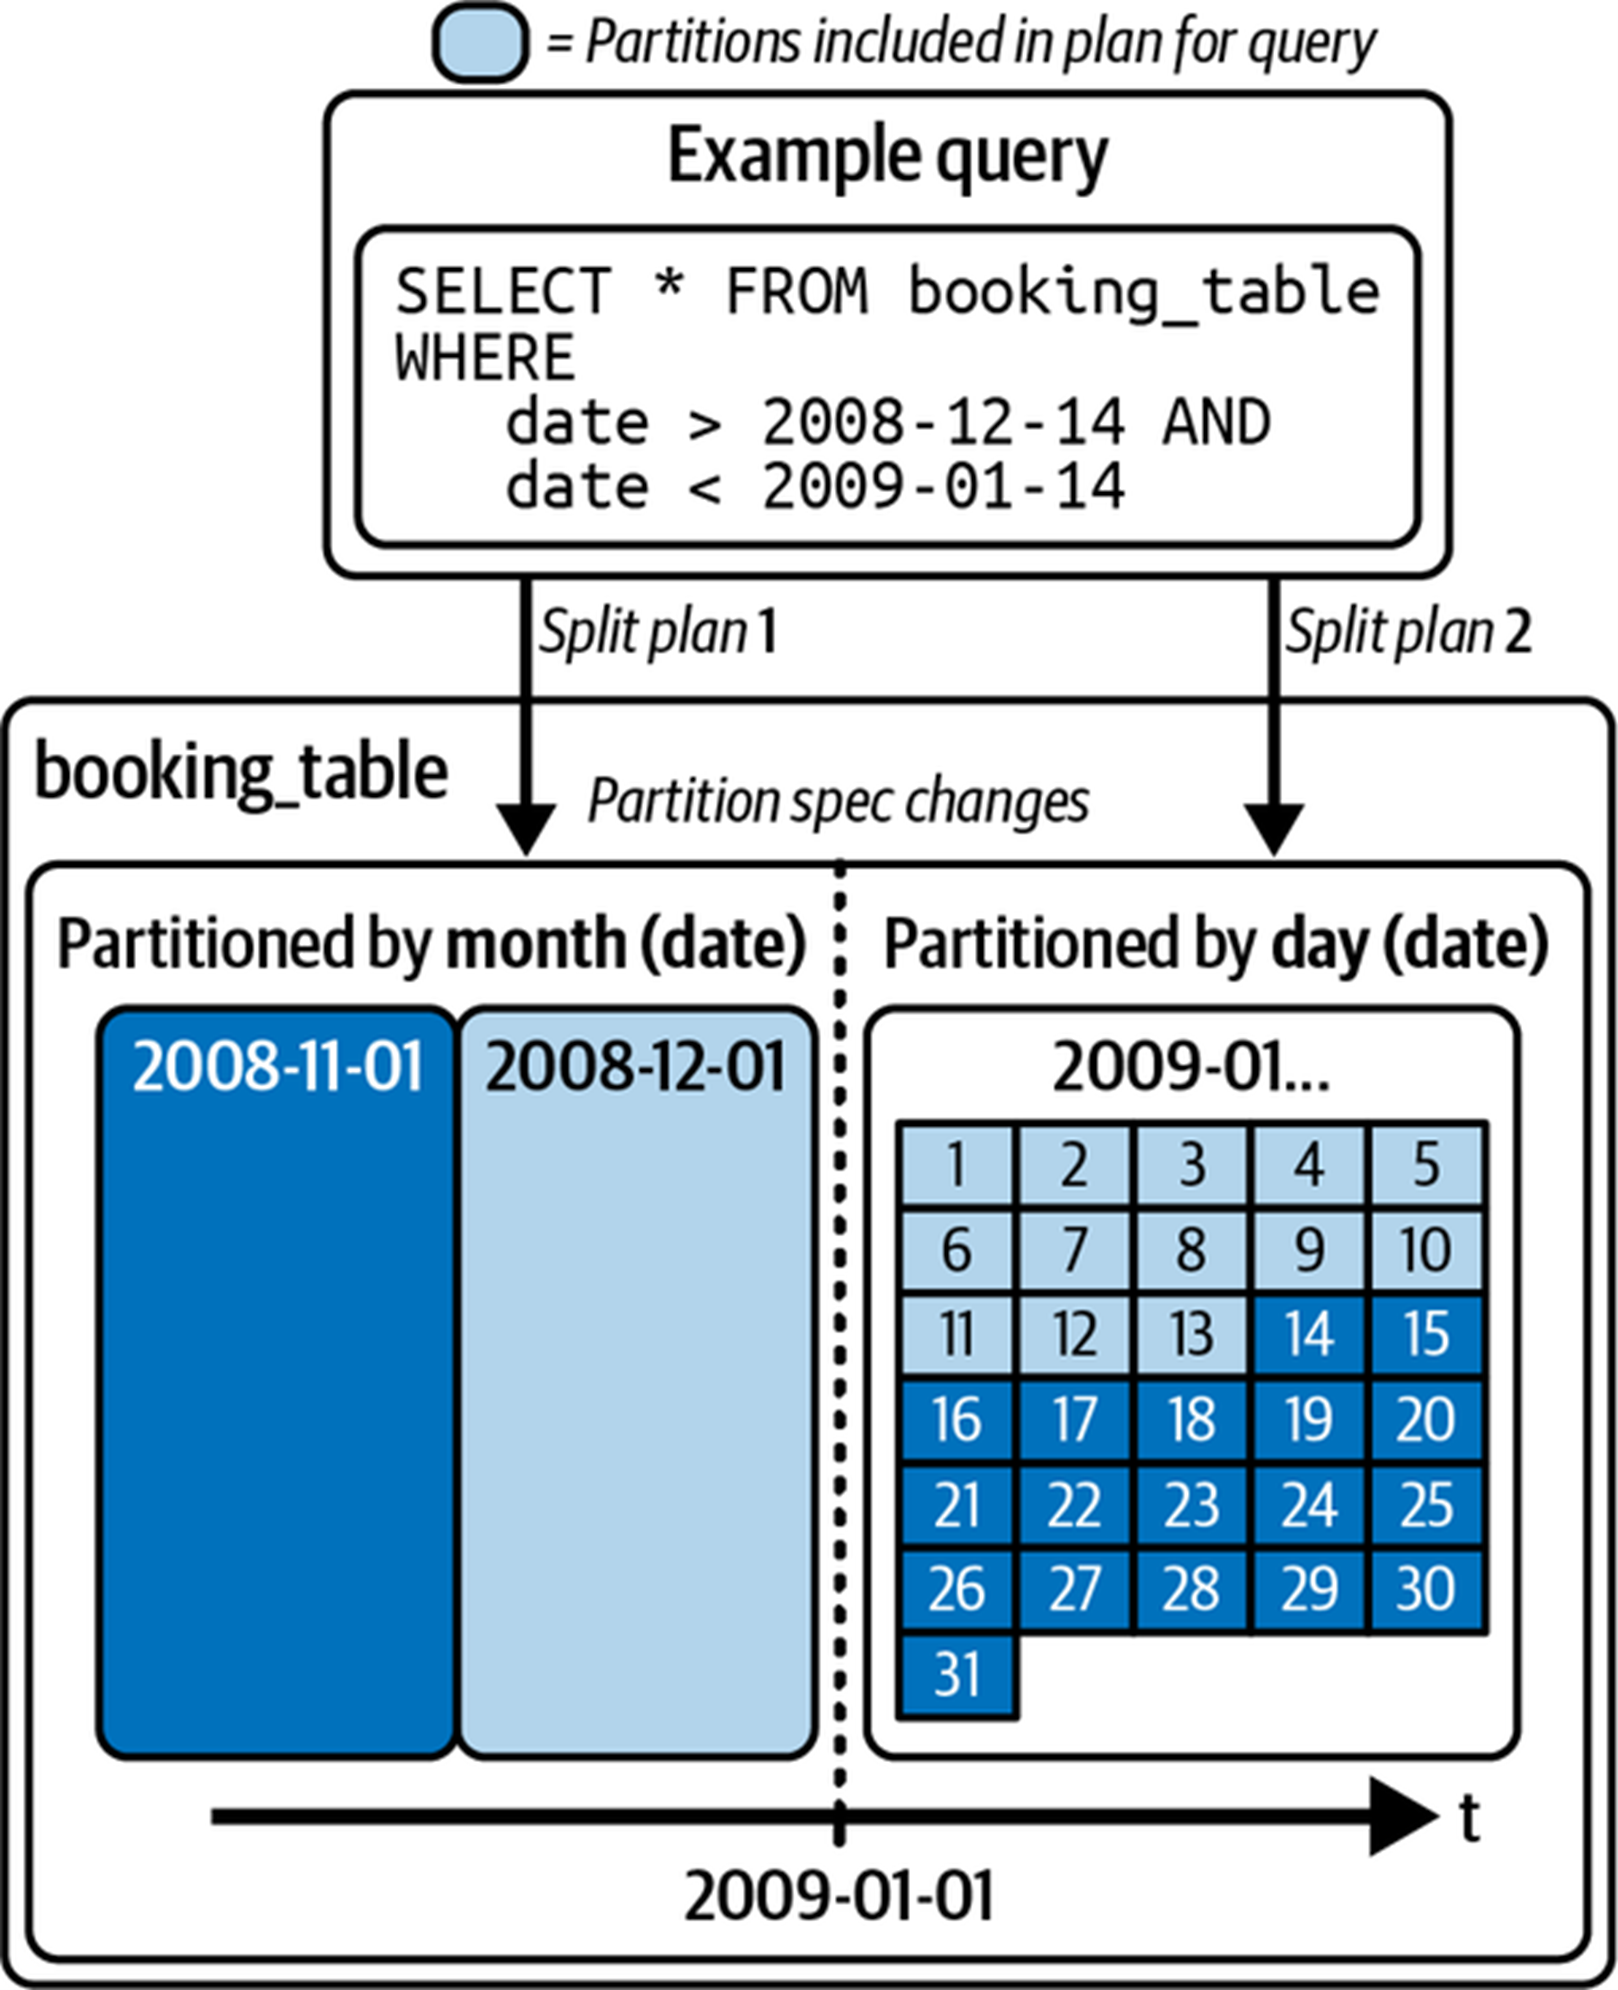
С помощью Apache Iceberg Вы можете в любой момент изменить партиционирование таблицы без необходимости переписывать таблицу и все ее данные. Поскольку партиционирование имеет отношение к метаданным, операции, необходимые для внесения изменений в структуру таблицы, выполняются быстро и поэтому стоят недорого.
На рисунке 8 показана таблица, которая изначально была разбита по месяцам, а затем - по дням. Ранее записанные данные остаются в разделах по месяцам, а новые данные записываются в разделы по дням, при запросе движок составляет план для каждого разбиения на основе примененной к нему схемы партиционирования.
- Скрытое партиционирование
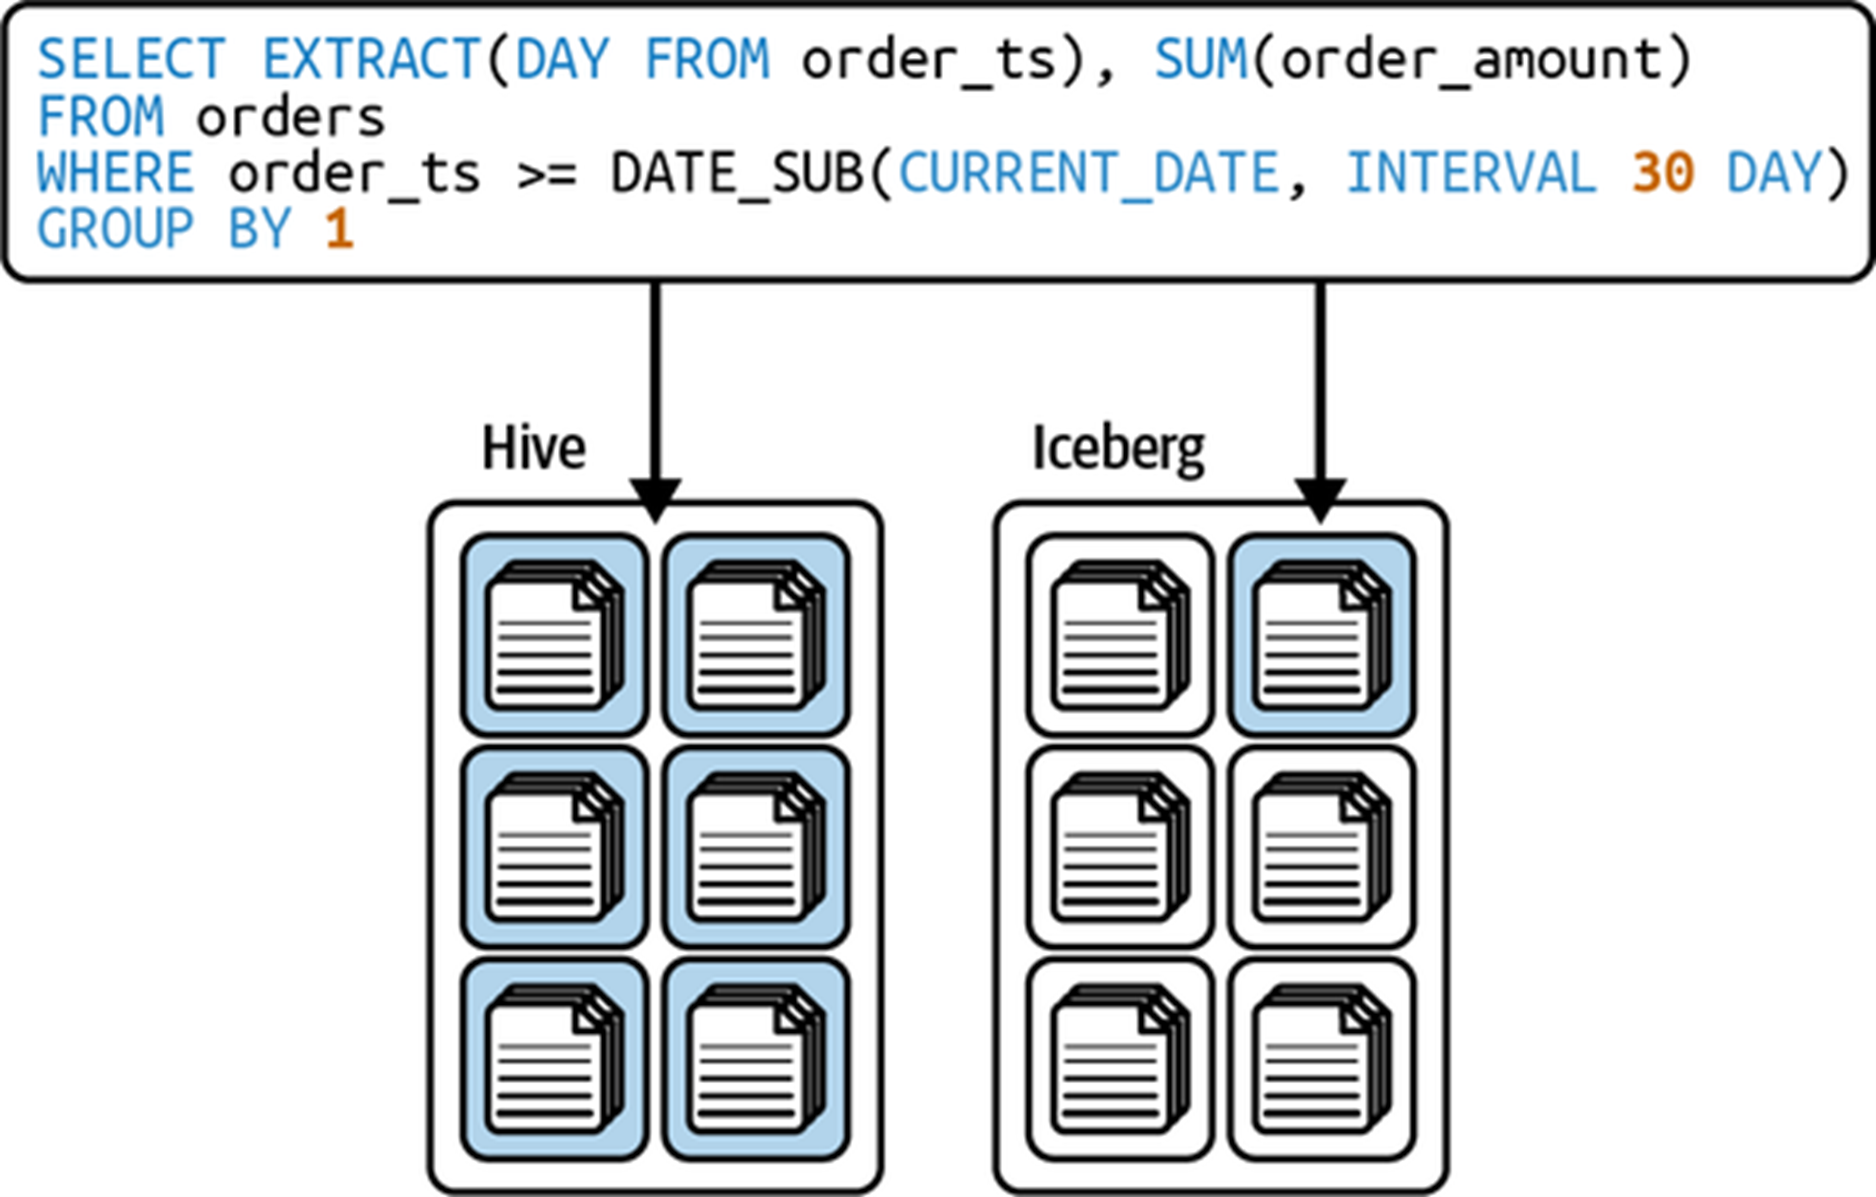
Иногда пользователи не знают, как физически разделена таблица, и, честно говоря, это и не должно их волновать. Зачастую таблица разделена по какому-то полю временной метки, и пользователь может сделать запрос по этому полю (например, получить среднюю выручку за последние 90 дней). Для пользователя наиболее интуитивно понятным способом сделать это является включение фильтра event_timestamp >= DATE_SUB(CURRENT_DATE, INTERVAL 90 DAY). Однако это неизбежно приведет к полному сканированию таблицы, поскольку таблица фактически разделена на отдельные поля под названием event_year, event_month и event_day. Это происходит потому, что при разбиении по временной метке получаются крошечные разделы, поскольку значения имеют секундную, миллисекундную или более низкую гранулярность.
В Iceberg партиционирование состоит из двух частей: столбец, на котором должно быть основано физическое разделение, и необязательное преобразование этого значения, включая такие функции, как bucket, truncate, year, month, day и hour. Возможность применения преобразований устраняет необходимость создания новых столбцов исключительно для разделения. В результате запросы, использующие партиционирование, становятся более интуитивно понятными, поскольку пользователям не нужно добавлять в свои запросы дополнительные предикаты фильтрации по дополнительным столбцам разделения.
На рисунке 9 отражена ситуация, когда в таблице используется дневное разбиение. Запрос в Hive, показанный на данном рисунке, привел бы к полному сканированию таблицы, поскольку для партиционирования, вероятно, был бы создан еще один столбец «день». В Iceberg метаданные будут отслеживать разделение как «преобразованное значение CURRENT_DATE» и, следовательно, будут использовать партиционирование при фильтрации по CURRENT_DATE.
- Операции с таблицами на уровне строк
Вы можете оптимизировать шаблоны обновления таблицы на уровне строк так, чтобы они принимали одну из двух форм: копирование при записи (COW) или слияние при чтении (MOR). При использовании COW для изменения любой строки в данном файле данных переписывается весь файл (с изменением уровня строки в новом файле), даже если в нем обновляется только одна запись. При использовании MOR для любого обновления на уровне строк записывается только новый файл, содержащий изменения в затронутой строке, которые проверяются при чтении. Это позволяет ускорить выполнение тяжелых операций обновления и удаления.
- Отслеживание изменений с течением времени
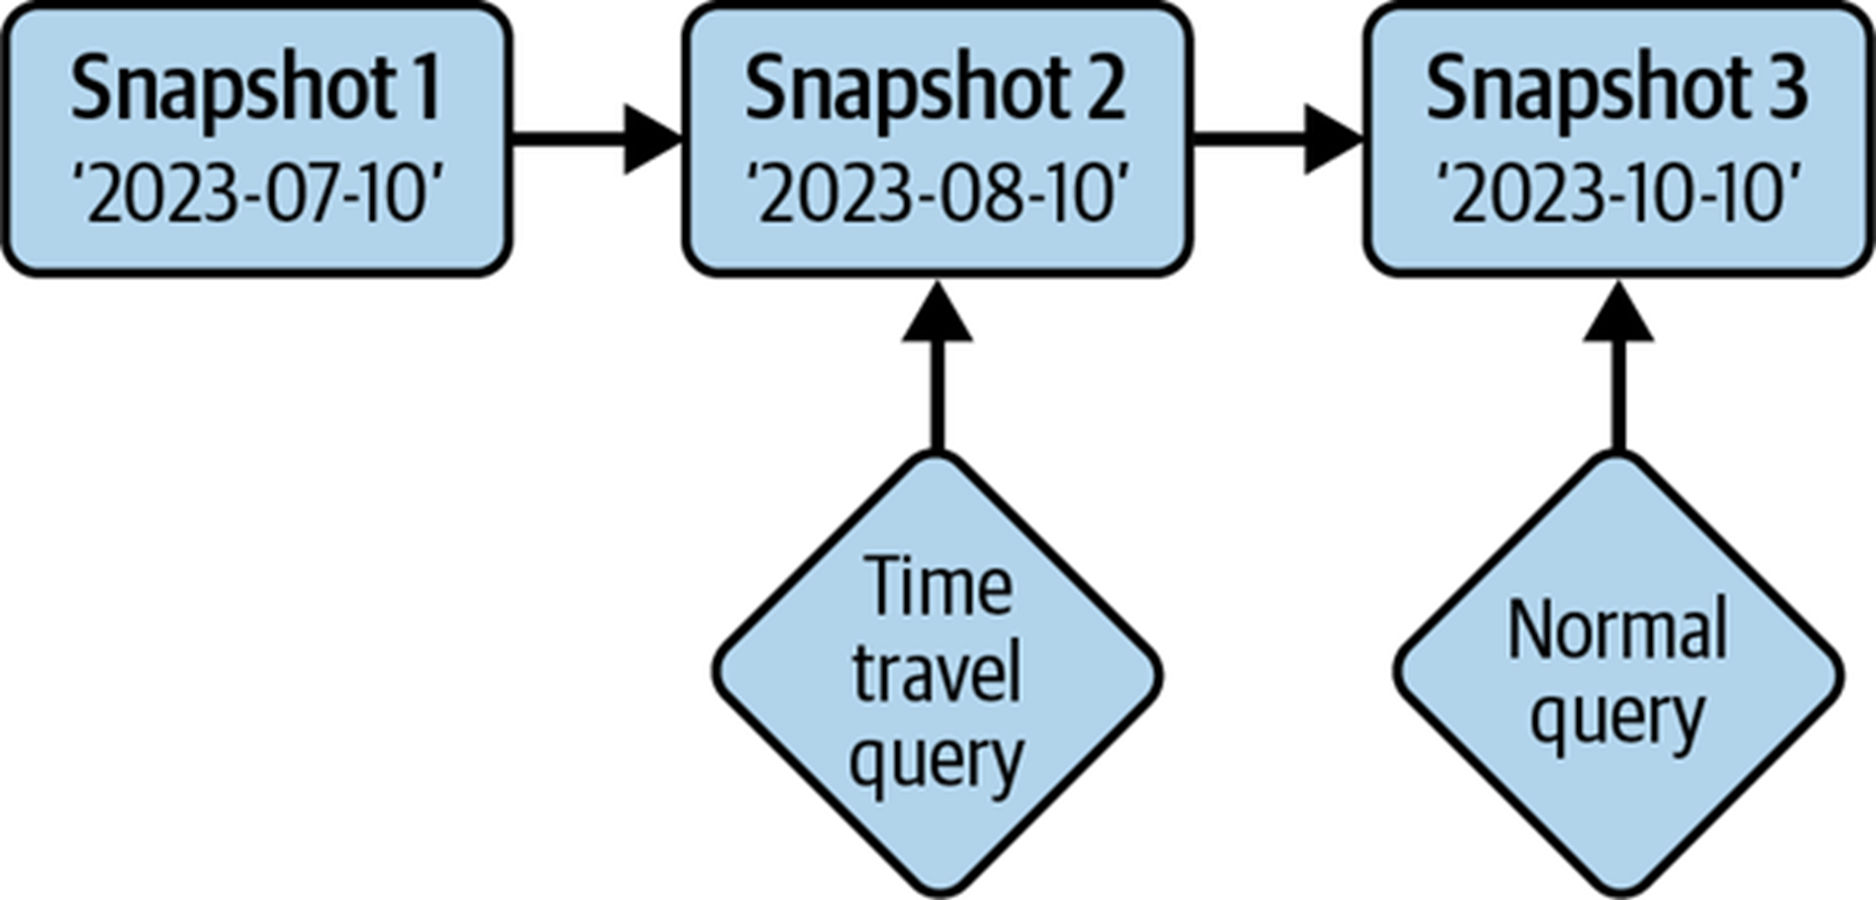
Apache Iceberg оперирует неизменяемыми моментальными снимками, поэтому информация об историческом состоянии таблицы является доступной, что позволяет выполнять запросы о состоянии таблицы в определенный момент времени в прошлом. Это может пригодится в таких случаях, как составление отчетности на конец квартала без необходимости дублирования данных таблицы в отдельное место или воспроизведения результатов ML-модели на определенный момент времени.
- Откат версии
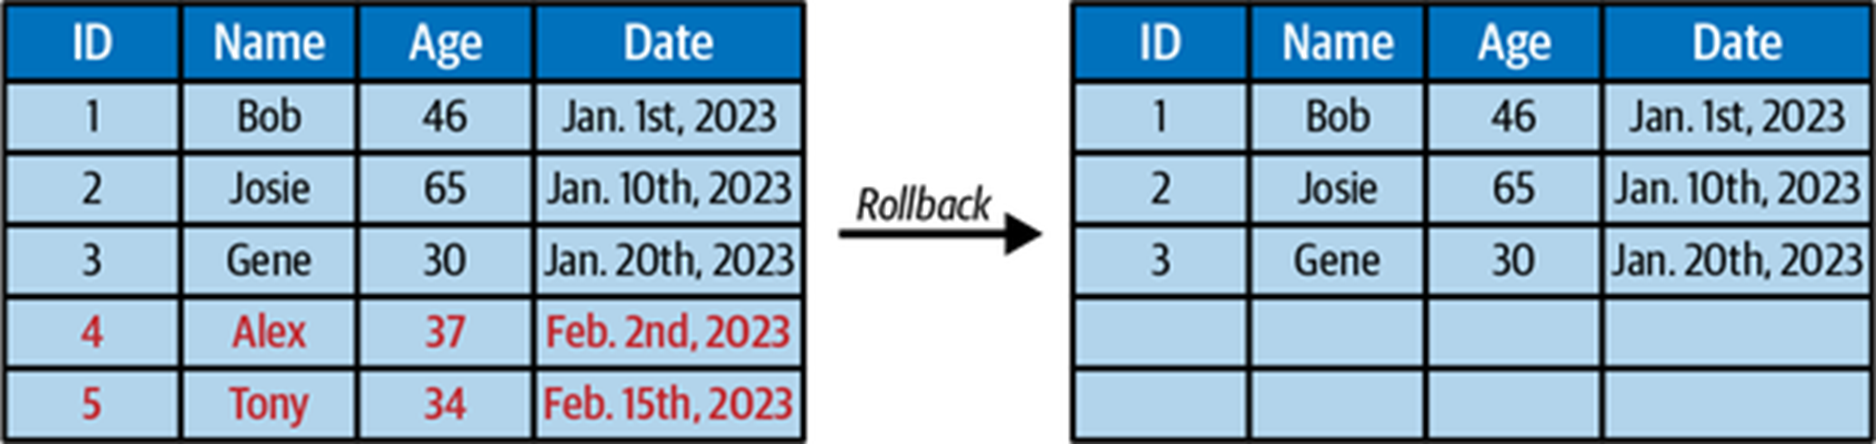
Изоляция моментальных снимков Iceberg не просто позволяет запрашивать данные в том виде, в котором они есть, но и возвращает текущее состояние таблицы к любому из предыдущих снимков. Поэтому исправить ошибки так же просто, как и откатиться назад.
- Изменение схемы
Таблицы меняются, будь то добавление/удаление столбцов, переименование столбцов или изменение типа данных столбца. Независимо от того, как изменяется Ваша таблица, Apache Iceberg предоставляет Вам проверенные и надежные функции изменения схемы - например, обновление столбца int в столбец long по мере увеличения значений в столбце.
Заключение
Прочитав данную статью, Вы узнали о том, что Apache Iceberg - это формат таблиц, разработанный для Data Lakehouse. Его основной задачей является нивелирование недостатков формата таблиц Hive. Iceberg способен обеспечить транзакции Hive, гарантии ACID, развитие схем, разделов и т.д. Ему удалось добиться такого результата благодаря созданию спецификаций и вспомогательных библиотек, которые позволяют существующим инструментам для работы с данными обеспечивать поддержку открытого формата таблиц.


