

Оптимизация AWS Glue CI/CD
Подробный блюпринт
В условиях постоянно развивающегося ландшафта управления данными плавное преобразование исходных данных в полезные инсайты имеет решающее значение для компаний по всему миру. Совсем недавно появился AWS Glue - сервис в AWS, предназначенный для оптимизации операций извлечения, преобразования и загрузки данных (ETL).
Glue значительно упрощает сложные задачи ETL, автоматизируя большую часть трудоемкой работы и предоставляя своим пользователям интуитивно понятный интерфейс.
Однако, как и в случае с большинством облачных сервисов, тестирование, развертывание и оркестровка ETL-заданий в Glue сопряжены с рядом сложностей, включая, помимо всего прочего, необходимость версионирования кода, управление зависимостями, настройку инфраструктуры и контроль доступа. Для решения всех этих задач необходима продуманная стратегия CI/CD, адаптированная специально для AWS Glue.
В этой статье мы как раз и поговорим о такой стратегии. В частности, мы рассмотрим комплексный блюпринт, разработанный для оптимизации и автоматизации рабочих процессов AWS Glue CI/CD, доступный в репозитории GitHub.
Обзор репозитория GitHub
Репозиторий GitHub является результатом коллективной работы специалистов, занятых в сфере данных, который, помимо всего прочего, содержит подробные примеры ключевых концепций. Мы используем его в качестве отправной точки для реализации Data Lake на базе Glue, что ускоряет процесс обучения дата -инженеров.
aws-glue-ci-cd-blueprint
├──.github/
   └──workflows/ (CI/CD configurations)
├──infrastructure/
   └──environments/ (deployment environment configurations)
      └──dev/
      └──prod/
      └──qa/
      └──staging/
   └──modules/ (reusable infrastructure components)
      └──athena/
      └──core/
      └──glue/
├──src/ (ETL code written in Python)
├──tests/ (unit tests for the Python code)
├──...
Ключевые компоненты и фреймворки:
- Непрерывная интеграция: GitHub Actions
- Инфраструктура как код: Terraform
- Контроль качества кода (Python): Unittest + Pytest, Black + Flake8
Стоит подчеркнуть, что понимание концепций важнее, чем владение какими –либо инструментами, облегчающими работу с данными. Например, код GitHub Actions можно легко перевести в GitLab CI. То же самое относится и к Terraform и AWS Cloud Formation, а также к языку программирования и инструментам QA.
Начало работы над блюпринтом
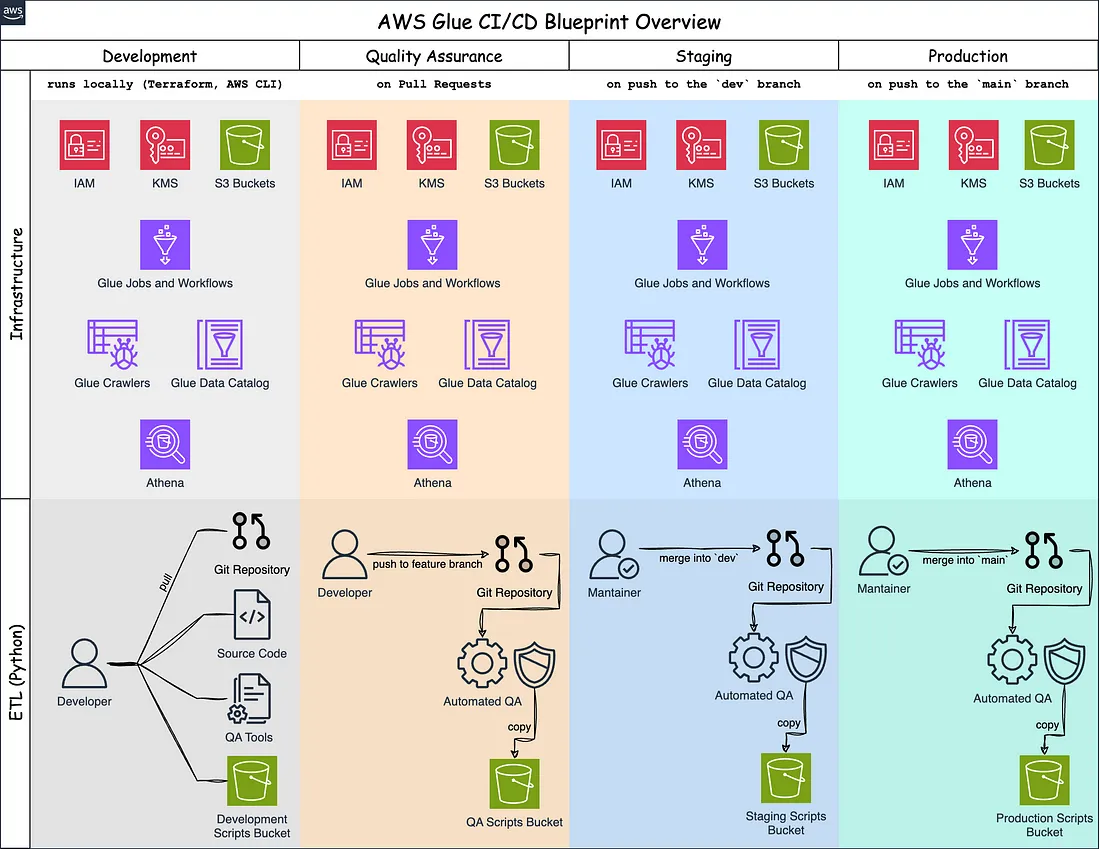
Прошу Вас обратить внимание на изображение, представленное ниже. На нем изображены две области: одну для инфраструктуры и другую для Python-кода. Мы решили рассмотреть их отдельно, потому что, как показывает опыт, такими частями кода занимаются разные люди или, по крайней мере, в разные моменты жизненного цикла разработки конвейера данных. Как правило, инфраструктура должна быть создана до развертывания любого задания ETL.
Автоматизация
Современные команды по работе с данными используют различные среды для разработки, проверки и внедрения конвейеров данных - среды, работающие в облаке и опирающиеся на множество подключенных ресурсов. Реплицировать конфигурации ресурсов между этими средами без автоматизации практически невозможно. Тем не менее, в данной статье представлены рекомендации по автоматизации инфраструктуры и проверки качества кода.
Со стороны IaC Terraform отвечает за настройку всех ресурсов AWS, связанных с конвейерами данных - например, ролей IAM с минимальными привилегиями, заданий Glue, рабочих процессов и политик IAM для Athena.
Что касается ETL-кода, юнит-тесты, форматирование и lint checks выполняются каждый раз, когда новые коммиты размещаются в Pull Requests или сливаются в dev и main для того, чтобы предотвратить изменения, которые могут негативным образом повлиять на конвейеры обработки данных. Если все идет хорошо, код будет развернут в правильном месте.
Шаги, выполняемые на GitHub, настраиваются с помощью GitHub Actions. За более подробной информацией обратитесь сюда: aws-glue-ci-cd-blueprint/.github/workflows. Файлы, начинающиеся с on-iac-, относятся к CI/CD IaC, остальные, начинающиеся с on-, относятся к CI/CD кода Python.
Тем не менее, разработчики могут выполнять команды Terraform, AWS CLI, а также проверки качества локально, особенно при использовании среды разработки (описано в разделе "Стратегия развертывания").
Тестирование
К конфигурациям Terraform применяются три типа проверок, которые сразу же останавливают конвейеры развертывания инфраструктуры, если какая-либо из них не пройдена (смотрите on-iac-pr-against-dev.yaml ):
- Команда для проверки входного формата: terraform fmt -check
- Команда, проверяющая синтаксис и структуру файлов конфигурации Terraform на наличие ошибок: terraform validate
- Команда, создающая план выполнения для Terraform: terraform plan
К коду Python также применяются три типа проверок, которые останавливают конвейеры развертывания при любом сбое (on-pr-against-dev.yaml ):
- Фреймворк для тестирования кода на Python: pytest
- Команда, проверяющая синтаксис: black --check ./src ./tests
- Линтер: flake8 ./src ./tests
Стратегия развертывания
Блюпринт строится из четырех сред:
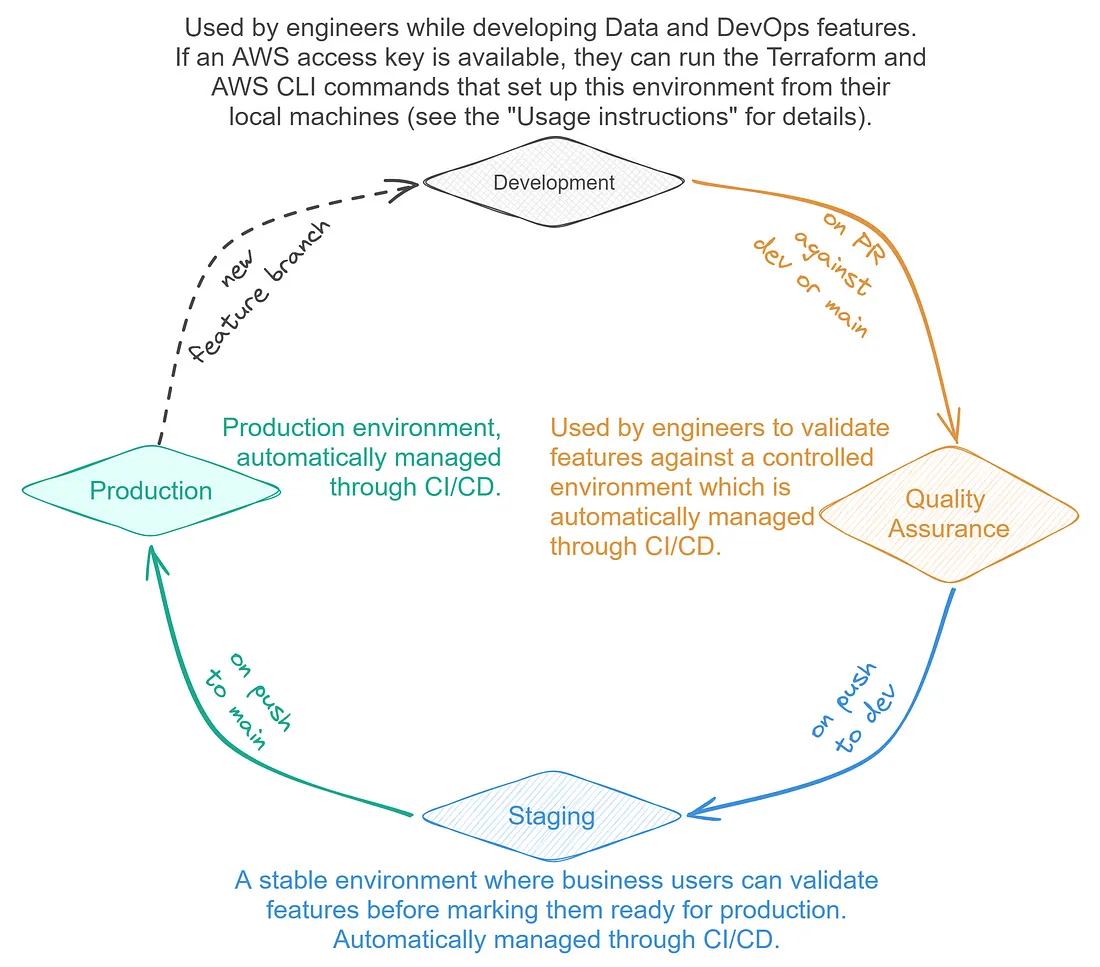
Не обязательно использовать сразу все 4 среды, если Вашей организации это не нужно. Однако мы настоятельно рекомендуем иметь как минимум Development и Production.
Инструкция по использованию
Дисклеймер: первое выполнение процесса, описанного в этом разделе, может занять пару часов. Это напрямую зависит от Вашего опыта работы с инструментами. Однако знакомство с планом того стоит. Преимущества более коротких циклов поставки и более высоких стандартов качества данных проявляются достаточно быстро.
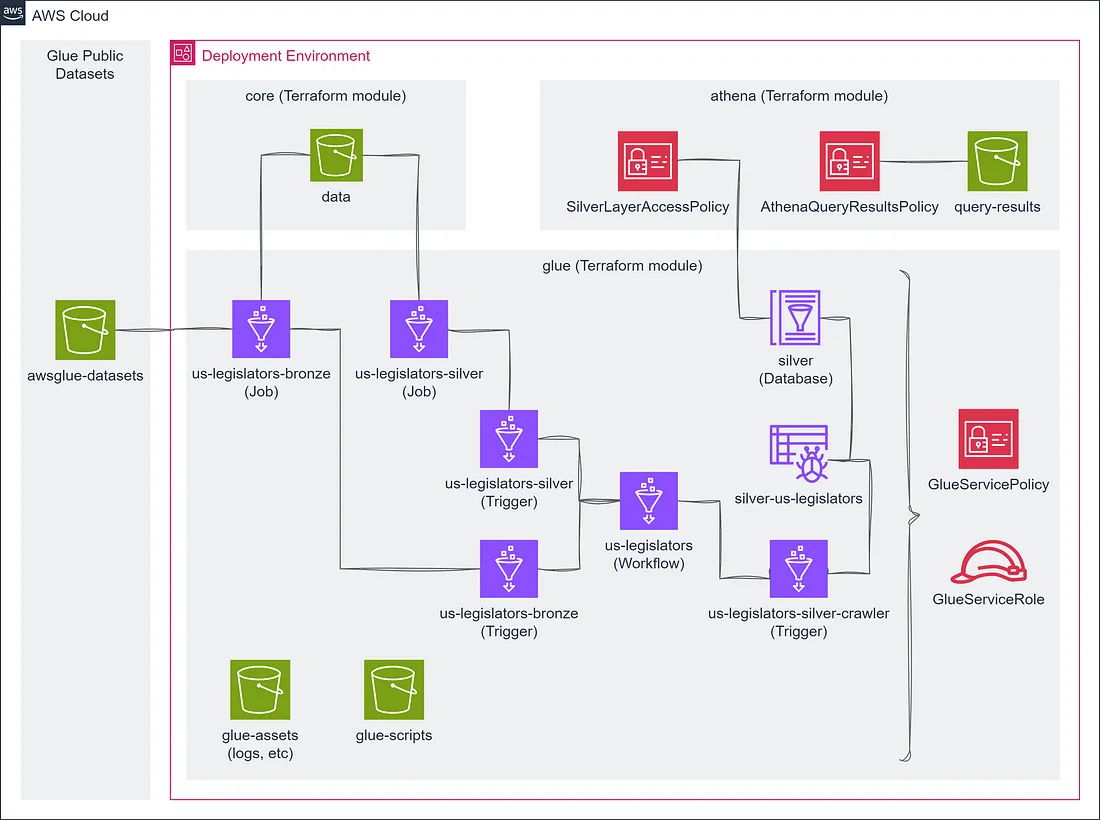
После краткого обзора настало время немного «поиграть» с планом. Мы создадим задания Glue, которые скопируют файл examples/us-legislators/all/persons.json из S3 awsglue-datasets. На следующем этапе Crawler проверит таблицу и создаст запись в каталоге данных. Рабочий процесс достаточно прост, но одно его достаточно для достижения поставленных целей. На изображении ниже показаны модули Terraform, ресурсы AWS, а также связь между ними.
Предполагается, что:
- У Вас уже есть копия репозитория aws-glue-ci-cd-blueprint с ветками main и dev;
- Terraform и AWS CLI установлены в Вашей локальной среде;
- У Вас есть права на управление Glue, IAM и S3; в противном случае Вам может понадобиться помощь для того, чтобы выполнить следующие шаги. Доступ к Athena является серьезным преимуществом.
Terraform добавляет суффикс dev|qa|staging|prod к каждому создаваемому ресурсу AWS, поэтому все четыре среды развертывания могут быть собраны в одной учетной записи. Это подходит для учебных целей, но не должно использоваться в реальных блюпринтах, в которых, для среды понадобится управляемая учетная запись.
Теперь Выполним несколько операций вручную... Для этого нам понадобится создание пользователь IAM со следующими правами доступа:
- AmazonS3FullAccess
- AWSKeyManagementServicePowerUser
- AWSGlueConsoleFullAccess
- IAMFullAccess
- Пользовательская политика для выполнения kms:EnableKeyRotation and kms:EnableKeyDeletion.
Этому пользователю не нужен доступ к консоли, поскольку он будет использовать только Terraform и AWS CLI в локальной среде разработки. Создайте ключ доступа для этого пользователя и сохраните его идентификатор и секрет.
Для хранения файлов состояния Terraform Вам также понадобится S3. Просмотрев файлы infrastructure/environments/*/provider.tf, Вы заметите, что glue-ci-cd-terraform сконфигурировано для блюпринта, поэтому необходимо обновить эти файлы.
Кроме того, необходимо задать разные имена для infrastructure/environments/*/variables.tf: data_bucket_name, glue_assets_bucket_name, glue_scripts_bucket_name и athena_query_results_bucket_name.
Настало время действовать! Выполните следующие команды в терминале:
export AWS_ACCESS_KEY_ID=<YOUR-ACCESS-KEY-ID>
export AWS_SECRET_ACCESS_KEY=<YOUR-SECRET-ACCESS-KEY>

export TF_VAR_aws_access_key=$AWS_ACCESS_KEY_ID
export TF_VAR_aws_secret_key=$AWS_SECRET_ACCESS_KEY

cd infrastructure/environments/dev/
terraform init
terraform plan
terraform apply
В среде разработки (суффикс dev) будет создано около двадцати ресурсов AWS, формирующих пример инфраструктуры ETL-конвейера, включая S3, политики и роли IAM, задания Glue, базы данных и рабочие процессы.
Для завершения процесса настройки скопируйте код ETL в бакет со скриптами:
cd ../../..
aws s3 sync --delete ./src s3://<YOUR-GLUE-SCRIPTS-BUCKET>
Затем перейдите на страницу Glue Workflows в AWS Console и выберите glue-ci-cd-us-legislators-dev. Нажмите Run workflow и подождите около 10 минут, пока процесс не завершится.

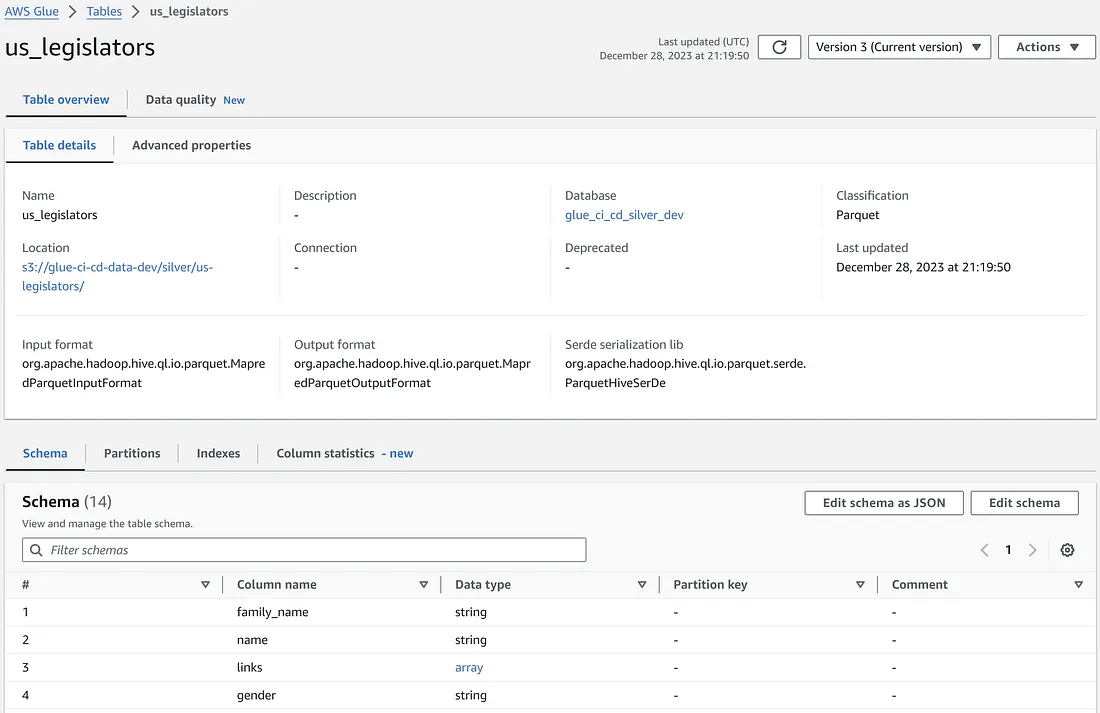
Просмотрите бакет данных и найдите папку bronze, в которой хранятся необработанные данные в формате JSON. Также там есть серебряная папка с данными в формате Parquet - преобразование из JSON в Parquet является одним из этапов конвейера примера. В рабочем процессе Glue Workflow также есть Crawler, который проверяет «серебряную» таблицу и создает соответствующую запись в каталоге данных.
Последний этап - настройка репозитория GitHub для CI/CD. Перейдите на страницу настроек репозитория и выберите "Environments". Создайте три: quality-assurance, staging и production. Для каждой из них задайте секрет AWS_ACCOUNT_ID и переменные AWS_REGION и GLUE_SCRIPTS_S3_BUCKET. Обратите внимание на то, что Вам не нужно указывать ключ доступа или секрет, потому что GitHub Action runners будет использовать определенную IAM-роль.
Еще раз просмотрите все файлы CI/CD YAML и найдите Configure AWS credentials для того, чтобы подтвердить, что для запуска GitHub Action будет использоваться GlueCICDGitHubActionsServiceRole. Эта IAM-роль пока не создана в Вашем аккаунте AWS, поэтому для завершения настроек создайте эту роль и следуйте инструкциям из раздела Настройка OpenID Connect в Amazon Web Services. Предоставьте ему те же права, которые были предоставлены ранее созданному IAM-пользователю.
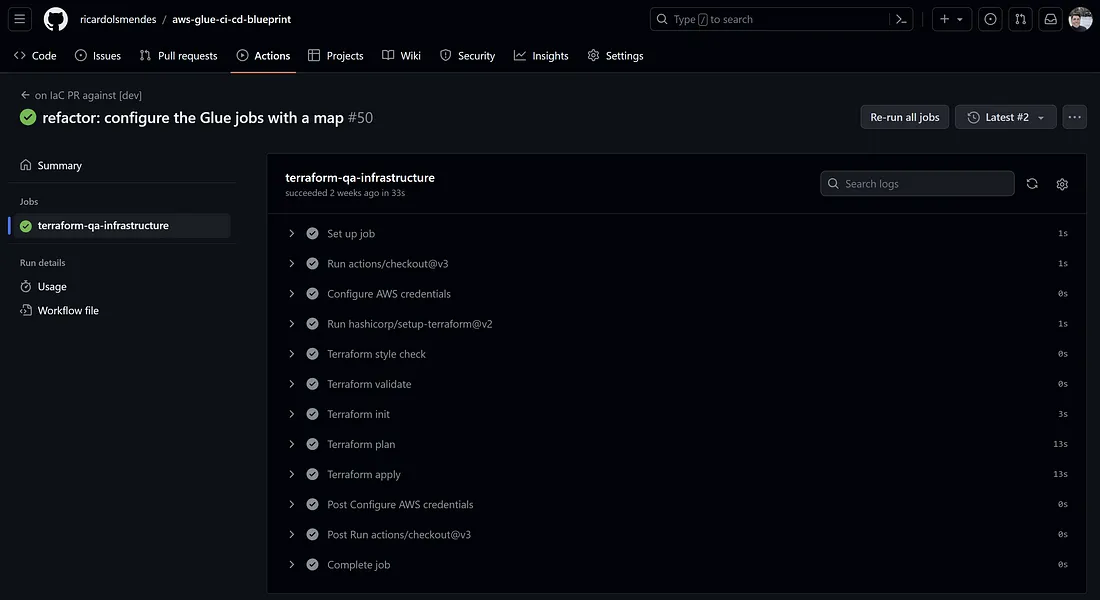
После этого Вы можете автоматизировать рабочие процессы и проверить качество в оставшихся трех средах в соответствии с правилами, описанными в разделе "Стратегия развертывания". Измените скрипты, добавьте новые шаги в конвейер, создайте Pull Requests в Вашем репозитории, объедините их в ветку dev и объедините dev в main. Для просмотра примеров CI/CD откройте репозиторий.
Сложности и пути их решения
Да, предоставленный блюпринт содержит основные полезные ресурсы для оптимизации конвейеров AWS Glue CI/CD, но, как известно, нет предела совершенству. Забегая вперед, скажу, что есть ряд сложностей, с которыми Вам придется столкнуться:
- Поддержка нескольких сред разработки и сред проверки качества. В настоящее время существует только одна среда разработки и одна среда проверки качества, что, скорее всего, вызовет проблемы с параллелизмом для больших команд. Лучшим решением является поддержка одной среды разработки для каждого инженера и одной среды QA для каждого Pull Request;
- Характеристики качества данных. DataOps - это не просто DevOps, применяемый к данным; в начальной версии блюпринт представляет собой просто DevOps для конвейеров данных Glue. Автоматическая настройка проверок качества данных поможет "продвинуть" их в категорию DataOps;
- Интеграционные тесты. Юнит-тесты хорошо работают с кодом, написанном на Python, но конвейеры ETL обычно опираются на SQL-запросы, которые не подходят для юнит-тестирования. Добавление поддержки интеграционных или системных тестов было бы отличным решением.
Заключение
В постоянно развивающейся сфере управления данными роль AWS Glue в оптимизации процессов ETL является ключевой, поскольку позволяет организациям максимально эффективно использовать потенциал своих данных. В ходе этого исследования мы выявили проблемы, присущие управлению CI/CD для заданий AWS Glue, и представили комплексный план, направленный на решение этих сложностей.
Принятие изменений часто требует времени и немалых усилий. Применение мер, описанных в инструкциях по использованию, на практике может занять некоторое время, особенно у тех, кто только еще начинает знакомиться с инструментами. Но поверьте, оно того стоит! Первые плоды своего труда Вы увидите в самые кратчайшие сроки.
Изучите репозиторий GitHub, ознакомьтесь с деталями реализации проекта и адаптируйте его под нужды своего проекта.


