

Будущее цифровой финансовой отчетности: стандарты, расширенная аналитика и interoperability
Цифровая финансовая отчетность перестала быть merely формальным бюрократическим требованием. Современная экосистема требует автоматизированной генерации XBRL-отчетов, интегрированной аналитики и тесной совместимости между системами внутри и за пределами организации. В этой главе анализируются ключевые компоненты будущего подхода: от архитектуры и стандартов до методик внедрения и операционной практики. Рассматриваются причины перехода к более открытым автомобильным каналам обмена данными, механизмы обеспечения качества данных и роль расширенной аналитики в повышении информативности и управляемости финансовой информации.
В этой главе формируется целостное видение, которое позволяет перейти от концепций к конкретной реализации в рамках реальных проектов автоматизации XBRL-отчётности. Приводятся принципы выбора таксономий, подходы к интеграции ERP и финансовых систем, а также требования к безопасности, аудиту и соответствию регуляторным нормам. Особое внимание уделяется interoperabilности между доменами бизнеса, регуляторами и рынком капитала, чтобы обеспечить единое, сопоставимое и машиночитаемое представление финансовой информации.
- Архитектура современной системы генерации XBRL: данные, модули, интеграционные паттерны.
- Стандарты и таксономии: выбор, адаптация и управление расширениями.
- Расширенная аналитика и открытые протоколы взаимодействия между системами.
- Управление качеством данных, метаданными и аудитом.
- Практические подходы к внедрению и операционной готовности.
Архитектура и поток данных для автоматической генерации XBRL
Стратегия построения цифровой отчетности строится вокруг четкой архитектурной раскладки: источники данных, трансформационные слои, механизмы сопоставления с таксономиями и финальный генератор XBRL-документов. При этом критически важна модульность: каждый компонент должен быть автономно развиваемым, но тесно интегрированным через стандартизированные интерфейсы.
Глобальные принципы архитектуры включают:
- источник данных: ERP, GL/General Ledger, субсегменты управленческого учёта, внешние данные регуляторов и контрагентов;
- слой интеграции: Extract-Transform-Load (ETL) или ELT-подходы, конвейеры -дривен, в которых события по финансовым операциям инициируют перерасчёт XBRL-экземпляров;
- сопоставление и семантика: трансформация данных в термины финансовой отчетности, выстраивание маппинга на таксономии XBRL;
- слой генерации: формирование XBRL-экземпляров и контекстов, применение указанных ролей и концепций, добавление метаданных и ссылок на источники;
- валидация и контроль качества: бизнес-правила, схемы XBRL и внешний валидатор таксономий;
- публикация и аудит: безопасный канал передачи, цифровая подпись, запись журналов и трассировка изменений;
- интерфейсы и обмен данными: API для интеграций, подписанные форматы XML/IXBRL, поддержка JSON-цепочек там, где применимо.
В рамках такой архитектуры следует определить три базовых паттерна взаимодействий:
- пакетная генерация с плановыми циклами выпуска отчетности, когда данные загружаются за период и проходят полный цикл валидации;
- событийная генерация, когда новые операции немедленно приводят к обновлению XBRL-инстансов;
- гибрид, сочетающий периодическую базу и события для критических подразделений или регуляторных требований.
Для пояснения можно привести условное разбиение процесса на пять основных слоев:
- источник данных и инкрементальные события;
- слой трансформации и маппинга;
- таксономический и семантический движок;
- генератор XBRL-инстансов и валидатор;
- канал публикации, аудит и управление версиями.
Важно помнить, что цель архитектуры - минимизировать ручной труд, повысить качество данных и обеспечить устойчивую эволюцию под влиянием изменений регуляторного поля. В качестве примера инструментальной поддержки в рамках открытых решений можно указать Arelle - открытый XBRL-процессор, который демонстрирует принципы валидации и генерации XBRL-документов. В российских реалиях часто встречается интеграция с платформами 1C: Enterprise, обеспечивающими связку между локальной бухгалтерией и XBRL-отчетностью через адаптированные модули.
Развертывание такой архитектуры требует детального проектирования интерфейсов между компонентами и устойчивых процедур управления изменениями. В частности, для модуля маппинга необходимо определить:
- унифицированное описание полей бухгалтерской и управленческой информации;
- правила трансформации из локального формата в концепты таксономии;
- механизмы обработки ошибок и пропусков;
- стратегию обновления маппинга при изменении таксономий.
С точки зрения технологий целесообразно выбирать открытые форматы и протоколы для обмена, чтобы обеспечить будущее расширение и совместимость. REST/GraphQL-API для обмена данными между слоями, XML/IXBRL для финальной генерации и подписываемая передача данных - стандартные решения, которые хорошо масштабируются и позволяют внедрять дополнительные сервисы аналитики или проверки.
Стандарты, таксономии и расширение Taxonomy
Главной движущей силой цифровой отчетности остаются стандарты и таксономии, которые задают смысловую сетку для финансовых данных. XBRL как платформа распространения бизнес-аналитики предусматривает не только репрезентацию финансовых величин, но и контексты, единицы измерения, ролей и линейку ссылок на источники. Во многих юрисдикциях наблюдается тенденция к демократизации и расширению таксономий через совместные регуляторные и отраслевые инициативы.
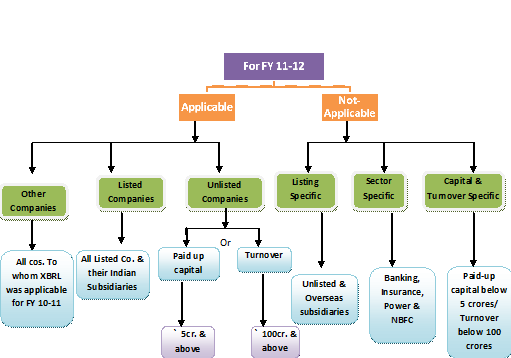
Ключевые моменты:
- выбор базовой таксономии: IFRS Taxonomy, локальные или отраслевые варианты; для международных компаний критичен сценарий мультизональности, когда требуется поддержка нескольких налогономий и их конвертация;
- расширения и collapsible taxonomies: организациям разрешается добавлять кастомные элементы, но их управление должно быть регламентировано политиками управления изменениями и согласовано с регулятором;
- iXBRL и цифровая подпись: современные требования к формату и целостности документов;
- управление версиями таксономий: поддержка миграций, архивы и74 уведомления об изменениях;
- инструментальные решения: в открытом контексте, например, Arelle поддерживает работу с разными taxonomies; в российском контексте допустимо упоминать интеграции с 1C: Enterprise для адаптации под локальные требования.
Выбор и управление таксономиями должны быть привязаны к регуляторной стратегии компании. Необходимо обеспечить синхронность между обновлениями таксономий и релевантными бизнес-процессами, чтобы исключить рассогласование между бизнес-данными и финансовым представлением. Важна процедура согласования изменений в таксономии и регуляторных требований: кто отвечает за прием апдейтов, как регистрируются изменения, как тестируются новые элементы в демо-окружении, прежде чем перейти в продуктивную среду.
Для практической адаптации важно иметь план по внедрению расширений таксономий. Расширения должны:
- иметь четкое описание целевой функции и зависимостей;
- быть под контролем версии и иметь тестовую канавку;
- проходить регуляторную экспертизу, если расширение влияет на представление финансовых категорий;
- быть документированы и доступны для аудита.
Инструменты для работы с таксономиями варьируются от коммерческих платформ до открытых решений. В контексте открытого сообщества выделяется Arelle, как платформа для анализа и валидирования XBRL-документов и Taxonomy. В российском контексте добавляется роль 1C: Enterprise как средство реализации конкретных бизнес-процессов и интеграции с локальной бухгалтерией, что позволяет адаптировать таксономии под требования российской финансовой отчетности и регуляторов.
Расширенная аналитика и interoperability
Будущее цифровой финансовой отчетности предполагает тесную интеграцию финансовых данных с аналитикой, поддержкой машинного обучения и возможностей открытого взаимодействия между системами. Расширенная аналитика позволяет превратить XBRL-данные в управляемые инсайты, выходящие за рамки статического snapshot. Interoperability обеспечивает бесшовный обмен данными между ERP, финансовыми системами, регуляторными порталами и рыночными участниками.
Ключевые направления:
- семантическая связность: использование контекстов, единиц измерения и ссылок на источники для сопоставления данных в разных системах;
- машинное обучение и правила: автоматическая кластеризация и тегирование элементов с учётом исторических данных, поддержка программной логики для автоматического распознавания аномалий и несоответствий;
- открытые протоколы обмена: RESTful API, BEP/JSON-XML-IXBRL конвергентно; использование событийной архитектуры через шину сообщений для обновлений;
- роль открытых стандартов: JSON-LD или RDF для описания метаданных, что облегчает интеграцию с новыми системами и платформами;
- встраиваемая аналитика: dashboards и управляемые отчёты, доступ к трактовкам через регуляторные требования и внутренние политики;
- примеры практик: внедрение вендор-нейтральной среды с поддержкой нескольких TAXONOMY и multi-source data integration.
Эти направления усиливают ценность отчётности: уменьшают задержки, повышают точность и прозрачность, а также позволяют регуляторам и рынку капитала быстрее и понятнее интерпретировать данные. В рамках конкретной реализации, можно отметить:
- обеспечение полноты данных за счёт обработки пропусков и автоматического заполнения только по согласованной логике;
- применение верификации данных с учётом бизнес-правил и регуляторных требований;
- отслеживание происхождения данных и полное документирование цепочки их преобразования.
Применение аналитических методов должно быть tightly integrated в конвейер генерации отчётности: от источников данных до финального XBRL-документа, с возможностью отката и аудита, когда требуется. В практических условиях это может потребовать внедрения средств Data Governance и Catalog-решений, которые позволяют понять, какие элементы данных соответствуют каким концепциям XBRL и как они изменяются во времени.
В части инструментов упоминание Arelle как открытой платформы для анализа таксономий и валидирования экземпляров служит иллюстрацией того, что открытые решения могут служить основой для корпоративной инфраструктуры. В контексте российской реальности упоминание 1C: Enterprise подчеркивает возможность реализации интеграций с локальными финансовыми системами и регуляторной отчетности без потери совместимости.
Управление данными, качеством и метаданными
Надежность цифровой отчетности начинается с качества данных и прозрачности их происхождения. В рамках будущего подхода к XBRL-генерации необходимо внедрять управляемые политики данных, обеспечить полноту и точность, а также сохранять полную трассируемость изменений. Важные элементы:
- источники данных и линейка трансформаций: документировать источники, применяемые преобразования и риски на каждом этапе;
- качество данных: набор стандартов качества (полнота, точность, согласованность), автоматические проверки и пороги допуска;
- метаданные: хранение контекста, источников, версий и залежалых зависимостей, чтобы обеспечить воспроизводимость и аудит;
- контроль версий и аудит: каждый обновление должен сопровождаться записью, кто инициировал изменение, какие правила применены, какие тесты пройдены;
- безопасность и доступ: разграничение ролей, шифрование канала передачи, аудит доступа к данным и документам;
- соответствие требованиям регулятора: регламенты по хранению, срокам обновления и форматам, которые регуляторы требуют для регуляторной отчетности.
Таким образом, управление данными становится неотъемлемой частью инфраструктуры, а качество данных - ключевым фактором доверия к автоматически сгенерированным XBRL-документам. В этом контексте интеграция с инструментами Data Governance и Catalog облегчает управление семантикой, версиями и изменениями в таксономиях, а также позволяет оперативно реагировать на регуляторные обновления.
Внедрение и операционная готовность
Реализация архитектурного решения по автоматической генерации XBRL требует перехода к новой операционной модели. Внедрение включает планирование, пилоты, масштабирование и устойчивое управление изменениями. Основные аспекты:
- стратегическое планирование: согласование бизнес-целей с регуляторными требованиями, выбор таксономий и определение политики расширений;
- управление изменениями: процессы утверждения изменений в маппинге, таксономиях и правилах генерации, регламент обновления;
- тестирование: создание тестовых наборов данных, валидационные сценарии, регрессионное тестирование и проверки на соответствие регуляторным требованиям;
- роль команды: формирование кросс-функциональной команды, отвечающей за данные, архитектуру, бизнес-правила и требования регулятора;
- интеграционные риски: совместимость с существующими системами, минимизация сбоев в бизнес-процессах, план восстановления;
- управление затратами и сроками: реалистичный график внедрения, инфраструктурные решения и окупаемость проекта;
- обучение и культурная адаптация: подготовка сотрудников к новым процессам, смена ролей и ответственности, формирование новой управленческой культуры, ориентированной на данные.
Успешное внедрение требует разумной скорости и гибкости: строить базовую архитектуру с возможностью расширения, выбирать устойчивые и совместимые технологии, а затем постепенно увеличивать долю автоматизации, сохраняя возможность ручного контроля там, где это необходимо. В дорожной карте проекта следует предусмотреть этапы миграции, параллельную работу старых и новых процессов, а также механизмы отката при необходимости.
Key takeaways
- XBRL-генерация должна строиться на модульной архитектуре с четким разделением источников данных, маппинга, taxonomies, генерации и валидации.
- Выбор таксономий и расширений требует регуляторной осмотрительности, управляемых процессов версионирования и документированной политики изменений.
- Расширенная аналитика и interoperability усиливают ценность отчетности, превращая статические данные в управляемые инсайты и обеспечивая совместимость между системами через открытые протоколы.
- Управление качеством данных и метаданными является фундаментом доверия к автоматизированной отчетности; каждое изменение должно сопровождаться аудируемостью и контролем версий.
- Внедрение требует стратегического планирования, четких процессов управления изменениями, тестирования и подготовки персонала к новой операционной модели.
- Открытые инструменты, такие как Arelle, могут служить опорной базой для валидации таксономий и формирования первых прототипов, в то время как локальные экосистемы, например 1C: Enterprise, помогают интегрировать решение в существующую инфраструктуру.
- Эффективная архитектура обеспечивает не только соответствие регуляторным требованиям, но и способность быстро адаптироваться к изменениям стандартизированных форматов и новым регуляторным требованиям.
FAQ
1. Что такое interoperabilität в контексте XBRL и почему это важно?
Interoperability (совместимость и обмен данными) означает, что данные и метаданные можно без потерь передавать между системами разных поставщиков и юрисдикций. В контексте XBRL это обеспечивает сопоставимость отчетности между регуляторами, инвесторами и контрагентами, снижает затраты на конвертацию и позволяет быстро адаптироваться к изменениемм таксономий и регуляторным требованиям.
2. Какие основные стандарты применяются для автоматической генерации XBRL?
Основные стандарты включают XBRL как базовый формат, iXBRL для онлайн-отчетности, IFRS Taxonomy и локальные налогономии. Управление расширениями таксономий требует процедур управления изменениями и верификации правил. Важно обеспечить соответствие форматов и цифровую подпись для гарантий целостности.
3. Как избежать рассогласования между локальными данными и международной таксономией?
Необходимо реализовать единый слой маппинга, поддерживающий мультизональность и локальные требования, а также механизм версионирования таксономий. Регулярные аудиты и регламентированные процедуры обновления помогают синхронизировать локальные данные с глобальными стандартами.
4. Какие роли играют данные качество и метаданные в автоматизации XBRL?
Качество данных обеспечивает точность и полноту финансовой информации, избегает пропусков и ошибок в конвертации. Метаданные позволяют трассировать источник данных, контексты, единицы измерения и версии трансформаций, что критично для аудита и регуляторной проверки.
5. Какие подходы к внедрению обеспечивают устойчивость проекта?
Рекомендуются поэтапные планы: пилоты на ограниченном наборе данных, затем масштабирование, параллельная работа старых и новых процессов, активное управление изменениями и обучение сотрудников. Важно заранее определить регуляторные требования и связанные с ними сроки.
6. Какие инструменты стоит рассмотреть для начала проекта?
С учетом баланса открытых и коммерческих решений можно начать с Arelle как основы для анализа и валидации таксономий, а для интеграции в локальную инфраструктуру - использовать российские решения на базе 1C: Enterprise. В дальнейшем можно рассмотреть дополнительные коммерческие платформы для управления Taxonomy и контекстами.
7. Как обеспечить безопасность и аудит в процессе автоматической генерации?
Необходимы разделение ролей, контроль доступа к данным, цифровая подпись документов и журналирование всех операций трансформации и генерации. Также следует реализовать политику хранения и процедуры аудита, проверяемые регуляторными требованиями.
8. Какие вызовы возникают при работе с расширениями таксономий?
Расширения должны управляться через регламентированную схему согласования, версионирования и тестирования. Важно обеспечить совместимость с основнымиTaxonomy и избежать конфликтов, которые могут затруднить валидацию и сравнение между юрисдикциями.
9. Какой дорожной картой руководствоваться при внедрении?
Начать с определения регуляторных требований и основных таксономий, затем построить базовую архитектуру и пилот на ограниченном наборе данных, после чего - масштабирование и добавление расширенных функций аналитики и интеграций.
10. Какие преимущества приносит автоматическая генерация XBRL для компании?
Ускорение цикла отчетности, повышение точности данных, прозрачность источников, возможность детального анализа и лучшая сопоставимость с регуляторными требованиями и рынком капитала. Эти эффекты ведут к снижению операционных рисков и повышению доверия стейкхолдеров.


