

Другие метрики точности: MAE, RMSE, sMAPE, MASE, Forecast Deviation
В этой главе рассматриваются альтернативные и диагностические метрики точности прогнозов спроса, которые дополняют широко известные MAPE и Bias. Мы освещаем, как их рассчитывать на уровне данных и пайплайна, как интерпретировать результаты в разных контекстах и какие архитектурные решения необходимы для внедрения этих метрик в производственные процессы.
Метрики, представленные здесь, служат двумя целями: во-первых, расширяют спектр характеристик прогноза (масштабируемость, устойчивость к выбросам, симметричность ошибок, влияние на сравнения между рядами); во-вторых, служат инструментами диагностики и контроля качества, позволяя выявлять проблемы кроющиеся за средними значениями ошибок и направление предсказаний. В контексте цифровой трансформации спроса эти метрики становятся частью архитектуры наблюдаемости прогностических систем: они обеспечивают качество принятых управленческих решений, помогают в калибровке запасов и в управлении рисками, связанными с перегрузками или дефицитом.
-
Внимание к масштабу. MAE и RMSE зависят от единиц измерения спроса и требуют аккуратного использования при сравнении между категориями или временными рядами различного масштаба.
-
Информативность о тенденции ошибок. Forecast Deviation и направление ошибок позволяют не только понять величину отклонений, но и определить, в каком направлении система склонна ошибаться: недокат, перерасчет или систематический подгон под тренд.
-
Чувствительность к структуре ряда. sMAPE учитывает симметричность ошибок, но обладает caveats при близких к нулю значениям и нулевых спросах, что требует внимательной обработкиDen.
-
Масштабируемость и сопоставимость. MASE позволяет сравнивать модели и наборы данных с разной структурой и сезонностью, если правильно выбрать параметр сезонности m и обеспечить достаточную длину обучающей выборки.
-
В архитектурном плане целесообразно организовать централизованный сервис метрик. Он объединяет расчеты MAE, RMSE, sMAPE, MASE и Forecast Deviation, поддерживает версионирование данных, хранит историю метрик, обеспечивает доступ к дашбордам и автоматизированные отчеты для команд по прогнозированию, заказчикам и управлению запасами. Такая интеграция упрощает аудит и регулятивную отчетность, а также ускоряет итеративное улучшение моделей.
MAE и RMSE: базовые принципы, сравнение в контексте спроса
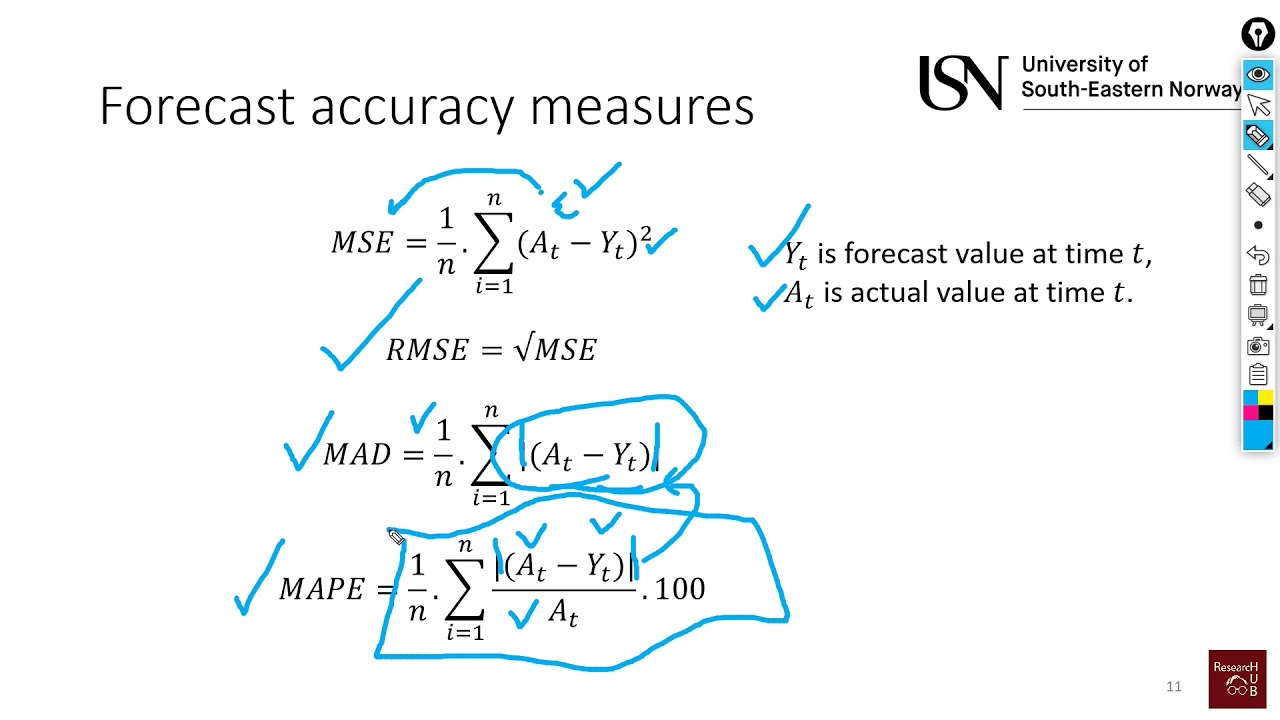
MAE и RMSE являются базовыми, широко применяемыми метриками ошибок прогноза. MAE (mean absolute error) рассчитывается как среднее значение абсолютной разности между фактическими значениями и прогнозами. RMSE (root mean squared error) - корень из среднего квадрата ошибок. Разница между ними не только в математической форме, но и в характере штрафа за крупные ошибки.
- MAE даёт линейный штраф за каждую сильную ошибку: каждое отклонение влияет пропорционально своей величине. Это делает MAE более устойчивым к очень крупным ошибкам по сравнению с RMSE.
- RMSE усиливает влияние крупных ошибок за счёт квадратичного члена: большие расхождения становятся заметнее и оказывают больший эффект на итоговую величину ошибки.
Эти свойства определяют практическое использование в задачах прогноза спроса:
-
Когда критична стабильность отклонений на уровне единиц измерения услуги или товара и когда выбросы не должны формировать рыночную стратегию, MAE может быть предпочтительнее.
-
В случаях, когда важно карать крупные промахи сильнее (например, для планирования запасов с критической чувствительностью к перепроизводству или упущению), RMSE может быть предпочтительнее.
-
В контексте сравнения моделей на одном и том же наборе данных RMSE и MAE дают согласные сигналы, если распределение ошибок не имеет тяжелых хвостов. Различие между этими метриками станет заметным, если в данных присутствуют крупные выбросы или редкие сюрпризные пики спроса.
Расчет и интерпретация требуют аккуратности в подготовке данных: выверка совпадения временной разметки у фактических значений и прогнозов, обработка пропусков, корректная настройка горизонтов и обеспечение согласованности между тестовой и обучающей выборками. В производственном пайплайне MAE и RMSE часто служат ядром панели контроля качества, на их основе строят пороги предупреждений и автоматические сигналы на отклонение от планов.
Реализация и интеграция
-
Вычисления выполняются параллельно по сегментам (категориям, складам, каналам продаж) для сохранения контекста спроса.
-
В пайплайне для каждого горизонта можно хранить MAE и RMSE отдельно и строить тренд по времени для раннего обнаружения ухудшения качества.
-
Для консолидации сравнения между моделями можно нормализовать метрики по среднему уровню спроса единицам измерения, но только если цель - сопоставлять модели внутри одного домена. В противном случае предпочтительнее сохранять исходную шкалу и документировать контекст.
import numpy as np

def mae(y_true, y_pred):
    y_true = np.asarray(y_true, dtype=float)
    y_pred = np.asarray(y_pred, dtype=float)
    mask = ~np.isnan(y_true) & ~np.isnan(y_pred)
    return np.mean(np.abs(y_true[mask] - y_pred[mask]))

def rmse(y_true, y_pred):
    y_true = np.asarray(y_true, dtype=float)
    y_pred = np.asarray(y_pred, dtype=float)
    mask = ~np.isnan(y_true) & ~np.isnan(y_pred)
    return np.sqrt(np.mean((y_true[mask] - y_pred[mask])**2))
Важные нюансы
-
Пропуски и несовпадение горизонтов. Любые расхождения между массивами фактов и прогнозов должны быть четко зафиксированы и исключены из расчетов, чтобы не искажать сравнение моделей.
-
Наличие выбросов. RMSE более чувствителен к выбросам, поэтому в аналогичных условиях стоит дополнять анализ дополнительными диагностическими метриками, например медианной абсолютной ошибки и анализа распределения остатков.
-
Масштабируемость. При сравнении моделей между сегментами с разной величиной спроса полезно познакомиться с относительными метриками (нормализованными на средний спрос или медиану), но не забывать о контекстном применении.
sMAPE и MASE: устойчивость к структуре ряда
sMAPE (symmetric Mean Absolute Percentage Error) - симметричная версия MAPE, предназначенная для устранения проблемы ненормируемых ошибок при больших или нулевых значениях спроса. Формула может иметь несколько вариантов, чаще всего применяется версия: 100% × (2 × |y - f|) / (|y| + |f|). Вариант с множителем 2 в числителе выравнивает шкалу относительно изменений в обоих направлениях.
-
Преимущества: относительный характер ошибок, сравнимость между рядами с разными масштабами; снижается перекос, связанный с нулевым спросом.
-
Ограничения: при очень малых значениях спроса знаменатель может стать очень маленьким, что приводит к завышению ошибки; для нулевых или близко нулевых значений требуется обработка емпирическими порогами (eps).
-
Практические рекомендации: применяйте sMAPE, если цель - сравнение между товарами/категориями с разной базой спроса и если требуется более понятная интерпретация в процентах. Всегда документируйте, как обрабатываются случаи нулевого спроса и как выбирается epsilon для устойчивости расчетов.
-
Интерпретация: отрицательный разрез в sMAPE здесь не существует, поскольку метрика даёт неотрицательное значение; интерпретация строится через относительную величину ошибки относительно среднего уровня спроса.
Реализация
import numpy as np

def smape(y_true, y_pred, eps=1e-8):
    y_true = np.asarray(y_true, dtype=float)
    y_pred = np.asarray(y_pred, dtype=float)
    denom = np.abs(y_true) + np.abs(y_pred) + eps
    return 100.0 * np.mean(2.0 * np.abs(y_true - y_pred) / denom)
Пример применения в наборе данных
- Если базовый спрос для группы продуктов невелик (например, единицы), а прогноз ошибается на 1-2 единицы, относительная ошибка может быть искажена, и sMAPE покажет неоправданно высокий процент. Здесь полезно дополнительно рассмотреть MAE/RMSE и применить пороги по контексту.
MASE: шкала и сезонность как ключ к сопоставимости
MASE (Mean Absolute Scaled Error) - масштабная метрика, которая нормализует среднюю абсолютную ошибку относительно средней абсолютной ошибки наивного прогнозирования по обучающей выборке. Это позволяет сравнивать модели и наборы данных с различной структурой и сезонностью.
-
Принцип: разбить прогнозируемую ошибку на нормирующий коэффициент, вычисляемый на обучающих данных через наивный прогноз с лагом m (часто m = 1, но может быть и сезонным, например m = сезонность). В результате MASE становится масшабируемой и даёт единичную шкалу, по которой легко судить о качестве прогноза.
-
Преимущества: независимость от масштаба и возможность сопоставления между категориями и временными рядами разных размеров; лучше подходит для кросс-серийной оценки, чем MAE/RMSE без нормализации.
-
Ограничения: зависит от длины обучающей выборки. Если в обучающей выборке малая вариативность (denom близка к нулю), MASE может быть нестабильной. В таких случаях применяют дополнительные шумоподобные поправки или альтернативы.
-
Выбор параметра m: для сезонных данных с известной периодичностью (например, месяцы с годичным циклом, m = 12) следует использовать соответствующий лаг. При отсутствии тесной сезонности применяется m = 1. Важно документировать обоснование выбора m в аналитической записке и в дашборде.
-
Интерпретация: MASE меньше 1 означает, что ваша модель лучше наивного прогноза; больше 1 - хуже наивного baseline. Однако конкретные пороги зависят от отрасли и бизнес-контекста.
Реализация и примеры кода
import numpy as np

def mase(y_true, y_pred, y_train, m=1):
    y_true = np.asarray(y_true, dtype=float)
    y_pred = np.asarray(y_pred, dtype=float)
    y_train = np.asarray(y_train, dtype=float)
    n = len(y_true)
    if len(y_train) Практические советы
- Для сравнения моделей на разных наборах данных используйте MASE как единый масштаб. При этом следите за длиной обучающей выборки и за тем, чтобы лаг m соответствовал структуре ряда.
- В реальных системах мониторинга храните и визуализируйте не только значения MASE, но и динамику denom (naive baseline) по времени - так проще увидеть, когда ухудшается базовый уровень, а не конкретная модель.
Forecast Deviation: диагностика направления ошибок
Forecast Deviation - это диагностическая концепция, фокусирующаяся на распределении отклонений между прогнозами и фактическими значениями, включая как signed-отклонения (разности прогноз - факт), так и их статистические свойства (среднее, дисперсия, хвосты). Хотя она не является единым общепринятым стандартом в виде числовой метрки, Forecast Deviation служит важной информацией для управления запасами, калибровки моделей и управления рисками.
- Signed deviation (e_t = y_t - f_t) позволяет оценить bias направления: систематический недосклад или переоценка спроса.
- Distributional analysis: анализ дисперсии и формы распределения ошибок помогает понять, насколько устойчивы прогнозы к сезонным колебаниям, всплескам спроса и редким событиям.
- Совокупная диагностика: когда этапа прогнозирования достаточно для принятия оперативных решений, сочетание MAE/RMSE и анализа Forecast Deviation даёт более полную картину качества прогноза, чем любая метрика по отдельности.
Как использовать Forecast Deviation в практической архитектуре
- Включайте в набор метрик не только величины ошибок, но и направление ошибок. Это позволяет бизнесу оценить риски отклонения запасов и корректировать параметры заказов.
- Визуализация распределения отклонений по категориям и складам помогает выявить паттерны, связанные с конкретными каналами продаж, временными окнами или товарами.
- Связывайте Forecast Deviation с порогами риска. Например, укажите допустимую долю отклонений в пределах заданного диапазона, а за пределами - инициируйте предупреждение или автоматическую корректировку запасов.
Реализация и примеры
-
Реализация может включать сбор и хранение резидентных ошибок в лавине данных модели, их суммарные статистики и периодические отчеты в дашбордах.
-
В зависимости от архитектуры можно дополнительно вычислять суммарные и кумулятивные отклонения по горизонту и по сегментам для оперативного планирования.
## Пример простого анализа Forecast Deviation
import numpy as np

def deviation_stats(y_true, y_pred):
    y_true = np.asarray(y_true, dtype=float)
    y_pred = np.asarray(y_pred, dtype=float)
    dev = y_true - y_pred
    mean_dev = np.mean(dev)
    std_dev = np.std(dev)
    skew = float(np.mean(((dev - mean_dev)**3) / (std_dev**3 + 1e-8)))
    return {
        'mean_deviation': mean_dev,
        'std_deviation': std_dev,
        'skewness': skew,
        'min_deviation': np.min(dev),
        'max_deviation': np.max(dev)
    }
Практические рекомендации
-
Используйте Forecast Deviation как фактор-камеру в мониторинге. Включайте в отчеты информацию о том, как часто направления ошибок приводят к недокупкам или перепроизводству.
-
Комбинируйте направление ошибок с бизнес-метриками - например, с величиной оборота, затратами на хранение и рисками дефицита.
-
При активной оптимизации запасов применяйте корректировки в параметрах заказа на основе анализа суммы отклонений в разные периоды, чтобы добиться баланса между излишками и дефицитом.
Интеграция в архитектуру прогнозирования
- Архитектура расчета. В рамках единого сервиса метрик целесообразно реализовать слой расчета MAE, RMSE, sMAPE, MASE и Forecast Deviation как микросервисы либо as-a-service. Это облегчает поддержку, масштабирование и версионирование.
- Источники и качество данных. Источник данных должен сохранять «историю» фактических значений и прогнозов с тегами по товарам, складам, каналам продаж, горизонту и временным отметкам. Контроль качества данных, проверки на пропуски, коррекция задержек данных - обязательная часть пайплайна.
- Метрики как часть CI/CD. Включение вычисления и тестирования метрик в процесс непрерывной интеграции и доставки позволяет обнаруживать деградацию точности на ранних этапах развёртывания новых моделей.
- Визуализация и дашборды. Встроенные панели должны показывать временные ряды MAE, RMSE, sMAPE, MASE и Forecast Deviation по сегментам, с возможностью фильтраций по товарной категории, складу, каналу, горизонту и периодам. Визуализации помогают бизнесу быстро оценить качество прогноза и принять управленческие решения.
- Примеры инструментов. В качестве открытых инструментов часто применяют scikit-learn для базовых расчетов метрик и pandas для обработки данных; для статистических расчётов - statsmodels или numpy. В контексте российского рынка возможно использование локальных платформ BI и интеграций через API с корпоративной аналитикой, но 1-2 примера сервисов достаточно.
Key takeaways
- MAE и RMSE дают разные сигналы об величине ошибок; выбор метрики должен зависеть от бизнес-контекста и распределения ошибок в данных.
- sMAPE обеспечивает симметричность ошибок и является полезной альтернативой MAPE, но требует осторожности при нулевых значениях и очень малых спросах.
- MASE предоставляет масштабируемую и сезонно корректируемую метрику для сопоставления между рядами и моделями, если корректно выбран лаг m и достаточна длина обучающей выборки.
- Forecast Deviation выступает диагностическим инструментом, помогающим понять направление и риск-аспекты ошибок, а не просто их величину.
- Интеграция в архитектуру требует единого сервиса метрик, качественных данных, контроля версий и продуманной визуализации для оперативного принятия решений.
- Правильная настройка пайплайна для расчета и мониторинга этих метрик поддерживает качество прогноза, снижает риски и ускоряет циклы цифровой трансформации.
- При внедрении стоит помнить о выборе параметров (например, m в MASE, epsilon в sMAPE) и документировать обоснование, чтобы обеспечить прозрачность и воспроизводимость.
FAQ
- Что выбрать между MAE и RMSE для оптимизации модели прогноза спроса?
- MAE лучше отражает реальную величину ошибок без излишнего акцентирования на крупные сбои; RMSE подчеркивает крупные ошибки и может быть более уместен, если бизнес нацелен на минимизацию тяжелых промахов. В практике часто используют обе метрики в связке: MAE для общей точности и RMSE для контроля риска крупных ошибок. Важно также учитывать контекст бизнеса и масштабы всего набора данных.
- В чем особенности и ограничения sMAPE?
- sMAPE полезен для сравнения рядов с разной масштабностью и обеспечивает симметричность ошибок. Ограничения возникают, когда оба значения y и f близки к нулю, что приводит к неоправданно большим процентам. Чтобы избежать этого, применяют пороговую защиту (eps) или альтернативные трактовки ошибок в нулевых областях и сопровождают расчеты дополнительными метриками.
- Как правильно выбирать параметр m в MASE?
- Выбор m зависит от сезонности ряда. Если ряд сезонный с периодом P, разумно использовать m = P. При отсутствии явной сезонности - m = 1. В любом случае важно проверить устойчивость MASE к изменению m и документировать обоснование выбора.
- Можно ли сравнивать метрики между категориями с разной базой спроса?
- Да, но чаще делают это через относительные или нормированные метрики (например, MASE и нормализованный MAE) или применяют дополнительные сравнения на единицу Sage относительно базового уровня спроса. В любом случае следует сохранять контекст и допускать сравнения только между наборами данных, имеющими схожие бизнес-условия.
- Как обрабатывать нулевые значения в данных для sMAPE?
- Добавляют малую константу eps в знаменатель для стабилизации расчетов и документируют пороги. Альтернативно можно исключать точки с нулевым спросом из расчетов, но это уменьшает объём информации и может создавать смещение в интерпретации.
- Как учитывать сезонность в MASE и сравнениях между рядами?
- В MASE учитывайте сезонность через лаг m, равный сезонному интервалу (например, 12 для годовой сезонности в месячных данных). Это позволяет нормализовать ошибки по отношению к наивному сезонному прогнозу и обеспечивает сопоставимость между рядами с разной сезонной структурой.
- Как внедрять эти метрики в систему мониторинга качества прогнозов?
- Разработайте единый сервис метрик, который принимает фактические значения, прогнозы и обучающие данные, вычисляет MAE, RMSE, sMAPE, MASE и Forecast Deviation, хранит временные ряды метрик и предоставляет API для дашбордов. Добавьте механизмы алертов при выходе за пороги и интегрируйте расчеты в CI/CD пайплайны и регламентные процессы.
- Какие инструменты и библиотеки полезны для расчета метрик?
- В открытом сообществе наиболее распространены scikit-learn и numpy для базовых расчетов MAE и RMSE; для симметричных и масштабируемых метрик можно использовать scipy, statsmodels, или собственные реализации, как в приведённых примерах. В корпоративной среде часто применяется собственная инфраструктура аналитики и интеграция через API в существующие BI-платформы.
- Какие риски связаны с избыточной зависимостью от одной метрики?
- Одна метрика не отражает всю картину. Из-за этого требуется набор метрик: сочетание MAE, RMSE, sMAPE и MASE обеспечивает всестороннюю точку зрения на точность и устойчивость прогноза. Просмотр распределения ошибок (Forecast Deviation) дополняет картину и снижает риск «слепоты» к редким, но критическим ситуациям.
- Как проверить воспроизводимость расчетов в рамках цифровой трансформации?
- Введите версионирование кода расчета метрик, зафиксируйте версии данных и зависимостей, документируйте параметры и горизонты, и регулярно прогоняйте тесты на репрезентативных наборах. Включение метрик в тестовые сценарии обеспечивает воспроизводимость и регрессионный контроль при обновлениях моделей.


