

Форматы данных и схемы: JSON, Avro, Protobuf; эволюция схем
Потоковые данные в CDP строятся на жесткой связи между тем, как данные публикуются, и тем, как они потребляются в реальном времени. Форматы данных и схемы определяют контракт между producers и consumers, обеспечивая устойчивость к изменениям бизнес-логики, рост объема и разнообразие форматов. В этой главе рассматриваются три базовых формата - JSON, Avro и Protobuf - их архитектурные особенности, преимущества и ограничения в контексте потоковой аналитики, а также подходы к эволюции схем, управлению совместимостью и практики внедрения в CDP.
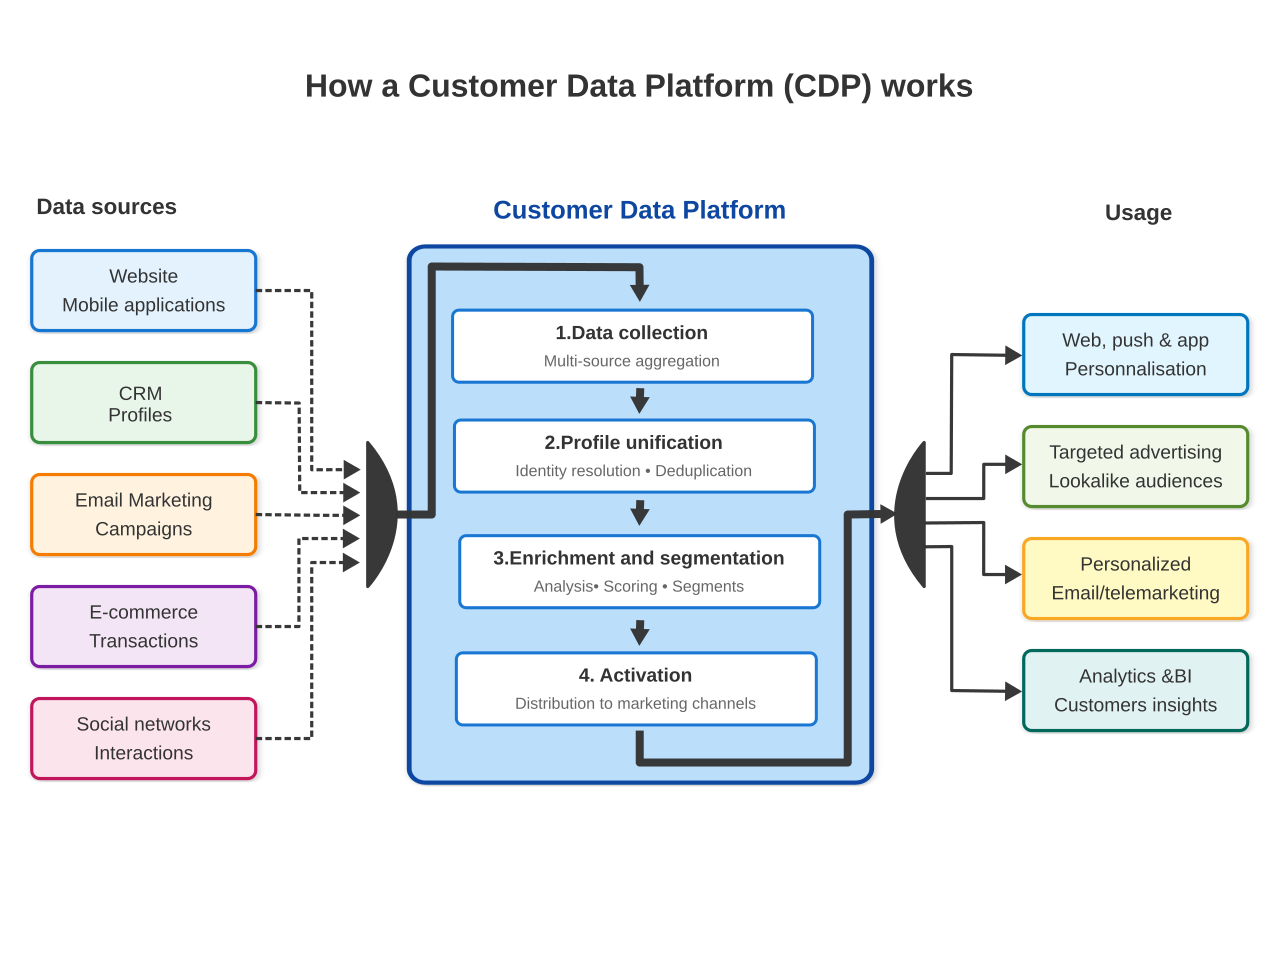
В CDP события чаще всего проходят через конвейер ingestion: они публикуются в потоковый сервис (например, Kafka, Pulsar или управляемые сервисы облаков), проходят через регистр схем и далее потребляются аналитическими сервисами, хранилищами и инструментами реального времени. В таких условиях выбор формата определяет не только скорость сериализации и пропускную способность, но и качество данных, возможность автоматического разворачивания изменений и совместимость версий схем между различными сервисами. Привычная гибкость формата (например, JSON) должна сочетаться с жестким контролем схемы (Avro, Protobuf), чтобы обеспечить предсказуемость аналитических запросов, репликацию изменений и детерминированность поведения потребителей.
Краткое содержание главы
- Архитектурные принципы работы форматов данных в потоке: контракт между producer’ами и consumer’ами, роль схем и регистров, режимы совместимости.
- JSON: преимущества для гибкости, ограничения для реального времени и методы обеспечения качества данных.
- Avro: эффективная бинарная сериализация, регистры схем, режимы совместимости и эволюция без прерывания потоков.
- Protobuf: компромисс между эффективностью и управлением схемами, принципы совместимости и практики внедрения в CDP.
- Эволюция схем в CDP: стратегия версий, Governance, тестирование совместимости, миграции и наблюдаемость.
- Реализация и интеграция в контексте CDP: архитектурные паттерны, регистрация схем, контроль качества и примеры рабочих пайплайнов.
Контекст поточных данных и роль форматов
Потоковые данные представляют собой неизменяемые события, которые публикуются часто в большом объеме и с минимальными задержками. Встроенная эмпатия между форматами и схемами позволяет decoupling между producers и consumers: producers не опираются на точную реализацию потребителей и наоборот. Однако это же требование приводит к необходимости жесткого контракта через схему: какие поля присутствуют, какие типы данных, какие значения и как обрабатывать отсутствие полей. В CDP контракт на схему чаще всего реализуется через регистр схем, который хранит версии и обеспечивает доступ к валидированной схеме для потребителей и консолидирует процедуры обновления и верификации.
С технической точки зрения форматы должны обеспечивать:
- детерминированную сериализацию и десериализацию: одинаковый поток байтов должен приводить к идентичной декодированной структуре на разных сервисах.
- совместимость при эволюции: возможность добавления, изменения или удаления полей без катастрофического прерывания рабочих пайплайнов.
- управляемость полей и типов: поддержка вложенных структур, массивов, мап, временных меток и специальных типов (логические типы даты/время).
- эффективную обработку пропусков и дефолтов: как потребитель реагирует на отсутствующие поля или значения null.
В практике CDP это выливается в набор архитектурных решений: выбор формата для конкретного конвейера, создание единого регистра схем, внедрение политики совместимости, тестирование изменений и мониторинг миграций. Изучение трех форматов не является академическим упражнением: каждый формат имеет место в разных частях конвейера и под разные задачи, и комбинация форматов иногда является оптимальным решением для разных бизнес-сценариев.
JSON: гибкость и ограничения
JSON остается одним из самых широко поддерживаемых форматов для потоковой передачи. Его достоинство - естественная читаемость, простота интеграций и возможность быстро разворачивать новые поля без сложной подготовки инфраструктуры. В начальных и средних стадиях цифровой трансформации JSON часто выступает первым форматом для интеграций событийных пайплайнов и интерфейсов между сервисами.
Преимущества
- гибкость и прозрачность: структура события видна «на глаз», легко эволюционирует без обновления инфраструктуры.
- широкая совместимость: любой язык и платформа поддерживают JSON, что упрощает создание простых пайплайнов и прототипов.
- совместные процессы в CDP: быстрое подключение источников данных, внешних API и инструментов аналитики без необходимости регистрировать схемы заранее.
Ограничения
- отсутствие жесткого контракта: без формального описания типов данные могут содержать несоответствия, приводя к неопределенному поведению потребителей.
- производительность и объем памяти: парсинг строк в объекты языка требует больше процессорного времени и памяти по сравнению с бинарными форматами.
- риск дрейфа схем: добавление новых полей может привести к несогласованности между producer’ами и consumer’ами, особенно если валидаторы не применяются единообразно.
- валидировать данные: отсутствие встроенного средства типовой проверки требует внешних средств (JSON Schema, регистры схем, тесты) для контроля качества данных.
Стратегии внедрения в CDP
- применение NDJSON или JSON Lines: один JSON-объект на строку, упрощает парсинг и обработку в стриминге, обеспечивает эффективные конвейеры чтения.
- внедрение JSON Schema для валидности: в качестве контракта можно использовать JSON Schema как акт регистрации, ограничивающий поля, типы и обязательность.
- сочетание с простыми механизмами версионирования: хранение версии схемы в заголовке сообщения или в полях полезной нагрузки позволяет потребителям выбирать парсер и миграцию без паузы в работе пайплайна.
Пример структуры события в JSON
{
  "schema_version": 1,
  "event_type": "page_view",
  "timestamp": 1689930400000,
  "user_id": "u_12345",
  "properties": {
    "page": "/home",
    "referrer": "google"
  }
}
Альтернативно можно применять JSON Schema как контракт и хранить только данные payload, что упрощает миграции и совместимость в больших командах. Однако если фронтальная часть проекта стремится к масштабируемости и устойчивости к росту объема, переход к бинарным форматам (Avro, Protobuf) часто становится необходимым шагом.
Avro: схематизация и эволюция
Avro известен своей бинарной эффективностью и встроенной поддержкой схем. В CDP Avro применяется там, где критичны пропускная способность и низкая задержка, особенно в высоконагруженных пайплайнах и аналитических системах. Основной механизм - разделение схемы и данных: данные сериализуются в компактный двоичный формат, а схема хранится отдельно в регистре схем.
Ключевые аспекты Avro
- бинарная сериализация: экономия пространства и ускорение парсинга по сравнению с JSON.
- регистр схем: хранение версий, идентификаторов и совместимости. В большинстве реализаций современных стеков данных схема привязывается к каждому сообщению через идентификатор, получаемый из регистра.
- управление эволюцией: в рамках одного пайплайна можно поддерживать несколько версий схем, однако ключ к устойчивости - практика обратной и взаимной совместимости.
Совместимость и эволюция
- обратная совместимость (backward): новая версия схемы может читать данные, написанные старой версией, если новые поля допускаются как необязательные или имеют значения по умолчанию.
- передовая совместимость (forward): старая версия может читать данные, записанные новой схемой, если новые поля помечены как необязательные и игнорируются потребителем старой схемой.
- полная совместимость (full): возможно чтение как старыми, так и новыми потребителями и производителями схем в рамках одной линейки версий.
- важное: при изменениях схемы добавление или модификация полей должно быть выполнено с явной стратегией дефолтов и способами обработки отсутствия полей.
Типовые структурные решения
- writer’s schema vs reader’s schema: клиенты сериализуют с одной схемой и читают с другой; режим “reader schema” может адаптировать данные под текущую логику потребителя.
- использование логических типов: дат и временных меток, decimal и других бизнес-типов, чтобы сохранить семантику на уровне смысла, а не только физического представления.
- дефолты и unions: в Avro поддерживаются сложные варианты, но следует избегать чрезмерной сложности полей, которые приводят к несовместимостям.
Пример Avro-схемы
{
  "type": "record",
  "name": "Event",
  "fields": [
    {"name": "user_id", "type": "string"},
    {"name": "event_type", "type": "string"},
    {"name": "timestamp", "type": "long"},
    {"name": "properties", "type": {"type": "map", "values": "string"}}
  ]
}
Пример использования идентификатора схемы
- Примерный уровень реализации в конвейере: каждый посыл содержит ссылку на схему в регистре, либо через специальный префикс в последовательности байтов, например, magic-число + schema_id, чтобы потребителю не пришлось передавать полную схему каждую запись.
Avro хорошо подходит для больших потоков, где важны скорость сериализации/десериализации и возможность централизованного управления схемами. Однако он требует наличия регистров схем и аккуратного планирования версий, особенно в распределенных CDP-пайплайнах, где разные компоненты обновляются независимо.
Protobuf: компактность и совместимость
Protobuf предлагает еще более жесткую и эффективную бинарную форму, ориентированную на производительность и устойчивость к изменениям. В proto3 (самая распространенная версия для новых проектов) отсутствуют некоторые механизмы согласования, которые есть в proto2, но обеспечивают простоту интеграции и высокую скорость сериализации.
Ключевые принципы Protobuf
- схемы через .proto файлы: поля имеют номера, которые определяют идентификаторы в бинарном формате; сами имена полей не влияют на совместимость.
- расширяемость через новые поля: добавление новых полей с новыми номерами не ломает существующих потребителей.
- порядок не имеет значения: данные читаются по идентификаторам полей, не зависят от позиции в бинарном потоке.
- proto3 и дефолты: отсутствие явного null позволяет проще моделировать отсутствие значений, но требует особого внимания к значению по умолчанию.
Совместимость и миграции
- добавление новых полей: безопасно, если старые потребители игнорируют неизвестные поля.
- удаление и переименование: рекомендуется использовать резервирование номеров и переадресацию на новые имена через новые сообщения/версии схем.
- регистры схем: в CDP можно использовать регистры Protobuf или многократно внедрять регистры схем, где хранится текущее состояние и история изменений.
Пример Protobuf-сообщения
syntax = "proto3";

package com.example;

message Event {
  string user_id = 1;
  string event_type = 2;
  int64 timestamp = 3;
  map properties = 4;
}
Преимущества Protobuf в контексте CDP заключаются в очень эффективной сериализации, что особенно важно в условиях высокой пропускной способности и задержек. Это делает Protobuf предпочтительным выбором для внутренних сервисов, микросервисных архитектур и компонентов, где межсервисное взаимодействие требует минимальных затрат на сериализацию и десериализацию. С другой стороны, Protobuf требует более формализованного подхода к контрактам, поскольку поля и их номера играют ключевую роль в совместимости и эволюции.
Эволюция схем и стратегии совместимости в CDP
Эволюция схем - не только техническая задача, но и организационная. В CDP изменение форматов должно сопровождаться политиками управления версиями, тестированием и мониторингом. Гибкость форматов не должна превращаться в хаос версий и рассинхрон между производителями и потребителями.
Стратегии эволюции
- версионирование и версия-ключи: каждое сообщение связано с версией схемы; потребители выбирают соответствующую версию или применяют reader-writer схемы для совместимости.
- режимы совместимости: backward, forward и full. В CDP обычно рекомендуется постепенно переходить на backward или full, чтобы обеспечить плавную миграцию.
- участие регистров схем: регистрация каждой версии схемы с описанием изменений и совместимости. Важна политика архивирования устаревших версий, чтобы сохранить воспроизводимость исторических данных.
- миграции и рефакторинг: планирование миграций через серию этапов, тестирование на песочнице, затем постепенный выпуск в продакшен с мониторингом ошибок и задержек.
Governance и процессы
- роли и ответственности: владельцы схем, команды по данным и операторы инфраструктуры должны взаимодействовать для своевременного обновления контрактов и устранения конфликтов.
- тестирование схем: функциональные тесты на сериализацию/десериализацию, тесты совместимости между версиями, регрессионное тестирование при миграциях.
- observability: мониторинг ошибок в процессе десериализации, доля несовместимых записей, скорость миграций и задержки в пайплайнах.
Паттерны внедрения в CDP
- двухуровневый подход: данные проходят через слой сообщений с объявлениями схем и слой обработки задач, где происходит валидирование и адаптация к версии потребителя.
- тема как версия: каждая версия схемы может иметь свою тему/канал, что дополняет управление эволюцией, особенно когда разные команды работают над разными версиями.
- drift detection: автоматические сигналы, которые предупреждают об отклонениях между тем, что ожидается по контракту, и тем, что реально публикуется в потоке.
Реализация и интеграция в CDP
Реализация форматов и схем требует согласованности между компонентами: продюсеры, регистры схем, консьюмеры, потоковые брокеры и аналитические инструменты. В CDP с реальным временем критически важно обеспечить детерминированность и мониторинг того, как схемы эволюционируют и как это влияет на аналитическую инфраструктуру.
- Регистры схем как центральный элемент: хранение версий схем, контроль совместимости и простота доступа для всех сервисов. Примеры - Confluent Schema Registry и подобные решения в облачных консолях. Встроенная функциональность регистра позволяет централизованно управлять изменениями, автоматизировать проверки и снижать риск расхождений между темами и потребителями.
- Интеграция с потоковыми платформами: форматы должны быть тесно связаны с инфраструктурой публикации сообщений. В случае Avro и Protobuf часто применяется схема-идентификатор в заголовке сообщения, что позволяет потребителю выбирать правильную схему без передачи полного описания каждый раз.
- Обеспечение качества данных: governance-процессы, проверки совместимости, аудит версий и автоматизированные тесты на регрессию при каждом изменении схемы. Набор метрик может включать долю сообщений с несовместимыми схемами, среднюю задержку конвейера и количество ошибок десериализации.
- Observability и drift-мониторинг: инструменты мониторинга должны распознавать дрейф схем на ранних стадиях, чтобы предотвратить дефекты в отчетах и аналитике в реальном времени. Это особенно важно для CDP, где мелкие несоответствия в полях могут приводить к ошибкам в агрегациях и неправильным выводам.
Практические подходы
- выбор форматов по задачам: JSON** - для гибкого начального сбора и прототипирования, Avro - для централизованного контроля и оптимальной пропускной способности, Protobuf - для межсервисной коммуникации и идущих в реальном времени конвейеров.
- документирование контрактов: хранение схем не только в регистре, но и в технической документации, включая примеры валидных и некорректных записей, чтобы снизить риск неверной реализации потребителями и продюсерами.
- миграции без остановки: планирование релизов, тестирование на песочнице и постепенный переход потребителей на новую версию схем, с поддержкой старых версий для совместимости.
Key takeaways
- Форматы данных определяют контракт потоковой аналитики: выбор должен учитывать требования к скорости, объему и совместимости.
- JSON обеспечивает гибкость, но требует строгих практик валидации и контроля качества данных.
- Avro и Protobuf предлагают жесткую схему и эффективную сериализацию, что полезно для больших потоков и системного анализа.
- Эволюция схем должна осуществляться через регистры схем, контроль версий, тестирование совместимости и governance-процессы.
- Архитектура CDP должна гарантировать минимальные прерывания при миграциях схем и поддерживать observability для раннего обнаружения дрейфа.
- Внедрение требует ясной политики версий, роли ответственных и автоматизации тестов и мониторинга.
- Реализация в CDP часто подразумевает комбинацию форматов по задачам и единый подход к регистрации схем и управлению их версиями.
FAQ
Вопрос: Какой формат лучше выбрать для потока, если требуется быстрое внедрение и минимальные усилия на поддержку?
JSON часто подходит на старте за счет своей простоты и широкої поддержки. Однако для крупных потоков и критичной аналитики рекомендуется внедрять Avro или Protobuf, чтобы обеспечить схему и компактную сериализацию. Начните с JSON и параллельно внедряйте регистр схем и переход к Avro/Protobuf на наиболее критичных конвейерах, минимизируя риск прерываний.
Вопрос: Что такое регистр схем и зачем он нужен в CDP?
Регистр схем - централизованное хранилище метаданных о версиях схем, их совместимости и идентификаторах. Он обеспечивает единый контракт между producers и consumers и позволяет управлять эволюцией без потери совместимости. Регистры поддерживают проверки совместимости и версионирование, что критично для устойчивых потоковых конвейеров.
Вопрос: Какие режимы совместимости следует применять и почему?
Обычно применяют backward или full совместимость. Backward позволяет новым потребителям читать данные, созданные старой схемой, что удобно для плавной миграции. Full обеспечивает одинаковую совместимость в обе стороны и защищает от несовместимостей, но требует более продуманного подхода к изменениям.
Вопрос: Какие риски связаны с эволюцией схем в рамках CDP?
Основные риски - несовместимость между производителями и потребителями, дрейф данных и полей, а также увеличение сложности управления версиями. Чтобы минимизировать риски, следует внедрять автоматическое тестирование совместимости, четко документировать изменения и использовать регистры схем с процессами ревью.
Вопрос: Как обеспечить согласованность между форматами в разных частях CDP?
Применяйте единую политику версий и идентификаторов схем, используйте единый Registy, и внедряйте конвертеры или адаптеры между форматами, когда это требуется. Для межсервисного взаимодействия полезно иметь унифицированные контракты и механизмы миграций, чтобы все сервисы двигались синхронно.
Вопрос: Какие практики тестирования пригодны для схем в CDP?
Рекомендуются: (1) модульные тесты сериализации/десериализации, (2) тесты совместимости между версиями схем, (3) тесты миграций на реальных данных в песочнице, (4) регрессионные проверки, чтобы убедиться, что новые поля не ломают существующую аналитическую логику.
Вопрос: Как выбрать между Avro и Protobuf для межсерверной передачи?
Avro хорошо подходит, когда важна встроенная поддержка регистров схем и эволюция в рамках одного конвейера; Protobuf - когда критична высокая пропускная способность и минимальные задержки в пределах сервисной архитектуры. В реальных системах часто используется комбинация: Protobuf для микро-сервисов и Avro в слоях обработки данных и хранения.
Вопрос: Какие минимальные шаги необходимы для запуска проекта по схемам в CDP?
определить требования к совместимости и выбрать формат(ы); 2) внедрить регистр схем и выстроить процесс версионирования; 3) протянуть пайплайны через конвейеры с поддержкой версий; 4) настроить мониторинг дрейфа схем и ошибок десериализации; 5) запустить пилотный проект на ограниченном наборе потоков и поэтапно расширять.
Вопрос: Можно ли хранить схемы отдельно от данных?
Да. Хранение схем в регистре и их использование через идентификатор в сообщении позволяет эффективно управлять эволюцией, но потребует интеграции с инфраструктурой регистров и аккуратного планирования миграций для существующих пайплайнов.
Вопрос: Как обеспечить обратную совместимость в случае сложной эволюции?
Планируйте миграции через несколько версий схем, применяйте режимы совместимости, используйте reader/writer схемы и дефолты для новых полей, тестируйте изменения на тестовых наборах данных и постепенно переводите потребителей на новую версию схем.
Вопрос: Какие примеры инструментов и продуктов можно упомянуть в контексте CDP?
В рамках открытых решений часто встречаются Confluent Schema Registry для Avro/JSON, Apache Kafka как потоковая платформа и инструменты для Protobuf-обработки в микросервисах. В рамках рынка можно учесть облачные регистры схем (AWS Glue Schema Registry, Google Cloud Data Catalog) и специфические решения внутри крупных CDP-платформ, которые интегрируют регистры схем, контроль версий и мониторинг в единый конвейер.


