

Алгоритм Instagram с машинным обучением
Реализация алгоритма Instagram с машинным обучением с использованием Python
Прогнозирование охвата постов в Instagram – одна из важнейших задач для любого бизнеса, который сильно зависит от клиентов социальных сетей. Поэтому в такой задаче очень важно знать, как работает алгоритм Instagram. В этой статье я расскажу вам о реализации алгоритма Instagram с машинным обучением на базе Python, чтобы понять, как ваши публикации могут получить больше охвата в Instagram.
Как работает алгоритм Instagram?
То, что люди видят в своих постах и историях в Instagram, зависит от сочетания поведения пользователей, которое они демонстрируют в большей части просматриваемого контента. Самыми важными характеристиками, которые влияют на охват ваших публикаций в Instagram, являются тип сообщений, с которыми люди взаимодействуют, тип сообщений, которые им нравятся и которые участвуют в обсуждениях.
Когда алгоритм Instagram получает положительный сигнал в соответствии с вышеуказанными функциями в ваших сообщениях, он дает больше возможностей для вашего поста, чтобы получить больший охват среди вашей аудитории.
Итак, теперь я надеюсь, что вы имеете представление о том, как работает алгоритм Instagram. Но как реализовать его с помощью машинного обучения? В следующем разделе я расскажу, как реализовать алгоритм Instagram с машинным обучением с использованием Python.
Алгоритм Instagram с машинным обучением
Основываясь на том, как работает алгоритм Instagram, мы выяснили, что чем больше у пользователя подписчиков, тем выше вероятность, что пост получит больше лайков и вовлеченности, чтобы охватить больше аудитории.
Поэтому нам нужно определить линейную взаимосвязь в данных и построить алгоритм машинного обучения на основе взаимосвязи, которую мы находим в данных, для реализации алгоритма Instagram с машинным обучением.
Для этой задачи я буду использовать набор данных примерно со 100 строками и 6 функциями, содержащими информацию об именах пользователей, подписях к сообщениям, подписчиках, хэштегах, времени с момента публикации и лайках. Итак, я собираюсь обучить модель машинного обучения предсказывать подобные элементы.
Реализация алгоритма Instagram с использованием Python
Теперь давайте начнем с задачи реализации алгоритма Instagram с машинным обучением с использованием Python. Я начну с импорта набора данных:
 import pandas as pd
 data = pd.read_csv("instagram_reach.csv")

data.info()
Результат:
<class 'pandas.core.frame.DataFrame'>
RangeIndex: 100 entries, 0 to 99
Data columns (total 8 columns):
 #   Column             Non-Null Count  Dtype
---  ------             --------------  -----
 0   Unnamed: 0         100 non-null    int64
 1   S.No               100 non-null    int64
 2   USERNAME           100 non-null    object
 3   Caption            94 non-null     object
 4   Followers          100 non-null    int64
 5   Hashtags           100 non-null    object
 6   Time since posted  100 non-null    int64
 7   Likes              100 non-null    int64
dtypes: int64(5), object(3)
memory usage: 6.4+ KB
Теперь давайте импортируем некоторые другие библиотеки Python и подготовим функцию для изучения облака слов, чтобы понять максимальный тип слов, используемых в подписях и хэштегах Instagram:
import matplotlib.pyplot as plt
from wordcloud import WordCloud, STOPWORDS
stopwords = set(STOPWORDS)
stopwords.add('will')
import re
import seaborn as sns
sns.set()
plt.style.use('seaborn-whitegrid')

def WordCloudPlotter(dfColumn):
    colData = data[dfColumn]
    textCloud = ''

    #text processing
    # converting colums to a
    #single line of text
    for mem in colData:
        textCloud = textCloud + str(mem)

    # plotting word cloud
    wordcloud = WordCloud(width = 800, height = 800,background_color ='white',
                          stopwords = stopwords,  min_font_size = 10).generate(textCloud)
    plt.figure(figsize = (8, 8), facecolor = None)
    plt.style.use('seaborn-whitegrid')
    plt.imshow(wordcloud)
    plt.rcParams.update({'font.size': 25})
    plt.axis("off")
    plt.title('Word Cloud: ' + str(dfColumn))
    plt.tight_layout(pad = 0)

    plt.show()

WordCloudPlotter('Caption')
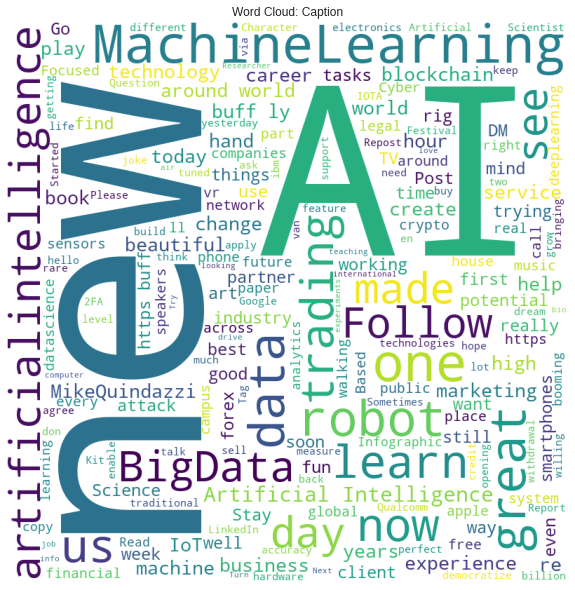
WordCloudPlotter('Hashtags')

А сейчас давайте разберемся, сколько лайков мы получаем в зависимости от количества подписчиков и времени, прошедшего с момента публикации:
def PlotData(features):
    plt.figure(figsize= (20, 10))
    pltNum = 1
    for mem in features:
        plt.subplot(1, 2 , pltNum)
        plt.style.use('seaborn-whitegrid')
        plt.grid(True)
        plt.title('Regplot Plot for '+ str(mem))
        sns.regplot(data = data, x = mem, y = 'Likes' , color = 'green')
        pltNum += 1

    plt.show()

PlotData(['Followers', 'Time since posted'])

Теперь я собираюсь обучить простую модель для прогнозирования целевого значения «лайков» с комбинацией количества подписчиков и времени с момента публикации:
import numpy as np
features = np.array(data[['Followers', 'Time since posted']], dtype = 'float32')
targets = np.array(data['Likes'], dtype = 'float32')
maxValLikes = max(targets)
print('Max value of target is {}'.format(maxValLikes))
Результат:
Max value of target is 349.0
Модель обучения:
Теперь давайте обучим алгоритм Instagram с помощью Python:
targets = targets/maxValLikes
from sklearn.preprocessing import StandardScaler
from sklearn.model_selection import train_test_split


xTrain, xTest, yTrain, yTest = train_test_split(features, targets, test_size = 0.1, random_state = 42)


stdSc = StandardScaler()
xTrain = stdSc.fit_transform(xTrain)
xTest = stdSc.transform(xTest)


from sklearn.ensemble import GradientBoostingRegressor
gbr = GradientBoostingRegressor()
gbr.fit(xTrain, yTrain)
Результат:
GradientBoostingRegressor(alpha=0.9, ccp_alpha=0.0, criterion='friedman_mse',
                          init=None, learning_rate=0.1, loss='ls', max_depth=3,
                          max_features=None, max_leaf_nodes=None,
                          min_impurity_decrease=0.0, min_impurity_split=None,
                          min_samples_leaf=1, min_samples_split=2,
                          min_weight_fraction_leaf=0.0, n_estimators=100,
                          n_iter_no_change=None, presort='deprecated',
                          random_state=None, subsample=1.0, tol=0.0001,
                          validation_fraction=0.1, verbose=0, warm_start=False)
    predictions = gbr.predict(xTest)
    plt.scatter(yTest, predictions)
    plt.style.use('seaborn-whitegrid')
    plt.xlabel('true values')
    plt.ylabel('predicted values')
    plt.title('GradientRegressor')
    plt.plot(np.arange(0,0.4, 0.01), np.arange(0, 0.4, 0.01), color = 'green')
    plt.grid(True)

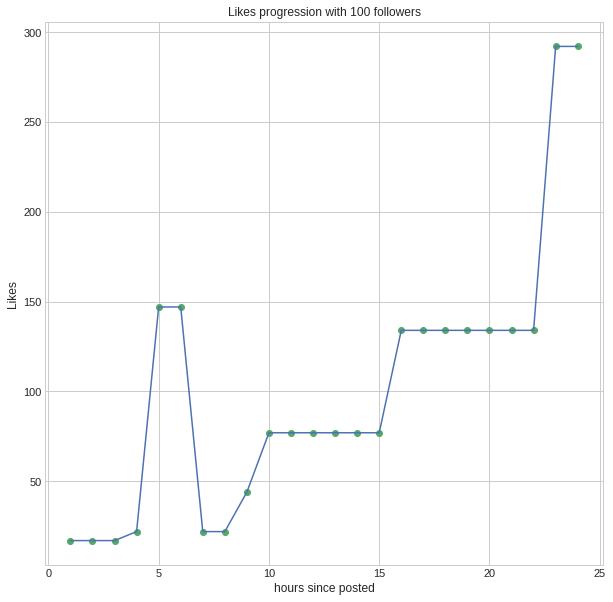
Итак, модель машинного обучения, представленная выше, выглядит хорошо, так что давайте реализуем ее, создав кейсы в реальном времени:
def PredictionsWithConstantFollowers(model, followerCount, scaller, maxVal):
    followers = followerCount * np.ones(24)
    hours = np.arange(1, 25)

    # defining vector
    featureVector = np.zeros((24, 2))
    featureVector[:, 0] = followers
    featureVector [:, 1] = hours

    # doing scalling
    featureVector = scaller.transform(featureVector)
    predictions = model.predict(featureVector)
    predictions = (maxValLikes * predictions).astype('int')

    plt.figure(figsize= (10, 10))
    plt.plot(hours, predictions)
    plt.style.use('seaborn-whitegrid')
    plt.scatter(hours, predictions, color = 'g')
    plt.grid(True)
    plt.xlabel('hours since posted')
    plt.ylabel('Likes')
    plt.title('Likes progression with ' + str(followerCount) +' followers')
    plt.show()

PredictionsWithConstantFollowers(gbr, 100, stdSc, maxValLikes)
 # likes progression for 200 followers
 PredictionsWithConstantFollowers(gbr, 200, stdSc, maxValLikes)

 # Like progression for 1000 followers
 PredictionsWithConstantFollowers(gbr, 1000, stdSc, maxValLikes)

Выводы
Основываясь на приведенных выше прогнозах, мы наблюдаем одну вещь: если у вас больше подписчиков, ваш пост с большей вероятностью получит больше лайков на всю жизнь. Но максимальное количество лайков не увеличится более чем в 20 раз, количество подписчиков только способствует увеличению количества лайков примерно на 20%.
Надеюсь, вам понравилась эта статья о том, как реализовать алгоритм Instagram с машинным обучением с использованием языка программирования Python.


